PDFium Component escribe texto en una página PDF a nivel de glifo mediante AddCidType2Text, embebiendo los datos TrueType que usted suministra como una fuente CID Type 2. Asigna a cada instancia de glifo un CID secuencial, genera el mapa explícito CID-a-GID y el CMap ToUnicode, y fusiona los glifos sobre la misma línea base en un único objeto de texto nativo. El subsetting opcional mantiene pequeño el archivo, con una política explícita para lo que ocurre cuando el subsetting falla
La escritura a nivel de glifo es lo que se necesita cuando el texto ya ha pasado por shaping. El árabe, el devanagari y cualquier escritura con formas contextuales producen una secuencia de identificadores de glifo que ya no se mapea uno a uno con los caracteres, de modo que una API que toma una cadena y un nombre de fuente no puede expresar el resultado. Entregar directamente los glifos y sus posiciones es la única forma de poner en un PDF texto de escritura compleja correctamente shaped
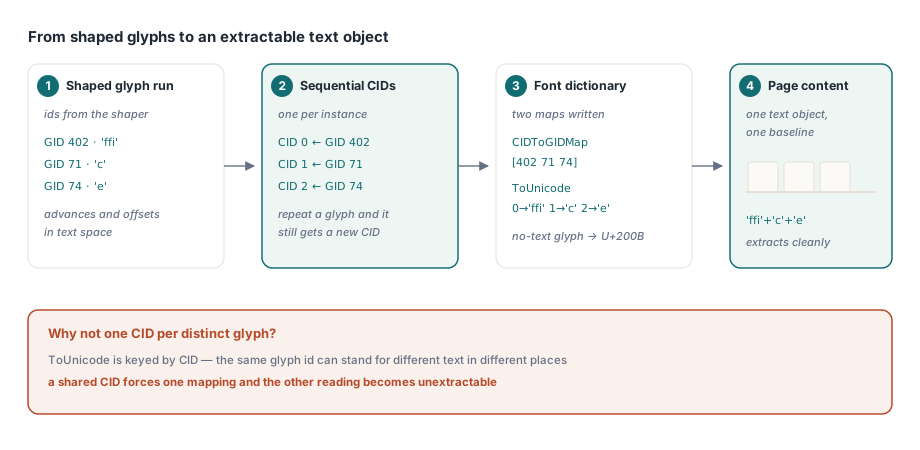
Por qué cada instancia de glifo obtiene su propio CID
La optimización tentadora es deduplicar: un CID por cada identificador de glifo distinto, reutilizado donde sea que aparezca ese glifo. Eso produce una fuente más pequeña y rompe la extracción de texto, porque el mismo glifo puede corresponder legítimamente a contenido Unicode distinto en lugares distintos
Un glifo de ligadura es el caso claro. El mismo glifo "ffi" puede representar los tres caracteres en una palabra y, tras una decisión de shaping distinta, otra cosa en otro lugar. El mapa ToUnicode se indexa por CID, así que un CID compartido solo puede llevar un único mapeo, y el texto que pierda esa disputa se vuelve inextraíble
Así que cada instancia de glifo toma su propio CID, y cada mapeo es libre de tener varias unidades de código UTF-16. Un glifo sin texto con significado — un elemento decorativo, un glifo puramente de posicionamiento — se mapea explícitamente a U+200B, un espacio de ancho cero, de modo que cada CID tiene un resultado de extracción observable en lugar de un vacío
uses
  PDFium;

var
  Pdf: TPdf;
  Glyphs: TPdfCidGlyphs;
  Options: TPdfCidFontOptions;
  Report: TPdfCidFontReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'label.pdf';
    Pdf.LoadDocument;
    Pdf.PageNumber := 1;

    // Una entrada por glifo shaped: el id del glifo, el texto que
    // representa, y su avance y desplazamientos en el espacio de texto
    SetLength(Glyphs, 3);
    Glyphs[0].GlyphID := 402;  Glyphs[0].UnicodeText := 'ffi';
    Glyphs[0].Advance := 18.4;
    Glyphs[1].GlyphID := 71;  Glyphs[1].UnicodeText := 'c';
    Glyphs[1].Advance := 9.8;
    Glyphs[2].GlyphID := 74;   Glyphs[2].UnicodeText := 'e';
    Glyphs[2].Advance := 9.2;

    Options := TPdfCidFontOptions.Default;   // se prefiere subsetting
    Options.VerifyExtraction := True;

    if Pdf.AddCidType2Text(LoadFileBytes('NotoSans.ttf'), Glyphs,
         11, 72, 700, Options, Report) then
      Writeln(Format('%d glyphs, %d unique, font %d -> %d bytes, match=%s',
        [Report.GlyphCount, Report.UniqueGlyphCount,
         Report.OriginalFontBytes, Report.EmbeddedFontBytes,
         BoolToStr(Report.ExtractionMatches, True)]));
  finally
    Pdf.Free;
  end;
end;
El subsetting, y las verificaciones que un código de retorno no le da
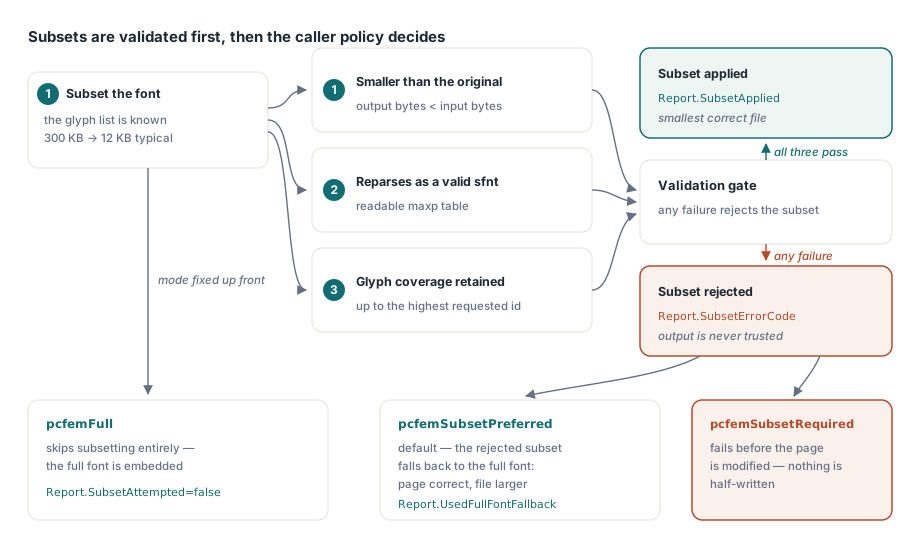
Reducir una fuente mediante subsetting a los glifos realmente usados es la diferencia entre embeber 300 KB y embeber 12 KB, y en un documento con varias fuentes eso decide si el archivo se puede enviar por correo. La ruta de subsetting de la plataforma acepta directamente una lista de glifos, lo cual encaja perfectamente con esta API, ya que el llamador ya conoce cada identificador de glifo en uso
Lo que no le da es confianza. Una llamada de subsetting puede reportar éxito y devolver una salida inservible, así que el componente valida tres propiedades antes de aceptar el resultado: la salida debe ser más pequeña que el original, debe volver a analizarse como un sfnt válido con una tabla maxp legible, y debe conservar los glifos hasta el identificador original más alto solicitado. Cualquier fallo significa que el subconjunto se rechaza
Lo que ocurre después depende de la política del llamador. Bajo pcfemSubsetPreferred, el valor por defecto, un subconjunto rechazado recurre a embeber la fuente completa, de modo que la página queda correcta y solo más grande. Bajo pcfemSubsetRequired, la operación falla antes de que se modifique la página, que es lo que quiere un pipeline con restricciones de tamaño. pcfemFull se salta el subsetting por completo. El informe le indica qué ruta se tomó mediante SubsetAttempted, SubsetApplied, UsedFullFontFallback y SubsetErrorCode
Una verificación que no puede producir un falso positivo
Con VerifyExtraction activado, el componente confirma que lo que escribió se puede volver a leer. La forma ingenua de hacer esto es extraer toda la página y buscar la cadena esperada, y es incorrecta: una página que ya contenía ese texto pasa la verificación incluso cuando el texto nuevo se escribió mal
En cambio, la página de texto se reconstruye y los handles de objeto insertados por esta llamada se leen individualmente, en orden de inserción, y se concatenan. El resultado se compara contra el texto esperado, y el informe expone ambas cadenas junto con el booleano, de modo que una discrepancia se pueda diagnosticar y no solo detectar
Actívelo durante el desarrollo y en cualquier pipeline donde la extraíbilidad sea un requisito — archivos con capacidad de búsqueda, cumplimiento de accesibilidad, minería de texto posterior. El costo es una reconstrucción de página de texto por llamada, razón por la cual no está activado por defecto en bucles ajustados
Límites y fallo atómico
Los bytes de fuente, las instancias de glifo y las unidades de código Unicode tienen cada uno un límite antes de la asignación, y el formato de fuente, el índice TTC, el rango de identificadores de glifo y los valores de geometría se validan antes de escribir nada. La geometría debe ser finita, lo cual suena obvio hasta que un motor de shaping le entrega un avance NaN proveniente de una fuente malformada
El fallo es atómico a nivel de página. Si falla la carga de la fuente, la escritura de objetos, la generación de contenido o la verificación de extracción, todos los objetos insertados por esa llamada se eliminan en orden inverso y el contenido de la página se regenera. Una llamada fallida deja la página como estaba, no con medio bloque de texto encima
Dónde encaja esto en un pipeline de texto
Vale la pena decir con claridad la división del trabajo. El shaping — convertir caracteres en glifos posicionados — no es el trabajo de esta API; le corresponde a un motor de shaping, y el propio soporte de texto bidireccional y de escrituras complejas del componente se cubre en manejo de emoji, CJK y pares subrogados. Esta API es lo que se llama después, con la corrida de glifos que produjo el shaper
Para texto latino ordinario sin shaping contextual, las API de texto basadas en cadenas, más simples, son la herramienta correcta y producen código más pequeño. Recurra a la escritura CID Type 2 cuando tenga una salida ya shaped, cuando necesite control exacto de los identificadores de glifo, o cuando la fuente deba embeberse desde bytes que usted tiene en lugar de resolverse por nombre — la alternativa de resolución de fuente es el mecanismo de proveedor descrito en controlar la sustitución de fuentes en PDF
Una nota para el despliegue: embeber una fuente es una cuestión de licencia tanto como técnica. Las fuentes varían en si el embebido está permitido en absoluto, permitido solo para visualización, o permitido para edición. La biblioteca embeberá cualquier byte que usted le entregue, y verificar la licencia es responsabilidad suya, no del formato de archivo
La escritura de texto a nivel de glifo, el suministro de fuentes y la extracción de texto comparten el mismo modelo de página en Delphi, C++Builder y Lazarus; la API completa se describe en la página de PDFium Component para Delphi