Un timeout de reconocimiento de 5,000 ms en una llamada in-process a Tesseract no significa que la llamada regrese a los cinco segundos. Con un set grande de modelos multilingües, el thread llamador puede quedarse dentro de la librería nativa mucho más allá de esa marca, porque el monitor de progreso que hace cumplir el deadline se consulta mientras se reconocen palabras, y la carga de modelos y el análisis de layout de página ocurren ambos antes de la primera consulta. Ese hueco, un callback de cancelación cuyo tipo de retorno C es un solo byte, y un iterador que entrega memoria que usted jamás debe liberar son el trabajo real de enlazar la API C de Tesseract con Delphi. El resto es plomería
Conectar la DLL de Tesseract a una capa de texto de HotPDF
HotPDF expone el camino in-process como HPDFCreateTesseractDLLOCREngine en la unit HPDFTesseractRecognition. La factory carga una DLL de Tesseract que exporta la API C, maneja TessBaseAPIInit2, TessBaseAPIRecognize y el iterador de resultados, y devuelve un IHPDFOCREngine. THotPDF.ApplyLoadedOCRTextLayer toma ese engine y agrega una capa de texto Unicode invisible y buscable a las páginas escaneadas, la misma llamada por la que pasa cada engine OCR de HotPDF
La factory valida con anticipación. El archivo DLL y el directorio tessdata deben existir. El identificador de idioma puede contener solo letras ASCII, dígitos, _ y +, y cada modelo en una combinación como chi_sim+eng necesita su archivo .traineddata correspondiente. Las 21 exportaciones requeridas tienen que resolver antes de recibir un engine. Los errores de configuración lanzan EArgumentException, con la exportación o el modelo faltante reportado por nombre; una DLL que no carga lanza EOSError con el código de error de Windows y la pista de revisar arquitectura y dependencias
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Una aplicación Win64 necesita una DLL de 64 bits; el nombre del archivo depende
  // de su build, y las DLLs de dependencia van en la misma carpeta
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // usa THPDFTesseractOptions.Default
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI, MinimumConfidence 0.5
    // Una lista de páginas vacía significa todas; las páginas que ya traen texto se saltan
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFTesseractOptions.Default asigna PageSegMode a tpsAuto, EngineMode a temDefault, TimeoutMilliseconds a 60,000 y MaxPixels a 16,777,216. Ese presupuesto de píxeles muerde antes de lo que uno espera. Una página carta US al default de 300 DPI se renderiza a 2,550 × 3,300 píxeles, unos 8.4 millones, y cabe. Suponga que sube la misma página a 600 DPI: se vuelve 5,100 × 6,600, unos 33.7 millones de píxeles, y el engine la rechaza con Invalid Tesseract DLL OCR request or pixel budget antes de que Tesseract vea la imagen. O sube MaxPixels (el techo es 67,108,864) o se queda en 300 DPI, que es de sobra para texto corrido; cada lado también tiene tope de 32,767 píxeles
La DLL se carga con LoadLibraryEx y los flags de búsqueda para la carpeta propia de la DLL más los directorios seguros por default. Las librerías de imagen de las que depende Tesseract pueden quedar junto a ella, y usted nunca tiene que tocar PATH ni depender del directorio actual. HotPDF no incluye ni descarga un runtime de OCR ni ningún modelo de idioma; ambos los provisiona usted
Qué cambia con la vía DLL comparada con tesseract.exe
El mismo reconocedor también se alcanza vía el adaptador tesseract.exe externo que escribe un BMP y parsea TSV. Ambos adaptadores alimentan un mismo pipeline de capa de texto, así que el mapeo de coordenadas, el filtro de confianza y la confirmación todo-o-nada se comportan igual. Lo que difiere es cómo entran los píxeles, cómo salen las palabras y qué pasa cuando el reconocedor se porta mal
| Aspecto | Adaptador tesseract.exe | Adaptador DLL de Tesseract |
|---|---|---|
| Factory | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| Píxeles que entran | Archivo BMP en un directorio temporal privado | Buffer de escala de grises de 8 bits en memoria |
| Palabras que salen | TSV por palabra, con tope de 64 MiB | Iterador de resultados, UTF-8 por palabra |
| Baselines | No están en el TSV; el pipeline las estima | Passthrough desde TessPageIteratorBaseline |
| Segmentación de página y modo de engine | Overload de THPDFTesseractOptions, enviado como --psm y --oem | THPDFTesseractOptions, enviado a TessBaseAPISetPageSegMode y TessBaseAPIInit2 |
| Presupuesto de píxeles | MaxPixels cuando se pasan opciones | MaxPixels siempre, más 32,767 píxeles por lado |
| Timeout | Duro: el proceso hijo se termina | Cooperativo: Tesseract tiene que enterarse |
| Aislamiento de crashes y memoria | Proceso separado | Ninguno, comparte su address space |
Un costo se queda con la DLL. Cada llamada Recognize crea su propia instancia de API y corre TessBaseAPIInit2, así que los modelos de idioma se inicializan por cada página. El caché de archivos le quita filo a la recarga, pero con un set grande de modelos multilingües sigue siendo el costo fijo más grande por página, y se cobra contra el deadline de reconocimiento. El engine DLL RapidOCR in-process toma la decisión contraria y mantiene sus modelos ONNX residentes durante la vida del engine, mientras que los problemas de frontera (ABI C, buffers prestados, trabajo nativo que no se puede interrumpir) son de la misma familia
¿Y cuál va en producción? Para una herramienta de escritorio o un trabajo por lotes que procesa unos cientos de escaneos, la DLL es la mejor opción: sin lanzamiento de proceso por página, sin bitmap temporal en disco, y baselines reales para líneas inclinadas. Un servidor de larga vida que acepta PDFs de extraños debe quedarse en tesseract.exe, porque un crash nativo o una asignación desbocada ahí tumba un proceso hijo y no su servicio
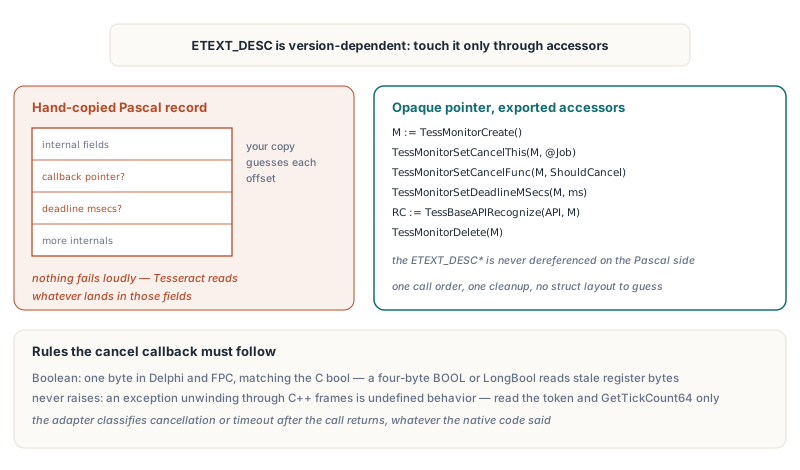
¿Por qué Delphi no puede copiar la struct monitor de Tesseract?
Delphi no puede reflejar con seguridad el monitor de progreso de Tesseract, porque ETEXT_DESC carga campos internos que varían entre builds de Tesseract. Un record traducido a mano desde un header pone el callback de cancelación y el deadline en los offsets que ese header usaba. Corra contra otro build y Tesseract lee su puntero de callback de un campo que ahora significa otra cosa, o nunca encuentra el deadline, y el reconocimiento simplemente corre hasta el final
El adaptador de HotPDF por eso trata el monitor como un puntero opaco y solo lo toca mediante funciones exportadas: TessMonitorCreate, TessMonitorSetCancelThis, TessMonitorSetCancelFunc, TessMonitorSetDeadlineMSecs y TessMonitorDelete. El bosquejo de abajo es su propio código de binding, no una API de HotPDF; sus declaraciones coinciden con las que el adaptador resuelve con GetProcAddress
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*, nunca desreferenciado
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  // Estado de su propio job, no un tipo de HotPDF
  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // Corre en el stack de Tesseract: lea un flag y el reloj, nunca lance excepciones
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// Uso, con los punteros de función resueltos por GetProcAddress:
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
El bosquejo declara el callback como Boolean, un byte tanto en Delphi como en Free Pascal, lo que coincide con el bool de C en TessCancelFunc. El BOOL de Windows de cuatro bytes y el LongBool de Delphi se ven intercambiables y son otro tipo: cuando un lado escribe un solo byte y el otro lee cuatro, los tres bytes altos son lo que el register tenía antes, y un false puede llegar como true. TessPageIteratorBoundingBox devuelve un int, declarado como Integer del lado Pascal, así que lea el tipo C de cada valor de retorno en vez de asumir una sola regla para toda la API
El callback además nunca lanza. Una excepción de Delphi haciendo unwinding a través de los frames de C++ de Tesseract es comportamiento indefinido. El callback de HotPDF lee solo el token de cancelación y un valor monótono de GetTickCount64, y el adaptador convierte el resultado en un diagnóstico de cancelación o timeout después de que TessBaseAPIRecognize regresa. Corre esa revisión haya sido o no 0 el código de retorno nativo
¿Qué punteros nativos posee el lado Delphi?
El adaptador Tesseract DLL de HotPDF posee tres objetos nativos por solicitud (la instancia de API, el monitor y el iterador de resultados) y todo lo demás es prestado. Cada llamada Recognize crea su propio set y lo libera en un bloque finally en orden fijo: TessResultIteratorDelete, luego TessMonitorDelete, luego TessBaseAPIDelete. Liberar la interfaz del engine llama FreeLibrary sobre la DLL
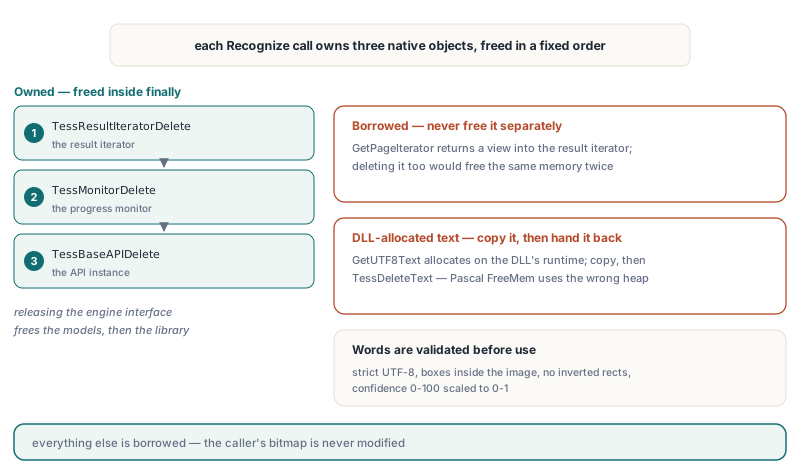
TessResultIteratorGetPageIteratordevuelve una vista dentro del iterador de resultados, no un objeto nuevo. El adaptador la usa paraTessPageIteratorBoundingBoxyTessPageIteratorBaseliney nunca la libera; borrarla también liberaría la misma memoria dos vecesTessResultIteratorGetUTF8Textdevuelve una cadena asignada por el runtime propio del DLL. El adaptador la decodifica y la devuelve víaTessDeleteTexten un bloquefinally, porque unFreeMemde Pascal la liberaría en el heap equivocado- El texto de cada palabra pasa por decodificación UTF-8 estricta con chequeo de longitud primero. Una palabra con caracteres de control, UTF-8 malformado, una caja fuera de la imagen, un rectángulo invertido o una confianza fuera de 0-100 hace fallar la solicitud; el adaptador no la remienda
- El texto por solicitud tiene tope de 1,048,576 unidades de código UTF-16, y el conteo de palabras tiene que caber en el presupuesto que
ApplyLoadedOCRTextLayerentrega con cada página
La confianza llega como 0-100 y se escala a 0-1, así que THPDFOCRTextLayerOptions.MinimumConfidence significa lo mismo para todos los engines. Cuando Tesseract reporta una baseline, ambos extremos se pasan a través, y para una palabra predominantemente vertical el ancho de la caja se usa como altura del texto. Sin baseline, el pipeline de la capa de texto recurre a su estimación geométrica, exactamente como hace con entrada TSV
Validar por rango las opciones de enum antes de que lleguen al DLL
La factory copia los bytes crudos de PageSegMode y EngineMode a un Integer antes de validarlos por rango. Un compilador tiene derecho a asumir que una variable de enum siempre guarda un valor declarado, así que una prueba como Ord(X) > Ord(High(T)) escrita directamente contra el enum se puede plegar a una constante false. Esos ordinales llegan al DLL como enteros planos: THPDFTesseractPageSegMode sigue la numeración de segmentación de página de Tesseract de 0 a 13, y THPDFTesseractEngineMode su numeración de modos de engine de 0 a 3. Un record de opciones limpiado con FillChar, leído de un stream o llenado desde C++Builder vía un cast a entero puede cargar un byte como 200, y validar la copia convierte eso en una EArgumentException en la factory. La factory también rechaza tpsOSDOnly y tpsAutoOnly, que no devuelven palabras, y exige osd.traineddata para tpsAutoOSD y tpsSparseTextOSD
¿Qué garantiza en realidad el timeout de reconocimiento?
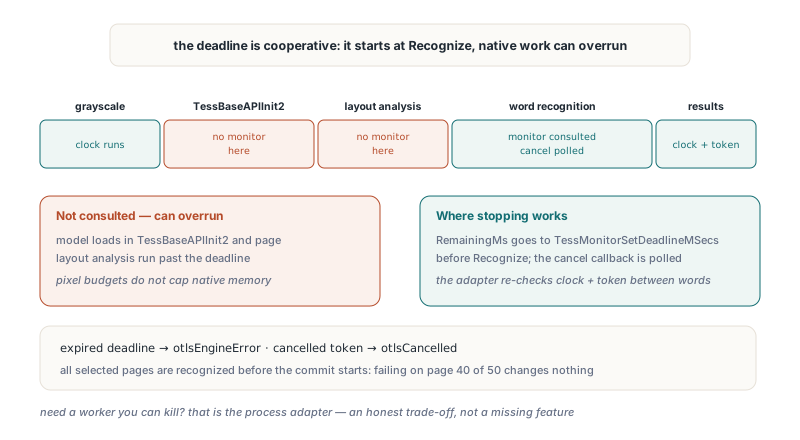
El timeout del DLL de Tesseract es cooperativo: HotPDF puede detener su propio trabajo y pedirle a Tesseract que se detenga, pero no puede forzar a código nativo a regresar. El reloj arranca cuando Recognize comienza, así que la conversión a escala de grises y la inicialización de modelos consumen del mismo presupuesto que el reconocimiento. El adaptador revisa el tiempo transcurrido y el token de cancelación cada 64 filas durante la conversión a escala de grises, después de la inicialización, y antes de cada palabra mientras recorre los resultados. Justo antes de TessBaseAPIRecognize pasa los milisegundos restantes a TessMonitorSetDeadlineMSecs
El hueco vive dentro de las llamadas nativas. Tesseract consulta su monitor solo durante el reconocimiento de palabras, así que dentro de TessBaseAPIInit2 o del análisis de layout una carga de modelo lenta o un layout patológico puede pasarse del deadline antes de que el timeout se reporte. Los presupuestos de píxeles y de salida tampoco acotan el uso de memoria de la propia librería nativa. Cuando necesita un worker que pueda matar sin más, el adaptador de proceso es la herramienta
La segmentación de página es donde el adaptador DLL rinde con entrada difícil. Formularios, etiquetas y tablas escaneadas con campos dispersos suelen reconocer mejor con tpsSparseText que con segmentación automática, que intenta armar columnas y párrafos que no existen. El timeout de abajo es corto para una página de formulario y aun así tiene que cubrir la inicialización de modelos
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // campos dispersos, sin armado de columnas
  TessOptions.EngineMode := temLSTMOnly;     // necesita modelos LSTM en tessdata
  TessOptions.TimeoutMilliseconds := 20000;  // incluye la inicialización de modelos
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        if Pos('timed out', string(Info.Diagnostic)) > 0 then
          Writeln('Tesseract timed out, document unchanged')
        else
          Writeln('Tesseract failed: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Un timeout aparece como otlsEngineError con Tesseract DLL OCR timed out en el diagnóstico. Un token asignado vía THPDFOCRTextLayerOptions.CancellationToken aparece como otlsCancelled. En ambos casos ApplyLoadedOCRTextLayer reconoce todas las páginas seleccionadas antes de empezar la confirmación, así que una falla en la página 40 de 50 deja el documento cargado exactamente como estaba. tpsSingleLine, tpsSingleBlock y tpsSparseText cambian solo la segmentación; ninguno endereza un escaneo torcido
Free Pascal y Lazarus: píxeles viejos y chino perdido
Ambas factory de Tesseract funcionan en builds Win32 y Win64 de Free Pascal y Lazarus para Windows una vez que el package de Lazarus se recompila para la arquitectura objetivo; el port general está cubierto en HotPDF en Free Pascal y Lazarus Win64. El manejo de la entrada es donde FPC se comporta distinto
Un TBitmap de la LCL escrito vía scanlines puede actualizar su imagen cruda sin refrescar el handle del bitmap de Windows, así que GetDIBits sobre ese handle devuelve los píxeles viejos. El síntoma desconcierta: texto dibujado directo sobre un bitmap se reconoce, una página renderizada vía scanlines no produce palabras. Bajo FPC el adaptador DLL lee un snapshot consciente del formato vía CreateIntfImage, que respeta el formato de píxel y el orden de filas de la imagen cruda. El build Delphi conserva el camino de GetDIBits sobre una copia privada de 24 bits, y ninguno de los builds modifica el bitmap del llamador
El adaptador tesseract.exe se topa con un problema distinto. El TStringList de FPC almacena cadenas ANSI, así que asignar el texto TSV decodificado UTF-8 a Lines.Text suelta cada carácter chino o de plano complementario que la página de códigos ANSI del sistema no pueda representar. El camino FPC conserva el TSV como bytes UTF-8, quita el BOM a nivel de bytes y decodifica cada palabra a UnicodeString por su cuenta. El adaptador DLL jamás se topa con el problema, porque decodifica cada palabra directo del iterador
El adaptador Tesseract DLL se distribuye junto con los adaptadores de proceso y el engine OCR incluido en HotPDF para Delphi, C++Builder y Free Pascal. Las ediciones y descargas están listadas en la página del componente PDF de HotPDF para Delphi