TerminateThread parece la forma obvia de detener una llamada de OCR que lleva demasiado tiempo moliendo una página escaneada para la paciencia de su UI. La documentación de Windows explica por qué no lo es: si el thread objetivo sostiene el lock del heap del proceso, ese lock nunca se libera, y la siguiente asignación en cualquier otro thread se puede bloquear para siempre. Una vez que el OCR corre dentro de su propio proceso, la única parada segura es una cooperativa, en checkpoints entre etapas de inferencia, y ese es el precio de cargar los modelos ONNX una vez y mantenerlos calientes
La alternativa que la mayoría de los equipos Delphi prueba primero es un proceso hijo. Un worker Python por página se puede matar en cualquier momento, lo que resulta atractivo, pero cada llamada arranca un intérprete, importa su runtime, y carga los modelos de detección y reconocimiento antes de leer un píxel. Suponga un trabajo de archivo con 500 páginas: ese trabajo de arranque corre 500 veces, y el despliegue ahora incluye un entorno Python sentado junto a un ejecutable nativo
PDF buscable desde escaneos con HPDFCreateRapidOCRDLLOCREngine
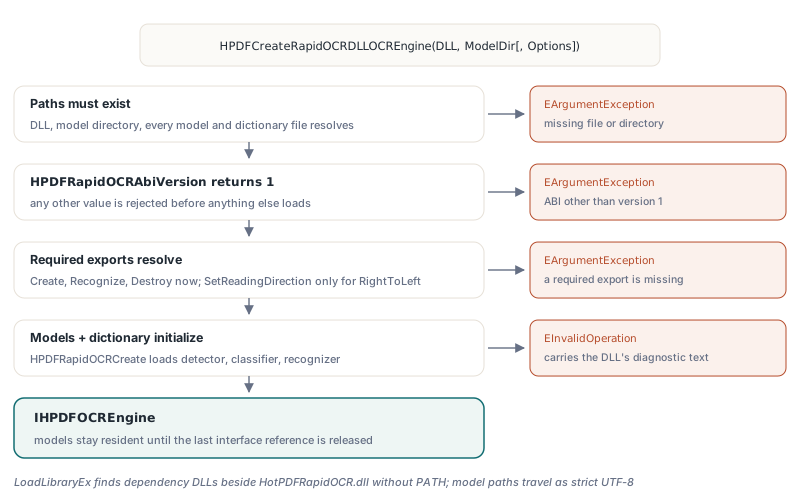
HotPDF corre RapidOCR in-process a través de HPDFCreateRapidOCRDLLOCREngine, declarada en la unit HPDFRapidOCRRecognition. La factory carga HotPDFRapidOCR.dll, inicializa una sola vez los modelos de detección ONNX, la clasificación de ángulo opcional y el reconocimiento, y devuelve un IHPDFOCREngine. Ese engine se conecta a THotPDF.ApplyLoadedOCRTextLayer exactamente como los demás engines OCR: el documento renderiza cada página, el DLL corre inferencia de CPU sobre ella, y el resultado se confirma como una capa de texto Unicode invisible. Sin Python, sin proceso hijo. El adaptador se distribuye para builds Delphi, C++Builder y FPC/Lazarus en Windows
La validación ocurre en la factory, antes de tocar cualquier página. Cada archivo de modelo y diccionario debe resolver, HPDFRapidOCRAbiVersion debe devolver 1, y las exportaciones requeridas deben existir antes de que HPDFRapidOCRCreate construya los modelos. Los errores de configuración lanzan EArgumentException; un modelo que se niega a cargar lanza EInvalidOperation con el diagnóstico propio del DLL, por ejemplo un diccionario que no corresponde al modelo de reconocimiento
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Los modelos se cargan aquí, fuera de cualquier deadline de reconocimiento.
  // Los nombres relativos en THPDFRapidOCRDLLOptions.Default se resuelven
  // contra el directorio de modelos
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models');
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // lista de páginas vacía = todas; SkipPagesWithText es True por default
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFRapidOCRDLLOptions.Default nombra ch_PP-OCRv3_det_infer.onnx, ch_PP-OCRv3_rec_infer.onnx, ch_ppocr_mobile_v2.0_cls_infer.onnx y ppocr_keys_v1.txt, con un hilo de CPU, un límite de entrada de 16,777,216 píxeles y un deadline de 60,000 ms por llamada de reconocimiento. Para otras escrituras, THPDFRapidOCRDLLOptions.ForLanguage conserva esos defaults y cambia <profile>/recognition.onnx más <profile>/dictionary.txt por uno de nueve perfiles, del chino tradicional y el cirílico al árabe y el devanagari. Cada engine lee un idioma; elija el perfil por página o por documento. Por qué el modelo y el diccionario siempre viajan como pareja está cubierto en modelos multilingües RapidOCR y diccionarios CTC en HotPDF
El engine se reporta como RapidOCR (native DLL) en Info.EngineName. Registre esa cadena en el log. Cuando el mismo servicio también corre el adaptador del proceso Tesseract externo o el engine OCR de template matching incluido, es la manera más rápida de saber qué reconocedor produjo una página mala
¿Por qué la ABI C solo habla int32_t y bytes UTF-8?
La frontera de HotPDFRapidOCR.dll usa enteros de ancho fijo, punteros crudos y longitudes en bytes explícitas porque Delphi, C++Builder y Free Pascal no comparten nada con MSVC más allá de la convención de llamada C. Un std::string, un std::vector o una excepción de C++ carga una disposición de memoria y un modelo de unwinding que pertenecen a un compilador y a una librería de runtime, y dejar que cualquiera de ellos cruce hacia código Pascal termina en un stack corrupto o un bloque del heap liberado por el allocator equivocado
La versión 1 de la ABI es una lista corta de reglas. Cada exportación es cdecl y devuelve un estado int32_t: 1 para éxito, 0 para falla. Cada función que puede fallar toma un buffer de diagnóstico propiedad del llamador y su tamaño en bytes, y el DLL escribe un mensaje UTF-8 terminado en NUL truncado para caber. Dentro del DLL, el cuerpo de cada exportación vive en un try con catch (const std::exception &) y catch (...). Un error de ONNX Runtime, un assert de OpenCV o un diccionario malformado se convierte en estado 0 más texto
| Exportación | Rol | Cuándo la resuelve el adaptador |
|---|---|---|
HPDFRapidOCRAbiVersion | Devuelve 1; cualquier otro valor se rechaza | Inmediatamente después de cargar el DLL |
HPDFRapidOCRCreate | Carga los modelos de detección, clasificación opcional y reconocimiento, y el diccionario | En la factory |
HPDFRapidOCRRecognize | Corre un bitmap y emite un callback por línea de texto | En la factory |
HPDFRapidOCRDestroy | Libera la instancia de modelos | En la factory |
HPDFRapidOCRSetReadingDirection | Orden de filas derecha a izquierda opcional | Solo cuando RightToLeft está asignado |
La exportación de dirección de lectura se resuelve de forma perezosa a propósito, así que un DLL compilado sin ella sigue sirviendo toda solicitud de izquierda a derecha. El adaptador carga la librería con LoadLibraryEx y flags de búsqueda que cubren la carpeta propia del DLL más los directorios seguros por default; las dependencias de ONNX Runtime u OpenCV puestas junto a HotPDFRapidOCR.dll se encuentran sin editar PATH. Las rutas de modelo y diccionario cruzan la frontera como UTF-8, y el DLL las convierte con MultiByteToWideChar en modo estricto antes de abrir archivos vía APIs de caracteres anchos. Un directorio de modelos bajo C:\Users\Łukasz o un nombre de usuario cirílico abre normal
Una regla vive en los archivos de build y no en el header. El DLL enlaza ONNX Runtime y OpenCV estáticamente, y el proyecto CMake hace default al CRT release estático (/MT). Mezcle librerías estáticas compiladas contra /MD y obtiene errores de link si tiene suerte, y dos heaps independientes si no. Provisione librerías compiladas para el mismo modo de CRT que el DLL
¿Qué pasa entre un TBitmap y una línea de texto?
HotPDF le entrega al DLL una copia BGR top-down independiente de la página renderizada, y el DLL devuelve un callback por línea reconocida. El texto de ese callback es prestado: el puntero es válido solo hasta que el callback regresa, así que el adaptador lo copia en el momento
En Delphi el snapshot sale de un TBitmap privado forzado a pf24bit y leído con GetDIBits usando un biHeight negativo. Eso da filas top-down rellenadas a alineación de cuatro bytes, y el stride viaja al DLL como argumento explícito. En FPC el adaptador lee vía CreateIntfImage. El bitmap del llamador nunca se modifica. Los chequeos de tamaño corren antes de asignar la copia: a lo sumo 32,767 píxeles por lado, y no más de MaxPixels en total, que hace default a 16,777,216 y se puede subir a 67,108,864
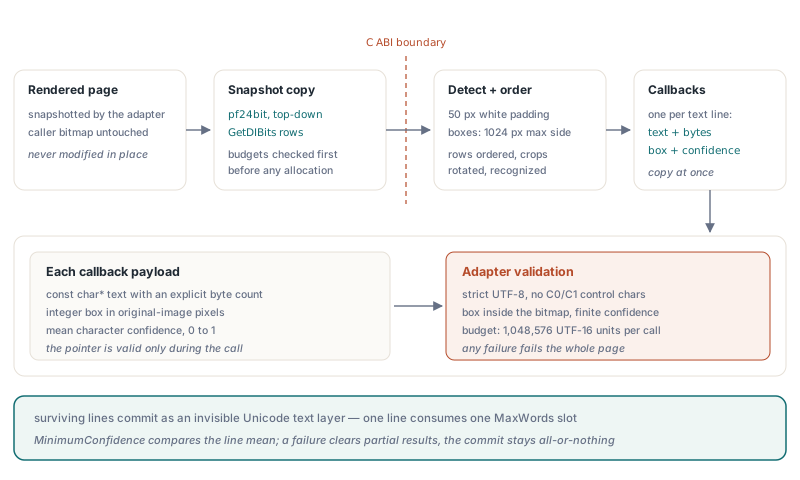
Dentro del DLL la imagen recibe un borde blanco de 50 píxeles, las regiones de texto se detectan con el lado largo escalado a 1,024 píxeles como máximo, y las cajas se ordenan en filas horizontales. Con el clasificador de ángulo habilitado, un recorte se gira 180 grados solo cuando el puntaje de boca abajo supera 0.9, lo que evita que una predicción débil voltee palabras cortas. Cada línea llega entonces como un const char*, un conteo de bytes, una caja entera en píxeles de la imagen original y la confianza media de caracteres. El adaptador es estricto con lo que acepta:
- El UTF-8 se decodifica con
MB_ERR_INVALID_CHARS, así que una secuencia de bytes malformada hace fallar la página en vez de plantar caracteres de reemplazo en una capa buscable - Los caracteres de control C0 y C1 se rechazan; las líneas de solo espacios se saltan
- La caja debe quedar dentro del bitmap, y la confianza debe ser un valor finito de 0 a 1
- El texto cuenta contra el
MaxTextCodeUnitsde la solicitud, con un techo duro de 1,048,576 unidades UTF-16 por llamada; los caracteres fuera del Basic Multilingual Plane cuestan dos unidades - Una excepción de Pascal dentro del callback se atrapa ahí, se almacena y se convierte en un retorno 0, lo que hace que el DLL se detenga; el mensaje almacenado se convierte en
Info.Diagnostic
Dos de estos detalles importan cuando ajusta la salida. La unidad es una línea, no una palabra: cada línea toma un slot de MaxWords, Info.AcceptedWordCount y Info.DroppedWordCount cuentan líneas, y un resultado de búsqueda resalta la caja de toda la línea. Y MinimumConfidence se compara con la confianza media de caracteres de la línea, así que un carácter borroso entre veinte limpios rara vez hunde la línea. Subir el umbral a 0.7 o 0.8 descarta líneas enteras, nunca caracteres sueltos. Una página en blanco termina con éxito y cero líneas, y cualquier falla descarta los resultados parciales para que la confirmación multipágina quede todo-o-nada
Un engine, una copia de modelos, un llamador a la vez
Cada engine DLL RapidOCR posee exactamente una instancia de modelos durante toda su vida, y las llamadas Recognize sobre ese engine se serializan con una sección crítica. Sostener la referencia IHPDFOCREngine es lo que mantiene los modelos en memoria, así que el trabajo por lotes debe crear el engine una vez y reutilizarlo en todos los documentos
procedure OcrBatch(const Files: TStrings; const OutputDir: string);
var
  Models: THPDFRapidOCRDLLOptions;
  Engine: IHPDFOCREngine;
  Doc: THotPDF;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
  I: Integer;
begin
  Models := THPDFRapidOCRDLLOptions.ForLanguage('ru-RU');
  Models.UseAngleClassifier := False;    // escaneos derechos: no se carga modelo clasificador
  Models.Threads := 4;                   // 1..64, acotado a los procesadores activos
  Models.TimeoutMilliseconds := 120000;  // por llamada Recognize, cooperativo
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Options := THPDFOCRTextLayerOptions.Default;
  for I := 0 to Files.Count - 1 do
  begin
    Doc := THotPDF.Create(nil);
    try
      Doc.AutoLaunch := False;
      if (Doc.LoadFromFile(Files[I]) > 0) and
        Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
        Doc.SaveLoadedDocument(IncludeTrailingPathDelimiter(OutputDir) +
          ExtractFileName(Files[I]))
      else
        Writeln(Files[I], ': ', string(Info.Diagnostic));
    finally
      Doc.Free;
    end;
  end;
end;  // última referencia liberada: modelos destruidos, luego el DLL descargado
Threads asigna los conteos de threads intra-op e inter-op de cada sesión ONNX del engine, y el DLL lo acota al conteo de procesadores activos. Dos threads que comparten un engine nunca corren inferencia en paralelo; el segundo espera. Esa espera no es un EnterCriticalSection a ciegas. El adaptador prueba el lock con TryEnterCriticalSection, duerme 25 ms entre intentos, y revisa el token de cancelación y el deadline cada vez, así que una solicitud en cola todavía se puede cancelar
El reloj del deadline arranca cuando se entra a Recognize, antes de tomar el lock. El tiempo en cola detrás de otra página cuenta contra TimeoutMilliseconds. Con cuatro worker threads sobre un engine y un deadline de 60 segundos, la cuarta página puede expirar sin llegar jamás al modelo. Déle a cada worker su propio engine. Cuesta una copia de los modelos en memoria por engine, y esa memoria compra timeouts predecibles y paralelismo real; compartir un engine solo tiene sentido cuando las solicitudes son tan raras que casi nunca hacen cola
¿Por qué una llamada de OCR nativa no se puede matar a mitad de inferencia?
Una llamada nativa RapidOCR no se puede matar a mitad de inferencia porque corre en su thread, dentro de su proceso, en medio de una sesión de ONNX Runtime que no tiene API de interrupción para un Run en marcha. La cancelación en el adaptador del DLL es cooperativa. El DLL llama a un callback de aborto antes y después de la detección, después de la clasificación de cada recorte, y después de cada línea reconocida, y se detiene en el primer checkpoint donde el callback devuelve 0. Un Run único que ya arrancó termina primero
Las opciones violentas son peores que esperar. TerminateThread dejaría el lock del heap del CRT, el thread pool de ONNX Runtime y cualquier estado de OpenCV en la condición en que estuvieran al momento. Llamar FreeLibrary mientras una llamada sigue ejecutándose desmapea código que está en el stack. Ninguna de las dos se puede volver segura, así que el adaptador nunca lo intenta. Un deadline expirado regresa como otlsEngineError con un diagnóstico de timeout; un token cancelado regresa como otlsCancelled:
// El token lo crea el llamador y lo comparte con el thread de UI,
// que llama Token.Cancel cuando el usuario pulsa Stop
function OcrWithStop(Doc: THotPDF; const Engine: IHPDFOCREngine;
  Token: THPDFCancellationToken): Boolean;
var
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Options := THPDFOCRTextLayerOptions.Default;
  Options.CancellationToken := Token;
  Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
  if not Result then
    case Info.Status of
      otlsCancelled:
        // detenido en el siguiente checkpoint de etapa o línea; documento sin cambios
        Writeln('Cancelled');
      otlsEngineError:
        // incluye un deadline cooperativo expirado y diagnósticos nativos
        Writeln('Engine: ', string(Info.Diagnostic));
      otlsBudgetExceeded:
        // se alcanzó un límite de página, píxel, palabra o contenido en Options
        Writeln('Budget: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Este es el verdadero trade-off entre los adaptadores de proceso y el DLL in-process, y ningún lado gana en todas las filas:
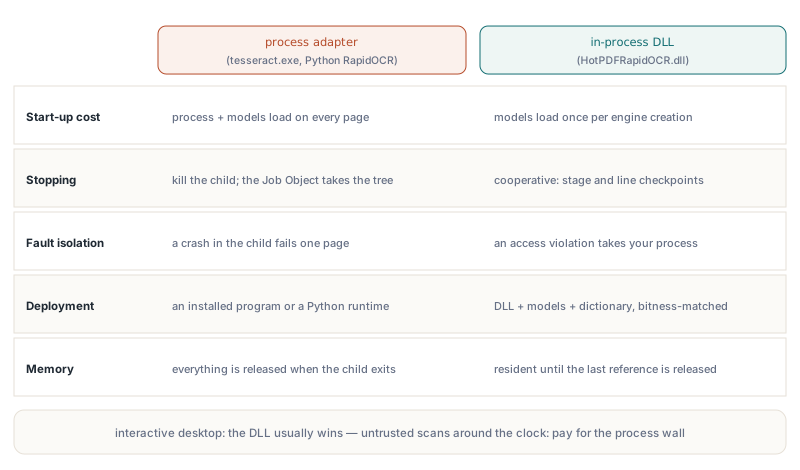
- Costo de arranque: los adaptadores Tesseract y RapidOCR Python lanzan un proceso y cargan modelos por cada página; el DLL carga modelos una vez por engine
- Detención: un proceso hijo se puede terminar sin más, y el worker Python corre dentro de un Job Object kill-on-close así que todo su árbol de proceso se va con él; el DLL se detiene en checkpoints de etapa y de línea
- Contención de fallas: un crash en
tesseract.exehace fallar una página; una access violation dentro del DLL se lleva su proceso abajo - Despliegue: los adaptadores de proceso necesitan un programa instalado o un entorno Python; el DLL se necesita a sí mismo, sus modelos y su diccionario, acordes al bitness de la aplicación
- Memoria: un adaptador de proceso libera todo cuando el hijo sale; un engine DLL mantiene sus modelos residentes hasta que la última referencia de interfaz desaparece
Elija el DLL para una aplicación de escritorio interactiva que aplica OCR a una página por vez y necesita un botón de Stop responsivo que regrese dentro de una etapa de inferencia. Para un server que ingiere escaneos no confiables las 24 horas, pague el costo de arranque por página y conserve la frontera de proceso; una imagen maliciosamente construida que tumba un reconocedor debería costar una página, y con un proceso hijo lo hace
Compilar HotPDFRapidOCR.dll y elegir modelos
HotPDFRapidOCR.dll se compila desde las fuentes C++ en Native/RapidOCR con MSVC, C++17, un Windows SDK y CMake 3.20 o posterior. El helper tools/Build-HotPDFRapidOCR.ps1 toma los directorios de la fuente nativa, ONNX Runtime y OpenCV más -Platform Win32 o Win64, y escribe el resultado en Lib/Native/RapidOCR/<Platform>/. Compile ambos si distribuye ambos. Una aplicación Delphi de 32 bits no puede cargar un DLL de 64 bits, y las librerías estáticas que provisione deben coincidir con la arquitectura objetivo y también con el modo de CRT
Los modelos tienen sus propias reglas de compatibilidad. El detector es un DB text detector. El reconocedor acepta modelos CTC en layout NCHW con altura de entrada fija de 32 o 48, y usa 48 cuando el modelo declara altura dinámica. El formato del modelo tiene que ser uno que el ONNX Runtime enlazado estáticamente entienda; exportaciones más nuevas como PP-OCRv5 pueden requerir un runtime más nuevo, y un modelo ilegible falla en la inicialización con un diagnóstico. tools/Install-RapidOCRModels.ps1 instala packs PP-OCRv3 y PP-OCRv4 verificados contra hashes SHA256 fijados, con detector y clasificador compartidos bajo los nombres de archivo que Default espera. Quédese con esos packs salvo que usted también controle el build del runtime
El diccionario debe ser UTF-8 sin BOM, en exactamente el orden de caracteres del modelo, y su conteo de entradas debe coincidir con las clases de salida del modelo. Los fines de línea CRLF están bien. Cuando un modelo incrusta su propia lista de caracteres en metadatos, la inicialización compara cada entrada y su posición contra el archivo de diccionario, así que un diccionario que solo tenga la longitud correcta igual falla. El DLL nunca descarga un modelo faltante
HotPDF incluye el adaptador RapidOCR nativo junto con los adaptadores OCR basados en proceso, el page renderer que los alimenta y el escritor de la capa de texto Unicode invisible, todo dentro de un componente VCL nativo para Delphi y C++Builder. Para software de captura y archivado que tiene que producir PDF buscable en máquinas sin Python instalado, el componente PDF de HotPDF para Delphi deja solo el DLL y sus archivos de modelo por desplegar