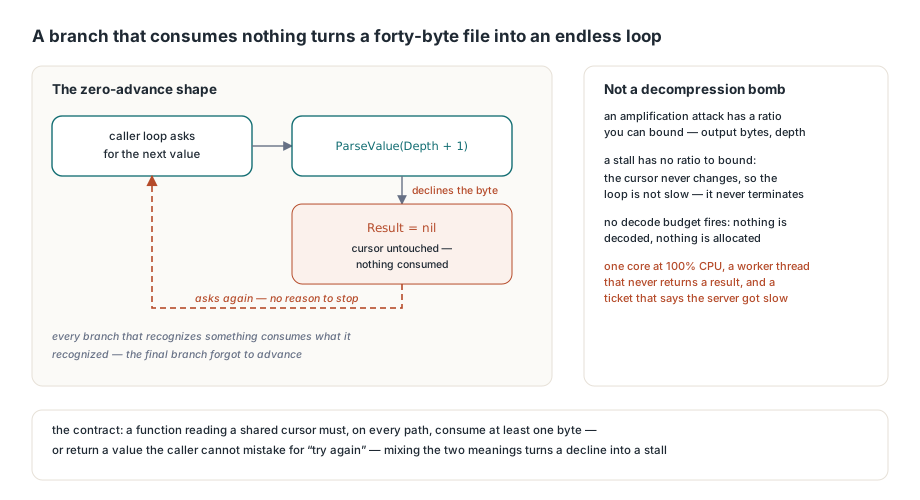
Un parser se cuelga con un PDF malformado cuando alguna rama lee un byte, decide no manejarlo y vuelve sin mover el cursor. El loop del caller no ve progreso ni razón para detenerse, así que gira para siempre. HotPDF publicó exactamente ese defecto en tres parsers independientes, todos alcanzables desde inputs de menos de cincuenta bytes
Esta es una clase de denial-of-service que vale la pena nombrar aparte, porque no parece la que todo el mundo ya se protege de tener. No hay descompresión, no hay crecimiento de asignaciones, no hay presión de memoria que dispare un watchdog. El proceso solo se queda al cien por ciento de CPU en un core con un puñado de bytes en un buffer. Si agregaste un decode budget después de leer sobre la amplificación de filtros anidados y las PDF bombs, ese budget no va a dispararse acá: no se está decodificando nada y no se está asignando nada. Falla distinta, fix distinto
¿Por qué un archivo de cuarenta bytes cuesta más que una bomba de descompresión?
Porque el costo no tiene ninguna relación con el tamaño del input. Un ataque de amplificación tiene un ratio que puedes acotar: limita los bytes de salida, limita la profundidad de recursión, y el peor caso se vuelve finito. Un loop de avance cero no tiene ratio que acotar. La condición del loop es función de un cursor que nunca cambia, así que no es lento, es no-terminante, y ningún límite basado en tamaño aguas arriba lo va a atrapar. Eso también lo hace operativamente único en su fealdad. Un crash te da un stack, un out-of-memory te da una línea de log, y un parser detenido te da un worker thread que nunca devuelve un resultado, una petición que nunca expira porque nada aguas abajo sabe que empezó, y un ticket que dice que el servidor se puso lento el martes. La causa estructural siempre tiene la misma forma. Un tokenizer o parser de valores tiene una cadena de ramas con llave en el byte actual. Cada rama que reconoce algo consume lo que reconoció. Después hay una rama final, o una guarda antes de la cadena, que vuelve por los bytes que nadie reclamó, y el autor la razona como un camino de error y no como un paso de escaneo. Los caminos de error vuelven. Los pasos de escaneo avanzan. Cuando una función tiene que ser ambas cosas, el avance es lo que se olvida
El parser de objetos: dos delimitadores que nadie consumió
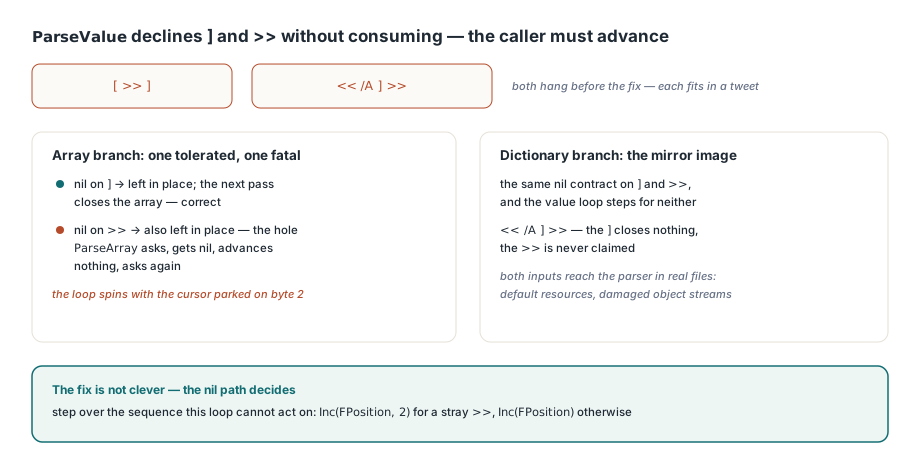
En HPDFParser, el método THPDFSpanObjectParser.ParseValue empieza declinando dos secuencias de bytes de plano. Según la sección 7.3 de ISO 32000-1, un valor no puede empezar con ] ni con >>, porque esos cierran un contenedor en lugar de abrir un valor, así que ParseValue vuelve nil para ambos sin consumirlos. Ese es el contrato correcto, y pone toda la carga de avanzar en el caller. La rama de arreglo honró la mitad: en un resultado nil revisaba por ], lo dejaba en su lugar para que la pasada siguiente cerrara el arreglo, y saltaba sobre todo lo demás — salvo que el chequeo resultó escrito de tal forma que un >> suelto también quedaba en su lugar. Así que [ >> ] se cuelga, porque ParseArray pide un valor, obtiene nil, no avanza nada y vuelve a pedir. La rama de diccionario tenía el agujero en espejo, y << /A ] >> se cuelga igual. Ambos inputs son lo bastante válidos para llegar al parser y lo bastante cortos para caber en un tweet
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // Antes del fix, ninguna de las dos llamadas de abajo volvía jamás
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
El fix no es ingenioso, y ese es el punto: el camino nil tiene que decidir, explícitamente, cuál de las dos secuencias no consumidas el loop actual puede procesar, y saltar sobre la otra
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue vuelve nil tanto para ']' como para '>>' sin consumirlos.
  // El ']' cierra el arreglo en la pasada siguiente, pero un '>>' suelto
  // dentro de un arreglo hay que saltarlo o el parseo nunca avanza
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;
Una cosa más merece atención acá. THPDFSpanObjectParser.RecordError solo incrementa ErrorCount en THPDFParserViewStatistics; no limita nada. El parser pone HPDFParserMaximumDepth en 64 para acotar el anidamiento, pero no tiene techo equivalente para la cantidad de errores, y un contador que nadie lee nunca es un circuit breaker perdido. Incluso con el avance restaurado, un input que produce un error por byte va a masticar un objeto grande a una velocidad que merece una salida temprana en lugar de un recorrido completo. Revisa Valid en el record de estadísticas después de cada parseo y trata un ErrorCount grande como razón para dejar de confiar en el objeto, no solo como un diagnóstico
La misma forma en el tokenizer de CMap y el reader de XFDF
HPDFCMapReader.NextToken llevaba el defecto idéntico en su rama de fallback. La función devuelve un TCMapTok y maneja <, ( y / con ramas dedicadas; todo lo demás cae a «leer hasta whitespace o delimitador». Cuando el byte inicial es en sí un delimitador del conjunto de la sección 7.2.2 de ISO 32000-1, ese loop corre cero veces, el token vuelve vacío, y el caller pide el mismo token de nuevo. De los seis caracteres que pueden caer ahí, solo [ lo interceptaba antes el manejo de bfrange, así que un ), >, ], { o } suelto en cualquier CMap ToUnicode bastaba para colgar la extracción de texto
// keyword o número: lee hasta whitespace o delimitador
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// Un delimitador que ninguna rama de arriba reclama (un ')', '>',
// '[', ']', '{' o '}' suelto) dejaría P donde estaba y volvería un
// keyword vacío, así que el caller pediría el mismo token para siempre
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
El lado XFDF tenía una variante con otro origen y el mismo efecto. HPDFXFDFXml.ParseElement pone Result := P al inicio, mientras P todavía apunta al < de apertura, y recién después incrementa su cursor local, así que toda salida temprana que sigue devuelve la posición de entrada salvo que sobrescriba Result antes. Una declaración de doctype según la sección 2.8 de XML 1.0, o cualquier otra cosa sin un nombre de tag parseable como <1a>, tomaba una salida que nunca actualizaba Result, y el loop de elementos hijos recibía la posición que había pasado. El loop de atributos tenía tres más de estos, porque ReadName, el skip de whitespace y el manejo de = declinan todos un byte que no es carácter de nombre, ni whitespace, ni uno de =, >, /, y ninguno lo consumía. La reparación vecina de CDATA movió una responsabilidad en lugar de agregar una guarda: una sección CDATA según la sección 2.7 de XML 1.0 empieza con <, así que el loop de hijos solía pasársela a ParseElement, que después leía un nombre de tag del contenido de la sección. Reconocerla en el loop de hijos con IsCDATAStart y copiar bytes al buffer de texto hasta IsCDATAEnd es la división correcta, y el skip viejo además medía un byte de largo, porque el marcador tiene ocho bytes contados desde el !
Contadores declarados que sobreviven a los datos
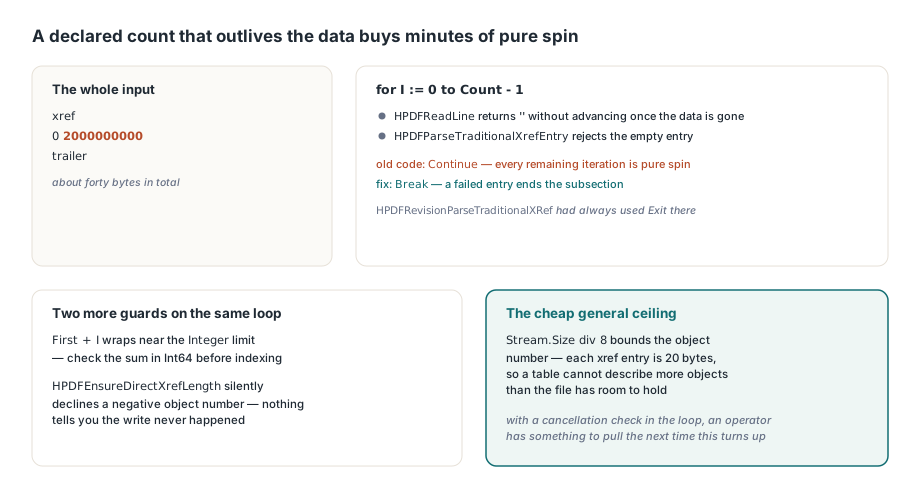
Una release posterior sacó a la luz el mismo patrón desde la dirección opuesta, y es la variante con más probabilidades de existir en tu propio código. Un header de subsección de cross-reference según la sección 7.5.4 de ISO 32000-1 es un par first count, y los dos parsers de xref tradicional de HotPDF loopeaban for I := 0 to Count - 1 sobre él, usando Continue y no Break cuando una entrada fallaba al parsear. Eso se lee como tolerancia a una línea mala. No lo es: HPDFReadLine devuelve una string vacía sin avanzar una vez que los datos se agotan, y HPDFParseTraditionalXrefEntry rechaza una entrada vacía de inmediato, así que cada iteración restante del conteo declarado es giro puro. La aritmética es despiadada — el header xref\n0 2000000000\ntrailer más un wrapper mínimo son unos cuarenta bytes, y compran decenas de segundos de un core ocupado sin ningún chequeo de cancelación en el loop. La pista estaba en la misma unit, porque HPDFRevisionParseTraditionalXRef siempre había usado Exit en esa posición. Cuando dos funciones parsean la misma gramática y no se ponen de acuerdo sobre si una entrada fallida termina la subsección, una de las dos es un fork que dejó de recibir los fixes, la misma firma que aparece en el manejo de cross-references híbrido donde una tabla tradicional y un stream describen los mismos objetos
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // Un conteo declarado mayor que la tabla giraría si no,
  // acá sin datos que leer
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // First viene del header de la subsección, así que la suma envuelve para un
  // inicio declarado cerca del límite de Integer, y el helper de crecimiento
  // rechaza en silencio un índice negativo
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... registra la entrada ...
end;
Los dos límites después del Break pertenecen a la misma reparación. HPDFEnsureDirectXrefLength se niega a crecer el arreglo por un número de objeto negativo y no dice nada al respecto, y First + I envuelve para un inicio declarado cerca del límite de Integer, así que un índice negativo llega a las escrituras de abajo. El techo de número de objeto de Stream.Size div 8 es la respuesta general barata, porque ninguna tabla de cross-reference tradicional puede describir más objetos de los que el archivo tiene espacio para contener, y cualquier header que afirme otra cosa está describiendo un archivo que no existe. Si estás reparando a mano una tabla dañada, el mismo razonamiento aplica desde el otro lado, que es el territorio cubierto en las notas sobre diagnosticar y reparar PDFs editados a mano
¿Cómo pruebas que un fix de cuelgue de verdad funciona?
Corriendo el código viejo, no releyéndolo. Un stall es una de las pocas clases de defecto donde un fix se puede verificar con una señal binaria y sin instrumentación, porque el proceso o vuelve o no vuelve, y razonar sobre el control flow es exactamente la habilidad que produjo el bug en primer lugar. La mecánica vale la pena copiarla. Extrae la revisión pre-fix de las units cambiadas a un directorio scratch, y después compila un probe pequeño con el search path de units poniendo ese directorio delante de la librería real: dcc32 -U<scratchdir>;<Lib> probe.dpr. El compilador toma las fuentes viejas para lo primero que encuentra y las fuentes actuales para todo lo demás, así que un solo binario de probe ejercita el parser viejo contra el resto de la librería. Córrelo bajo un timeout — cuarenta segundos es generoso — y trata el exit code 124 como la aserción. Después retira las units del directorio scratch de a una y recompila. Los tres stalls se reprodujeron así, cada uno atribuible a una unit específica, y los tres volvieron cuando la fuente arreglada estaba de vuelta en el path, a costo de un compile por unit
Dos trampas conviene conocer antes de intentarlo. El search path de units es silenciosamente permisivo: pásale a -U un path estilo Unix desde un shell, como $PWD, y el compilador ignora ese directorio sin decir palabra, lo que significa que tu probe compiló contra las fuentes actuales y pasó por la razón equivocada. Convierte el path a forma nativa de Windows primero. La segunda es que el directorio scratch no trae los include files, así que también necesitas -I<Lib> para HotPDF.inc o el build falla de una forma que parece problema de fuente y no de path. Y sé honesto sobre lo que el método no te da: confirma que un input específico dejó de colgarse en un build específico, y no dice nada sobre los inputs que no se te ocurrieron. Los defectos de avance cero se encuentran fuzzeando o leyendo cada rama de cada tokenizer, no con tests de regresión escritos a posteriori
Qué auditar en tus propios parsers
La regla reutilizable es un contrato, no un ítem de checklist. Toda función que lea de un cursor compartido debe, en cada camino incluidos sus caminos de fallo, o consumir al menos un byte o devolver un valor que el caller no pueda confundir con «inténtalo de nuevo». Mezclar esos dos significados en un solo nil o en un solo token vacío es lo que convierte una declinación en un stall. Así que audita por la forma y no por el síntoma. Encuentra todo loop cuya terminación dependa de un cursor que es dueño de otra función, y pregúntate qué pasa cuando esa función rechaza el byte actual. Encuentra toda rama de fallback escrita como «leer hasta X» y pregúntate qué hace cuando el cursor ya está sobre X. Encuentra todo loop acotado por un conteo que salió del archivo y no de los datos, y haz que un elemento fallido termine el loop en lugar de saltear una iteración. Donde la misma gramática se parsea en dos lugares, diféalos, porque uno habrá recibido un fix que el otro no. Y pon un chequeo de cancelación dentro de todo loop que pueda correr por una cantidad de iteraciones suministrada por el caller, para que un operador tenga algo a qué tirar cuando el próximo de estos aparezca en producción
Los parsers que se describen acá viajan en el HotPDF Delphi Component actual para Delphi y C++Builder, con los records de estadísticas y los límites de profundidad expuestos para que tu propio hardening pueda construirse sobre ellos