Abra un PDF que produjo Microsoft Word o Excel, hojee página por página, y nada se ve inusual. Cárguelo en un programa Delphi, lea el conteo de páginas, y el número es correcto. Luego re-grábelo con cifrado activado y el paso de guardado lanza una excepción, o la salida abre con una advertencia de cross-reference dañado. El archivo nunca estuvo corrupto. Es un archivo de referencia híbrida, y la misma estructura que le permite abrirse a un visor de quince años atrás es la que derrota a un loader que deja de leer demasiado temprano
Esta es una de las maneras más comunes en que un pipeline de PDF que pasó todos los tests internos conoce un archivo que no puede hacer round trip. Los inputs se generaron todos internamente, así que nunca fueron híbridos. El primer archivo híbrido llega el día que un cliente reenvía una factura exportada desde una hoja de cálculo
Lo que Word y Excel escriben en realidad
ISO 32000-1 describe el layout de referencia híbrida en §7.5.8.4. Una aplicación que quiere features de PDF 1.5 como object streams, mientras deja que un lector PDF 1.4 abra el archivo, escribe la información de cross-reference dos veces. Está la tabla de cross-reference clásica, las filas ASCII de ancho fijo que cerraban todo PDF hasta la versión 1.4, y está un cross-reference stream que indexa el resto. El trailer de la sección clásica carga una entrada /XRefStm cuyo valor es el offset en bytes de ese stream
La división del trabajo es deliberada. Los objetos que un lector viejo tiene que alcanzar, el catálogo y el árbol de páginas entre ellos, son direccionables desde la tabla clásica. Los objetos que se doblaron en compressed object streams están marcados libres en la tabla clásica, con una entrada de tipo f, así que un lector 1.4 los salta de largo y jamás tropieza con una estructura que no puede parsear. Sus ubicaciones reales viven solo en el cross-reference stream. La firma de tal archivo es su cola: una sección clásica corta que cubre solo los objetos que un lector legado necesita, cuyo trailer apunta al /XRefStm donde se sientan los datos de recuperación reales
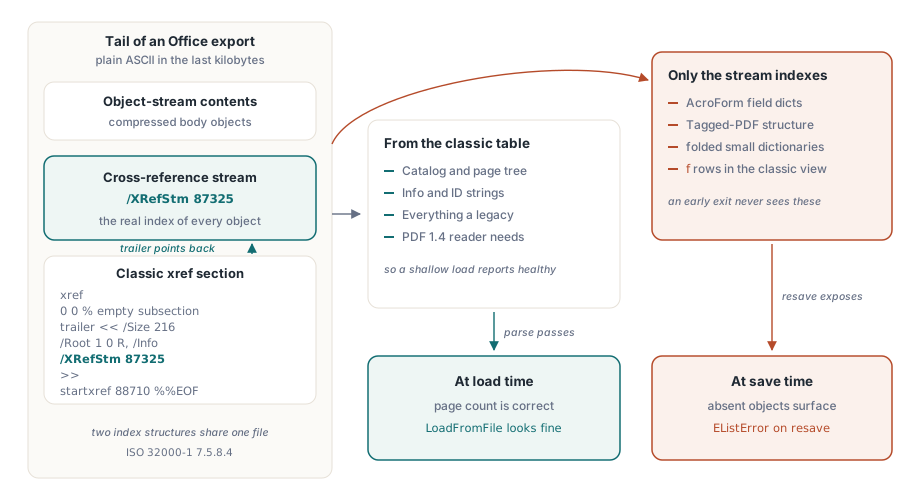
/XRefStm de su trailer lleva al stream que guarda el resto del índice de objetosPor qué un conteo de páginas correcto no prueba nada
Porque el catálogo y el árbol de páginas son alcanzables desde la tabla clásica a propósito, un loader que lee solo esa tabla encuentra /Root, camina el árbol de páginas, y reporta el número correcto de páginas. Todo lo que un lector viejo necesita está presente, así que el archivo luce sano. Los objetos que faltan son los que se empacaron en object streams: diccionarios de fields de AcroForm, elementos de estructura de PDF etiquetado, la larga cola de diccionarios chicos que jamás tuvieron que ser visibles para un visor legado
Uno no nota el hueco hasta que algo toca esos objetos, y un resave completo los toca todos. Recorrer el documento para re-cifrarlo o reescribirlo es precisamente la operación que pide cada número de objeto por turno, razón por la cual el síntoma sale a la luz al momento de guardar y no al cargar, lejos de su causa
La trampa es un detector que ve xref y se detiene
La manera barata de decidir cómo está indexado un archivo es seguir startxref e inspeccionar los primeros bytes a los que apunta. La palabra clave xref significa tabla clásica; un objeto stream significa un cross-reference stream. Ese test es correcto para cualquier archivo que se comprometa a un solo esquema. Es incorrecto para un archivo híbrido, cuyo startxref apunta a una sección clásica con el único propósito de satisfacer a los lectores viejos, mientras el /XRefStm en el trailer de esa sección es donde está indexada la mayor parte del documento. Un detector que devuelve "clásica" en el primer xref que encuentra jamás lee el /XRefStm, y cada objeto que vive solo en el stream se vuelve invisible
var
  Pdf: THotPDF;
  PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('Invoice_XLS.pdf');  // las páginas son alcanzables desde la tabla clásica
    // inspeccione o edite aquí el documento cargado
    Pdf.SaveLoadedDocument('Invoice_secured.pdf');     // necesita cada objeto, también los de solo-stream
  finally
    Pdf.Free;
  end;
end;
Corra esa secuencia sobre un loader construido alrededor del detector de salida temprana y la carga se ve bien; el resave es donde los objetos ausentes se anuncian. El arreglo no es leer más bytes al principio; es reconocer el trailer híbrido y seguir el /XRefStm antes de decidir que el archivo está completo
El orden de mezcla no es negociable
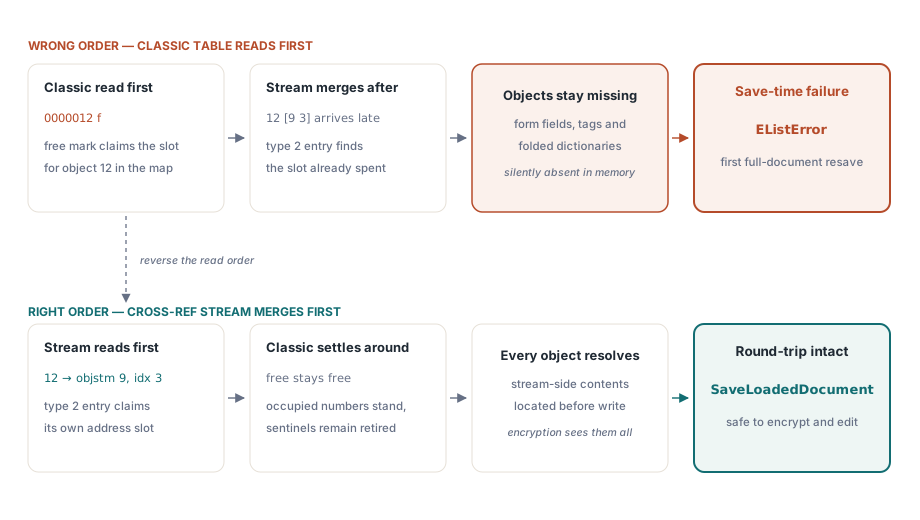
Una vez leídos ambos índices, solo se pueden combinar en una dirección. El cross-reference stream tiene que mezclarse primero, con las entradas clásicas rellenadas alrededor. La razón es el pequeño engaño en el corazón del formato. Un archivo híbrido marca sus objetos comprimidos como libres en la tabla clásica para que los lectores viejos los ignoren. Un loader que honra una política de primero-gana y lee la tabla clásica primero registrará esos números de objeto como libres, y luego descartará las entradas del stream que en realidad los localizan, porque los slots ya están tomados. Invierta el orden y las entradas de tipo 2 del stream, cada una un número de object stream más un índice, ganan los slots que se supone les pertenecen, y las entradas clásicas se acomodan alrededor
La misma disciplina protege contra una revisión más vieja resucitando un objeto borrado. Las actualizaciones incrementales se encadenan hacia atrás vía /Prev, y una entrada libre de tipo 0 es un centinela que una sección más reciente retiró un número de objeto. No se debe permitir que una sección posterior pero más vieja de la cadena sobrescriba ese centinela con una ubicación rancia. Trate el primero visto como autoridad para los marcadores libres y el objeto borrado sigue borrado; trátelo con descuido y la propia historia de un archivo reanima contenido que la última revisión eliminó
Cómo se separan las dos vistas
Todo eso asume que los dos índices están de acuerdo. Recién salido de Word, lo están: cada vista describe el mismo documento dentro del alcance que declara. El problema empieza cuando el archivo pasa por una herramienta que entiende solo una de ellas. Las utilidades de estampado son las sospechosas de siempre. Una agrega una actualización incremental de estilo clásico con unos pocos objetos nuevos, una nueva sección xref, un link /Prev hacia la sección anterior, y un trailer fresco. Si ese trailer suelta el /XRefStm, la vista del stream queda huérfana. Si copia el valor viejo hacia adelante, la vista del stream todavía describe el documento como estaba antes del estampado. De cualquier manera, los índices ahora discrepan
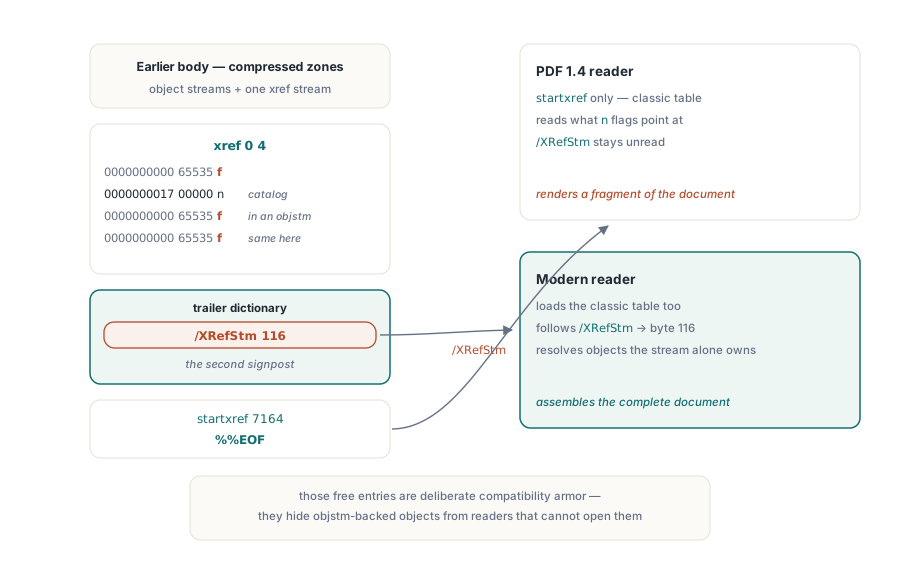
La firma es fácil de reconocer una vez que la conoce. Los objetos visibles por una vista faltan o están rancios en la otra. Un lector que resuelve vía el stream encuentra la versión pre-edición de un objeto actualizado, o ninguna entrada para uno agregado. Un lector que confía solo en la tabla ve la edición pero pierde cada objeto comprimido que solo el stream podía localizar. Los usuarios lo describen como form fields que aparecen en un visor y desaparecen en otro, anotaciones que la pasada de estampado parece haber borrado, o lookups que aterrizan en el objeto equivocado por completo
Adobe Acrobat es lo que hace que estos archivos cuesten tanto perseguir. Cuando el índice declarado discrepa con los bytes, Acrobat suele reconstruir en silencio los datos de cross-reference escaneando headers de objetos, así que quien produjo el archivo roto lo abre, no ve nada malo, y lo manda adelante. El fallo sale a la luz después y en otro lugar — un validador de preflight, un servicio de firma, un job de ingesta archivística — cualquier consumidor que confía en la estructura declarada y reporta objetos faltantes o un mismatch de cross-reference. "Abre bien en Acrobat" es cómo empieza casi todo ticket de desincronización híbrida
Lo que esto significa en HotPDF
El motor resuelve los archivos de referencia híbrida por usted, y lo hace en cada camino que tiene que parsear los datos de cross-reference. Cargue un documento con LoadFromFile o LoadFromStream, haga sus cambios, y llame a SaveLoadedDocument; o corra una operación de una sola pasada como EncryptFile que lee un input y escribe un output. De cualquier manera la recuperación lee el /XRefStm, mezcla la sección del stream antes de las entradas clásicas, y resuelve los objetos que viven en streams antes de que la escritura los enumere. El camino de cifrado AES-256 es donde esto se ve más claramente, porque cifrar un documento reescribe cada objeto y exige que cada objeto ya esté localizado
// De una pasada: lea el input híbrido, escriba una copia cifrada AES-256
Pdf.EncryptFile('Letter_DOC.pdf', 'Letter_secured.pdf',
  'owner-secret', '', aes256, [prPrint, prFillAnnotations]);
El detalle que vale llevarse se sienta río arriba de la API. Los archivos que llegan de Word, Excel, PowerPoint, y una larga lista de pipelines de "Guardar como PDF" son rutinariamente híbridos, así que un loader que usted ejercita solo contra la salida de su propio generador puede que jamás conozca uno en testing. Siembre sus fixtures con documentos exportados de aplicaciones Office reales, no solo con archivos que produjo su propio código
Cómo revisar un archivo que sospecha
Dos inspecciones resuelven la pregunta rápido. Abra el archivo en una vista hex y lea los bytes después del último startxref; un archivo híbrido muestra una sección clásica corta cuyo diccionario trailer contiene /XRefStm. O compare el conteo de objetos que reporta un parse completo contra el número de objeto más alto que /Size declara en el trailer. Un hueco grande significa que hay objetos escondidos en streams que el loader no abrió, que es el mismo faltante que luego se convierte en un fallo al guardar
La cola de una exportación típica de Excel vuelve concreta la primera revisión. Todo lo que va después del último xref es ASCII plain, así que la firma se lee directo de una vista hex (offsets ilustrativos, anotaciones agregadas)
xref
0 16                         % objetos 0-15: lo que necesita un lector legado
0000000000 65535 f
0000000017 00000 n
...                          % 14 filas más; el resto vive en object streams
trailer
<< /Size 216                 % uno más allá del número de objeto más alto en uso
   /Root 1 0 R
   /Info 15 0 R
   /ID [<5C9A...> <5C9A...>]
   /XRefStm 87325            % offset en bytes del cross-reference stream
>>
startxref
88710                        % apunta a la sección clásica de arriba
%%EOF
La clave /XRefStm en el trailer es la señal. La sección clásica de arriba lista 16 de los 216 números de objeto que usa el archivo; todo lo empacado en object streams o falta de ella o está marcado libre. Un detector que se detiene en la palabra xref ha visto, a este punto, solo ese índice parcial. Cuando prefiera scriptear la revisión en vez de mirarla a ojo, el marcador se sienta dentro de los últimos pocos kilobytes del archivo, así que una lectura hacia atrás acotada basta. Si el archivo luego se actualizó incrementalmente, la cola guarda más de un trailer, y el que cuenta es el último
// Devuelve el offset de /XRefStm desde el trailer más nuevo en la cola del archivo,
// o -1 si el marcador falta (el archivo no es híbrido, o no es un PDF para nada)
function FindXRefStm(const FileName: string): Int64;
var
  FS: TFileStream;
  Tail: AnsiString;
  Len, P, Q: Integer;
begin
  Result := -1;
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Len := 2048;                        // el trailer vive en la cola
    if FS.Size < Len then
      Len := Integer(FS.Size);
    FS.Position := FS.Size - Len;       // lectura hacia atrás acotada: 2 KB máximo
    SetLength(Tail, Len);
    FS.ReadBuffer(Tail[1], Len);
  finally
    FS.Free;
  end;
  P := 0;                               // conservar el último marcador: incremental
  Q := Pos(AnsiString('/XRefStm'), Tail); // las updates agregan trailers más nuevos
  while Q > 0 do
  begin
    P := Q;
    Q := Pos(AnsiString('/XRefStm'), Tail, P + 1);
  end;
  if P = 0 then
    Exit;                               // no hay marcador híbrido en la cola
  Inc(P, Length('/XRefStm'));
  while (P <= Len) and (Tail[P] in [' ', #9, #13, #10]) do
    Inc(P);                             // saltar whitespace después de la clave
  Result := 0;
  while (P <= Len) and (Tail[P] in ['0'..'9']) do
  begin
    Result := Result * 10 + Ord(Tail[P]) - Ord('0');
    Inc(P);
  end;
end;

// Uso: un resultado no negativo nombra el byte donde empieza el stream
if FindXRefStm('Invoice_XLS.pdf') >= 0 then
  Writeln('hybrid-reference file: resave will need the /XRefStm section');
Trate la sonda como triage, no como parser: le dice qué archivos de un lote merecen atención antes de que corra un job de resave, y nada más
Apúntela a una carpeta de inputs reales y los archivos se reparten en tres grupos. Un archivo solo-clásico tiene la palabra trailer en su cola pero ningún /XRefStm, así que la sonda devuelve -1. Un archivo que se compromete por completo a cross-reference streams también devuelve -1, correctamente. No tiene ninguna palabra trailer, porque sus claves de trailer viven en el diccionario del stream. Solo el layout de doble índice rinde un offset. Si su reporte de triage necesita distinguir los primeros dos grupos, busque trailer en la misma cola antes de descartarla; una llamada más a Pos lo resuelve
Antes de que la sonda corra desatendida, endurézcala en dos lugares. Un offset es solo una afirmación. Vaya a él y confirme que un objeto cuyo diccionario dice /Type /XRef de verdad se sienta ahí, porque un archivo dañado o truncado puede seguir cargando la clave mientras el stream que nombra ya no está. Ese archivo pertenece a un cubo distinto del híbrido sano. El chequeo son unas pocas líneas encima del mismo manejo de archivo
// Offset es el valor que devolvió FindXRefStm; FS es un TFileStream abierto
// de la misma forma, Head un AnsiString (Min viene de System.Math)
if Offset >= FS.Size then
  Exit(False);                          // la clave sobrevivió, el stream no
FS.Position := Offset;
SetLength(Head, Integer(Min(Int64(512), FS.Size - Offset)));
FS.ReadBuffer(Head[1], Length(Head));
Result := (Pos(AnsiString('/Type /XRef'), Head) > 0) or
  (Pos(AnsiString('/Type/XRef'), Head) > 0);  // la sintaxis PDF permite ambas grafías
Después haga de la ventana de 2 KB un parámetro. Dos kilobytes cubren la salida ordinaria de Office, pero un diccionario trailer inusualmente grande puede empujar el marcador fuera de rango, y ensanchar la ventana supera declarar el archivo clásico por accidente
Enrutar archivos híbridos por un pipeline
La detección rinde cuando cambia hacia dónde va un archivo después. Hacia dónde depende de lo que el pipeline está por hacer con él
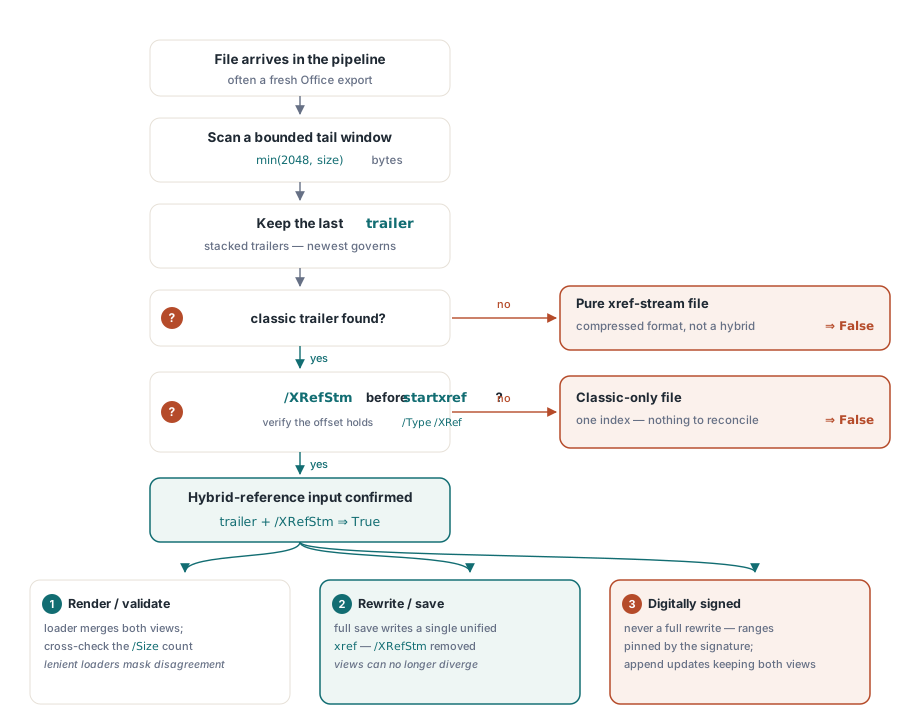
Los archivos que solo se leen, renderizan o validan deberían ir a un loader que resuelve ambas vistas. El PDFium Component parsea la cadena de /XRefStm durante la carga, así que la tabla de objetos que su código ve ya es la mezclada, y los chequeos de nuestro artículo sobre validar object y cross-reference streams aplican sin cambios. Cuando un híbrido desincronizado está dañado lo suficiente como para negarse a cargar, el motor lo reporta vía su código de error de carga, y FPDF_ERR_FORMAT es el que produce el daño estructural. Una carga limpia es evidencia más débil. PDFium es leniente por diseño y reconstruye la mayoría de los archivos inconsistentes sin comentario, así que el éxito prueba que el archivo era recuperable y no dice nada sobre si sus dos vistas están de acuerdo. Para esa pregunta, vuelva a comparar lo que encuentra un recorrido completo de objetos contra el /Size del trailer
Los archivos que el pipeline modifica son otra historia. Nuestra preferencia aquí es directa: dejar de ser híbridos del todo. Cargue el documento con HotPDF y guárdelo completo, y la salida carga una cross-reference única y autoconsistente en una sola forma. Sin /XRefStm, sin segunda vista que pueda derivar, cada objeto de propiedad de exactamente una entrada de índice. Esa normalización es lo que usted quiere antes de una ingesta archivística, antes de un RIP o servicio de firma estricto río abajo, y después de cualquier edición aplicada a un input híbrido. Se apoya por completo en la mezcla stream-primero descrita antes, ya que un guardado completo solo puede escribir los objetos que la carga logró localizar
Los documentos firmados son la excepción. Una reescritura completa mueve cada byte, lo que invalida cualquier firma computada sobre los rangos de bytes originales. Un cambio a un híbrido firmado tiene que entrar como una actualización incremental propiamente dicha que mantiene ambas vistas en paso, y un archivo firmado que solo necesita leerse debería pasar por el pipeline sin tocar
El lado del escritor de esta historia, cómo se producen en primer lugar los object streams y las cross-references comprimidas, está cubierto en nuestro artículo sobre object streams y actualizaciones incrementales. Cuando el archivo híbrido en cuestión además es muy grande, las técnicas de carga de el recorrido de la Direct File API para workflows de PDF grandes le permiten inspeccionarlo sin leerlo entero a memoria. Ambos se emparejan naturalmente con la recuperación descrita aquí, que viene como parte del HotPDF Delphi Component para Delphi y C++Builder junto con las APIs de carga, edición, cifrado y firma cubiertas en otros lugares de este blog