El primer objeto de un PDF linealizado tiene que declarar la longitud exacta del archivo en el que vive, al byte, y tiene que aparecer dentro de los primeros 1024 bytes. El Anexo F de ISO 32000-1 llama /L a esa entrada, y a un lector que la encuentra en desacuerdo con el tamaño real del archivo se le ordena tratar el documento como un PDF ordinario e ignorar cada sugerencia de linealización adentro. Así que el writer tiene que imprimir la longitud de un archivo que todavía no terminó de escribir, junto al offset de un stream de sugerencias, el final de la primera página y la posición de una tabla de referencias cruzadas cerca del final del archivo. Los cuatro números se mueven cada vez que algo delante de ellos cambia de tamaño
La recompensa es Fast Web View. Un PDF ordinario guarda su tabla de referencias cruzadas al final, así que un navegador que recibe un reporte escaneado de 200 páginas no puede ubicar la página 1 hasta que llega el último byte; un archivo linealizado mueve la página 1 y una pequeña sección de referencias cruzadas al frente, así que un cliente que usa peticiones de rango HTTP pinta la primera página temprano. Lo que sigue es el lado de la escritura. El cuadro del lado del lector está en la explicación de la linealización de PDF y Fast Web View
Cómo HotPDF organiza el layout de un archivo linealizado
HotPDF escribe salida linealizada cuando THotPDF.LinearizeOutput está en True, y el archivo sigue el orden físico que prescribe el Anexo F, parte por parte. Después del encabezado viene el diccionario de parámetros de linealización, luego la sección de referencias cruzadas de la primera página y su trailer, el catálogo con los demás objetos a nivel de documento, el stream de sugerencias primario, la primera página con cada objeto que necesita, las páginas restantes en orden, los objetos compartidos entre páginas posteriores, todo lo demás, y al final la tabla principal de referencias cruzadas
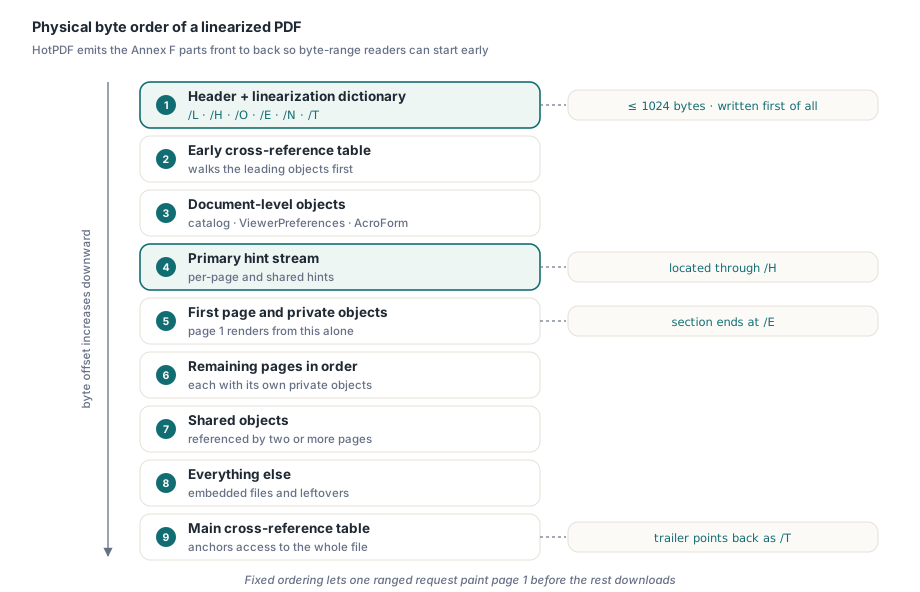
Nada en el modelo de documento dice a qué parte pertenece un objeto. El writer lo deduce del grafo de referencias cuando EndDoc guarda, caminando desde cada objeto de página y contando cuántas páginas alcanzan cada objeto indirecto. Un objeto alcanzado desde una página va a la sección de esa página. Un objeto alcanzado desde varias páginas es compartido, con un giro que una lectura rápida de la especificación se pierde: cuando la página 1 está entre las páginas que lo usan, el objeto va de todos modos a la sección de la primera página, porque la página 1 tiene que renderizarse solo con los bytes del comienzo. Solo los objetos compartidos puramente entre páginas posteriores esperan en la parte compartida. El catálogo, todo aquello a donde apunten sus entradas /ViewerPreferences, /OpenAction, /Threads y /AcroForm, y el diccionario de cifrado de un documento protegido forman el grupo a nivel de documento. Los nodos del árbol de páginas se empujan a la parte final para que nunca inflen la primera página
Abra la salida en un editor hexadecimal y la numeración se ve al revés. El bloque delantero, desde el diccionario de linealización hasta el stream de sugerencias, lleva los números de objeto más altos del archivo, mientras que todo lo que viene después se numera desde 1. La pequeña sección de referencias cruzadas del frente cubre exactamente ese bloque alto, y la tabla principal cubre del 1 al N
Una trampa de inicialización de records en las listas de partición
Listas como estas se escriben naturalmente como un record que guarda un arreglo dinámico más un conteo aparte, y esa forma esconde una trampa de Delphi. El compilador inicializa los campos managed de un record local. El Integer simple sentado al lado no recibe nada. En Win32 la ranura de la pila suele contener cero de casualidad, así que el primer anexado cae en el índice 0 y toda prueba pasa; en Win64 la ranura puede contener sobras y el primer anexado escribe en un índice arbitrario
type
  TPartList = record
    Values: TArray<Integer>;  // managed: lo limpia el compilador
    Count: Integer;           // unmanaged: lo que la pila tuviera
  end;

procedure Append(var List: TPartList; Value: Integer);
begin
  if List.Count = Length(List.Values) then
    SetLength(List.Values, List.Count * 2 + 16);
  List.Values[List.Count] := Value;
  Inc(List.Count);
end;

procedure BuildParts;
var
  FirstPage, Shared: TPartList;
begin
  FirstPage := Default(TPartList);   // obligatorio, no cosmético
  Shared := Default(TPartList);
  Append(FirstPage, 12);
  Append(Shared, 40);
end;
El writer de HotPDF asigna Default a cada lista de partición antes de tocarla. Una corrida en verde bajo Win32 no dice nada sobre si semejante record quedó inicializado
¿Por qué el layout tiene que converger antes de escribir el primer byte?
Porque el frente del archivo guarda offsets que apuntan hacia atrás, y la cantidad de dígitos de esos offsets desplaza todo lo que tienen detrás. El trailer de la primera página lleva una entrada /Prev con el offset en bytes de la tabla principal de referencias cruzadas. Escriba ese offset como 99998, descubra después que la tabla en verdad cae en 100003, y el trailer crece un dígito. La sección de referencias cruzadas de la primera página crece con él, cada objeto detrás se mueve un byte, y la tabla principal ahora queda en 100004. Una sola pasada acierta esto solo de suerte
HotPDF rompe el ciclo en dos movimientos. El diccionario de parámetros va a una ranura fija de 384 bytes rellena con espacios, así que /L, /H, /E y /T pueden tomar los dígitos que necesiten sin mover un solo objeto; si el texto del diccionario llegara a necesitar más de 384 bytes, la escritura lanzaría una excepción en lugar de desplazar el archivo. Eso deja a /Prev como la única variable libre, y pasa por un bucle de punto fijo. Cada objeto primero se serializa en un stream de conteo que registra longitudes y no guarda bytes. Una pasada de layout asigna offsets sección por sección y reporta dónde caería la tabla principal, y esa respuesta se vuelve la entrada de la siguiente pasada. El bucle se detiene cuando el offset propuesto deja de moverse y se rinde con una excepción después de ocho intentos
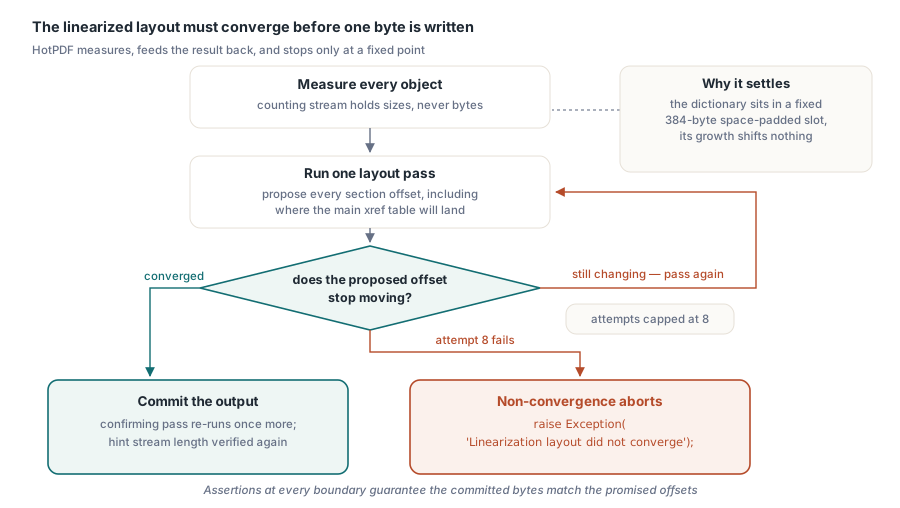
Solo un cambio en el conteo de dígitos mueve algo, así que una tercera pasada solo hace falta cerca de un límite de potencia de diez, como en el caso del 99998. Después de la convergencia el writer corre una pasada de confirmación, reconstruye el stream de sugerencias con offsets reales y verifica que su longitud no cambió; los offsets viven en campos de ancho fijo, así que la versión de marcador de posición y la final tienen que coincidir. Después la salida va derecha al stream de destino sin una segunda copia en buffer, y en cada frontera de sección los bytes escritos se comparan con el offset prometido. Un desajuste lanza una excepción desde EndDoc
Tablas de sugerencias, y dónde el Anexo F se lee de dos maneras
El stream de sugerencias primario lleva dos tablas. La tabla de sugerencias de offsets de página registra, para cada página, cuántos objetos guarda su sección, cuánto mide esa sección en bytes, y de qué objetos compartidos depende. La tabla de sugerencias de objetos compartidos lista la longitud de cada grupo de objetos compartidos. Con ambas, un lector puede pedir la página 37 directamente, y la entrada /S del stream da la posición dentro del stream donde arranca la tabla compartida
Dos detalles del Anexo F F.4 son fáciles de equivocar. El primero es que los offsets guardados en las tablas de sugerencias son offsets lógicos, calculados como si el stream de sugerencias primario no existiera. El objeto de la primera página y el primer objeto compartido están físicamente después del stream de sugerencias, así que el writer resta la longitud del objeto de sugerencias antes de registrar sus offsets. Un writer que registra offsets físicos en cambio deja cada petición de rango resultante desviada exactamente por el tamaño del objeto de sugerencias
El segundo es una ambigüedad genuina. El texto de F.4 describe cada tabla como un único flujo de bits continuo, con el bit más significativo primero, y lista los grupos compartidos de la primera página y los grupos compartidos posteriores como dos secuencias separadas. Los streams de sugerencias en circulación rellenan cada columna hasta un límite de byte y tratan los grupos compartidos como una sola lista combinada, y esa es la forma que se sabe que los lectores que consumen sugerencias aceptan. HotPDF escribe el layout alineado a bytes y combinado. Ese es el lado correcto que elegir: una tabla que cumple la letra de F.4 pero se desalinea para los clientes que la leen falla exactamente donde la linealización se supone que rendía, y una descarga de archivo completo jamás expone el problema
Activar la salida linealizada desde Delphi
Del lado de la API el interruptor es un Booleano. LinearizeOutput viene en False por omisión, y el writer lo consulta cuando EndDoc serializa el documento, así que fíjelo junto con las demás opciones de salida antes de BeginDoc y no lo toque más. Cada falla descrita arriba (no convergencia, un diccionario de parámetros demasiado grande, un desajuste de frontera, el techo de 4 GiB cubierto abajo) aparece como una excepción desde EndDoc, lo que hace un fallback directo
procedure WriteReport(const FileName: string; Linearize: Boolean);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.FileName := FileName;
    PDF.Version := pdf17;
    PDF.LinearizeOutput := Linearize;   // fije antes de BeginDoc
    PDF.BeginDoc;                       // crea la página 1
    PDF.CurrentPage.TextOut(72, 72, 0, 'Quarterly summary');
    PDF.AddPage;
    PDF.CurrentPage.TextOut(72, 72, 0, 'Details');
    PDF.EndDoc;                         // el layout y la escritura ocurren aquí
  finally
    PDF.Free;
  end;
end;

procedure PublishReport(const FileName: string);
begin
  try
    WriteReport(FileName, True);
  except
    on E: Exception do
    begin
      LogWarning('Linearization failed: ' + E.Message);  // su propio logger
      WriteReport(FileName, False);                       // un PDF plano en su lugar
    end;
  end;
end;
El fallback produce un PDF ordinario que cualquier visor abre; solo pierde la primera página rápida. Para un pipeline de reportes ese trueque es fácil, porque una primera pintura lenta es una molestia y un reporte faltante es un incidente
El lado del despliegue pesa más que el código. La linealización rinde solo cuando el servidor honra las peticiones HTTP Range; un endpoint que manda el archivo entero le compra a usted una escritura más lenta y un archivo más grande para nada. Deje LinearizeOutput apagado para los archivos que se envían por correo, se adjuntan o se descargan antes de que alguien los vea. Actívelo para los documentos que un navegador abre directo desde una URL, después de confirmar que la respuesta lleva Accept-Ranges: bytes
¿Por qué LinearizeOutput apaga los object streams?
Porque cada entrada de tabla de sugerencias describe un rango de bytes, y un objeto empaquetado en un contenedor /ObjStm no tiene rango de bytes propio; existe solo como una rebanada de otro stream comprimido que hay que traer e inflar completo. Con LinearizeOutput activado, HotPDF escribe tablas de referencias cruzadas de texto tradicionales y objetos indirectos sin empaquetar aun cuando UseXRefStream o UseObjectStreams también esté fijado. El camino linealizado toma precedencia al guardar, así que su código no tiene conflicto que resolver
El costo es el tamaño del archivo, porque los diccionarios pequeños que un object stream comprimiría juntos ahora quedan sueltos. Si la salida compacta importa más que la latencia de la primera página, el trueque está trazado en object streams y actualizaciones incrementales en HotPDF. Los exportadores de Office tropiezan con la misma tensión desde el otro lado, razón por la que algunos emiten el layout descrito en streams de referencias cruzadas híbridos en PDFs generados por Office
La linealización también necesita PDF 1.2 o posterior. Con una Version más baja, HotPDF promueve el documento a 1.2 al guardar. Con StrictVersionLock fijado lanza una excepción en cambio, porque una versión que usted fijó a propósito no debería cambiar a sus espaldas
El techo de 4 GiB de la salida linealizada
Las tablas de sugerencias guardan offsets y longitudes en campos de 32 bits, así que un archivo linealizado no puede direccionar nada más allá de 4 GiB, y HotPDF se niega a producir uno antes que escribir offsets que den la vuelta. El techo viene de los anchos de campo que define el Anexo F
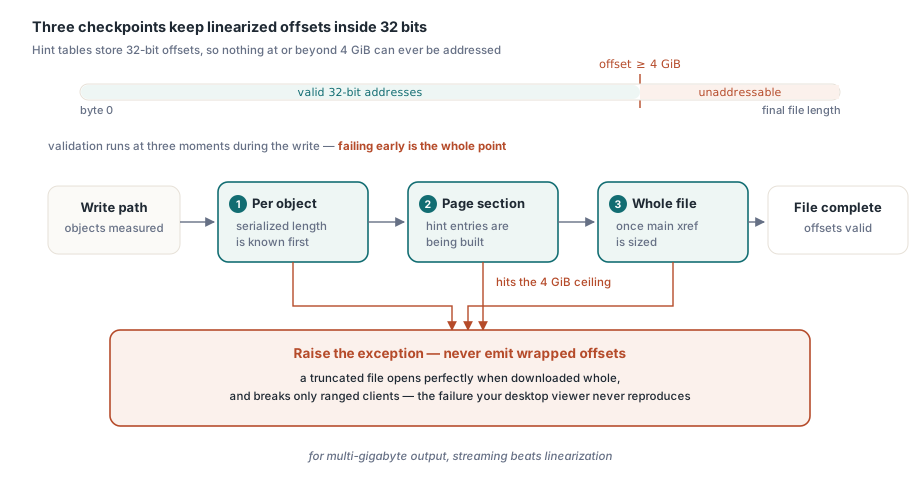
La verificación corre en tres puntos, todos antes de que el primer byte llegue al destino: sobre cada objeto una vez que su longitud serializada se conoce, sobre cada longitud de sección de página mientras se construyen las entradas de sugerencias, y sobre la longitud final del archivo una vez que la tabla principal de referencias cruzadas quedó dimensionada. Unos offsets que den la vuelta serían la peor manera de fallar: un visor que descarga el archivo completo puede ignorar las sugerencias, mientras que el cliente de rangos de bytes salta a los bytes equivocados, así que las pruebas de escritorio jamás reproducen la falla. Para salida de varios gigabytes, la ruta de streaming en la Direct File API para flujos de trabajo de PDF grandes es donde mirar
Comprobar si un archivo entrante está linealizado
THotPDF.IsLoadedLinearized reporta si el documento cargado se declara linealizado. La verificación ocurre antes del parseo: HotPDF lee hasta 1024 bytes desde la posición cero del origen, encuentra el primer objeto, y busca dentro de ese objeto /Linearized con el valor 1. Los comentarios, las cadenas literales y las cadenas hexadecimales se saltan, así que el nombre apareciendo dentro de un string no cuenta, y el escaneo se detiene en stream o endobj. Solo se acepta 1 o un equivalente como 1.0
La respuesta se guarda en caché al momento de la carga porque para cuando el código de la aplicación pregunta, el parser ya movió la posición del stream y LoadFromFile ya liberó su stream de origen
El flag reporta lo que el archivo reclama. El Anexo F agrega una segunda condición: /L debe coincidir con la longitud real del archivo, y una actualización incremental agregada después de la linealización rompe esa coincidencia, así que los lectores vuelven a tratar el archivo como ordinario. Un pipeline que acepta archivos de editores que agregan sus guardados puede comparar los dos números por su cuenta
// Su propio helper, no es parte de HotPDF: compara /L con el tamaño real
// Parseo simplificado; asume un único espacio después de /L
function DeclaredLengthMatches(const FileName: string): Boolean;
var
  FS: TFileStream;
  Head: AnsiString;
  ActualSize: Int64;
  P, Q: Integer;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    ActualSize := FS.Size;
    SetLength(Head, 1024);
    SetLength(Head, FS.Read(Head[1], 1024));
  finally
    FS.Free;
  end;
  P := Pos(AnsiString('/L '), Head);
  Result := P > 0;
  if not Result then
    Exit;
  Inc(P, 3);
  Q := P;
  while (Q <= Length(Head)) and (Head[Q] in ['0'..'9']) do
    Inc(Q);
  Result := StrToInt64Def(string(Copy(Head, P, Q - P)), -1) = ActualSize;
end;

procedure InspectUpload(const FileName: string);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    if PDF.LoadFromFile(FileName) <= 0 then
      Exit;
    if not PDF.IsLoadedLinearized then
      Writeln('Not linearized')
    else if not DeclaredLengthMatches(FileName) then
      Writeln('Linearized, but modified after linearization')
    else
      Writeln('Ready for Fast Web View');
  finally
    PDF.Free;
  end;
end;
LinearizeOutput e IsLoadedLinearized son parte del HotPDF Delphi Component para Delphi y C++Builder, y su página de producto documenta cómo interactúan con los streams de referencias cruzadas, los object streams y el bloqueo de versión