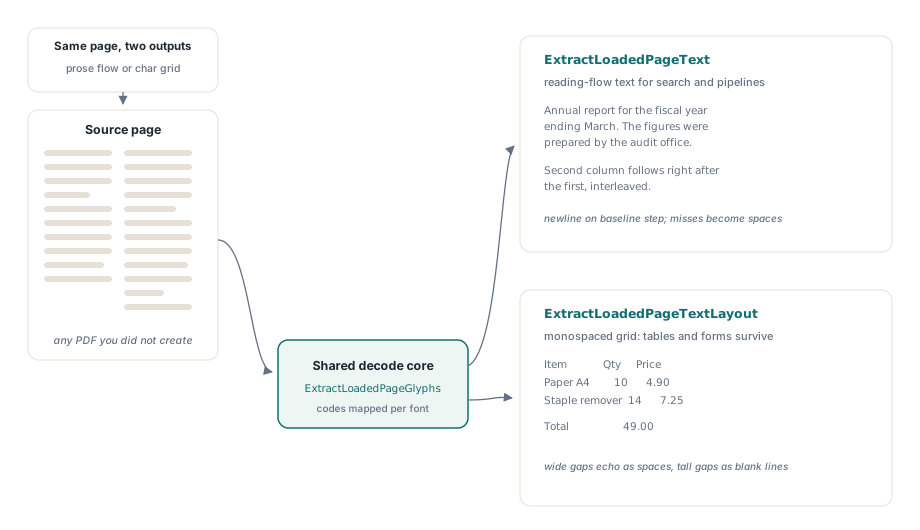
HotPDF Delphi Component extrae texto Unicode de cualquier PDF que cargue en Delphi mediante dos llamadas: ExtractLoadedPageText devuelve el texto en flujo de lectura de una página, y ExtractLoadedPageTextLayout (añadido en la versión v2.263.0) reconstruye la disposición visual de la página como texto sin formato, de modo que las columnas, sangrías y la alineación de tablas sobreviven en el resultado. Ambas funcionan en documentos que HotPDF no creó, que es el caso que realmente importa: la factura que un cliente le envió por correo electrónico, el informe que entregó una oficina de escaneo o el contrato generado por un software que ya nadie puede nombrar
Llegar allí requirió más mecanismos de los que sugieren las dos firmas, porque un archivo PDF no almacena texto de la misma manera que un archivo de texto. Este artículo recorre ambos modos de extracción, luego abre el capó de las tres piezas subyacentes — el lector de CMap, el intérprete de flujo de contenido y la cadena de alternativas para la decodificación de fuentes — porque saber cómo funciona el mapeo es la diferencia entre encogerse de hombros ante una salida con caracteres extraños y diagnosticarla
¿Por qué la extracción de texto es más difícil que leer cadenas del archivo?
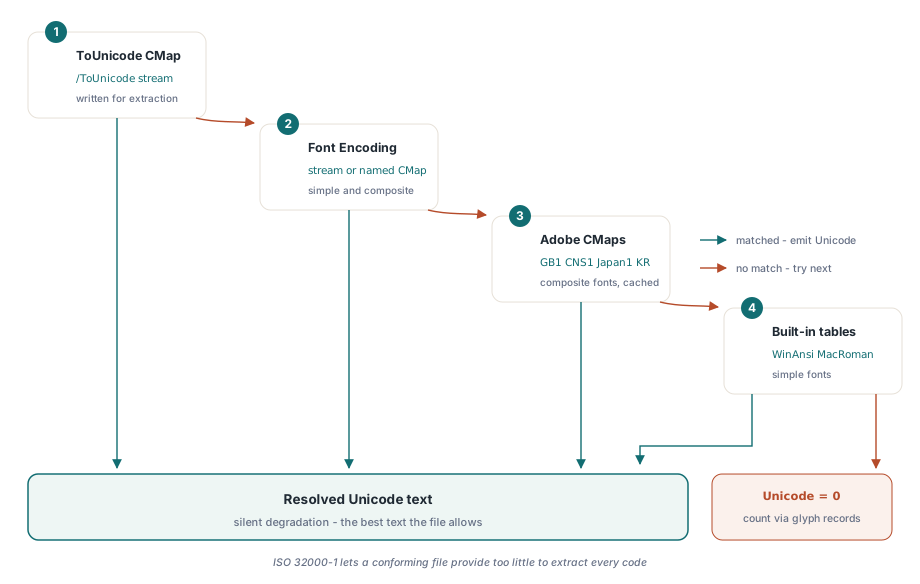
Un flujo de contenido PDF registra códigos de caracteres, no caracteres. Los operadores Tj y TJ (ISO 32000-1 §9.4.3) contienen cadenas de bytes cuyo significado depende completamente de la fuente seleccionada por el Tf precedente: el byte 0x41 podría ser la letra A bajo WinAnsi, un glifo arbitrario en una fuente de subconjunto o la mitad de un CID de dos bytes en una fuente CJK compuesta. La norma ISO 32000-1 §9.10 define la extracción de texto exactamente como este problema de decodificación — mapear cada código de regreso a Unicode utilizando la información que proporcione el diccionario de fuentes — y la norma es explícita al señalar que un archivo conforme no está obligado a proporcionar suficiente información para hacerlo
Esa última cláusula explica cada informe de error del tipo "por qué copiar y pegar de este PDF produce texto sin sentido" que haya visto. Un productor que incrusta una fuente de subconjunto sin una tabla /ToUnicode ha escrito un archivo que se representa perfectamente pero se extrae como texto sin sentido, porque el mapeo de código a glifo existe pero el mapeo de código a Unicode nunca se incluyó. Por lo tanto, cualquier API de extracción honesta es una cadena de alternativas basada en el mejor esfuerzo, y la pregunta útil es qué tan profunda es esa cadena
Extracción de flujo de lectura con ExtractLoadedPageText
Para la indexación de búsqueda, la coincidencia de palabras clave o el envío de texto a un flujo de trabajo de análisis, ExtractLoadedPageText es la llamada que desea. La firma es function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean — los índices de página son de base cero, el resultado llega como una UnicodeString nativa de Delphi y la función devuelve False cuando la página no tiene un flujo de contenido legible en lugar de generar una excepción
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
    // AllText ahora contiene el texto en flujo de lectura del documento
  finally
    Pdf.Free;
  end;
end;
Los saltos de línea en la salida provienen de una regla geométrica deliberadamente simple. Desde HotPDF v2.766.79, se inserta una nueva línea cuando el origen del glifo cruza la dirección de escritura por más de la mitad de la altura del texto, tomada como la mayor entre la altura del cuadro de ascendente a descendente de este glifo y la del glifo anterior, en unidades de página. Antes de esa release el movimiento vertical se comparaba con la mitad del tamaño de fuente dado a Tf, que suele ser 1 en documentos que dimensionan el texto a través de la matriz de texto, así que un superíndice elevado abría una línea nueva y el texto rotado ponía cada carácter en su propia línea. Los espacios entre palabras siguen una regla correspondiente desde la v2.766.76: cuando un productor separa palabras moviendo la posición del texto, con un ajuste TJ o un Td, en lugar de mostrar un carácter de espacio, se agrega un espacio cuando la separación a lo largo de la línea base, tras el ancho del propio glifo anterior, supera 0.15 de la altura del cuadro del glifo, y nunca entre dos caracteres chinos, japoneses o coreanos. Los caracteres que el decodificador no puede resolver se convierten en espacios en lugar de desaparecer, por lo que los límites de las palabras sobreviven incluso cuando los glifos individuales no lo hacen. Lo que este modo no intenta es la agrupación en orden de lectura o la detección de múltiples columnas: una página de dos columnas sale intercalada en el orden del flujo de contenido, que suele ser el orden visual, aunque no siempre
¿Cuándo debería usar la extracción con conservación de diseño en su lugar?
ExtractLoadedPageTextLayout es la llamada correcta siempre que la posición tenga un significado: tablas, formularios, listas de códigos o cualquier cosa que pretenda comparar con diff, buscar con grep o analizar por columnas. En lugar de aplanar los glifos en un flujo, los agrupa en líneas base, ordena cada línea base por X y reproduce los espacios en blanco horizontales y verticales en una cuadrícula de caracteres monoespaciados dimensionada a partir del avance de glifo medio y el tamaño de la fuente. Los espacios anchos entre segmentos en la misma línea base se convierten en secuencias de espacios; los espacios grandes entre líneas base se convierten en líneas en blanco. El resultado se lee como se ve la página
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // Las columnas, la sangría y la alineación de tablas sobreviven como
  // espacios y líneas en blanco en una cuadrícula de caracteres
end;
Ambos modos comparten cada byte de la maquinaria de decodificación y difieren solo en cómo organizan los glifos decodificados, por lo que la elección no cuesta nada en fidelidad. Elija ExtractLoadedPageText cuando solo importen las palabras y ExtractLoadedPageTextLayout cuando importe la disposición. La detección del orden de lectura de múltiples columnas sigue estando fuera del alcance de ambos — una representación en cuadrícula de una página de dos columnas le muestra ambas columnas lado a lado, fielmente, lo cual para comparar con diff es exactamente correcto y para el reflujo de prosa no lo es
¿Cómo decodifica HotPDF los códigos de caracteres a Unicode?
HotPDF Delphi Component resuelve cada código de carácter a través de una cadena de alternativas ordenada por prioridad: primero el CMap /ToUnicode incrustado de la fuente, luego la entrada /Encoding (flujo o CMap con nombre), luego — para fuentes compuestas — los archivos CMap estándar de Adobe para colecciones de caracteres como Adobe-GB1, Adobe-CNS1, Adobe-Japan1 y Adobe-KR, y finalmente las tablas integradas WinAnsi y MacRoman para fuentes simples. Una estrategia que no puede ofrecer una respuesta se degrada silenciosamente a la siguiente en lugar de generar una excepción, y un código que agota toda la cadena se resuelve en 0 para que el llamador pueda contar las omisiones en lugar de adivinar
El CMap /ToUnicode (ISO 32000-1 §9.10.3) se encuentra en primer lugar porque es el mapeo que el productor escribió específicamente para la extracción. La ruta del CMap estándar de Adobe es importante para los documentos CJK que utilizan CMaps predefinidos como UniGB-UTF16-H en lugar de incrustar algo: HotPDF distribuye los archivos de colección en su directorio resources\CMap, los localiza de forma relativa al ejecutable en tiempo de ejecución y almacena en caché cada mapa analizado por proceso — vale la pena saberlo porque el más grande de ellos, el mapa Adobe-GB1, es de aproximadamente 2 MB de texto de origen que no desea volver a analizar por página. Si el directorio no existe, el decodificador simplemente omite los CMaps respaldados en el disco y trabaja con las tablas incrustadas más las codificaciones integradas. Este es el espejo del lado de la lectura del problema de modelado cubierto en modelado de texto de escritura compleja con HotPDF, donde se enfrenta la misma distinción entre código y glifo en el momento de la escritura
Dos trampas de sintaxis de CMap que vale la pena conocer
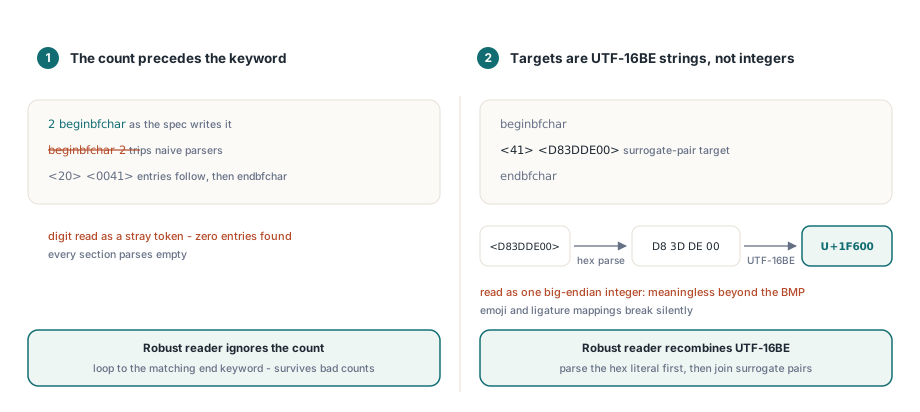
Los archivos CMap parecen fáciles de analizar y no lo son, y dos detalles representan la mayoría de las fallas de los analizadores en el primer intento. El primero es que el recuento de registros viene antes de la palabra clave de la sección: una sección dice 2 beginbfchar, no beginbfchar 2. Un analizador que espera el recuento después de la palabra clave de la sección consume el número como un token suelto, y luego encuentra cero entradas en cada sección. El enfoque robusto — en el que se basó el lector de HotPDF — consiste en ignorar el recuento por completo y repetir el ciclo hasta encontrar la palabra clave endbfchar / endbfrange correspondiente, lo que tiene la ventaja de tolerar archivos del mundo real cuyos recuentos simplemente son incorrectos
La segunda trampa es que los destinos de bfchar y bfrange son cadenas UTF-16BE, no enteros. El destino <D83DDE00> significa U+1F600 — un par de sustitutos que debe recombinarse en un punto de código — y leer esos cuatro bytes como un entero big-endian produce un valor sin sentido en cada punto de código fuera del Plano Multilingüe Básico. Los emojis en los archivos PDF ya no son exóticos, por lo que un decodificador que omite la recombinación de sustitutos falla en los archivos que sus usuarios realmente tienen. HotPDF analiza el literal hexadecimal a bytes sin formato primero, luego recombina las unidades de código UTF-16BE, lo que también cubre los destinos de múltiples caracteres que producen los mapeos de ligaduras
Descender al nivel de glifos con ExtractLoadedPageGlyphs
Ambas llamadas de texto están construidas sobre ExtractLoadedPageGlyphs, y el THPDFGlyphArray subyacente también está disponible para su código. Cada THPDFGlyphRecord lleva el punto de código Unicode resuelto junto con el código de carácter en bruto, el ancho en bytes del código (1, 2 o 4, decidido por el codespacerange del CMap), la clave y el tamaño del recurso de fuente activo, el origen X e Y en espacio de usuario, y el avance horizontal; desde la v2.766.76 también lleva GlyphEndX y GlyphEndY, el extremo en espacio de página del ancho del propio glifo sin espaciado de carácter ni de palabra, que es la magnitud de la que parte la regla de separación de palabras descrita arriba. Eso alcanza para construir detección de límites de palabra, resaltado posicionado o un algoritmo de diseño propio sin tocar usted mismo el flujo de contenido
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Contar los registros Unicode = 0, como se mostró anteriormente, es la forma honesta de medir la calidad de la extracción en un documento dado antes de confiar en el texto en los pasos siguientes. Los registros de glifos también anclan cada carácter al operando de origen en el flujo de contenido, que es lo que hace posible la búsqueda y reemplazo de texto de documentos cargados de HotPDF sobre la misma base
¿Qué archivos PDF no entregarán su texto?
Algunos archivos derrotan a cualquier extractor, y es mejor detectarlos que entregar su salida. Los documentos escaneados son el caso más evidente: una página que es una sola imagen grande no contiene operadores de texto en absoluto, por lo que la extracción devuelve correctamente una cadena vacía — la solución es OCR, y extraer las imágenes de la página del PDF cargado es el primer paso de ese flujo de trabajo. Las fuentes de subconjunto sin una tabla /ToUnicode son el caso más difícil: si la ruta /Encoding y los CMaps estándar también resultan vacíos, esos glifos se resuelven en 0 y aparecen como espacios en las llamadas de texto. Los documentos cifrados se extraen normalmente siempre que los cargue con su contraseña a través de la sobrecarga de LoadFromFile, de modo que los flujos se descifren antes de que el intérprete los vea
Vale la pena exponer claramente un límite más estrecho: la cadena de decodificación lee los flujos de CMap y contenido a través de la ruta Flate de HotPDF, por lo que una fuente cuyo flujo ToUnicode utiliza un filtro inusual se degrada a la siguiente estrategia en lugar de fallar en la página. En la práctica, FlateDecode cubre casi todo lo producido en las últimas dos décadas, y la degradación es silenciosa por diseño — obtiene el mejor texto que el archivo permite en lugar de una excepción. La misma maquinaria de objetos del lado de la lectura que resuelve los diccionarios de fuentes aquí también potencia la edición de metadatos en documentos cargados, por lo que un flujo de ingesta de documentos puede extraer, inspeccionar y anotar en una sola pasada
La extracción de texto, la representación que conserva el diseño, el acceso a nivel de glifos y las funciones de búsqueda y reemplazo integradas en ellos son parte del componente estándar HotPDF Delphi Component para Delphi y C++Builder — sin DLL externas, sin servicios de texto del sistema operativo, solo Object Pascal que puede recorrer paso a paso cuando un archivo extraño llega a su cola