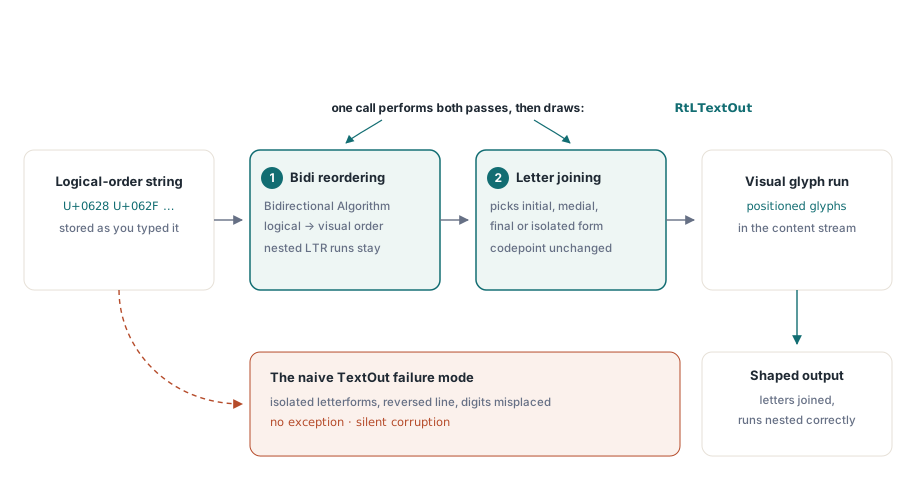
Pase la frase árabe يوضح ملف PDF a TextOut y abra el resultado. Las letras corren en la dirección equivocada, y cada una queda en su forma aislada con un hueco visible antes de la siguiente, como si alguien hubiera escrito inglés al revés y pulsado espacio entre cada carácter. No se lanzó ninguna excepción. No se imprimió ninguna advertencia. La salida simplemente está mal, y está mal porque dos transformaciones distintas de las que depende el árabe nunca ocurrieron. Saber cuáles son esas dos transformaciones, y qué llamada las realiza, es casi todo a lo que se reduce la salida PDF de escrituras complejas
HotPDF es un componente PDF VCL nativo para Delphi y C++Builder, y hace por usted el trabajo de derecha a izquierda mediante una llamada distinta. También se detiene en unos cuantos puntos concretos que conviene conocer antes de comprometerse con una configuración regional, así que este artículo mapea los conceptos y los límites honestos; la configuración práctica de la llamada en sí vive en el artículo de referencia de RtLTextOut
Por qué una cadena correcta se imprime mal de todos modos
Unicode guarda el texto en orden lógico, el orden en que usted lo escribe y lo lee en voz alta. Un renderizador tiene que colocar los glifos en orden visual. Para las escrituras de izquierda a derecha esos órdenes coinciden y nadie piensa en ello. Para el árabe y el hebreo no coinciden, y cuando una sola línea mezcla direcciones, digamos una oración en árabe que lleva el token latino "PDF" o un precio escrito en dígitos, el Algoritmo Bidireccional de Unicode (UAX #9) decide exactamente cómo se anidan los fragmentos de izquierda a derecha dentro de la línea de derecha a izquierda. Esa es la primera transformación, el reordenamiento, y omitirla es lo que invierte la línea
La segunda es el modelado contextual. Una letra árabe se dibuja de forma distinta según dónde cae en la palabra: inicial, media, final o aislada. El punto de código sigue siendo el mismo en todos los casos; solo cambia el glifo. Un pipeline que entrega cada punto de código directamente a su glifo predeterminado produce exactamente la salida desconectada, en formas aisladas, del párrafo inicial. El hebreo se salta este paso, ya que sus letras no se unen, pero sigue necesitando el reordenamiento. El árabe necesita ambas cosas, y por eso el árabe, no el hebreo, es la cadena con la que usted prueba
En el escritorio nada de esto es problema suyo. Cuando un formulario VCL pinta árabe en un TEdit, la pila de texto del sistema operativo lo reordena y lo modela en silencio, que es precisamente por lo que la cadena que se ve perfecta en pantalla sale rota en un PDF ingenuo. Un flujo de contenido no almacena texto editable. Almacena glifos posicionados, así que quien emite el flujo hereda el trabajo de modelado que antes hacía el sistema operativo. RtLTextOut es la llamada que retoma ese trabajo
Qué modela RtLTextOut por usted
HotPDF mantiene la ruta latina y la ruta de escrituras complejas como dos métodos diferentes. TextOut imprime lo que usted le da en el orden en que se lo da. RtLTextOut realiza primero ambas transformaciones — reordenamiento bidireccional en toda la línea, análisis contextual para las escrituras que se unen — y luego imprime. Qué reglas de escritura se aplican viaja a través del charset de la fuente y no de la llamada en sí, así que la dirección es una elección explícita en cada punto de llamada en lugar de una suposición hecha a partir de los caracteres. La configuración parámetro por parámetro, los valores de charset, los pasos de registro de fuentes y un ejemplo completo compilable están todos en el artículo de referencia de RtLTextOut; este artículo se queda con lo que significan las transformaciones, dónde se detienen y cómo demostrar que funcionaron
Una regla de uso importa incluso a esta altura: la entrada debe estar en orden lógico, porque RtLTextOut realiza la inversión por sí mismo, y una cadena que usted ya invirtió a mano sale doblemente invertida — el artículo de referencia recorre esa trampa y su limpieza. Lo que le gana a la trampa una mención aquí es por qué sobrevive a las pruebas. Una cadena puramente árabe doblemente invertida puede verse perfectamente correcta, y solo se desmorona cuando una línea lleva una palabra latina o un número, porque esos tramos incrustados ya no se anidan como dicta UAX #9. El error no está en el renderizado; está en alimentar al algoritmo con texto que ya estaba procesado a medias
Ese mismo comportamiento de direcciones mezcladas hace tropezar a los revisores más de lo que hace tropezar al código. Dentro de una línea de derecha a izquierda, los dígitos y las palabras latinas incrustadas siguen leyéndose de izquierda a derecha. Alguien que no ha trabajado con diseño bidireccional mirará una factura renderizada, verá el número de cuenta leyéndose en el sentido "equivocado" respecto al árabe que lo rodea, y lo reportará como un error. Es el resultado correcto según la especificación. Una nota breve en sus criterios de aceptación, escrita antes de la primera revisión por un hablante nativo, ahorra ese viaje de ida y vuelta
Cuándo bastan el reordenamiento y la unión, y cuándo no
Para texto corrido en árabe y hebreo — reportes, facturas, contratos, cartas — reordenamiento más unión contextual es todo el trabajo, y RtLTextOut lo carga solo. El límite aparece cuando la tipografía pide más que unión. La respuesta de HotPDF del lado árabe es un modelador opcional del lado del productor: establezca AutoShapeArabic := True y el componente reescribe el tramo en orden lógico a Formas de Presentación de Unicode antes de la pasada bidireccional, de modo que las formas de unión se calculan contra los vecinos lógicos y los pliegues de ligaduras quedan horneados en los puntos de código que el PDF realmente lleva, en lugar de dejarse para que un visor los resuelva. El interruptor viene apagado de forma predeterminada y la salida es estable byte a byte cuando permanece apagado, así que activarlo es una decisión deliberada por pipeline de documentos, no una actualización global. El mismo modelo opcional se extiende a las otras escrituras de derecha a izquierda con unión que HotPDF modela: siríaco, N'Ko, adlam y hanifi rohingya tienen cada una su propia bandera de modelado automático que refleja la del árabe
Las características opcionales de OpenType son otro mecanismo distinto. Las ligaduras discrecionales y las características similares de sustitución simple pasan por GetSingleSubstituteGlyph(GID, 'liga'), que resuelve una sustitución a la vez — primero el ID del glifo de entrada, luego la etiqueta de la característica — y devuelve el glifo de entrada sin cambios cuando la característica no aplica. Eso basta para manejar una lista finita y conocida de ligaduras que usted mismo mantiene. No es un motor GSUB completo, y la diferencia es exactamente donde los planes ambiciosos de configuración regional se tuercen: un pipeline de modelado que maneja el árabe sin fallas ha demostrado reordenamiento y unión, nada más
Cobertura entre escrituras
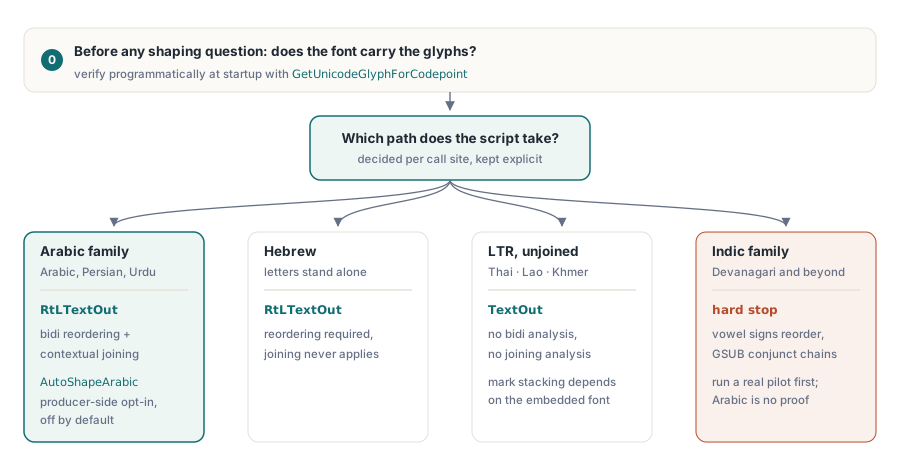
El árabe ejercita ambas transformaciones, por lo que es la cadena con la que probar, y por lo que una pasada en árabe es la evidencia individual más fuerte de que el pipeline funciona. El hebreo necesita el reordenamiento pero no la unión, ya que sus letras van sueltas; si el hebreo se renderiza correctamente pero el árabe sale desconectado, la mitad bidireccional está bien y la mitad contextual nunca se ejecutó. El persa y el urdu montan sobre la escritura árabe y heredan su comportamiento, aunque la preferencia del urdu por el estilo nastaliq es una decisión de fuente con consecuencias de legibilidad que debe juzgar un lector nativo
El tailandés se sitúa por completo al otro lado de la línea. Corre de izquierda a derecha, así que no necesita trabajo bidireccional, y sus letras no se unen, así que no necesita análisis contextual; las cadenas en tailandés pasan por la ruta ordinaria de TextOut igual que el latín. Lo que sí tiene el tailandés son marcas apiladas — vocales y marcas tonales arriba y abajo de la consonante base — y que esas queden bien colocadas depende de que la fuente construya sus marcas combinantes para apilarse sin ayuda de un motor de modelado. La mayoría de las fuentes tailandesas dedicadas lo hacen. Pruebe con la fuente exacta que va a incrustar, no con una parecida
El devanagari y el resto de la familia índica son el tope honesto. Sus signos vocálicos se reordenan alrededor de los grupos consonánticos y sus conjuntos se forman mediante cadenas de sustituciones dependientes del contexto, lo cual es territorio de GSUB completo, más allá del reordenamiento y la unión. Si una configuración regional índica está en la hoja de ruta, ejecute un piloto real con cadenas genuinas de clientes antes de prometerla — que el árabe funcione no es evidencia de que el devanagari lo hará. Las cadenas CJK, el vietnamita con sus diacríticos apilados y el texto europeo mezclado toman todos la ruta ordinaria sin análisis bidireccional, y conviene mantener las dos rutas físicamente separadas en el código de reportes, una rutina para los tramos RTL y otra para todo lo demás, de modo que la lógica de configuración regional sea visible en el punto de llamada en lugar de esconderse detrás de una bandera que alguien olvida establecer
La cobertura de glifos se decide antes de que el modelado siquiera se ejecute
El modelado escoge glifos de una fuente. Si la fuente no los lleva, no hay nada que escoger, y por eso la falla clásica de despliegue — impecable en la computadora del desarrollador, cajas en blanco en el servidor del cliente tras una sustitución silenciosa de fuente — es un problema de cobertura, no de modelado. La cura práctica, registrar una fuente que usted distribuye en lugar de confiar en lo que un equipo tenga instalado, se recorre paso a paso en el artículo de referencia. El punto conceptual es que la cobertura tiene que establecerse antes de que cualquier pregunta sobre modelado tenga siquiera sentido, y que puede establecerse por programa en lugar de mirando la salida a ojo
// Después de RegisterUnicodeTTF, audite la cobertura de los
// puntos de código que sus datos realmente usan
GID := Pdf.GetUnicodeGlyphForCodepoint($0628);  // U+0628 ARABIC LETTER BEH
LogGlyphAudit($0628, GID);
El registro en sí lleva dos restricciones — un piso de PDF 1.5 para el manejo de Unicode incrustado y los bits de permiso de incrustación de la fuente — ambas cubiertas junto con los pasos de configuración en el artículo de referencia de RtLTextOut. Lo que corresponde aquí es el hábito de auditar: GetUnicodeGlyphForCodepoint es su sistema de alerta temprana. Recorra los rangos de puntos de código que sus datos realmente usan cuando el servicio arranca y registre qué IDs de glifo regresan. Un hueco de cobertura aparece entonces como una línea en un registro de arranque durante el despliegue, en lugar de como caracteres faltantes en una factura que ya llegó a un cliente
El orden de lectura pertenece al documento, no a los glifos
Acertar con cada glifo todavía deja una cosa sin hacer. ISO 32000-1 §12.2 define una preferencia de visor llamada /Direction que declara el orden de lectura general del documento. No toca ningún glifo. Lo que hace es indicarle a un visor cómo organizar las páginas enfrentadas de dos en dos, de qué lado debe comenzar un diseño de páginas enfrentadas y hacia qué lado debe inclinarse la interfaz de lectura. Nada de eso se ve en una sola página, que es exactamente por lo que se olvida
// Declare el orden de lectura de derecha a izquierda a nivel de documento
Pdf.Direction := RightToLeft;  // agrega vpDirection a ViewerPreferences
Establecer Direction es todo el trabajo: el setter de la propiedad agrega vpDirection a las ViewerPreferences del documento, así que una sola línea lleva la preferencia al archivo. Si el texto sale a través de RtLTextOut esto lo obtiene gratis, porque la llamada cambia la dirección del documento como efecto secundario — el artículo de referencia cubre cuándo un documento mixto necesita deshacer eso. El caso en que debe establecerlo usted mismo es un documento de derecha a izquierda producido de cualquier otra forma, por ejemplo a partir de una entrada que usted modeló previamente aguas arriba y dibujó por la ruta ordinaria. Omítalo ahí y la prueba de una sola página que está mirando se ve idéntica de cualquier manera; luego alguien imprime un folleto a doble cara, las páginas enfrentadas salen en espejo, y la causa es una línea que faltó semanas antes
Verificación de la salida modelada
Verifique de extremo a extremo, porque una página puede verse correcta y aun así ser inútil para todo lo que viene después. Tres comprobaciones encuentran la mayoría de los problemas. Copie el texto de vuelta desde Acrobat y compare los puntos de código contra su cadena fuente. Ejecute la búsqueda dentro del documento del visor para una palabra que pueda ver en la página. Y abra la salida en una computadora que no tenga sus fuentes de desarrollo, la que más probablemente exponga una sustitución. Nada de eso reemplaza a un lector nativo mirando un documento real, que atrapa cosas que ningún corpus sintético atrapará. Ponga esa revisión en el calendario antes de que el formato se publique
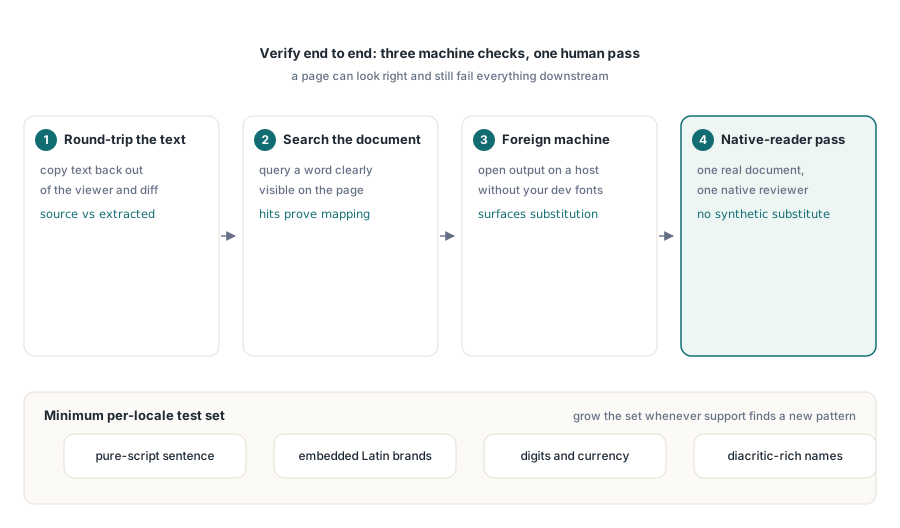
Elija las cadenas de prueba a propósito en lugar de reciclar lo que un traductor envió el año pasado. Un mínimo viable por configuración regional: una oración en escritura pura, una oración con nombres de marca latinos incrustados, una línea con dígitos y moneda, y nombres con diacríticos o marcas combinantes. Los nombres reales de clientes rompen suposiciones que el texto de relleno deja intactas, así que deje que el conjunto de regresión crezca una cadena cada vez que un caso de soporte revele un patrón que no había visto
El registro de fuentes, el subconjunto y la API cotidiana de dibujo de texto se cubren en el artículo sobre salida de reportes, fuentes e imágenes con HotPDF. Cuando los mismos documentos también tienen que cumplir perfiles de accesibilidad, las reglas de etiquetado de idioma y estructura del artículo de validación PDF/A y PDF/UA se apoyan sobre el trabajo de modelado de aquí
Las API de derecha a izquierda y de fuentes Unicode descritas arriba se incluyen con el componente HotPDF para Delphi para Delphi y C++Builder; la página del producto enlaza la referencia completa de salida de texto