HotPDF Delphi Component borra una página de un PDF cargado a través de THotPDF.DeletePage, y desde la versión 2.751.0 esa llamada además poda cada referencia de nivel documento que todavía apunta a la página: los destinos con nombre del árbol /Names /Dests, el diccionario /Dests heredado del catálogo, las acciones /GoTo de los marcadores, los elementos de estructura bajo /StructTreeRoot, el ParentTree, las entradas OBJR de las anotaciones y las anotaciones de link de las páginas que sobreviven. El árbol de páginas se reconstruye al final, cuando ya nada más puede alcanzar el objeto borrado
La falla que esto evita es fácil de reproducir y difícil de diagnosticar. Borre la portada de un informe etiquetado, guarde y abra el resultado: Acrobat muestra la cantidad correcta de páginas, pero el marcador "Contents" ya no lleva a ningún lado, el verificador de accesibilidad reporta un elemento de estructura sin página y un validador estricto lista una referencia a un objeto libre. Nada en el árbol de páginas está mal. El problema es que una página de PDF no es solo una hoja de /Pages; es un destino al que apunta medio catálogo, y sacar la hoja deja a todos esos punteros colgados
¿Por qué no alcanza con sacar la página de /Kids?
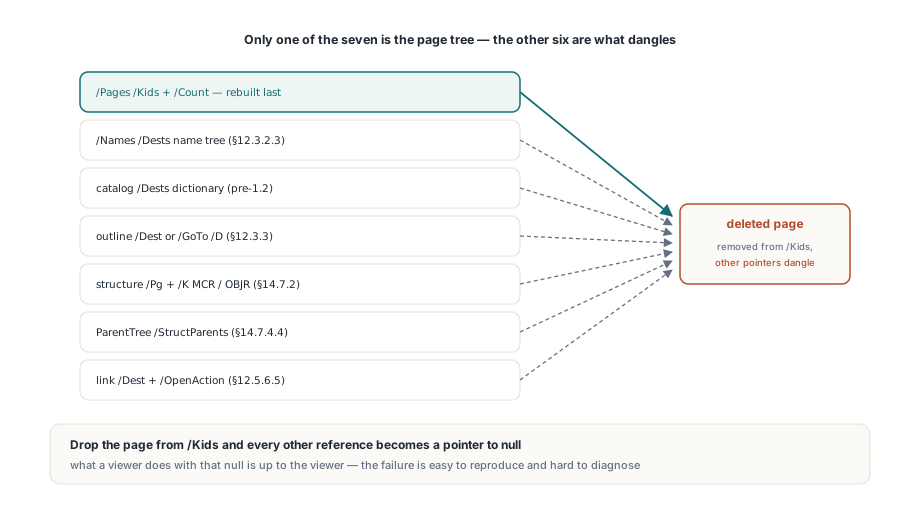
Porque ISO 32000-1 permite que al menos siete estructuras independientes guarden una referencia al objeto de página, y solo una de ellas es el árbol de páginas. Sacar la página de /Kids y decrementar /Count cumple con §7.7.3, y cada una de las otras referencias pasa a ser un puntero a un objeto que o está liberado en el xref o simplemente no está en el archivo reescrito. Un visor que siga uno de esos punteros obtiene null, y qué hace con ese null depende del visor
- El árbol de nombres bajo
/Names/Dests(§7.7.4, §12.3.2.3) mapea nombres a arrays de destino cuyo primer elemento es la página - El diccionario
/Destsanterior a la 1.2, directamente en el catálogo, guarda arrays del mismo tipo indexados por nombre - Los ítems del outline (§12.3.3) llegan a una página a través de un
/Destinline o de una acción/Acon/S /GoToy un array/D - Los elementos de estructura (§14.7.2) llevan una clave
/Pgque nombra la página donde vive su contenido marcado, y sus hijos/Kpueden ser referencias de contenido marcado y referencias de objeto (§14.7.4.3) atadas a esa página - El
ParentTree(§14.7.4.4) mapea los números/StructParentsde páginas y anotaciones de vuelta a elementos de estructura, y un elemento puede vivir ahí sin aparecer en la cadena/Kdesde la raíz - Las anotaciones de link en otras páginas (§12.5.6.5) llevan un
/Desto una acción/GoToque apunta a la página, y el/OpenActiondel catálogo puede hacer lo mismo
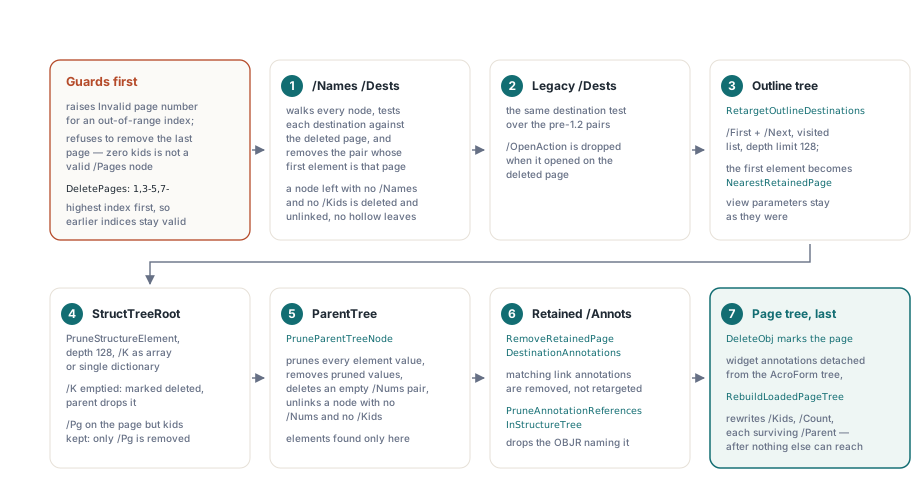
¿Qué limpia THotPDF.DeletePage antes de tocar el árbol de páginas?
THotPDF.DeletePage(PageIndex) sobre un documento cargado ejecuta primero todo el barrido de referencias, después marca el objeto de página como borrado con DeleteObj, desengancha las anotaciones widget del árbol de campos del AcroForm, desplaza el array interno de páginas y por último llama a RebuildLoadedPageTree para reescribir /Kids, /Count y el /Parent de cada página que sobrevive. El barrido recorre el catálogo en un orden fijo: el árbol de nombres /Names /Dests, el diccionario /Dests al estilo viejo, /OpenAction, el árbol de outline, /StructTreeRoot con su ParentTree y, al final, los arrays /Annots de cada página que queda. Cada paso decide si una referencia se elimina, se reapunta o se deja como está, según lo que la especificación permita que esa estructura haga sin la página. Antes de que corra todo esto hay dos guardas: DeletePage lanza Invalid page number ante un índice fuera de rango y se niega a borrar la última página, porque un nodo /Pages con cero hijos no es un PDF válido, mientras que DeletePages acepta la misma notación basada en uno "1,3-5,7-" que las otras operaciones de página sobre documentos cargados e itera desde el índice más alto hacia abajo para que los índices que usted escribió sigan siendo válidos mientras trabaja
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('tagged-report.pdf', '') > 0 then
    begin
      // Base cero: se descarta la portada. Los destinos con nombre,
      // los marcadores, el árbol de estructura, el ParentTree y las
      // anotaciones de link que apuntaban a ella se podan antes de
      // reconstruir el árbol /Pages.
      Pdf.DeletePage(0);
      // Notación de rangos base uno para lotes, el índice más alto
      // primero por dentro para que los índices menores sigan válidos.
      Pdf.DeletePages('3-4,9');
      Pdf.SaveLoadedDocument('tagged-report-trimmed.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
¿En qué se tratan distinto los destinos con nombre y los marcadores?
Los destinos con nombre se eliminan y los marcadores se reapuntan, porque un nombre que ya no existe es un resultado aceptable, mientras que un marcador sin destino es un defecto visible. En el árbol /Names /Dests, HotPDF recorre cada nodo, prueba cada destino, tanto en la forma de array pelado como en la forma de diccionario con una clave /D, contra la página borrada, y elimina el par nombre/valor cuando el primer elemento del array es esa página. Un nodo cuyos /Names y /Kids terminan los dos vacíos se marca como borrado y se desengancha de su padre, así que el árbol nunca conserva hojas huecas. La misma prueba corre sobre el diccionario /Dests al estilo viejo del catálogo, y el /OpenAction del catálogo simplemente se descarta si abría en la página borrada. Una frontera en este punto: cuando un nodo del árbol de nombres pierde entradas, HotPDF borra el par /Limits de ese nodo en lugar de recalcular las claves mínima y máxima nuevas, y si bien los visores resuelven los nombres sin problema sin eso, un verificador de conformidad estricto que lea ISO 32000-1 §7.9.6 puede marcar un nodo que no es raíz y al que le falta /Limits
Los ítems del outline van para el otro lado. RetargetOutlineDestinations recorre /First y /Next desde la raíz del outline, con una lista de visitados y un límite de profundidad de 128 para que un árbol cíclico corrupto no cuelgue la llamada, y para cada array /Dest o array /D de una acción /GoTo que apunte a la página reemplaza el primer elemento con NearestRetainedPage: la página que seguía a la borrada, o la anterior cuando la borrada era la última. Los parámetros de vista que vienen después de la referencia de página se dejan como estaban. Un marcador que apuntaba a la portada de un capítulo borrado cae entonces en la primera página de lo que queda en lugar de desaparecer de la barra lateral, que es el comportamiento que un revisor espera de un documento recortado. Eso sí, la prueba de destino solo matchea arrays explícitos: un ítem de outline cuyo /Dest es un string de nombre que antes resolvía a la página borrada no se reapunta, porque la entrada del árbol de nombres ya no está y la referencia ahora no resuelve a nada en lugar de a un objeto liberado, así que el visor lo trata como un marcador muerto. La mecánica del propio árbol de outline, /First, /Next y la semántica poco obvia de /Count, está cubierta en la guía para agregar marcadores y destinos con nombre en un PDF cargado
// Verifique el barrido en lugar de confiar en él.
Pdf.DeletePage(0);
if Pdf.ResolveLoadedNamedDestination('cover') = -1 then
  ShowMessage('Named destination "cover" was pruned');
// Un marcador que apuntaba a la portada ahora resuelve a la
// página que le seguía (índice base cero 0 después del borrado).
if Pdf.GetLoadedBookmarkPageIndex('Contents') = 0 then
  ShowMessage('Bookmark retargeted to the nearest retained page');
¿Qué pasa con el árbol de estructura y el ParentTree?
Los elementos de estructura que existen solo por la página borrada se eliminan, y los elementos que abarcan varias páginas pierden su clave /Pg pero conservan sus hijos. PruneStructureElement baja por la cadena /K desde /StructTreeRoot hasta una profundidad de 128, manejando tanto la forma de array como la forma de diccionario único de /K que §14.7.2 permite. Para cada elemento primero poda los hijos y después evalúa el elemento mismo: si la poda dejó su /K vacío, el elemento se marca como borrado y su padre lo descarta. Si el /Pg del propio elemento nombra la página borrada y el elemento todavía tiene hijos más un padre /P, solo se elimina /Pg, porque un /Pg en un elemento es la página por defecto de sus hijos de contenido marcado y esos hijos pueden referenciar otras páginas de forma explícita. Solo se elimina de plano un elemento cuyo /Pg sea la página borrada y que no tenga nada debajo
El ParentTree recibe el mismo trato, y la razón es la que dolió durante el desarrollo: un elemento de estructura puede ser alcanzable desde el ParentTree y desde ningún otro lado. El number tree mapea enteros /StructParents a un solo elemento o a un array de elementos, y PruneParentTreeNode corre PruneStructureElement sobre cada valor que encuentra, elimina los valores que quedaron podados, borra un par /Nums cuando su array de valores queda vacío y desengancha un nodo cuyos /Nums y /Kids desaparecieron los dos. Podar solo los descendientes de /K habría dejado a esos elementos huérfanos apuntando a una página liberada a través de /Pg y a referencias de contenido marcado liberadas a través de sus hijos /MCR. Si usted extrae texto en orden de estructura, eso importa de forma directa: la extracción de texto en orden de estructura recorre exactamente estos árboles, y un elemento con el /Pg en null es un párrafo que se cae del orden de lectura sin avisar
¿Qué anotaciones de link se eliminan en las páginas que sobreviven?
Cualquier anotación de link en una página retenida cuyo array /Dest o acción /GoTo apunte a la página borrada se elimina junto con su pertenencia al árbol de estructura. RemoveRetainedPageDestinationAnnotations recorre el array /Annots de cada página que no sea la objetivo, aplica la misma prueba de destino que usa para los outlines, marca como borrada la anotación que matchea, la saca del array y después llama a PruneAnnotationReferencesInStructureTree para que el diccionario OBJR cuyo /Obj nombraba esa anotación se elimine de su elemento de estructura, y el elemento mismo se elimine si el OBJR era su único hijo. Dejar el OBJR en su lugar violaría §14.7.4.3, que exige que /Obj referencia a un objeto existente, y aparecería en una verificación PDF/UA como un link etiquetado sin anotación detrás. Note la asimetría con los marcadores: los links se eliminan, no se reapuntan. Una referencia cruzada en el cuerpo del texto que decía "ver página 3" está mal una vez que la página 3 no está, y apuntarla a la página 4 sería una mentira de una forma en que un marcador que cae en el capítulo más cercano no lo es, así que si su flujo de trabajo necesita conservar esos links, reapúntelos usted mismo antes de llamar a DeletePage
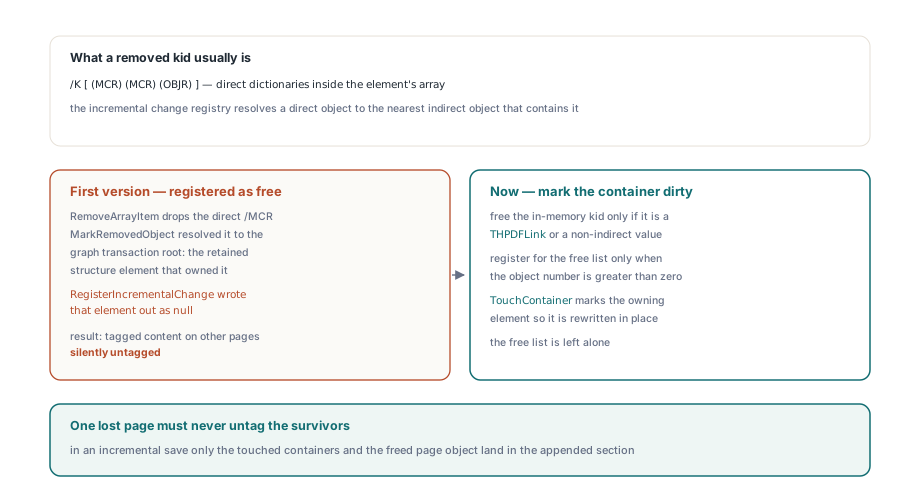
¿Por qué un /MCR o un /OBJR eliminado nunca debe registrarse como libre?
Porque las referencias de contenido marcado y las referencias de objeto suelen ser diccionarios directos dentro del array /K de su elemento padre, y el registro de cambios incrementales resuelve un objeto directo al objeto indirecto más cercano que lo contiene. Cuando RemoveArrayItem saca un hijo de un array /K, libera el objeto en memoria solo si era un THPDFLink o un valor no indirecto, y MarkRemovedObject registra un objeto en la lista de libres solo cuando su número de objeto es mayor que cero. La primera versión de este barrido no hacía esa distinción, y el efecto en un save incremental fue exactamente lo que el registro está diseñado a hacer: RegisterIncrementalChange subía desde el /MCR directo hasta su raíz de transacción en el grafo, que era el elemento de estructura retenido que lo poseía, y escribía ese elemento como null. Un documento al que se le sacó una página volvía con el contenido etiquetado de las otras páginas desetiquetado en silencio. La única jugada correcta para un hijo directo es marcar su contenedor como sucio a través de TouchContainer para que el contenedor se reescriba, y dejar la lista de libres en paz
// Actualización incremental: solo los contenedores tocados y el
// objeto de página liberado caen en la sección agregada.
Pdf := THotPDF.Create(nil);
try
  Pdf.BeginIncrementalUpdate('tagged-report.pdf');
  Pdf.DeletePage(0);
  // Los elementos de estructura retenidos cuyo /K perdió un /MCR
  // directo se reescriben in place, nunca como null.
  Pdf.SaveIncrementalUpdate('tagged-report-trimmed.pdf');
finally
  Pdf.Free;
end;
La misma precaución marca lo que DeletePage deliberadamente no libera en un documento cargado. Los content streams, los XObjects y las anotaciones que no son widget de la página borrada se dejan como objetos, porque un archivo cargado puede compartir cualquiera de ellos con una página que queda y no hay forma barata de probar lo contrario en el momento del borrado. Sacar la referencia del árbol de páginas alcanza para la corrección; los bytes que esos objetos todavía ocupan son otra pregunta, y el grafo de dependencias de objetos y el análisis de bytes retenidos es la herramienta para medir qué sigue cargando un documento recortado
DeletePage contra DeleteLoadedPage: ¿cuál conviene llamar?
Llame a DeletePage para cualquier borrado de página que vea el usuario, y reserve DeleteLoadedPage para el caso en que se esté rearmando todo el documento y ninguna referencia de nivel documento valga la pena conservar. THotPDF.DeleteLoadedPage(PageIndex), agregado en la versión 2.508.0, es la variante liviana: desplaza el array interno de páginas, llama a RebuildLoadedKidsArray para reescribir /Kids y /Count, invalida la caché de páginas renderizadas y dispara OnLoadedDocumentModified. No recorre el árbol de nombres, los outlines, el árbol de estructura ni las anotaciones de otras páginas, y no marca el objeto de página como borrado. Esa es la herramienta correcta dentro del armado N-up, donde HotPDF agrega hojas recién compuestas y después descarta cada página original con DeleteLoadedPage(0): las páginas fuente se reemplazan en bloque, y el contenido de la hoja se refiere a sus recursos y no a los objetos de página. Para el trabajo común de "sacar la página 7 de este contrato", DeletePage es la única llamada que deja un documento etiquetado, con marcadores y con links cruzados lo bastante consistente como para pasar un validador, tanto en una reescritura completa con SaveLoadedDocument como en una actualización incremental con SaveIncrementalUpdate. Los dos métodos vienen en HotPDF Delphi Component para Delphi y C++Builder, sin runtime de visor externo ni dependencias