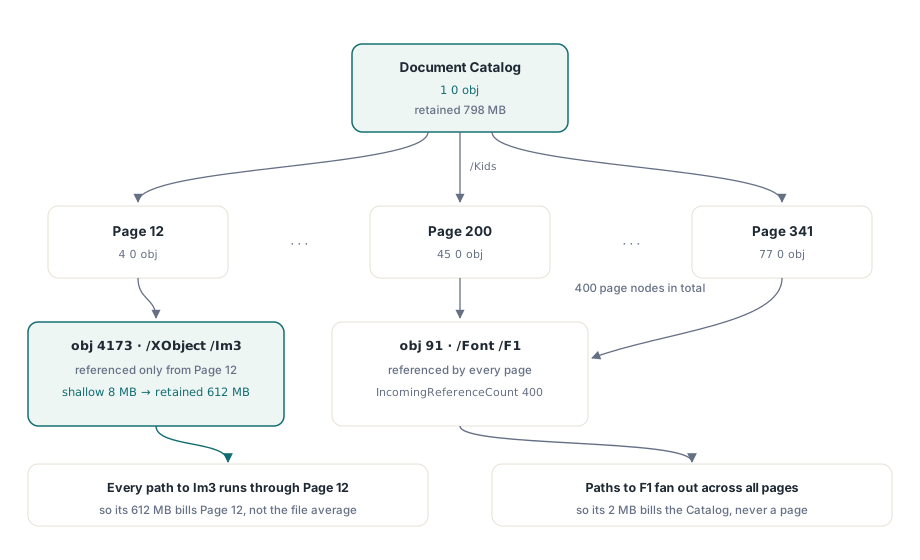
Para un reporte de 400 páginas que incrusta una sola fuente de 2 MB, cobrarle a cada página todo lo que referencia produce un total extraño: las páginas suman 800 MB de fuente en un archivo que tal vez ocupa 30 MB en disco. Divida la fuente en partes iguales y cada página cuesta unos 5 KB, así que nada parece caro y la memoria parece venir de ningún lado. Ninguno de los dos números responde la pregunta real: cuántos bytes se liberarían si un objeto dado desapareciera
Esa cifra tiene nombre en el análisis de heap, tamaño retenido, y la teoría de grafos tiene una forma limpia de calcularla. Un objeto se le factura a su dominador, el objeto más cercano por el que toda ruta desde la raíz tiene que pasar para llegar a él. Los objetos compartidos flotan hacia arriba hasta llegar a un nodo que realmente los posee, los exclusivos se quedan donde están, y los totales suman sin contar dos veces
Tamaño superficial, tamaño retenido y la regla del dominador en HotPDF
HotPDF calcula esto para un documento cargado mediante THotPDF.BuildLoadedObjectDependencyGraph. La llamada devuelve un THPDFObjectDependencyNode por cada objeto indirecto cargado y una THPDFObjectDependencyEdge por cada referencia indirecta, y luego ejecuta un análisis de dominadores con raíz en el Catalog del documento, el objeto nombrado por la entrada /Root del trailer (ISO 32000-1 §7.7.2). Cada nodo carga dos tamaños. EstimatedShallowBytes es lo que el objeto cuesta por sí solo. EstimatedRetainedBytes es su propio costo más el costo superficial de cada objeto que domina
Volvamos a la fuente. Todas las páginas la referencian, así que ninguna página la domina; las rutas solo convergen en el nodo del árbol de páginas que está encima de esas páginas, que en un árbol plano es el objeto raíz /Pages. Los 2 MB de la fuente aterrizan ahí y luego se consolidan en el Catalog. Un XObject de imagen dibujado en la página 12 y en ningún otro lado es el caso contrario: toda ruta hacia él pasa por la página 12, así que el tamaño retenido de la página 12 incluye la imagen completa. La parte superior de la lista retenida es, por lo tanto, una lista de objetos cuya eliminación liberaría memoria
La misma aritmética regala una verificación cruzada. THPDFObjectDependencyGraphInfo.CatalogRetainedBytes equivale a la suma de los tamaños superficiales de todos los objetos alcanzables desde el Catalog, y TotalEstimatedBytes es la suma de los tamaños superficiales de todos los objetos cargados, alcanzables o no. La brecha entre ambos es memoria retenida por objetos a los que el documento ya no apunta
Ejecutar el grafo y leer un resultado fallido
El método devuelve True solo cuando el análisis completo terminó, y ese valor de retorno es lo que hay que revisar. Un resultado False igual llena el registro de información, pero los arreglos no son algo que se pueda reportar. Cuando el conteo de objetos supera MaxObjects (250,000 por defecto), el método se detiene antes de construir nodos y pone ObjectCount en uno más que el límite, así que usted se entera de que el límite era muy pequeño, no de qué tan grande es el documento. Cuando el presupuesto de aristas (2,000,000 por defecto) o el límite de anidamiento de 256 niveles para objetos directos se alcanza durante el escaneo, los nodos regresan con tamaños superficiales parciales y sin tamaños retenidos ni alcanzabilidad
uses
  SysUtils, HPDFDoc;

procedure ProfileLoadedPdf(const FileName: string);
var
  Pdf: THotPDF;
  Nodes: THPDFObjectDependencyNodeArray;
  Edges: THPDFObjectDependencyEdgeArray;
  Info: THPDFObjectDependencyGraphInfo;
begin
  Pdf := THotPDF.Create(nil);
  try
    // LoadFromFile devuelve el conteo de páginas; 0 significa que la carga falló
    if Pdf.LoadFromFile(FileName) = 0 then
      Exit;

    // Límites elevados para una ejecución forense fuera de línea
    if not Pdf.BuildLoadedObjectDependencyGraph(Nodes, Edges, Info,
      1000000, 8000000) then
    begin
      // Log es su propia rutina de registro
      Log(Format('graph incomplete: %s (limit %s, invalid %s, objects %d)',
        [string(Info.Diagnostic), BoolToStr(Info.LimitExceeded, True),
         BoolToStr(Info.InvalidObjectGraph, True), Info.ObjectCount]));
      Exit; // no jerarquice ni sume un arreglo de nodos parcial
    end;

    Log(Format('%d objects, %d edges (%d unresolved), %d reachable',
      [Info.ObjectCount, Info.EdgeCount, Info.UnresolvedReferenceCount,
       Info.ReachableObjectCount]));
    Log(Format('estimated %d bytes, Catalog retains %d, unreachable %d',
      [Info.TotalEstimatedBytes, Info.CatalogRetainedBytes,
       Info.TotalEstimatedBytes - Info.CatalogRetainedBytes]));

    LogTopRetained(Nodes, Edges, 10);
  finally
    Pdf.Free;
  end;
end;
Otros dos indicadores merecen una mirada en esa rama de fallo. InvalidObjectGraph se activa cuando el objeto Catalog no se encuentra entre los objetos cargados, o cuando un objeto directo resulta contenerse a sí mismo, lo que solo ocurre en entrada mal formada. LimitExceeded también cubre un análisis de dominadores que no converge tras 128 pasadas. Diagnostic explica cada caso en una línea. Pasar cero o un valor negativo en MaxObjects, o un MaxEdges negativo, lanza EArgumentOutOfRangeException en lugar de devolver False
Cuando la llamada falla por un límite, descarte los arreglos y vuélvala a ejecutar con cotas más grandes. Los tamaños superficiales parciales se ven plausibles en un log y están equivocados justo de la forma que manda a la gente tras el objeto equivocado. Las cotas existen porque el grafo tiene un costo propio: cada arista guarda una cadena Path, así que una ejecución de ocho millones de aristas asigna ocho millones de cadenas pequeñas encima del documento que está midiendo. Esto pertenece a una ruta de diagnóstico que alguien dispara a propósito
¿Qué cuenta realmente EstimatedShallowBytes?
EstimatedShallowBytes estima memoria residente, no bytes en el archivo. Para cada objeto suma el tamaño de instancia del objeto parseado y sus hijos directos, los slots que sostienen las listas de diccionarios y arreglos, la longitud de cada clave, nombre y cadena, y el payload de un stream si ese payload está en RAM: un memory stream, o un stream de carga diferida que ya fue leído a memoria. Un stream cuyos bytes aún viven en el archivo de origen, o que fue derramado a un archivo temporal, contribuye solo su overhead de objeto
Eso tiene una consecuencia práctica. Un archivo cargado de escaneos perfilado justo después de la carga puede mostrar tamaños retenidos modestos para sus imágenes, porque nada las ha decodificado aún. Ejecute el grafo después del paso que hizo crecer el proceso (renderizado, extracción de texto, una combinación) y los streams materializados aparecerán con su peso real. Para una verificación reproducible, perfile el mismo archivo dos veces, una justo después de LoadFromFile y otra después de la operación costosa, y compare las entradas superiores
ObjectType es grueso. Reporta el tipo de valor PDF, otStream u otDictionary y así sucesivamente, así que una imagen, un programa de fuente y un content stream de página se leen todos como otStream. La arista entrante es donde se ve el rol. THPDFObjectDependencyEdge.Path registra en qué parte del objeto origen se encontró la referencia, empezando en $, con /Key para entradas de diccionario, [n] para elementos de arreglo y /dictionary para el diccionario de un stream. Una ruta $/Resources/XObject/Im3 desde una página, o $/XObject/Im3 desde un diccionario de recursos aparte, significa que el objeto se usa como un XObject llamado Im3; $/FontFile2 viniendo de un descriptor de fuente significa un programa TrueType incrustado; $/Contents[0] significa contenido de página
// Su propio helper, no parte de la librería: ordena los primeros Count nodos por
// tamaño retenido e imprime la ruta de una referencia entrante de cada uno
procedure LogTopRetained(const Nodes: THPDFObjectDependencyNodeArray;
  const Edges: THPDFObjectDependencyEdgeArray; Count: Integer);
var
  Taken: array of Boolean;
  I, J, Best: Integer;
  Via: AnsiString;
begin
  SetLength(Taken, Length(Nodes));
  for I := 1 to Count do
  begin
    Best := -1;
    for J := 0 to High(Nodes) do
      if (not Taken[J]) and ((Best < 0) or
         (Nodes[J].EstimatedRetainedBytes >
          Nodes[Best].EstimatedRetainedBytes)) then
        Best := J;
    if Best < 0 then
      Break;
    Taken[Best] := True;

    Via := '(no incoming reference)';
    for J := 0 to High(Edges) do
      if Edges[J].Resolved and
         (Edges[J].TargetObjectNumber = Nodes[Best].ObjectNumber) and
         (Edges[J].TargetGenerationNumber = Nodes[Best].GenerationNumber) then
      begin
        Via := Edges[J].Path;
        Break;
      end;

    Log(Format('%d %d obj  shallow %d  retained %d  refs in %d  via %s',
      [Nodes[Best].ObjectNumber, Nodes[Best].GenerationNumber,
       Nodes[Best].EstimatedShallowBytes, Nodes[Best].EstimatedRetainedBytes,
       Nodes[Best].IncomingReferenceCount, string(Via)]));
  end;
end;
Una ruta entrante basta para clasificar la mayoría de los objetos. Para un objeto compartido, IncomingReferenceCount le dice cuántas referencias hay, y ImmediateDominatorObjectNumber con su número de generación le dice qué objeto lo posee tras el análisis de dominadores. Ese campo es -1 para el Catalog y para todo objeto que el Catalog no puede alcanzar. Una arista cuyo indicador Resolved es False apunta a un número de objeto que no está cargado; esas se cuentan en UnresolvedReferenceCount, y un conteo alto en un archivo por lo demás sano suele significar una sección de referencias cruzadas dañada
¿De dónde salen los objetos inalcanzables?
Un nodo con ReachableFromCatalog en False está cargado y cuesta memoria, pero ninguna cadena de referencias desde el Catalog llega a él, así que nada en la estructura del documento lleva a un visor hasta él. Su tamaño retenido equivale a su tamaño superficial, porque el análisis de dominadores solo corre sobre objetos alcanzables. Sumar EstimatedRetainedBytes sobre los nodos inalcanzables da entonces la misma respuesta que TotalEstimatedBytes - CatalogRetainedBytes
Las actualizaciones incrementales son una fuente común, aunque no de la forma que la gente suele asumir. Cuando una revisión posterior redefine el objeto 2120, la entrada de referencias cruzadas más nueva gana y la definición anterior nunca se carga, así que las copias sustituidas del mismo número de objeto no aparecen en el grafo. Lo que sí aparece es un objeto que una revisión posterior simplemente dejó de referenciar: una anotación eliminada de un arreglo /Annots reescrito, una imagen reemplazada por un nuevo número de objeto, un campo de formulario quitado del AcroForm. Nada en ISO 32000-1 §7.5.6 obliga a una actualización a marcar esas entradas como libres, y mientras los datos de referencias cruzadas las listen como en uso, el cargador las trata como objetos vivos. El artículo sobre object streams y actualizaciones incrementales cubre cómo se apilan las revisiones
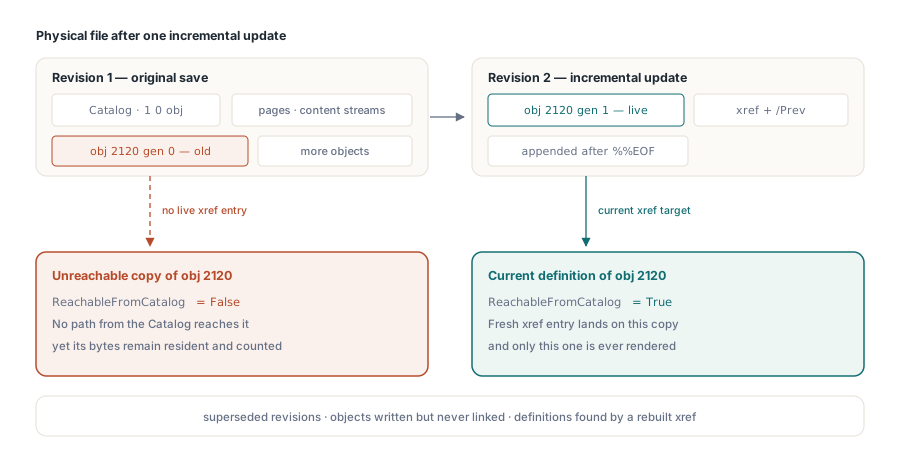
Las otras dos fuentes son productores que escriben objetos y luego fallan en enlazarlos, y archivos dañados cuyos datos de referencias cruzadas tuvieron que reconstruirse escaneando, lo que puede recoger definiciones de objetos que nada referencia. Cuando una gran parte del total estimado vive en nodos inalcanzables, una reescritura limpia del archivo le gana a anexar otra revisión más, y el grafo le da el conteo de bytes para justificar el guardado más lento
¿Es el parser el que retiene la memoria?
Antes de culpar al documento, revise cómo se comportó la carga misma. Dos llamadas describen al parser en lugar del contenido, y ambas se reinician al comienzo de cada LoadFromFile o LoadFromStream, así que siempre describen la carga más reciente
GetLastParserArenaStatistics llena un registro THPDFParserArenaStatistics para la arena de bloques que sostiene tokens y búferes de vida corta durante el parseo. Los bloques son de 64 KiB (BlockSize), y una asignación mayor que un bloque recibe un bloque de su propio tamaño. AllocationCount menos ReusedAllocationCount equivale a BlockAllocationCount, el número de veces que la arena tuvo que pedirle un bloque nuevo al administrador de memoria. Los bloques se conservan durante la vida de la instancia THotPDF y se liberan cuando se destruye. Si una instancia procesa un lote completo, RetainedBytes refleja aproximadamente el mayor working set que cualquier archivo del lote necesitó, lo que explica una meseta que dura hasta que el componente se libera. TemporaryObjectElisionCount cuenta las claves de diccionario leídas directo a la arena en lugar de construirse como objetos de nombre temporales
GetDocumentStringInternStatistics describe el pool por documento que deduplica nombres PDF, operadores de content stream y cadenas cortas. Las cadenas de 1 a 64 bytes son elegibles. El pool retiene como máximo 65,536 entradas y 4 MiB, y esos topes regresan en el registro como MaxStringLength, MaxEntryCount y MaxRetainedBytes. Una cadena vacía, de más de 64 bytes, o nueva cuando el pool está lleno se cuenta en BypassCount y se conserva como cadena ordinaria. Un archivo que genera cantidades enormes de nombres únicos cuesta entonces aproximadamente lo que costaría sin el pool, y no más
var
  Arena: THPDFParserArenaStatistics;
  Intern: THPDFDocumentStringInternStatistics;
begin
  if Pdf.GetLastParserArenaStatistics(Arena) then
    Log(Format('arena: %d blocks, %d bytes held, peak %d, ' +
      '%d new blocks for %d allocations, %d tokens',
      [Arena.RetainedBlockCount, Arena.RetainedBytes, Arena.PeakUsedBytes,
       Arena.BlockAllocationCount, Arena.AllocationCount, Arena.TokenCount]));

  if Pdf.GetDocumentStringInternStatistics(Intern) then
  begin
    Log(Format('intern: %d of %d requests hit, %d bypassed, %d bytes reused',
      [Intern.HitCount, Intern.RequestCount, Intern.BypassCount,
       Intern.ReusedBytes]));
    // Su propia verificación, no una llamada de la librería: marca un pool que alcanzó sus topes
    if (Intern.EntryCount >= Intern.MaxEntryCount) or
       (Intern.RetainedBytes + Intern.MaxStringLength >
        Intern.MaxRetainedBytes) then
      Log('intern pool at its cap: later strings were not deduplicated');
  end;
end;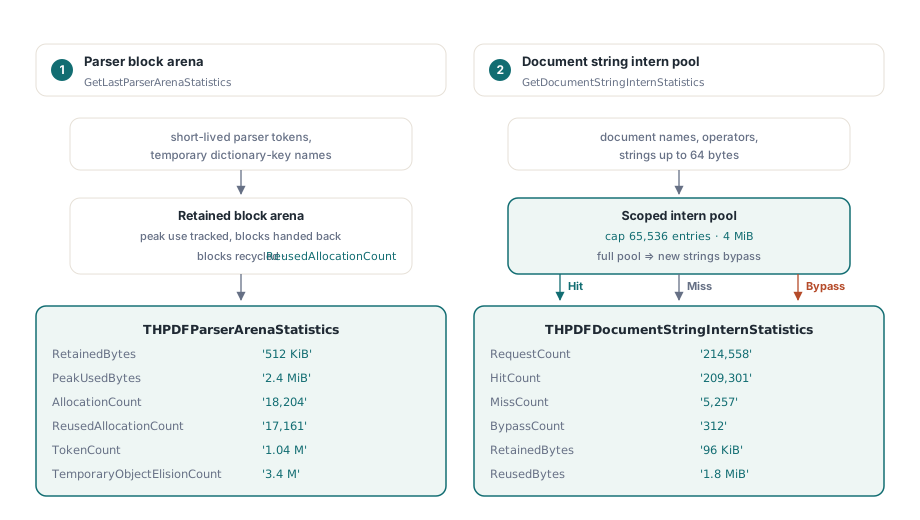
Los PDF típicos repiten un vocabulario pequeño de nombres y operadores, así que HitCount se queda cerca de RequestCount y ReusedBytes crece con el conteo de páginas. Un BypassCount que se acerca a RequestCount en un archivo modesto es inusual. En una ruta de ingesta de subidas no confiables, regístrelo
Un orden de triaje para una queja de memoria
Comience con CatalogRetainedBytes. Si está cerca del crecimiento que midió en el proceso, la memoria está en el documento y la cima de la lista retenida lo nombrará. Si está muy por debajo, la memoria vive en algún lado que el grafo no mide, como sus propios cachés, bitmaps renderizados o la arena del parser, y el registro de la arena es lo siguiente que hay que leer
- Jerarquice los nodos por
EstimatedRetainedBytesy lea laPathentrante de los diez primeros. Los objetivos XObject en la cima suelen apuntar a contenido cargado de escaneos donde el downsampling paga; los objetivos/FontFile,/FontFile2o/FontFile3apuntan a programas de fuente completos incrustados donde bastarían subconjuntos; los streams/Contentsgrandes suelen venir de salida vectorial generada, como mapas o exportaciones CAD - Reste
CatalogRetainedBytesdeTotalEstimatedBytes. Un residuo grande son objetos varados, así que la corrección pertenece al paso de guardado - Lea los registros de arena e intern al final. Rara vez explican gigabytes, pero sí explican un proceso que se queda grande después de cerrar cada documento
Ejecute esos pasos en ese orden. El primero zanja la mayoría de las quejas, y para documentos muy grandes la respuesta estructural suele ser dejar de sostener el grafo de objetos completo a la vez, que es para lo que está hecho el flujo de trabajo de la API de archivo directo
Los tres diagnósticos son llamadas de método ordinarias que devuelven registros planos, así que encajan en cualquier registro o telemetría que una aplicación Delphi o C++Builder ya tenga. HotPDF se distribuye como componente VCL nativo con código fuente completo; la documentación y una descarga de prueba están en la página del componente HotPDF Delphi PDF