Agregue un nuevo rango de etiquetas al manual de un proveedor para que el apéndice lea App-a, App-b en lugar de A-1, A-2, guarde y reabra el archivo. El page box sigue diciendo A-1. Abra el catálogo en un editor de texto y el diccionario /PageLabels muestra la razón: trae un arreglo /Kids heredado del productor y, justo al lado, un arreglo /Nums fresco que guarda su rango. ISO 32000-1 deja que la raíz de un number tree tenga una de esas claves u otra, y un lector que encuentra /Kids en la raíz desciende por ella y no busca más
Cómo guarda PDF rangos de etiquetas de página
Las page labels son las cadenas que un visor muestra en su page box en lugar del índice físico de página, e ISO 32000-1 §12.4.2 las guarda en un number tree bajo la clave de catálogo /PageLabels. Cada clave es un índice de página base cero donde comienza un rango de etiquetado. Cada valor es un diccionario de etiqueta con hasta tres entradas: /S para el estilo de numeración (D, R, r, A o a), /P para una cadena de prefijo, y /St para el número de la primera página del rango, que por omisión es 1. Un rango corre hasta la siguiente clave. La especificación también exige una entrada para el índice de página 0, así que cada página del documento cae dentro de algún rango
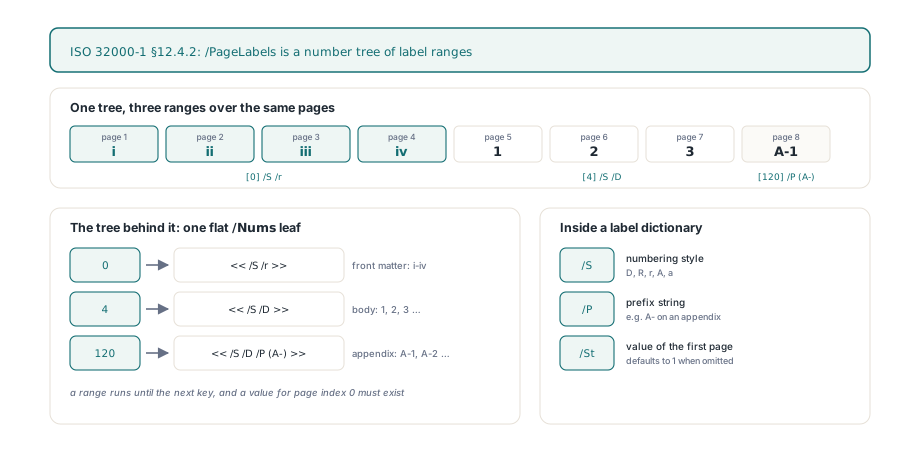
En PDF Library for Delphi el escritor es TPDFlib.AddPageLabels(Start, Style, Offset, Prefix), y se mapea a ese diccionario con tres reglas que vale la pena memorizar. Start es base 1 como cualquier otro argumento de página en la biblioteca, y entra al árbol como Start - 1. Style va de 0 a 5: 0 no escribe ningún /S, así que la etiqueta es solo el prefijo (útil para una sola página etiquetada Cover), y 1 a 5 se vuelven D, R, r, A y a. Un estilo fuera de 0..5 hace que la llamada devuelva 0 y deja el documento intacto. Offset se vuelve /St solo cuando es mayor que cero; pase 0 y la clave se omite, lo que todo lector interpreta como 1
Un libro típico que sale de una herramienta de maquetación necesita tres rangos: números romanos en minúsculas para el front matter, números arábigos para el cuerpo, y un apéndice con prefijo
uses
  PDFlibrary;

var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('handbook.pdf', '') <> 1 then
      Exit;
    // Páginas 1-4: i, ii, iii, iv (romanos en minúsculas)
    Lib.AddPageLabels(1, 3, 1, '');
    // Páginas 5-120: 1, 2, 3 ... (decimal, reiniciando en 1)
    Lib.AddPageLabels(5, 1, 1, '');
    // Páginas 121 en adelante: A-1, A-2 ... (decimal con prefijo)
    Lib.AddPageLabels(121, 1, 1, 'A-');
    WriteLn(Lib.GetPageLabel(5));    // 1
    WriteLn(Lib.GetPageLabel(122));  // A-2
    Lib.SaveToFile('handbook-labeled.pdf');
  finally
    Lib.Free;
  end;
end;
Las page labels llegaron en PDF 1.3, así que cada llamada también le pide al documento subir su versión de salida a por lo menos 1.3. Si usted fijó la versión con LockSaveVersion, esa petición se ignora y el bloqueo se mantiene, porque la biblioteca no pasa por encima de una versión que usted eligió a propósito. Si va a bloquear, bloquee en 1.3 o superior en cualquier trabajo que escriba etiquetas
¿Por qué un rango nuevo desaparece cuando la raíz tiene /Kids?
El rango desaparece porque ISO 32000-1 §7.9.7 (Tabla 37) le da a la raíz de un number tree /Kids o /Nums, nunca ambos, y los lectores eligen /Kids cuando está presente. Los productores que escriben documentos largos suelen dividir el árbol en nodos intermedios, cada uno con un par /Limits, y colgarlos de una raíz que solo tiene /Kids. Una rutina de inserción que solo conoce /Nums mira esa raíz, no encuentra ningún arreglo, crea uno junto al /Kids existente y mete ahí el rango nuevo. La escritura tiene éxito. El archivo sigue siendo parseable. Entonces cada visor desciende por /Kids, ve los tres rangos originales del productor, y nunca toca el arreglo perdido, que es exactamente el síntoma del manual del proveedor del párrafo inicial
La salida es dejar de tratar la raíz como un contenedor que podría hacer crecer un segundo punto de entrada. Cuando AddPageLabels encuentra /Kids en la raíz, primero recorre cada hoja del árbol existente de izquierda a derecha y recolecta cada clave con su diccionario de etiqueta, y luego construye un arreglo /Nums plano a partir de esa lista. /Kids, /Limits y cualquier /Nums sobrante se retiran de la raíz antes de adjuntar el arreglo plano, y solo entonces entra el rango nuevo con una inserción ordenada común. Quitar /Limits también importa: la Tabla 37 lo permite solo en nodos intermedios y hojas, y una raíz que lo conserve está malformada aunque ahora guarde /Nums
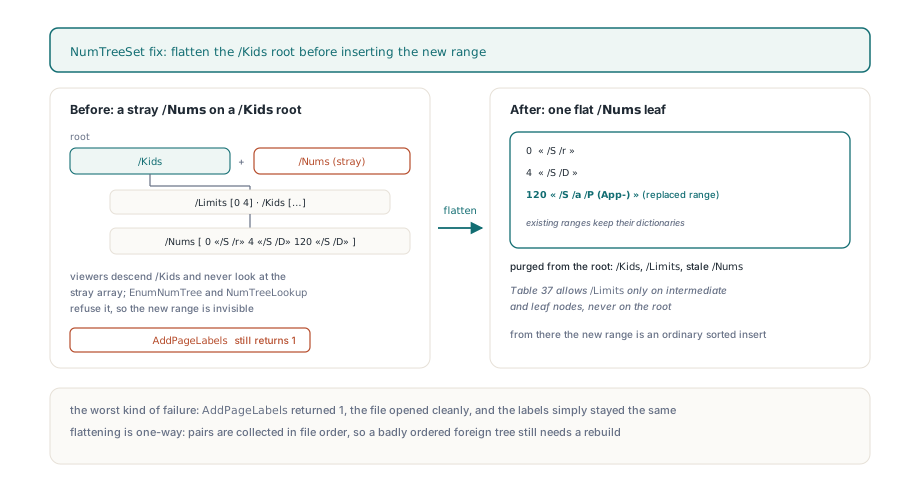
Un efecto secundario es fácil de pasar por alto. Si un archivo le llega ya roto, con ambas claves en la raíz porque alguna herramienta anterior hizo la inserción ingenua, el recorrido de hojas sigue /Kids igual que lo haría un visor, así que los rangos del arreglo perdido no se trasladan. Un visor nunca mostró esos rangos tampoco, así que las etiquetas después de la edición coinciden con lo que los lectores ya veían
El árbol aplanado no se reconstruye después en nodos /Kids balanceados, y creemos que es la decisión correcta para este árbol en particular. El balanceo rinde para name trees con miles de destinos o archivos incrustados. Un árbol de page labels tiene una entrada por rango de etiquetado, y hasta un manual de referencia grande rara vez necesita más de unas pocas docenas; una sola hoja también es lo que la mayoría de los productores escribe cuando no están dividiendo por dividir. Un pase de rebalanceo agregaría código que puede fallar en cada guardado, por una ganancia de búsqueda que nadie podría medir en un árbol tan pequeño
// Reetiquete el apéndice en un archivo cuya raíz de /PageLabels usa /Kids
if Lib.LoadFromFile('vendor-manual.pdf', '') = 1 then
begin
  WriteLn('Before: ', Lib.GetPageLabel(121));  // p. ej. A-1
  // Misma página de inicio que el rango existente, así que su valor se reemplaza
  if Lib.AddPageLabels(121, 5, 1, 'App-') = 1 then
  begin
    WriteLn('After: ', Lib.GetPageLabel(121));  // App-a
    WriteLn('Front: ', Lib.GetPageLabel(2));    // ii, sin cambios
    Lib.SaveToFile('vendor-manual-relabeled.pdf');
  end;
end;
Como el rango nuevo empieza en el mismo índice de página que una clave existente, la inserción reemplaza el diccionario de esa clave en lugar de agregar una segunda entrada para el índice de página 120. Los rangos romano y decimal de las hojas del productor pasan con sus diccionarios originales, incluidos los valores /St que tengan
El recorrido de hojas tiene que sobrevivir árboles malformados también. Una entrada /Kids que apunta de vuelta a uno de sus propios ancestros, o dos ramas que comparten una hoja, aparece en archivos de canalizaciones dañadas. El recorrido recuerda qué nodos ya visitó, así que un ciclo se recorre una vez y luego se deja atrás, y una hoja compartida aporta sus rangos una sola vez. Las mismas preocupaciones para name trees están cubiertas en manejo de ciclos de name tree, /Limits erróneos y hojas grandes
Recorrer un arreglo /Nums en pares
Un arreglo /Nums es una tira plana de entradas alternadas, [key0 value0 key1 value1 ...], y solo las posiciones pares son claves. Esa disposición invita a un error clásico. Un bucle que avanza un elemento a la vez y pregunta "¿esto es un número?" comparará valores como si fueran claves cada vez que un valor resulte numérico. Si esa comparación gana una prueba de menor que, el punto de inserción cae en un índice impar, el nuevo par entra en medio de uno existente, y cada clave y valor posteriores intercambian lugares
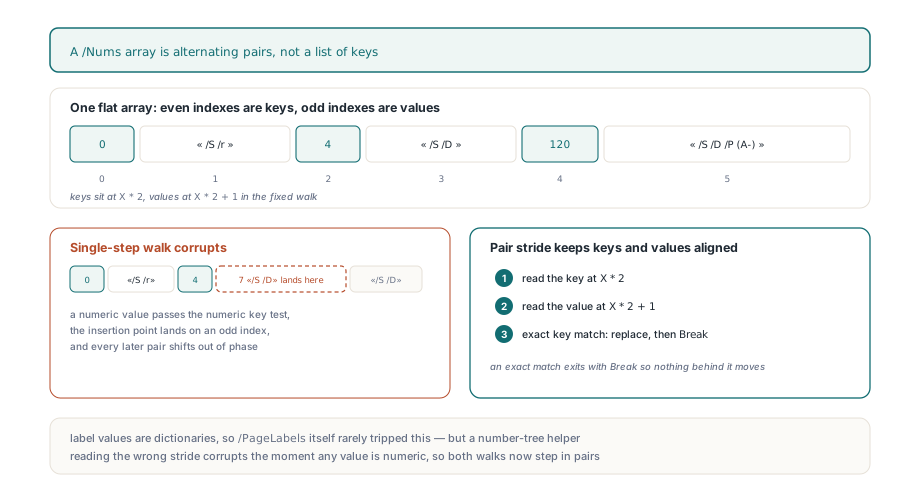
Los valores de page label son diccionarios, así que el error se esconde en /PageLabels mismo. Aparece el día en que el mismo helper se reutiliza para un number tree cuyos valores son números simples, y nada en la sintaxis del arreglo le advierte qué tipo está sosteniendo. PDF Library for Delphi lee las claves en el índice X * 2 y los valores en X * 2 + 1 tanto en el recorrido de hojas como en la inserción, y una coincidencia exacta de clave reemplaza el valor y detiene el escaneo. Si usted escribe su propio código de number tree contra objetos crudos, copie ese paso antes que nada
Leer etiquetas de vuelta con GetPageLabel
TPDFlib.GetPageLabel(Page) devuelve la etiqueta de una página base 1, y sus dos alternativas se comportan distinto a propósito. Un documento sin ninguna entrada /PageLabels devuelve el número de página decimal, así que quien llama puede usar la función incondicionalmente para mostrar. Un documento que tiene un árbol pero ningún rango que cubra la página pedida devuelve una cadena vacía. Ese segundo caso es lo que produce un archivo que se salta la entrada obligatoria del índice de página 0: las primeras páginas no tienen etiqueta en el sentido de la especificación, y una cadena vacía lo reporta con más honestidad que un número inventado. Empiece siempre su conjunto de etiquetas en la página 1
Los estilos de letras siguen la especificación de PDF en vez de las columnas de hojas de cálculo. Después de Z viene AA, luego BB, luego CC; la letra se repite en vez de acarrear, así que la página 53 de un rango A es AAA. Los romanos se generan en mayúsculas para R y en minúsculas para r, y el prefijo se antepone sin cambios en ambos casos
var
  P: Integer;
  Data: WideString;
begin
  // Auditoría rápida de lo que un visor mostrará en su page box
  for P := 1 to Lib.PageCount do
    WriteLn(P, ' -> ', Lib.GetPageLabel(P));

  // El valor de opción 4 exporta solo los rangos de etiquetas, un bloque PageLabelBegin
  // por rango
  Data := Lib.ExportDocumentData(4);
  // ... edite el texto, o llévelo a otro archivo ...
  // El primer registro de etiquetas limpia los rangos existentes, luego cada registro
  // se repite vía AddPageLabels; devuelve los registros aplicados
  WriteLn(Lib.ImportDocumentData(Data, 4), ' label ranges applied');
end;
Para ediciones en volumen, ExportDocumentData con valor de opción 4 escribe cada rango como un bloque PageLabelBegin seguido de líneas PageLabelNewIndex (la página de inicio base 1), PageLabelStart, un PageLabelPrefix opcional y PageLabelNumStyle, con nombres como LowercaseRomanNumerals y DecimalArabicNumerals. ImportDocumentData trata el primer registro de etiquetas que encuentra como un reemplazo completo: llama a ClearPageLabels una vez, lo que retira toda la entrada /PageLabels del catálogo, y luego alimenta cada registro a AddPageLabels. El árbol reconstruido es una sola hoja desde el inicio, así que una ida y vuelta por texto de un original con forma de /Kids regresa en la misma forma plana que produce la ruta de reetiquetado
Orden de hojas y movimientos de página después de reetiquetar
Aplanar conserva los rangos en el orden en que los encuentra. §7.9.7 exige claves en orden ascendente, pero circulan archivos con hojas fuera de orden, y GetPageLabel aplica el último rango en ese orden cuya clave esté en o por debajo del índice de página. Para un archivo que declara sus rangos como [0 roman, 120 A-, 4 decimal], con el rango decimal empezando en 1, la página 122 resuelve al rango decimal y lee 118 donde usted esperaba A-2. Si la auditoría página por página de arriba muestra etiquetas así, no las parche con una llamada AddPageLabels más. Llame a ClearPageLabels y vuelva a escribir el conjunto completo en orden ascendente; cuatro llamadas cuestan menos que razonar sobre qué rango gana
Las etiquetas también están atadas a índices de página, no a objetos de página. Cualquier cosa que cambie el conteo o el orden de páginas deja los rangos exactamente donde estaban, apuntando a las páginas que ahora se sienten en esos índices. Un intercambio en el lugar como reemplazar páginas conservando números de objeto mantiene el conteo, así que las etiquetas quedan alineadas. Una fusión como intercalar escaneos dúplex entrelazados produce una nueva secuencia de páginas, y esa salida debería recibir un conjunto de rangos recién escrito después de la fusión, empezando en la página 1
Las llamadas de etiquetas, el aplanado de /Kids y la exportación e importación de datos de documento mostradas aquí forman parte de PDF Library for Delphi, que apunta a Delphi, C++Builder y Lazarus; su entrada de referencia para AddPageLabels lista los valores de estilo y códigos de retorno en una sola tabla