Arme un PDF cuyo name tree de /Dests tenga un root con dos hijos. El primer hijo declara /Limits [(a) (z)], y su array /Kids apunta directo de vuelta al root. El segundo hijo carga la entrada real de (chapter7), pero sus límites están escritos al revés: [(z) (a)]. Pídale a una búsqueda de name tree de libro de texto chapter7 y o recursa hasta agotar el stack o devuelve "no encontrado" para un destino al que un visor puede saltar. El archivo completo cabe en unos dos kilobytes, y cada objeto en él parsea limpio
Ese archivo mete tres trampas separadas en una sola estructura: un ciclo de /Kids, un rango que reclama una clave que no tiene, y un rango que jamás puede coincidir con nada. Una cuarta trampa necesita un archivo mucho más grande. En cuanto una sola hoja carga más de 32,768 pares nombre/valor, cualquier código que meta "qué hoja" y "qué entrada" en un solo entero de 32 bits empieza a apuntar al par equivocado. El resto de este artículo recorre cada trampa, lo que debería hacer un reader al respecto, y cómo se comportan las llamadas Delphi en archivos armados así
Cuatro features de PDF que descansan en name trees y number trees
Los name trees y number trees sostienen toda feature de PDF que mapea un set grande de claves a objetos, y PDFlibPas, la PDF Library de losLab para Delphi, expone cuatro de ellas mediante métodos públicos de TPDFlib. ISO 32000-1 §7.9.6 define el name tree (claves de cadena, Table 36) y §7.9.7 el number tree (claves enteras, Table 37). Los nodos root e intermedios cargan /Kids; las hojas cargan pares clave/valor ordenados en /Names o /Nums; se espera que todo nodo que no sea root cargue un array /Limits de dos elementos con la clave menor y la mayor debajo de él
| Árbol | Dónde vive | Especificación | API de lectura de PDFlibPas |
|---|---|---|---|
| Named destinations | /Dests en el diccionario de nombres | §12.3.2.3 | GetNamedDestination, luego GetDestPage / GetDestType |
| Page labels | /PageLabels en el catálogo (number tree) | §12.4.2 | GetPageLabel |
| Attachments | /EmbeddedFiles en el diccionario de nombres | §7.7.4, §7.11.4 | EmbeddedFileCount, GetEmbeddedFileStrProperty |
| JavaScript de documento | /JavaScript en el diccionario de nombres | §7.7.4 | GlobalJavaScriptCount, GlobalJavaScriptPackageName |
Dos filas esconden un detalle. Los named destinations también existen en una forma PDF 1.1 más vieja, un diccionario /Dests plano en el catálogo indexado por objetos de nombre, y GetNamedDestination revisa ese diccionario primero y solo después baja por el name tree PDF 1.2. La fila de JavaScript tiene un casi homónimo que lee otra cosa por completo: GetDocJavaScript devuelve scripts adjuntos a los triggers del documento en el diccionario /AA del catálogo (WS, DS, WP, DP, DC), mientras que los paquetes nombrados que corren cuando se abre un documento viven en el name tree /JavaScript y los lista GlobalJavaScriptPackageName
Todas estas estructuras vienen del archivo. La especificación le dice a un writer qué debe producir, y un reader igual recibe lo que el writer, un incremental save dañado o un fuzzer pusieron ahí. Es la misma lección que endurecer un parser PDF en Pascal contra archivos maliciosos, aplicada a la forma del árbol en vez de a longitudes de buffer
¿Por qué un array /Kids cíclico tumba a un walker de árbol recursivo?
Un walker recursivo se estrella contra un array /Kids cíclico porque nada en la recursión recuerda qué nodos ya entró, así que una referencia de hijo a un ancestro convierte un archivo finito en un descenso sin fin. Un árbol legítimo puede hacer el mismo daño sin ciclo alguno: una cadena de 4,096 niveles de nodos de un solo hijo es sintaxis válida que le cuesta a un reader recursivo 4,096 frames de stack
La variante más leve ni se estrella. Cuando dos entradas /Kids referencian la misma hoja, una enumeración ingenua la visita dos veces, así que un conteo de attachments regresa más alto que la cantidad de archivos del documento y una lista de scripts muestra el mismo package dos veces
PDFlibPas recorre ambos tipos de árbol con un stack explícito last-in, first-out en el heap más un set de visitados indexado por identidad de diccionario. Un nodo se marca cuando sale del stack. Una referencia cíclica puede pasar un momento en el stack, pero se descarta en cuanto vuelve a subir, y cada diccionario distinto expande sus hijos exactamente una vez. El trabajo total queda acotado por la cantidad de diccionarios distintos más la longitud combinada de sus arrays /Kids; una cadena de 4,096 niveles se vuelve 4,096 iteraciones de bucle y 4,096 entradas de hash set
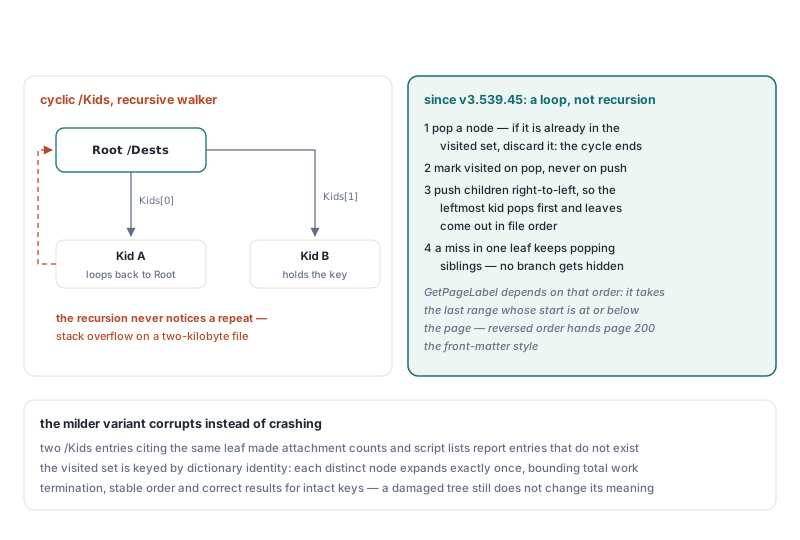
El orden es la parte donde la gente se equivoca al convertir recursión en bucle. Un stack invierte lo que usted le meta, así que los hijos hay que empujarlos del último índice al primero; entonces el hijo más a la izquierda sale primero y las hojas salen en el orden izquierda-derecha en que el productor las escribió. Marcar al sacar y no al empujar importa por la misma razón. Con marcas al empujar y empujes de derecha a izquierda, una hoja compartida por las posiciones 0 y 2 quedaría reclamada por la posición 2, y sus entradas aparecerían más tarde de lo que dice el archivo. Los page labels dependen de ese orden, como muestra la última sección
Si escribe su propio código de árboles contra otro modelo de objetos, esta es la forma que recomendamos. El tipo de nodo de abajo es deliberadamente abstracto, y ambas funciones son código del lado del reader, no llamadas de la librería
uses
  System.Generics.Collections;

type
  TTreeNode = class
  public
    Kids: TArray<TTreeNode>;   // vacío en una hoja
    Keys: TArray<string>;      // claves de hoja, ordenadas por un productor que se porta bien
    Values: TArray<Integer>;   // paralelo a Keys
    HasLimits: Boolean;
    LoKey, HiKey: string;
  end;

// Helper suyo: /Limits solo puede podar cuando es un par bien formado y ordenado
function LimitsExclude(Node: TTreeNode; const Key: string): Boolean;
begin
  Result := Node.HasLimits and (Node.LoKey <= Node.HiKey) and
    ((Key < Node.LoKey) or (Key > Node.HiKey));
end;

// Búsqueda suya: stack explícito, set de visitados, marca al sacar
function FindValue(Root: TTreeNode; const Key: string;
  out Value: Integer): Boolean;
var
  Pending: TList<TTreeNode>;
  Visited: TDictionary<TTreeNode, Byte>;
  Node: TTreeNode;
  I: Integer;
begin
  Result := False;
  Value := 0;
  if Root = nil then
    Exit;
  Pending := TList<TTreeNode>.Create;
  Visited := TDictionary<TTreeNode, Byte>.Create;
  try
    Pending.Add(Root);
    while Pending.Count > 0 do
    begin
      Node := Pending[Pending.Count - 1];
      Pending.Delete(Pending.Count - 1);
      if Visited.ContainsKey(Node) then
        Continue;                      // ciclo o hijo compartido: ya visto
      Visited.Add(Node, 0);
      if Length(Node.Kids) > 0 then
      begin
        // Empuje de derecha a izquierda para que el hijo izquierdo salga primero
        for I := High(Node.Kids) downto 0 do
          if (Node.Kids[I] <> nil) and not LimitsExclude(Node.Kids[I], Key) then
            Pending.Add(Node.Kids[I]);
      end
      else
        for I := 0 to High(Node.Keys) do
          if (Node.Keys[I] = Key) and (I <= High(Node.Values)) then
          begin
            Value := Node.Values[I];
            Exit(True);
          end;
      // Un fallo en esta hoja: siga sacando a sus hermanos
    end;
  finally
    Visited.Free;
    Pending.Free;
  end;
end;
Un fallo en una rama no dice nada del árbol
El atajo de búsqueda más común elige el primer hijo cuyo /Limits cubre la clave, baja por él, y jamás vuelve a mirar a un hermano. En un árbol limpio eso es correcto y rápido. En el archivo del párrafo inicial falla: el primer hijo reclama chapter7, regresa al root, y la búsqueda termina con las manos vacías mientras el siguiente hermano tiene la entrada
PDFlibPas no se detiene en la primera rama plausible. La búsqueda con clave detrás de GetNamedDestination empuja a todo hijo cuyo rango no descarte la clave, y sigue sacando del stack hasta encontrar coincidencia o vaciarlo. En un árbol bien formado con rangos disjuntos, a lo sumo un hijo sobrevive el chequeo de rango en cada nivel, así que el costo extra es nulo. En uno dañado son unas cuantas visitas de nodo extra, y la respuesta regresa bien
Las hojas reciben el mismo tratamiento. ISO 32000-1 exige que las claves de un array /Names estén ordenadas por valor de byte, así que la librería prueba primero una búsqueda binaria. Cuando falla, recurre a un barrido lineal de los pares, porque una hoja desordenada haría invisible una clave presente. Pagar un barrido lineal en cada fallo genuino es un costo que aceptamos: las búsquedas de nombres realmente ausentes son raras, y un "no encontrado" falso sobre un link funcional cuesta mucho más que una pasada extra sobre una hoja
Una contradicción estructural se maneja con rechazo. La Table 36 permite que un nodo cargue /Kids o /Names, jamás ambos. Una búsqueda con clave trata un nodo que carga ambos como malformado y lo salta en vez de adivinar qué mitad quiso el productor. La enumeración de number trees, como el recorrido detrás de GetPageLabel, es más tolerante y sigue /Kids cuando ambos están presentes, porque descartar un rango entero desetiquetaría todas las páginas posteriores
¿En qué puede confiar un reader respecto de /Limits?
Un reader puede confiar en /Limits para saltarse trabajo, y solo cuando el par está bien formado; jamás puede usar la entrada para concluir que una clave está ausente. La Table 36 dice que los nodos intermedios y hoja deben cargarla, pero en la práctica la entrada desaparece tras ediciones a mano, guarda números dentro de un name tree, o llega con sus cotas invertidas. PDFlibPas resuelve cada uno de esos casos de la misma manera, manteniendo al hijo buscable
/Limitsausente: un chequeo de rango que salte a tal hijo deja todo su subárbol inalcanzable cada vez que un productor olvida la entrada, así que el hijo se busca- Tipo equivocado o longitud equivocada, como números en un name tree o un array de un elemento: se maneja exactamente igual que una entrada ausente
- Cotas invertidas como
[(Z) (A)]o[9 0]: ninguna clave satisfaceLo <= Key <= HicuandoLo > Hi, así que confiar en el par excluiría la rama para toda búsqueda; un rango solo poda cuando su cota inferior no excede la superior - Bien formado y ordenado: se usa para saltar la rama, que es para lo que existe la entrada
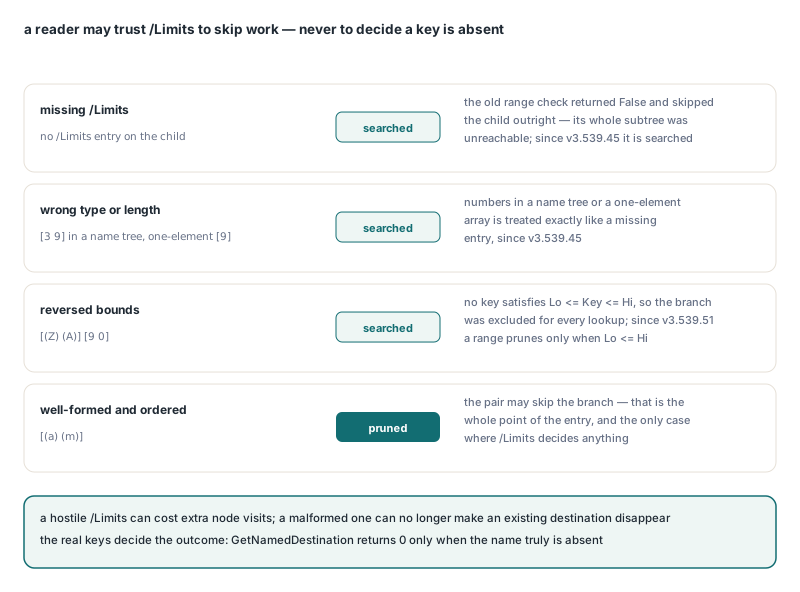
Del lado del llamador hay dos ceros que distinguir. GetNamedDestination devuelve 0 cuando el nombre realmente está ausente y un ID de destino en cualquier otro caso. Que GetDestPage devuelva 0 para un ID válido significa que el nombre existe pero su objetivo no resuelve a una página de este documento, lo que es un reporte de bug distinto. GetDestType reporta la vista como 1 para XYZ, 2 para Fit y así hasta 8 para FitBV
uses
  PDFlibrary;

procedure LookUpDestination(const FileName, DestName: string);
var
  Lib: TPDFlib;
  DestID, Page: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
    begin
      WriteLn('Load failed, error ', Lib.LastErrorCode);
      Exit;
    end;
    // Primero el /Dests del catálogo (PDF 1.1), luego el name tree /Dests
    DestID := Lib.GetNamedDestination(DestName);
    if DestID = 0 then
    begin
      WriteLn('No destination named ', DestName);
      Exit;
    end;
    Page := Lib.GetDestPage(DestID);
    if Page = 0 then
      WriteLn(DestName, ' exists but does not resolve to a page')
    else
      WriteLn(DestName, ' -> page ', Page,
        ', view type ', Lib.GetDestType(DestID));  // 1 = XYZ, 2 = Fit ...
  finally
    Lib.Free;
  end;
end;
Esto arma un chequeo de regresión compacto. Construya el archivo de dos hijos del párrafo inicial, apunte la entrada real de chapter7 a la página 2 con vista /Fit, y el procedimiento debería imprimir página 2 con tipo de vista 2. Una búsqueda de primera coincidencia imprime "No destination" porque el hijo que hace loop gana la carrera; una búsqueda que confía en rangos invertidos imprime lo mismo por la razón contraria. Una vez que los destinos resuelven, las entradas de outline que apuntan a ellos están cubiertas en leer acciones de bookmarks y anotaciones PDF en Delphi
Hojas con más de 32,768 entradas y la trampa del índice empaquetado
Cuando el código necesita un entero como handle para "entrada N en la hoja M", la codificación tentadora empaqueta la posición de la hoja en los 16 bits altos de un Integer y el offset dentro del array /Names de esa hoja en los 16 bits bajos. Cada par ocupa dos slots del array. El índice de par 32,768, el par número 32,769, arranca por lo tanto en el offset 65,536, que es $10000. Ese bit se arrastra a la mitad alta, y el decodificador lo lee de vuelta como offset 0 de la siguiente hoja
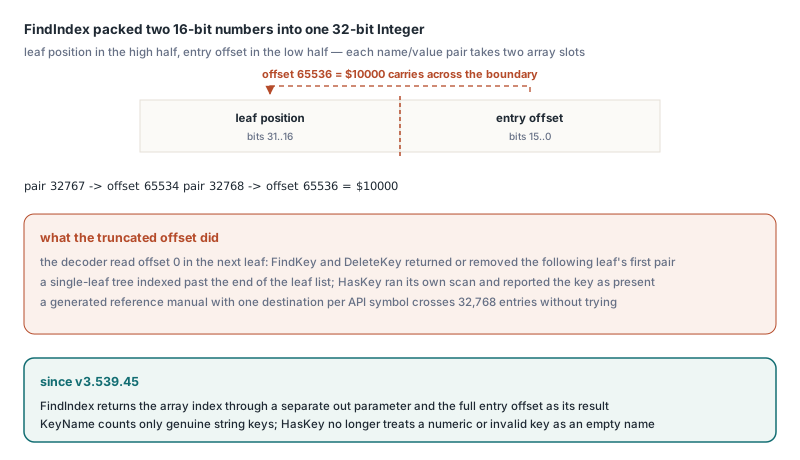
Los síntomas dependen de la forma del árbol. Con una sola hoja no hay siguiente hoja, así que el handle decodificado indexa más allá del final de la lista de hojas. Con varias hojas, una búsqueda o un borrado caen en el primer par de la hoja siguiente, mientras que un barrido plano de claves sigue reportando la clave pedida como presente. Archivos de este tamaño no son exóticos. Una referencia de API generada con un named destination por símbolo cruza 32,768 entradas rápido, y algunos productores escriben todas en una sola hoja plana en vez de balancear el árbol
PDFlibPas guarda la posición de hoja y el offset de entrada en dos enteros de ancho completo, así que ninguno puede derramarse en el otro con cualquier tamaño de hoja. El mismo reader cuenta solo claves de cadena genuinas. Para una hoja como [(Valid) 42 123 456], EmbeddedFileCount reporta 1, la clave numérica 123 jamás se confunde con un nombre vacío, y un índice de 0 o menos devuelve una cadena vacía de GetEmbeddedFileStrProperty en vez del objeto que resulte seguir. El tag 1 de esa función es el nombre del archivo y el tag 2 el subtipo MIME
procedure AuditTrees(const FileName: string);
var
  Lib: TPDFlib;
  I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
      Exit;
    // Number tree de /PageLabels; los archivos sin uno devuelven números de página planos
    for I := 1 to Lib.PageCount do
      WriteLn('Page ', I, ' label: ', Lib.GetPageLabel(I));
    // Name tree de /EmbeddedFiles; índices desde 1, claves no cadena se saltan
    for I := 1 to Lib.EmbeddedFileCount do
      WriteLn('Attachment ', I, ': ', Lib.GetEmbeddedFileStrProperty(I, 1),
        ' (', Lib.GetEmbeddedFileStrProperty(I, 2), ')');  // nombre, subtipo MIME
    // Name tree de /JavaScript: lista nombres de packages, no ejecuta nada
    for I := 1 to Lib.GlobalJavaScriptCount do
      WriteLn('Script package: ', Lib.GlobalJavaScriptPackageName(I));
  finally
    Lib.Free;
  end;
end;
Un archivo de prueba de dos páginas muestra bien la salida esperada. Dele a su root de /PageLabels un array /Kids que liste una hoja dos veces y que además referencie al root mismo, con rangos de romanos en minúscula desde la página 1 y decimales con prefijo A- desde la página 2. La auditoría debería imprimir i y A-1, cada rango aplicado una vez. Escribir page labels en un árbol así tiene sus propias arrugas, cubiertas en arreglar page labels PDF guardados en number trees /Kids; AddPageLabels aplana un root /Kids en una sola hoja /Nums antes de insertar, con la misma enumeración segura ante ciclos
Dónde traza sus líneas el recorrido
El recorrido garantiza terminación, orden estable y respuestas correctas para cualquier árbol cuyas claves reales estén intactas. Lee un árbol dañado tal como está escrito y no intenta reconstruir lo que el autor quiso, y de esa decisión se siguen cinco consecuencias
- La identidad, no el contenido, define a un nodo. Dos diccionarios distintos con entradas idénticas son dos nodos, así que un productor que copie una hoja en vez de referenciarla recibe esas entradas dos veces
- Un par
/Limitsbien formado y ordenado poda aunque esté equivocado. Un rango que miente de forma plausible, digamos[(a) (m)]sobre una hoja que también guarda(q), esconde aq. La única defensa sería ignorar/Limitspor todas partes y barrer cada hoja, y en un árbol de destinos con decenas de miles de entradas eso bota la razón de ser de la entrada. Seguimos podando - La enumeración preserva el orden del archivo.
GetPageLabelrecorre cada rango enumerado y aplica el último cuyo índice de inicio esté en o debajo de la página, así que un productor que escriba rangos desordenados recibe semántica de orden de archivo, y revertir el recorrido le entregaría a la página 200 el estilo de preliminares - La memoria crece con los nodos y entradas distintos. El recorrido agrega una lista y un hash set encima de los objetos parseados
- Las claves duplicadas dentro de una hoja se resuelven de forma determinista: la búsqueda binaria devuelve el par coincidente en el que caiga primero, y el fallback lineal conserva la última coincidencia que barra
Las herramientas de preflight, los archivadores y los visores de documentos leen estos árboles antes de renderizar la primera página, lo que los pone primeros en la fila para lo que llegue en una cola de subidas. Los readers de árboles descritos aquí se distribuyen con PDFlibPas, la PDF Library para Delphi, que compila tanto con Delphi como con Free Pascal