Escape el comentario de un cliente como se debe, de modo que <b>urgent</b> entre a su plantilla HTML como <b>urgent</b>, entréguelo a un renderer que parsea el markup dos veces, y el PDF puede regresar con la palabra urgent en negrita. El escape fue correcto. El renderer lo decodificó una vez por pasada. Cualquier camino de HTML a PDF que parsea, escribe el resultado de vuelta como HTML y parsea otra vez tiene que decodificar entidades exactamente una vez en todo el viaje
La versión help desk de esta historia es ordinaria. Los tickets se exportan a PDF, el comentario del cliente vive dentro de un <p>, y alguien teclea angle brackets en el cuadro de comentario. Un nombre de tag desconocido simplemente se esfuma de la página. Un anchor escapado se convierte en una anotación de link clicable en un documento que su personal cree. El archivo es válido y abre por donde sea; simplemente dice algo distinto a los datos
Donde el texto escapado vuelve a ser markup
El texto escapado se vuelve markup en el punto donde un renderer de dos pasadas escribe texto ya decodificado de vuelta a HTML sin escaparlo otra vez. Lo que el primer parse decodificó es entonces sintaxis viva para el segundo
Las dos pasadas en DrawHTMLText y DrawHTMLTextBox de PDF Library for Delphi (PDFlibPas) existen por una buena razón. El primer parse parte la entrada en tags y palabras. El renderer luego resuelve la cascada del stylesheet: las reglas de los bloques <style> se confrontan contra cada tag, se combinan con los atributos style inline, y la lista completa de elementos se escribe de vuelta como una cadena HTML normalizada con cada tag cargando su estilo final. La pasada de layout parsea esa cadena. El matching de selectores, flexbox, grid y el resto del soporte CSS descrito en flexbox, CSS grid y layout de footnotes en el renderizado HTML de PDFlibPas dependen todos de ese paso intermedio
El peligro vive en cómo salen las palabras. Los tags se pueden escribir de vuelta desde su forma fuente, pero las palabras se sostienen como texto decodificado, porque eso es lo que mide el line breaker. Agregue a la cadena normalizada la palabra que salió de <unsafe> tal cual, y <unsafe> llega al segundo parse como un elemento. Un diseño que decodifica una vez tiene que cerrar también tres fugas menores:
- Si
&no está en el set decodificado,R&Dse imprime literal y no hay forma alguna de poner la grafía<en la página como texto - Si la etapa de dibujo reemplaza
otra vez después de que el parse terminó, una grafía de entidad literal desaparece en el último momento - Si un productor HTML aguas arriba, como un conversor de Markdown o un exportador de datasets, escapa solo los angle brackets, una grafía de entidad dentro de un ejemplo de código o un valor de celda se decodifica a markup
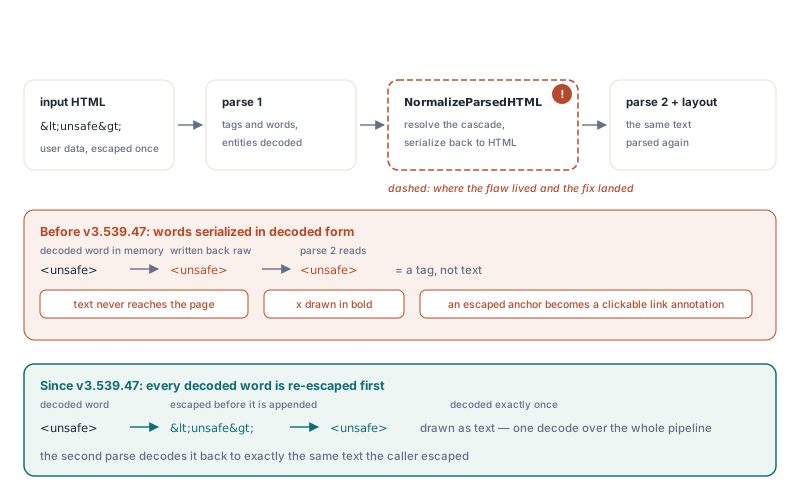
La tabla de abajo lista lo que llega a la página para un puñado de entradas, comparando un renderer de dos pasadas ingenuo con el pipeline de PDFlibPas
| Entrada que llega al renderer | Renderer de dos pasadas ingenuo | PDFlibPas |
|---|---|---|
<unsafe> | Parseado como tag, el texto jamás llega a la página | <unsafe> dibujado como texto |
<b>x</b> | x dibujado en negrita | <b>x</b> dibujado como texto |
R&D | R&D impreso literal | R&D |
&lt; | &lt; impreso literal | < |
Markdown code span que contiene | Un espacio sin ruptura | dibujado como texto |
Valor de celda de dataset < | < | < |
¿Cómo decodifica PDF Library for Delphi cada entidad exactamente una vez?
PDF Library for Delphi decodifica cada entidad exactamente una vez siguiendo tres reglas juntas: el parser decodifica & al final, la etapa de dibujo no decodifica nada, y todo lugar que convierte palabras decodificadas de vuelta a HTML las escapa primero. Quite cualquiera de las tres y una de las filas de la tabla de arriba se voltea a la columna ingenua
Empiece por lo que se decodifica. En contenido de texto el parser reconoce <, >, & y . Las referencias numéricas como A y las entidades nombradas como " se quedan como texto literal. Esa lista corta decide cómo debe escapar su propia entrada, lo que vuelve a aparecer más abajo
El orden dentro del decoder importa aun dentro de una sola pasada. Decodifique & primero y la entrada &lt; se vuelve <, y el reemplazo inmediatamente siguiente la convierte en <: un doble decode sin ningún segundo parse. El camino de palabras de 8 bits por eso reemplaza <, > y primero y & al final, así que el ampersand que produce jamás se vuelve a mirar. El camino de palabras UTF-16 toma otra ruta hacia el mismo resultado — un solo barrido de izquierda a derecha en pasos de dos bytes que reescribe cada coincidencia en el lugar y avanza más allá
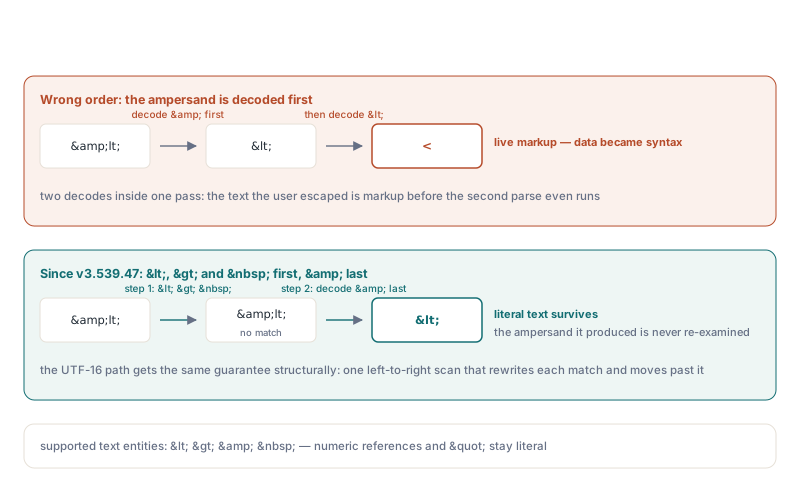
La etapa de dibujo no recibe reemplazo tardío de . Una palabra que llega al line breaker es texto final, y el decodificado vive en el parser y en ningún otro lugar
La regla de frontera pesa más que todas. Cuando el renderer escribe el HTML normalizado, escapa &, < y > en cada palabra decodificada antes de agregarla, y el segundo parse la decodifica de vuelta a los mismos caracteres. Efecto neto sobre ambas pasadas: un decode. La cadena de continuación que DrawHTMLTextBox devuelve sigue la misma regla. Las palabras que no cupieron se escapan antes de entrar al remainder, y el resto del remainder se copia del HTML normalizado, que ya está escapado. Una caja que se lo traga todo devuelve una cadena vacía
¿Por qué el escape UTF-16BE no puede usar un replace a nivel de byte?
El escape UTF-16BE no puede usar un replace a nivel de byte porque los dos bytes de un ampersand pueden cabalgar entre dos caracteres sin relación. La unidad de trabajo segura es el code unit completo de 16 bits
El renderer guarda las palabras Unicode como UTF-16 big-endian empaquetado en cadenas de bytes, byte alto primero, así que un ampersand es 00 26. Tome U+0100 (letra mayúscula latina A con macrón, bytes 01 00) seguida de U+2603 (el muñeco de nieve, bytes 26 03). El buffer se lee 01 00 26 03, y los bytes dos y tres deletrean 00 26. Una búsqueda por bytes de #0'&' encuentra un ampersand que ningún carácter contiene, empalma & en medio de dos code points, y desplaza cada carácter posterior un byte
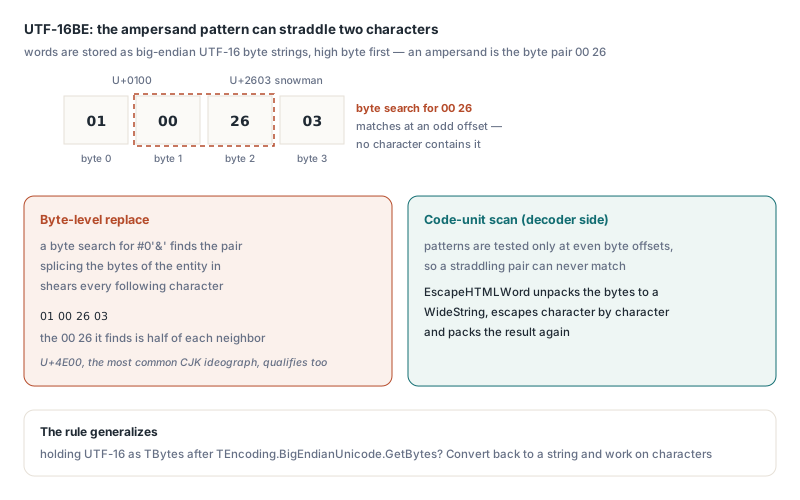
Esto no es una esquina exótica. Cualquier carácter cuyo byte bajo sea cero puede aportar la primera mitad, y U+4E00, uno de los ideogramas CJK más frecuentes, es tal carácter. Los angle brackets quedan expuestos igual: 00 3C y 00 3E aparecen cada vez que tal carácter va seguido de uno del rango U+3C00 a U+3EFF en el CJK Extension A. Así que PDFlibPas escapa las palabras Unicode desempaquetándolas a un WideString, escapando carácter por carácter y volviendo a empaquetar el resultado. El decoder es seguro por la razón espejo: solo prueba patrones en offsets pares
Su propio código puede tropezar con el mismo muro. Una vez que texto UTF-16 vive en TBytes, por ejemplo después de TEncoding.BigEndianUnicode.GetBytes, buscarle patrones de bytes es un bug esperando el par correcto de caracteres. Convierta de vuelta a string y trabaje sobre caracteres
Código Markdown y celdas de dataset: el ampersand va primero
Ambos productores HTML dentro de PDFlibPas, el conversor de Markdown y el exportador de datasets, escapan el ampersand antes de los angle brackets, así que el único decode del renderer restaura el texto original byte a byte
En MarkdownToHTML, los code spans inline y los bloques de código cercados o indentados mapean & a &, < a < y > a >. Los espacios se vuelven y un tab se vuelve cuatro de ellos, lo que mantiene la indentación intacta. La prosa ordinaria escapa solo los angle brackets: el HTML crudo tecleado en prosa no puede inyectar tags, mientras que un autor que escribe deliberadamente & igual recibe un ampersand, como esperan los autores de Markdown. DrawMarkdownText y DrawMarkdownTextBox corren la misma conversión, así que un bloque de código aparece exactamente como se tecleó:
uses
System.SysUtils, PDFlibrary;
procedure RenderCodeSample;
var
Lib: TPDFlib;
Md, Html: WideString;
begin
Md := 'Comparison helper:' + sLineBreak + sLineBreak +
'```' + sLineBreak +
'if (A < B) and (Flags <> 0) then' + sLineBreak +
' WriteLn(''<tag> & R&D'');' + sLineBreak +
'```';
Lib := TPDFlib.Create;
try
// Inspeccione el HTML: dentro de código, '&' se vuelve '&' y '<' se vuelve '<'
Html := Lib.MarkdownToHTML(Md);
Lib.SetOrigin(1); // origen arriba-izquierda, Y crece hacia abajo
Lib.SetMeasurementUnits(0); // puntos
// La página muestra el código exactamente como se tecleó, grafías de entidad incluidas
Lib.DrawMarkdownText(50, 50, 495, Md);
Lib.SaveToFile('code-sample.pdf');
finally
Lib.Free;
end;
end;El exportador de datasets es donde vive el atajo tentador. Si un renderer no decodificara &, escapar el ampersand imprimiría & en cada celda que tenga uno, así que escapar solo los angle brackets parece la opción más amable. Se derrumba con la primera celda cuyo valor tenga de casualidad <, que entonces llega a la página como <. Como el renderer sí decodifica &, el exportador detrás de PDFlibExportDataSet escapa & primero, y un valor como R&D < & aterriza en el PDF textual. El resto de ese exportador está cubierto en exportar un TDataSet a un reporte PDF en Delphi
¿Por qué primero, y no solo en algún punto de la cadena? Escape < primero y obtiene <. Escape & segundo y eso se convierte en &lt;, que un decode único correcto muestra como < y no como <. Una cadena de reemplazos secuencial solo funciona cuando el carácter de escape mismo se maneja antes de cualquier paso que lo introduzca
¿Cómo debe escapar texto no confiable para DrawHTMLTextBox?
Escape el contenido de texto no confiable para PDFlibPas reemplazando &, luego <, luego >, exactamente una vez, y mantenga los datos no confiables fuera de los valores de atributos por completo. El helper de abajo es suyo para agregar; es código RTL plano:
uses
System.SysUtils, PDFlibrary;
// Helper suyo (no parte de la librería): escapa texto no confiable
// para contenido de texto HTML de PDFlibPas. '&' debe reemplazarse primero,
// de lo contrario el ampersand dentro de un '<' recién producido
// se escapa una segunda vez
function EscapeHTMLText(const S: string): string;
begin
Result := StringReplace(S, '&', '&', [rfReplaceAll]);
Result := StringReplace(Result, '<', '<', [rfReplaceAll]);
Result := StringReplace(Result, '>', '>', [rfReplaceAll]);
end;
procedure RenderTicket(const CustomerComment: string);
var
Lib: TPDFlib;
Html: WideString;
begin
Lib := TPDFlib.Create;
try
Lib.SetOrigin(1);
Lib.SetMeasurementUnits(0);
Html := '<p><b>Customer comment</b></p>' +
'<p>' + EscapeHTMLText(CustomerComment) + '</p>';
Lib.DrawHTMLText(50, 50, 495, Html);
Lib.SaveToFile('ticket.pdf');
finally
Lib.Free;
end;
end;Aliméntelo con el comentario Try <a href="https://example.com">this</a> & <b> y la página muestra esos caracteres uno a uno. Bajo un renderer que decodifica dos veces, la misma entrada escapada se vuelve una anotación de link viva. Ese es el paso de glitch cosmético a problema de seguridad: un comentario de ticket jamás debería poder plantar un URL clicable en un PDF que va a su propio personal
Fíjese en lo que el helper deja quieto. Los escapadores de propósito general también vuelven " en " y ' en ', lo que es correcto para un browser y está mal aquí — el decode de texto de PDFlibPas solo conoce las cuatro entidades listadas antes, así que esas dos se imprimirían literal como " y '. No reutilice un escapador de browser para esto. Las comillas son inofensivas en contenido de texto; solo importan dentro de valores de atributos, y el renderer no decodifica entidades en atributos para nada. Para atributos preferimos una regla antes que un escapador más astuto, porque ahí no se verifica ningún esquema de escape de todas formas: mantenga los valores de usuario fuera de href, src y style. Si un destino de link de verdad tiene que salir de input de usuario, valídelo usted contra una allow-list de esquemas y caracteres y rechace cualquier cosa con comillas o angle brackets
Dos hábitos se siguen directo del decode de una sola pasada:
- Siempre escape
&. Sáltelo, y el texto de usuario que contenga<aparece como<— inofensivo, pero no es lo que el usuario tecleó - Escape en un solo punto. El texto que pasa por dos escapadores renderiza
<como la grafía visible<, así que halle el único lugar donde sus datos entran a la cadena HTML y escape ahí
Paginar con LeftOverText sin romper los escapes
DrawHTMLTextBox devuelve el HTML que no cupo, llamado normalmente LeftOverText, y ese remainder conserva las grafías de entidad literales y los angle brackets escapados intactos cuando entra a la siguiente caja. Páselo de vuelta exactamente como lo recibió
const
  BoxLeft = 50;
  BoxTop = 50;
  BoxWidth = 495;    // dimensionado para una página A4 en puntos
  BoxHeight = 740;
  MaxPages = 500;    // su propio tope de seguridad

procedure RenderLongHTML(Lib: TPDFlib; const Html: WideString);
var
  Rest: WideString;
  Pages: Integer;
begin
  Lib.SetOrigin(1);
  Lib.SetMeasurementUnits(0);
  Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Html);
  Pages := 1;
  while (Rest <> '') and (Pages < MaxPages) do
  begin
    Lib.NewPage;
    Inc(Pages);
    // El remainder ya es HTML escapado: jamás lo escape ni lo des-escape
    Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Rest);
  end;
  if Rest <> '' then
    raise Exception.CreateFmt('Content still left after %d pages', [MaxPages]);
end;
Trate el remainder como opaco. Es HTML normalizado con los estilos ya resueltos sobre cada tag, así que pasarlo por su propio escapador vuelve cada < en &lt;, y decodificarlo le entrega tags vivos a la siguiente caja. Empalmar texto fresco de usuario dentro tiene los mismos dos modos de falla. El tope de páginas cuesta una comparación: si algún elemento jamás cabe en la caja, un bucle sin tope no tiene salida natural
Markdown tiene su propia continuación. DrawMarkdownTextBox devuelve un remainder que empieza con un comentario marcador, que le dice a los puntos de entrada de Markdown saltarse la conversión en la siguiente llamada. Devuélvaselo a DrawMarkdownTextBox o DrawMarkdownText, de la misma forma en que alimentaría LeftOverText de vuelta a DrawHTMLTextBox. Un remainder de Markdown le pertenece a los puntos de entrada de Markdown, así que déjelo de ese lado y enrute solo los remainders de DrawHTMLTextBox por las llamadas HTML
La forma detrás de todo esto — parsear, escribir de vuelta a la misma sintaxis, parsear otra vez — también aparece en template engines, sanitizadores HTML y cadenas de Markdown a HTML a PDF, y la falla llega en dos direcciones. Demasiado poco re-encoding convierte datos en sintaxis. Demasiado encoding, o un decoder que corre dos veces, le muestra grafías de entidad al lector o se las come. Parchar una sola dirección tiende a romper la otra, que es por lo que el renderer de PDFlibPas trata el decode de &, decodificarlo al final, ningún decode tardío y re-escape en cada frontera como un solo paquete. La dirección de exportación sigue la misma regla en exportación semántica de PDF a Markdown y DOCX desde Delphi, donde cada carácter literal se escapa para la sintaxis objetivo exactamente una vez
El dibujo HTML y Markdown, el exportador de reportes de datasets y el resto del engine de layout vienen como fuente Pascal nativa en PDF Library for Delphi, tanto para Delphi como para Free Pascal. Las ediciones, la cobertura de plataformas y la descarga de prueba están listadas en la página del producto PDF Library for Delphi