Medio punto lo decide. En un reporte con texto de cuerpo de 10 puntos, un título de sección compuesto en negrita de 11 puntos se convierte a Markdown como un párrafo corriente, mientras que una leyenda de 12 puntos en la portada, en peso regular, vuelve como ### Quarterly figures. Eso parece al revés hasta que uno recuerda qué guarda realmente una página PDF: glifos en coordenadas, un nombre de fuente y un tamaño. Nada en la página dice "heading". Cada encabezado que un conversor emite es una suposición construida de esos tres datos, y la suposición tiene umbrales
Por qué una página PDF no tiene párrafos que exportar
Una página PDF contiene operadores de despliegue de texto, no párrafos. Cada operador coloca una corrida de glifos en una posición, en el orden en que la aplicación productora los emitió, e ISO 32000-1 no obliga al productor a decir que dos corridas pertenecen a la misma oración, y mucho menos al mismo elemento de lista o celda de tabla. El formato describe una página impresa con exactitud, y lo consigue tirando la estructura que produjo la página
Así que cada conversor reconstruye lo que el generador descartó. Las líneas vienen de líneas base compartidas y del espaciado vertical. Los saltos de párrafo vienen de cambios de espaciado e indentación. Una lista es una racha de bloques que empiezan con un carácter de viñeta o un patrón numérico. Una tabla es una grilla de bloques de texto cuyos bordes se alinean a lo largo de filas y columnas. Sobre documentos que siguen hábitos tipográficos corrientes esto funciona bien; sobre un folleto maquetado por efecto visual tiene muy poco de dónde agarrarse
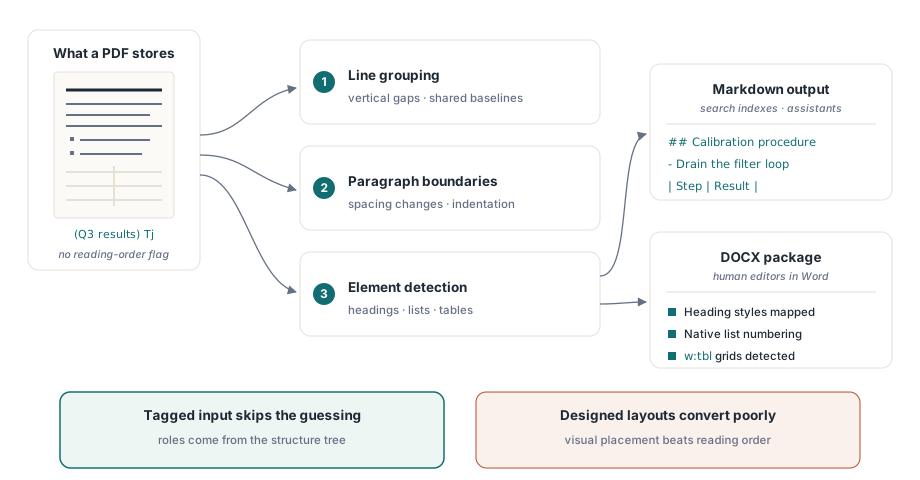
Los PDF etiquetados son la gran excepción. Cuando un documento trae un árbol de estructura, los roles de párrafo, encabezado, lista y tabla quedan registrados por el productor en vez de adivinados después, razón por la cual el trabajo descrito en estructura de accesibilidad de PDF etiquetado también rinde en calidad de conversión. Si usted controla al productor, etiquetar la salida es lo más barato que puede hacer por quien la convierta después
De dónde salen los niveles de encabezado
PDF Library for Delphi decide los niveles de encabezado de dos maneras, según la entrada. En una página etiquetada, un bloque cuyo rol de estructura es H1 a H6 conserva ese nivel, y H o Title se vuelve nivel 1. En una página sin etiquetar, la exportación recurre al tamaño de fuente relativo al texto de cuerpo de la página, y solo considera párrafos de una sola línea de 200 caracteres o menos
La regla de tamaño necesita una razón y una brecha absoluta, medidas contra el tamaño de cuerpo dominante:
| Salida Markdown | Texto más grande de la línea | Con cuerpo de 10 pt |
|---|---|---|
# | al menos 1.6 veces el tamaño del cuerpo y al menos 4 pt más grande | 16 pt en adelante |
## | al menos 1.35 veces y al menos 2.5 pt más grande | 13.5 pt en adelante |
### | al menos 1.15 veces y al menos 1.25 pt más grande | 11.5 pt en adelante |
Eso explica el ejemplo inicial. Un título en negrita de 11 puntos sobre texto de 10 puntos falla el tercer escalón por medio punto, y el peso no juega ningún papel en el nivel. La leyenda de la portada, a 12 puntos, lo pasa. La brecha absoluta existe para cuerpos pequeños: sobre texto de 6 puntos, tamaño de nota al pie, una razón por sí sola promovería una línea de 7 puntos a encabezado, y el requisito extra de 1.25 pt lo detiene
Creemos que este es el intercambio correcto. La negrita es demasiado común dentro del texto de cuerpo (frases de entrada, términos definidos, totales en una línea de resumen) para ser una señal de encabezado confiable por sí sola, y un conversor que promueve cada línea en negrita produce Markdown con docenas de secciones espurias. Perder unos cuantos encabezados solo-en-negrita cuesta menos. Si sus documentos dependen de títulos en negrita al tamaño del cuerpo, la corrección confiable es aguas arriba: etiquételos, o suba el tamaño del título un punto y medio
La negrita y la itálica en la salida se leen del nombre de la fuente. Una corrida cuyo nombre de fuente contiene Bold, Black o Demi se vuelve **bold**; Italic o Oblique se vuelve *italic*. Los productores que hacen subset de fuentes bajo nombres opacos como F3, o que simulan negrita trazando glifos regulares, no le dan nada que leer a la exportación, y ese texto llega sin estilo
Exportación a Markdown para pipelines de recuperación
La ruta de Markdown es la que toca usar cuando el destino es un pipeline de texto: un sitio de documentación, un índice de búsqueda, un corpus fragmentado para un asistente. ExportPageMarkdown devuelve una página como WideString, ExportDocumentMarkdown devuelve un rango de páginas, y SaveMarkdownToFile y SaveMarkdownToStream escriben el mismo texto como UTF-8 sin marca de orden de bytes. La ausencia de BOM es deliberada; una cantidad de generadores de sitios estáticos y herramientas de diff la tratan como contenido
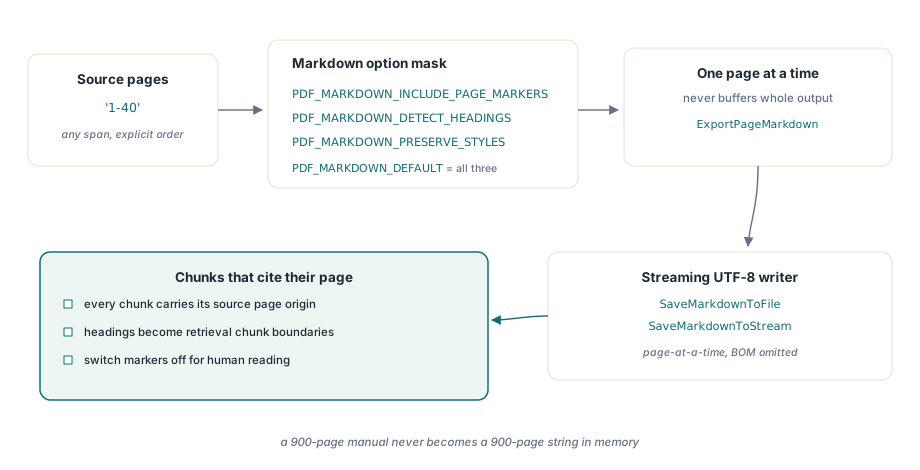
Las opciones son una máscara de bits: PDF_MARKDOWN_INCLUDE_PAGE_MARKERS (1), PDF_MARKDOWN_DETECT_HEADINGS (2) y PDF_MARKDOWN_PRESERVE_STYLES (4), con PDF_MARKDOWN_DEFAULT combinando las tres. Un segundo ajuste, a nivel de documento, controla el análisis mismo: SetStructuredTextOptions toma los flags PDF_STRUCTURED_*, y su valor por omisión detecta columnas, detecta encabezados y pies de página corrientes, y une tablas que continúan a través de un salto de página
uses
  SysUtils, PDFlibrary;

var
  Pdf: TPDFlib;
  Exported: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    if Pdf.LoadFromFile('handbook.pdf', '') = 0 then
      raise Exception.Create('Cannot open handbook.pdf');

    // La detección de encabezados y pies de página corrientes está activa por omisión;
    // agregar EXCLUDE_FURNITURE también los quita de la salida
    Pdf.SetStructuredTextOptions(PDF_STRUCTURED_ADVANCED_DEFAULT or
      PDF_STRUCTURED_EXCLUDE_FURNITURE);

    // Marcadores de página y encabezados, pero sin énfasis ** y *
    Exported := Pdf.SaveMarkdownToFile('1-40',
      PDF_MARKDOWN_INCLUDE_PAGE_MARKERS or PDF_MARKDOWN_DETECT_HEADINGS,
      'handbook.md');
    if Exported = 0 then
      raise Exception.CreateFmt('Markdown export failed, error %d',
        [Pdf.LastErrorCode]);

    // JSON con una entrada por página: readingSource es tagged, mixed,
    // geometric o geometric-columns
    Writeln(Pdf.GetLastStructuredTextDiagnostics);
  finally
    Pdf.Free;
  end;
end;
Para un corpus de recuperación nosotros quitamos PDF_MARKDOWN_PRESERVE_STYLES. El énfasis se aplica corrida por corrida, así que una frase en negrita compuesta por varias corridas sale como **Net** **revenue**, que se lee bien en pantalla y agrega ruido a cada embedding. Los marcadores de página son el caso contrario: consérvelos. Cada marcador es un comentario HTML, <!-- page: 12 -->, invisible cuando el Markdown se renderiza y trivial de parsear cuando usted divide fragmentos, así que un pasaje recuperado puede citar la página de la que vino. Cuando una tabla continúa desde la página anterior, el marcador de la página nueva se omite para que la tabla de tuberías quede entera
Dos comportamientos atrapan a quien exporta página por página en un bucle. Primero, los encabezados corrientes se reconocen por repetición: un párrafo en el 12 por ciento superior o inferior de la página cuenta como adorno cuando texto coincidente se sienta en la misma banda de otra página de la misma exportación, con los dígitos normalizados para que "Página 3 de 40" coincida con "Página 4 de 40". Una llamada de una sola página no tiene otra página contra la cual comparar, así que un encabezado corriente sin etiquetas se queda en el texto. Segundo, las imágenes en Markdown se incrustan inline como URIs data:, lo que mantiene el archivo autosuficiente y significa que una página con una fotografía grande puede agregar cientos de kilobytes de base64 al archivo. Si su fragmentador tiene un límite de tamaño, quite las líneas que empiezan con 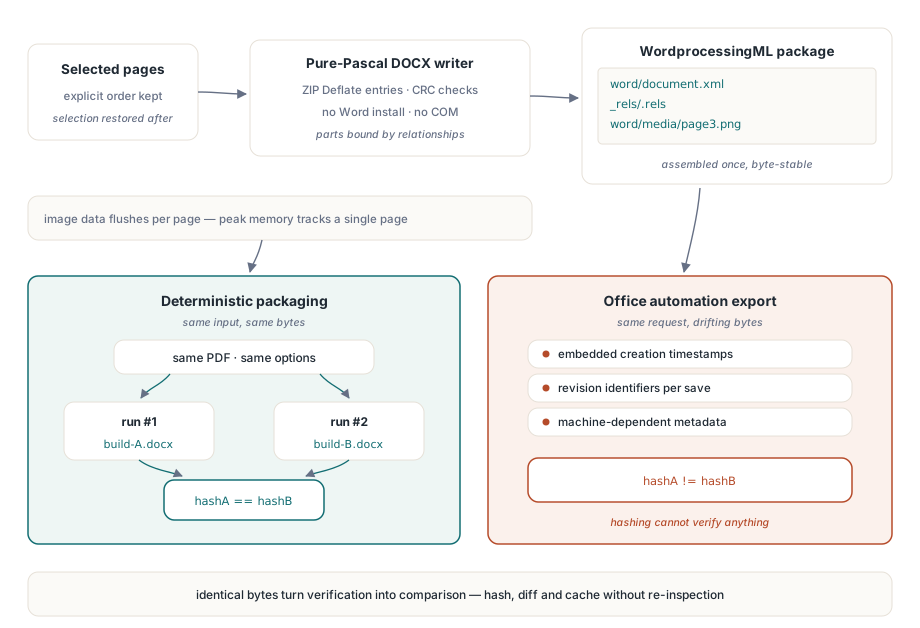
Dos decisiones hacen que eso se mantenga. Cada entrada ZIP lleva la misma fecha DOS fija, 1 de enero de 1980, en vez de la hora de la ejecución, y la parte de propiedades del núcleo no tiene fechas de creación ni modificación. Cada entrada se comprime con Deflate crudo solo cuando eso realmente la hace más pequeña, así que los medios PNG, que ya vienen comprimidos, se guardan tal cual. Usted puede confirmar el primer punto con unzip -v handbook.docx: cada fila muestra la misma fecha
La automatización de Office no puede darle eso. Guardar vía Word estampa la hora actual en los metadatos del paquete y en los encabezados ZIP, así que el mismo documento convertido dos veces difiere de formas que arruinan un hash. El mismo razonamiento está detrás de los identificadores de archivo estables de IDs de PDF deterministas para builds reproducibles: una vez que la salida es reproducible, la verificación se convierte en una comparación
Qué entradas convierten bien, y cuáles nunca lo harán
La calidad de conversión varía más con la entrada que con el conversor, y vale decírselo a sus usuarios de antemano. Los PDF etiquetados y los documentos comerciales generados limpiamente (facturas, reportes, contratos) convierten bien: los encabezados aterrizan como encabezados, las tablas sobreviven, las listas se renumeran en Word. Los diseños académicos de dos columnas salen en el orden de lectura correcto cuando la geometría de columnas es regular, y los diagnósticos reportan geometric-columns para esas páginas. Las tablas que se parten entre páginas se reensamblan por inferencia, así que revíselas por muestreo. El material de marketing fuertemente diseñado, donde el texto se coloca por efecto y no en orden de lectura, le da a cualquier conversor poco que rescatar; espere retocar el resultado a mano
Los documentos escaneados son un caso aparte. Una página que es una sola imagen grande no contiene objetos de texto, así que no hay nada que exportar hasta que exista una capa de texto, y correr OCR es un prerrequisito para ambos formatos. Antes de comprometerse con un lote grande, tome una muestra de una docena de archivos representativos y enumere lo que contienen sus páginas, como se describe en búsqueda de texto y enumeración de elementos de página; una página con imágenes y sin corridas de texto le dice más en un segundo que leer la salida convertida
Escoja el formato por lo que viene después. Markdown sirve para máquinas y pipelines: los encabezados se vuelven límites de fragmento, las tablas siguen legibles como tablas de tuberías, y los marcadores de página dan a cada fragmento una cita. DOCX sirve para gente que necesita cambiar el documento, porque lo que quiere de vuelta es un archivo editable en Word, con listas y tablas reales, y el texto solo no le da eso
PDF Library for Delphi viene para Delphi, C++Builder y Lazarus, con ediciones DLL y ActiveX que exponen las mismas llamadas de exportación Markdown y DOCX a hosts de C#, C++ y scripting. La referencia de cada flag de opción y una descarga de prueba están en la página del producto PDF Library for Delphi