Το HotXLS Delphi Component συγκρίνει δύο τιμές κειμένου όπως η Excel 16 από το v2.384.67: χωρίς διάκριση πεζών, στη σειρά «word sort» του Windows user locale, που είναι ό,τι επιστρέφει η CompareStringW με τη σημαία NORM_IGNORECASE. Οι παύλες και οι απόστροφοι προσπερνιούνται στο πρώτο πέρασμα και σπάνε μόνο ισοπαλίες, οπότε ο ="a-b">"ab" είναι TRUE, ενώ η υπόλοιπη στίξη ταξινομείται πριν από ψηφία και γράμματα, οπότε και ο ="a~b"<"ab" είναι TRUE. Η ίδια σειρά κινεί πλέον τους τελεστές σύγκρισης, τα κριτήρια > / <, την ταξινόμηση range και το VLOOKUP
Κανείς δεν υποβάλλει bug με τίτλο «ασυμφωνία collation». Οι αναφορές λένε ότι ο COUNTIF(A:A,">M") μετράει δύο σειρές περισσότερες στον server παρά στην Excel, ότι μια τιμοκατάλογος ταξινομημένη από το reporting service βάζει το X-100 εκεί που η Excel δεν θα το έβαζε, ή ότι ο VLOOKUP("ABC",...) επιστρέφει #N/A αν και η στήλη φανερά περιέχει abc. Και τα τρία προέρχονται από την ίδια ερώτηση: όταν και οι δύο τελεστέοι είναι κείμενο, ποιος είναι μικρότερος; Η Excel έχει ακριβή απάντηση, δεν είναι αυτή που δίνει ο περισσότερος κώδικας Delphi, και πριν το v2.384.67 το HotXLS έδινε τρεις διαφορετικές απαντήσεις ανάλογα με ποια διαδρομή κώδικα ρωτούσε κανείς
Ποιον κανόνα χρησιμοποιεί η Excel για να συγκρίνει δύο strings κειμένου;
Η Excel συγκρίνει κείμενο με το word sort του user locale, αγνοώντας πεζά-κεφαλαία. Το word sort είναι το προεπιλεγμένο collation των συναρτήσεων σύγκρισης Windows NLS: τα γράμματα συγκρίνονται με τη γλωσσική τους σειρά αντί για τα code points τους, οι τονισμένοι χαρακτήρες κάθονται δίπλα στο βασικό τους γράμμα, και δύο χαρακτήρες παίρνουν ειδική μεταχείριση. Η παύλα - και ο απόστροφος ' αγνοούνται στο πρώτο πέρασμα, οπότε το co-op και το coop προσγειώνονται το ένα δίπλα στο άλλο, και μόνο όταν το υπόλοιπο των strings ισοπαλήσει η παρουσία τους αποφασίζει τη σειρά. Κάθε άλλο σημείο στίξης μετράει και ταξινομείται πριν από τα ψηφία, και τα ψηφία ταξινομούνται πριν από τα γράμματα
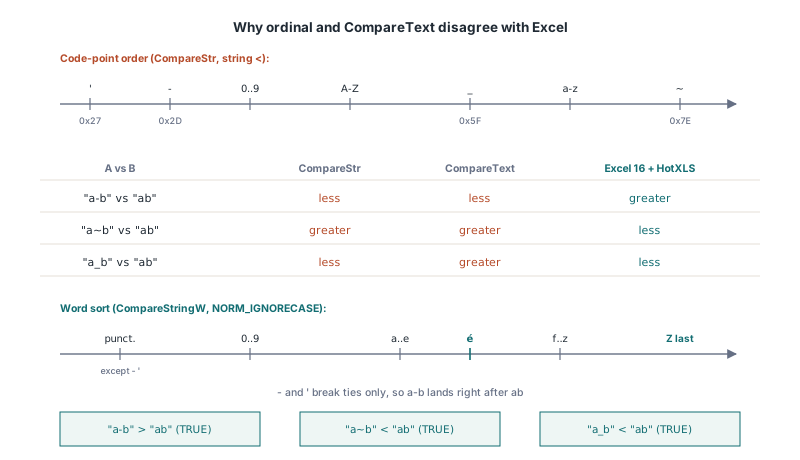
Ο πίνακας δείχνει τι σημαίνει αυτό στην πράξη, δίπλα στις δύο συγκρίσεις που πιο πιθανόν θα φτάσει να χρησιμοποιήσει ένας developer Delphi. Η στήλη Excel κρατά τις ετυμηγορίες που επέστρεψε η Excel 16 για τον IF(A<B,...), που το HotXLS αναπαράγει από το v2.384.67
| A vs B | Excel 16 / HotXLS | CompareStr (ordinal) | CompareText |
|---|---|---|---|
"a-b" vs "ab" | μεγαλύτερο | μικρότερο | μικρότερο |
"a'b" vs "ab" | μεγαλύτερο | μικρότερο | μικρότερο |
"a~b" vs "ab" | μικρότερο | μεγαλύτερο | μεγαλύτερο |
"a_b" vs "ab" | μικρότερο | μικρότερο | μεγαλύτερο |
"ab" vs "AB" | ίσον | μεγαλύτερο | ίσον |
"é" vs "f" | μικρότερο | μεγαλύτερο | μεγαλύτερο |
"Z" vs "f" | μεγαλύτερο | μικρότερο | μεγαλύτερο |
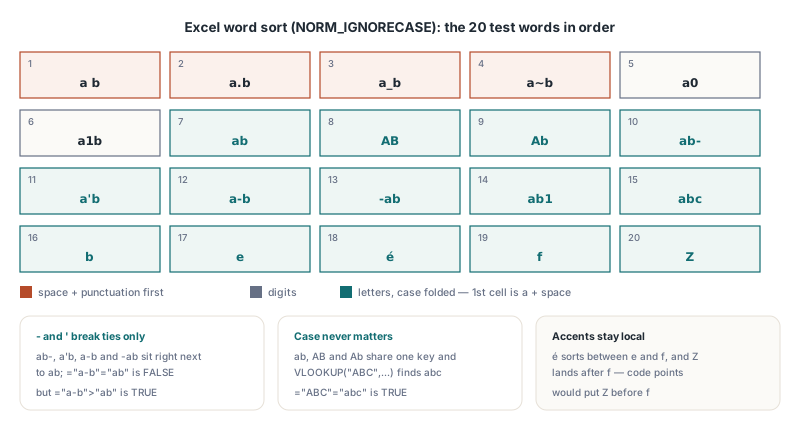
Δύο συνέπειες ξεφεύγουν εύκολα. Πρώτον, ο ρόλος της παύλας ως σπάσιμο ισοπαλίας σημαίνει ότι ο ="a-b"="ab" είναι FALSE: τα strings είναι κοντινοί γείτονες στην ταξινόμηση, μα όχι ίσα. Δεύτερον, η ισότητα αγνοεί τελείως τα πεζά-κεφαλαία, οπότε το ab, το AB και το Ab είναι το ίδιο κλειδί όσο αφορά οποιαδήποτε σύγκριση. Ταξινόμηση 20 δοκιμαστικών λέξεων με το Range.Sort της Excel δίνει a b, a.b, a_b, a~b, a0, a1b, ab / AB / Ab, ab-, a'b, a-b, -ab, ab1, abc, b, e, é, f, Z· μέσα στην ομάδα ab, τη θέση αποφασίζει ο προσπερασμένος χαρακτήρας
Πώς καρφιτσώθηκε η σειρά κειμένου της Excel;
Η σειρά κειμένου της Excel ταυτοποιήθηκε με μέτρηση, όχι με τεκμηρίωση, γιατί η τεκμηρίωση της Excel δεν ονομάζει το collation. Το test παρήγαγε 4.000 τυχαία ζεύγη strings από στίξη ASCII, ψηφία, και τις δύο υποθέσεις γραμμάτων, κενά, é, ß, ä, κινεζικούς χαρακτήρες, full-width μορφές και το non-breaking space, με μήκη από 0 έως 4 και τα μισά ζεύγη χτισμένα ως σχεδόν ταυτόσημα μεταξύ τους. Η Excel 16 αποτίμησε IF(A<B,-1,IF(A=B,0,1)) για κάθε ζεύγος, και οι ετυμηγορίες σταυρώθηκαν με το Windows comparison API με διαφορετικά σύνολα σημαιών
- Μόνο
NORM_IGNORECASE(προεπιλεγμένο word sort, user locale): καμία γνήσια ασυμφωνία. Οι μόνες 7 διαφορές ήταν κελιά που όλο τους το περιεχόμενο ήταν', που η Excel τα καταναλώνει ως χαρακτήρα προθέματος κειμένου, οπότε ήταν τεχνάσματα δειγματοληψίας και όχι διαφορές collation NORM_IGNORECASEμεSORT_STRINGSORT: 41 ασυμφωνίες. Το string sort μεταχειρίζεται την παύλα και τον απόστροφο ως συνηθισμένα σύμβολα, που είναι ακριβώς η συμπεριφορά που η Excel δεν έχει- Προσθήκη
NORM_IGNOREWIDTH: λάθος με άλλον τρόπο, γιατί κάνει τις full-width και half-width μορφές του ίδιου γράμματος να συγκρίνονται ίσες, και η Excel τις κρατά χώρια
Δεύτερος, χειροπιαστός έλεγχος σύγκρινε και τα 190 ζεύγη που βγήκαν από 20 δυστροπικές λέξεις και το αποτέλεσμα του Range.Sort της Excel στην ίδια στήλη. Και τα δύο συμφώνησαν με σκέτο word sort NORM_IGNORECASE, και εκείνες οι 190 ετυμηγορίες συν η ταξινομημένη σειρά είναι πλέον μέρος της regression suite του HotXLS, που τρέχει και μέσω της classic engine TXLSWorkbook και μέσω της εγγενώς XLSX engine TXLSXWorkbook
Γιατί το CompareText και η ordinal σύγκριση τη λένε λάθος;
Το CompareText και η ordinal σύγκριση λένε λάθος τη σειρά της Excel επειδή συγκρίνουν UTF-16 code units, και η σειρά code points βάζει τη στίξη σε τυχαίες θέσεις ως προς τα γράμματα. Η παύλα είναι U+002D και ο απόστροφος U+0027, κάτω από κάθε γράμμα, οπότε μια ordinal σύγκριση κρίνει το "a-b" μικρότερο του "ab" αντί να μεταχειρίζεται την παύλα ως σπάσιμο ισοπαλίας. Η tilde U+007E κάθεται πάνω από κάθε γράμμα, οπότε το "a~b" βγαίνει μεγαλύτερο, το αντίθετο της Excel. Το CompareText στο Delphi RTL αναδιπλώνει μόνο a..z σε κεφαλαία και μετά συγκρίνει code units, που προσθέτει δεύτερη παραμόρφωση: η underscore U+005F βρίσκεται ανάμεσα στα κεφαλαία και τα πεζά γράμματα, οπότε η αναδίπλωση σε κεφαλαία μετακινεί το "a_b" από κάτω από το "ab" πάνω από αυτό. Καμία από τις δύο συναρτήσεις δεν ξέρει ότι το é ανήκει ανάμεσα στο e και το f
Τα συνήθη εργαλεία Delphi πέφτουν και από τις δύο πλευρές της γραμμής:
- Το
CompareStr, ο τελεστής<για strings και τοTComparer<string>.Default(που καλεί τοCompareStr) είναι ordinal και ευαίσθητα σε πεζά-κεφαλαία, οπότε τοTArray.Sort<string>χωρίς comparer βάζει τοZπριν από τοf - Το
CompareTextκαι τοSameTextείναι ordinal μετά από αναδίπλωση πεζών-κεφαλαίων μόνο ASCII - Τα
AnsiCompareTextκαιWideCompareTextστο Delphi RTL στα Windows καλούνCompareString(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...), την ίδια κλήση που ταιριάζει με την Excel. Μια sortedTStringListμε τις προεπιλογές της (UseLocaleTrue,CaseSensitiveFalse) περνά απόAnsiCompareTextκαι άρα συμφωνεί κι αυτή με την Excel - Σε στόχους POSIX το Delphi RTL δρομολογεί το
AnsiCompareTextμέσω ICU collator, διαφορετικού αλγορίθμου με άλλους κανόνες στίξης, και τοAnsiCompareTextτου Free Pascal στα Windows καλείCompareStringAμετά από μετατροπή στην ANSI code page, που χάνει κάθε χαρακτήρα που εκείνη η σελίδα δεν αναπαριστά
Άρα οι RTL συναρτήσεις με επίγνωση locale είναι σωστές στα Windows κατά υλοποίηση, όχι κατά συμβόλαιο, και κώδικας που χρειάζεται τη σειρά της Excel κερδίζει κάνοντας την κλήση API ρητά. Το HotXLS είχε το ίδιο κοκτέιλ εσωτερικά. Οι τελεστές σύγκρισης έκαναν κεφαλαία και τα δύο strings και συγκρίνηκαν code points, οι κλάδοι > / < των συναρτήσεων κριτηρίων χρησιμοποιούσαν τη Variant σύγκριση του Delphi ευαίσθητη σε πεζά-κεφαλαία, και το VLOOKUP / HLOOKUP ταίριαζε κείμενο με εκείνη τη Variant σύγκριση επίσης, γι’ αυτό το VLOOKUP("ABC",A1:A20,1,FALSE) δεν μπορούσε να βρει abc. Η ταξινόμηση range χρησιμοποιούσε ήδη WideCompareText. Τρεις διαδρομές, τρεις σειρές
Τι άλλαξε στο HotXLS v2.384.67;
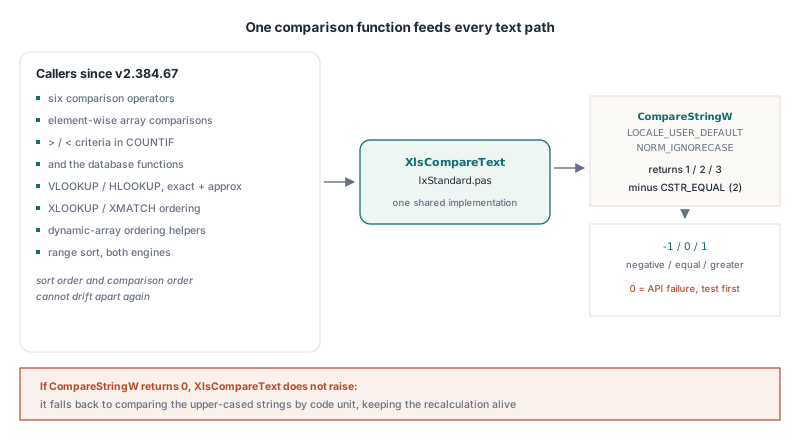
Από το v2.384.67 οι συγκρίσεις κείμενο-με-κείμενο στις διαδρομές υπολογισμού και ταξινόμησης του HotXLS περνάνε από μία συνάρτηση, το XlsCompareText στο lxStandard.pas, που καλεί CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...) και αφαιρεί CSTR_EQUAL. Οι καλούντες είναι οι έξι τελεστές σύγκρισης, οι συγκρίσεις στοιχείο προς στοιχείο σε array τύπους, οι κλάδοι >, <, >= και <= των κριτηρίων τύπου COUNTIF και των database συναρτήσεων, το VLOOKUP και το HLOOKUP (ακριβές και κατά προσέγγιση), οι βοηθοί ταξινόμησης πίσω από τις συναρτήσεις dynamic-array και το XLOOKUP / XMATCH, και η ταξινόμηση range και των δύο engines. Το να περνά η ταξινόμηση range από την ίδια συνάρτηση εγγυάται ότι η σειρά ταξινόμησης και η σειρά σύγκρισης δεν μπορούν να ξαναχωρίσουν, που μετράει επειδή το κατά προσέγγιση VLOOKUP σε κείμενο βγάζει νόημα μόνο όταν η στήλη ταξινομήθηκε στη σειρά που συγκρίνει το lookup
uses
  System.Variants, lxHandleX;

var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Sheets.Add('Data');  // Το Calculate αποτιμάει πάνω στο active sheet
    Writeln(VarToStr(Book.Calculate('="a-b">"ab"')));   // True: η παύλα σπάει μόνο ισοπαλίες
    Writeln(VarToStr(Book.Calculate('="a-b"="ab"')));   // False: η ισοπαλία σπάστηκε, δεν είναι ίσα
    Writeln(VarToStr(Book.Calculate('="a~b"<"ab"')));   // True: πρώτα η στίξη
    Writeln(VarToStr(Book.Calculate('="ABC"="abc"')));  // True: τα πεζά-κεφαλαία αγνοούνται
  finally
    Book.Free;
  end;
end;
Οι συγκρίσεις μεταξύ διαφορετικών τύπων είναι ξεχωριστός κανόνας και δεν άλλαξαν: κάθε αριθμός είναι κάτω από κάθε τιμή κειμένου και κάθε τιμή κειμένου κάτω από κάθε boolean, όπως περιγράφεται στο άρθρο για comparison chains, κενούς τελεστέους και SUMIF. Το word sort ισχύει μόνο όταν και οι δύο τελεστέοι είναι κείμενο. Το wildcard matching είναι επίσης ξεχωριστό: ένα κριτήριο όπως "a*" ή "=ab" είναι δοκιμή προτύπου ή ισότητας, που καλύπτεται στον οδηγό για wildcards της Excel σε COUNTIF, MATCH και DSUM, και το collation που συζητάμε εδώ αποφασίζει μόνο τους τελεστές σειράς
Το επόμενο παράδειγμα φορτώνει τις 20 δοκιμαστικές λέξεις σε στήλη, την ταξινομεί με TXLSXWorksheet.SortRange, και τσεκάρει ένα πλήθος κριτηρίου κι ένα lookup. Τα πλήθη είναι όσα επέστρεψε η Excel 16 για την ίδια στήλη
const
  Words: array [0..19] of string = ('ab', 'a-b', 'a~b', 'a_b', 'AB', 'a b',
    'ab1', 'ab-', '-ab', 'abc', 'a''b', 'Ab', 'b', 'a.b', 'a1b', 'a0',
    #$00E9, 'e', 'f', 'Z');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Words');
    for i := 0 to High(Words) do
      Sheet.Cells[i + 1, 1].Value := WideString(Words[i]);

    // Excel 16 στην ίδια στήλη: 11, 11, 14
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">ab")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,"<a-b")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">=AB")')));

    // Ήταν #N/A πριν το v2.384.67: το lookup σύγκρινε με διάκριση πεζών
    Sheet.Cells[1, 3].Formula := '=VLOOKUP("ABC",A1:A20,1,FALSE)';
    Book.Recalculate;
    Writeln(VarToStr(Sheet.Cells[1, 3].Value));                // abc

    // Μία στήλη κλειδιού, αύξουσα: a b, a.b, a_b, a~b, a0, a1b, ab, AB, Ab, ...
    Sheet.SortRange(1, 1, 20, 1, [1], [False]);
    for i := 1 to 20 do
      Writeln(VarToStr(Sheet.Cells[i, 1].Value));
  finally
    Book.Free;
  end;
end;
Το TXLSXWorksheet.SortRange χρησιμοποιεί σταθερό merge sort, οπότε τα ab, AB και Ab, που συγκρίνονται ίσα, κρατούν τη σχετική σειρά που είχαν πριν την ταξινόμηση. Τα κενά κελιά πάνε στο τέλος και προς τις δύο κατευθύνσεις, όπως στην Excel
Πώς ταιριάζω τη σειρά ταξινόμησης της Excel στον δικό μου κώδικα Delphi;
Για να ταιριάξετε τη σειρά κειμένου της Excel στον δικό σας κώδικα Delphi, καλέστε CompareStringW με LOCALE_USER_DEFAULT και NORM_IGNORECASE, και μην προσθέσετε SORT_STRINGSORT ή NORM_IGNOREWIDTH. Η επιστρεφόμενη τιμή δεν είναι πρόσημο αποτέλεσμα σύγκρισης: το API επιστρέφει CSTR_LESS_THAN (1), CSTR_EQUAL (2) ή CSTR_GREATER_THAN (3), και 0 όταν η κλήση αποτύχει. Αφαιρέστε 2 για να πάρετε τη συνήθη σύμβαση αρνητικό / μηδέν / θετικό, και τσεκάρετε πρώτα για 0, επειδή αστοχία που θα ληφθεί ως αποτέλεσμα γίνεται -2, ένα σιωπηλό «μικρότερο»
uses
  Winapi.Windows, System.SysUtils, System.Generics.Defaults,
  System.Generics.Collections;

// Η σειρά κειμένου της Excel: word sort user locale, χωρίς διάκριση πεζών
function ExcelCompareText(const A, B: string): Integer;
var
  R: Integer;
begin
  R := CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE,
    PWideChar(A), Length(A), PWideChar(B), Length(B));
  if R = 0 then
    RaiseLastOSError;          // το 0 είναι αστοχία, όχι αποτέλεσμα σύγκρισης
  Result := R - CSTR_EQUAL;    // τα 1/2/3 γίνονται -1/0/1
end;

var
  Keys: TArray<string>;
begin
  Keys := ['abc', 'a-b', 'AB', 'a~b', '-ab', 'ab'];
  TArray.Sort<string>(Keys, TComparer<string>.Construct(
    function(const L, R: string): Integer
    begin
      Result := ExcelCompareText(L, R);
    end));
  // a~b, ab / AB (ίσα, είτε σειρά), a-b, -ab, abc
end;
Το TArray.Sort δεν είναι σταθερό, οπότε κλειδιά που συγκρίνονται ίσα, όπως τα ab και AB, μπορεί να βγουν με οποιαδήποτε σειρά· αν μετράει η αρχική σειρά ίσων κλειδιών, ταξινομήστε array ευρετηρίων με την αρχική θέση ως δευτερεύον κλειδί. Το αντίστροφο case επίσης εμφανίζεται: καμιά φορά μια στήλη δεν πρέπει να ακολουθεί τη σειρά της Excel, για παράδειγμα κωδικοί εξαρτημάτων όπου X-100 και X100 είναι διακριτοί κωδικοί και πρέπει να ταξινομούνται κατά code point. Το TXLSXWorksheet.SortRange έχει overload που παίρνει TXLSSortCompareEvent, μια μέθοδο με υπογραφή function(const Left, Right: Variant): Integer of object, και τη χρησιμοποιεί αντί για την ενσωματωμένη σύγκριση
uses
  System.SysUtils, System.Variants, lxStandard, lxHandleX;

type
  TPartNumberOrder = class
    function Compare(const Left, Right: Variant): Integer;
  end;

function TPartNumberOrder.Compare(const Left, Right: Variant): Integer;
begin
  // Ένας custom comparer δέχεται επίσης κενά κελιά (ως Null): τοποθετήστε τα μόνοι σας
  if VarIsNull(Left) or VarIsNull(Right) then
    Exit(Ord(VarIsNull(Left)) - Ord(VarIsNull(Right)));
  Result := CompareStr(VarToStr(Left), VarToStr(Right));   // ordinal, με διάκριση πεζών
end;

var
  Sheet: TXLSXWorksheet;   // γεμάτο sheet, σειρές 2..501, στήλες A..D
  Order: TPartNumberOrder;
begin
  // ...
  Order := TPartNumberOrder.Create;
  try
    // κλειδωμένο στη στήλη A, αύξουσα
    Sheet.SortRange(2, 1, 501, 4, [1], [False], xlsSortByRows,
      xlsSortExcelLike, Order.Compare);
  finally
    Order.Free;
  end;
end;
Όταν δίνεται custom comparer, το HotXLS προσπερνά τον δικό του χειρισμό κενών και περνά τις ακατέργαστες τιμές κλειδιών, οπότε ο comparer πρέπει να φροντίζει τα Null. Για φθίνουσα σειρά το HotXLS αντιστρέφει ό,τι επιστρέφει ο comparer, που μετακινεί και τα κενά στην κορυφή εκτός αν ο comparer το προβλέψει. Κρατήστε υπόψη ότι στήλη ταξινομημένη έτσι δεν είναι πια στη σειρά που περιμένει το κατά προσέγγιση VLOOKUP της Excel ή ένα binary-search XLOOKUP· οι παγίδες εκείνων των modes σε δεδομένα ταξινομημένα με άλλη σειρά καλύπτονται στον οδηγό για binary search modes των XLOOKUP και XMATCH
Γιατί μπορεί το ίδιο workbook να ταξινομείται διαφορετικά σε άλλη μηχανή;
Το ίδιο workbook μπορεί να ταξινομείται διαφορετικά σε άλλη μηχανή επειδή η σειρά κειμένου της Excel εξαρτάται από το Windows user locale, και το HotXLS ακολουθεί σκόπιμα εκείνη την εξάρτηση. Το word sort είναι γλωσσικό: το σουηδικό collation για παράδειγμα βάζει το ä μετά το z, εκεί που τα αγγλικά και τα γερμανικά το κρατούν δίπλα στο a. Η Excel το κληρονομεί από το locale κάτω από το οποίο τρέχει, οπότε workbook που ξαναϋπολόγισε συνάδελφος στη Στοκχόλμη μπορεί να επιστρέψει διαφορετικό COUNTIF(...,">y") από το ίδιο αρχείο σε desktop στο Σικάγο. Το HotXLS περνά LOCALE_USER_DEFAULT ώστε τα αποτελέσματά του να ισούνται με της Excel στην ίδια μηχανή· οποιοδήποτε σταθερό locale θα έκανε το HotXLS να διαφωνεί με την Excel σε κάθε μηχανή με διαφορετική ρύθμιση
Τρεις πρακτικές συνέπειες ακολουθούν για server-side παραγωγή:
- Το locale που μετράει είναι αυτό του λογαριασμού κάτω από τον οποίο τρέχει η διεργασία. Ένα Windows service ή IIS application pool μπορεί να χρησιμοποιεί διαφορετική περιφερειακή μορφή από το desktop του developer, οπότε όσα παρατηρείτε στο IDE δεν είναι αυτόματα ό,τι υπολογίζει η παραγωγή
- Τα cached αποτελέσματα τύπων που γράφονται στο αρχείο αντανακλούν το locale της μηχανής παραγωγής. Η Excel ξαναϋπολογίζει με το δικό της locale, οπότε μια τιμή μπορεί να αλλάξει όταν το αρχείο ανοίξει αλλού και ξαναϋπολογιστεί· εκείνη είναι συμπεριφορά της Excel, όχι τεχνάσματος HotXLS
- Τα locales διαφωνούν κυρίως στους τονισμένους χαρακτήρες, σε συνδυασμούς γραμμάτων που κάποιες γλώσσες μεταχειρίζονται ως ένα γράμμα, και σε non-Latin γραφές, οπότε test δεδομένα περιορισμένα σε σκέτες αγγλικές λέξεις δεν θα φανερώσουν το πρόβλημα
Το όριο platform είναι απλό. Το HotXLS είναι Windows βιβλιοθήκη, χτισμένη για Win32 και Win64 με Delphi και C++Builder και για στόχους win32 / win64 με Lazarus και Free Pascal, και όλα αυτά τα builds καλούν την ίδια CompareStringW. Δεν υπάρχει ξεχωριστή διαδρομή collation εκτός Windows. Το μόνο fallback είναι για κλήση API που απέτυχε: αν η CompareStringW επιστρέψει 0, το XlsCompareText συγκρίνει τα strings σε κεφαλαία κατά code unit αντί να πετάξει exception στη μέση επανυπολογισμού, που κρατά τον υπολογισμό να τρέχει μα δεν εγγυάται πια τη σειρά της Excel
Σύντομη αναφορά: σύγκριση κειμένου της Excel στο HotXLS
- Κανόνας: word sort user locale με
NORM_IGNORECASE, χωρίςSORT_STRINGSORT, χωρίςNORM_IGNOREWIDTH, στο HotXLS από το v2.384.67 -και'σπάνε μόνο ισοπαλίες: ο="a-b">"ab"είναι TRUE και ο="a-b"="ab"είναι FALSE- Η υπόλοιπη στίξη ταξινομείται πριν από τα ψηφία, τα ψηφία πριν από τα γράμματα: οι
="a~b"<"ab"και="a0"<"ab"είναι TRUE - Τα πεζά-κεφαλαία δεν παίζουν ποτέ ρόλο: ο
="ABC"="abc"είναι TRUE και τοVLOOKUP("ABC",...)βρίσκειabc - Καλυμμένες διαδρομές: τελεστές σύγκρισης, συγκρίσεις array, κριτήρια
>/<,VLOOKUP/HLOOKUP, ταξινόμηση dynamic-array,SortRangeκαι στις δύο engines - Δεν καλύπτονται από αυτόν τον κανόνα: μικτοί τύποι (αριθμός < κείμενο < boolean) και wildcard κριτήρια, που έχουν τους δικούς τους κανόνες
- Σε κώδικα Delphi:
CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...), τσεκάρετε για 0, αφαιρέστεCSTR_EQUAL· αποφύγετεCompareText,CompareStrκαιTComparer<string>.Defaultόταν το αποτέλεσμα πρέπει να συμφωνεί με την Excel - Τα αποτελέσματα εξαρτώνται από το locale του λογαριασμού που τρέχει τον κώδικα, στην Excel και στο HotXLS το ίδιο
Οι συνηθισμένες λέξεις ταξινομούνται ίδια κάτω από κάθε κανόνα, οπότε μόνο κωδικοί με παύλα, στίξη και τονισμένα ονόματα εκθέτουν λάθος collation. Το HotXLS τώρα δίνει την απάντηση της Excel σε όλα αυτά και στις δύο engines, XLS και XLSX. Λεπτομέρειες για αδειοδότηση, υποστηριζόμενες εκδόσεις Delphi και C++Builder και δοκιμαστική λήψη στη σελίδα HotXLS Delphi Excel component