Το HotXLS Delphi Component αξιολογεί το =1<2<3 ως FALSE, την ίδια απάντηση που δίνει το Excel 16, επειδή από το v2.384.3 ο parser των τύπων του διπλώνει τους τελεστές σύγκρισης από αριστερά προς τα δεξιά: το 1<2 γίνεται TRUE, και το TRUE<3 είναι FALSE επειδή ένα boolean κατατάσσεται πάνω από κάθε αριθμό. Η ίδια έκδοση κάνει έναν κενό τελεστέο ίσο τόσο με 0 όσο και με "", και αφήνει το SUMIF να τραβήξει ένα sum range ενός κελιού στο σχήμα του criteria range του. Καθένα από αυτά μοιάζει με λεπτομέρεια μέχρι ένα workbook υπολογισμένο στο Delphi να διαφωνεί με το ίδιο workbook ανοιγμένο στο Excel
Η διαφωνία συνήθως ξεκινά με έναν τύπο που κάποιος έγραψε από διαίσθηση. Κάποιος πληκτρολογεί =0<B2<100 για να ελέγξει ότι μια ποσότητα είναι στο εύρος, το Excel απαντά ήσυχα FALSE για κάθε γραμμή, και το φύλλο φεύγει με το bug ψημένο μέσα του. Μια μηχανή υπολογισμών δεν έχει περιθώριο να διορθώσει την πρόθεση του χρήστη· η δουλειά της είναι να παράγει την τιμή που θα παρήγε το Excel, ώστε το cached αποτέλεσμα που γράφει το HotXLS στο αρχείο να συμφωνεί με ό,τι δείχνει το Excel μετά από επανυπολογισμό. Πριν το v2.384.3 το HotXLS απαντούσε TRUE για εκείνον τον έλεγχο εύρους σε κάθε γραμμή, λάθος προς την αντίθετη κατεύθυνση, και μια αναφορά που παραγόταν σε server θα διαφωνούσε με την ίδια αναφορά ανοιγμένη σε desktop
Γιατί το =1<2<3 επιστρέφει FALSE στο Excel;
Το Excel επιστρέφει FALSE επειδή διαβάζει μια αλυσίδα συγκρίσεων ως (1<2)<3, και το εσωτερικό TRUE μετά χάνει τη μάχη κατάταξης τύπων απέναντι στον αριθμό 3. Ο παλιός parser του HotXLS διάβαζε το ίδιο κείμενο ως 1<(2<3): το TXLSSyntax.Parse_expr στο lxFormula.pas έκανε parse έναν τελεστέο, έβλεπε token σύγκρισης, και αναδυόταν σε Parse_expr για τη δεξιά πλευρά, που κάνει τον τελεστή right-associative. Αυτό δίνει 1<TRUE, και ένας αριθμός είναι κάτω από boolean, οπότε το αποτέλεσμα ήταν TRUE. Το λάθος είναι συμμετρικό: το =3>2>1 είναι TRUE στο Excel και ήταν FALSE στο HotXLS, και το =1=1=TRUE είναι TRUE στο Excel και ήταν FALSE πριν το fix. Το regression CalculateFormula_ComparisonChainsFoldLeftToRight καρφώνει επτά τέτοιους τύπους απέναντι στις τιμές που επιστρέφει το Excel 16, και τρέχει τον καθένα και από τις δύο αρχιτεκτονικές μηχανών, το classic TXLSWorkbook και το XLSX-native TXLSXWorkbook, μέσω της μεθόδου Calculate που περιγράφει η επισκόπηση της μηχανής τύπων του HotXLS
const
  Formulas: array [0..6] of string = ('=1<2<3', '=3>2>1', '=(1<2)<3',
    '=1<(2<3)', '=1=1=TRUE', '=3>2>1=TRUE', '=1<2<3=FALSE');
  // Τι επιστρέφει το Excel 16:  FALSE, TRUE, FALSE, TRUE, TRUE, TRUE, TRUE
var
  Classic: IXLSWorkbook;
  Xlsx: TXLSXWorkbook;
  i: Integer;
begin
  Classic := TXLSWorkbook.Create;
  Xlsx := TXLSXWorkbook.Create;
  try
    // Το TXLSXWorkbook.Calculate αξιολογεί πάνω στο ενεργό φύλλο και
    // επιστρέφει Null όταν το workbook δεν έχει καθόλου φύλλο
    Xlsx.Sheets.Add('Data');
    for i := 0 to High(Formulas) do
      Writeln(Formulas[i], '  classic=', VarToStr(Classic.Calculate(Formulas[i])),
        '  xlsx=', VarToStr(Xlsx.Calculate(Formulas[i])));
  finally
    Xlsx.Free;
  end;
end;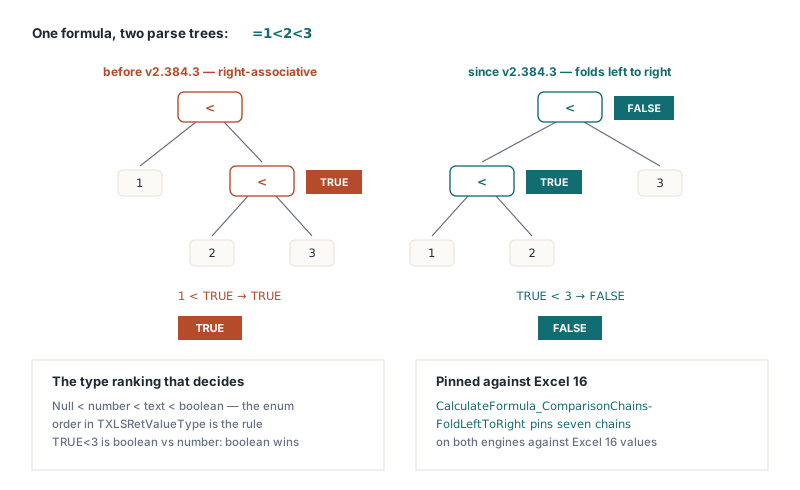
Το fix μετατρέπει το Parse_expr σε βρόχο του ίδιου σχήματος που χρησιμοποιεί ήδη το Parse_expr1 για το +, το - και το &. Κάνει parse τον πρώτο τελεστέο με Parse_expr1, και όσο το επόμενο token είναι ένα από =, <>, <, >, <= ή >=, δημιουργεί κόμβο σύγκρισης, προσαρτά το συσσωρευμένο αριστερό αποτέλεσμα ως πρώτο child, κάνει parse τον επόμενο τελεστέο με Parse_expr1 αντί για Parse_expr, και κάνει τον νέο κόμβο αριστερό αποτέλεσμα για τον επόμενο γύρο. Δύο λεπτομέρειες ήταν εύκολο να πάνε στραβά στη μετατροπή αναδρομής σε επανάληψη, και οι δύο είναι στις σημειώσεις των maintainers: ο συσσωρευμένος κόμβος πρέπει να παραδοθεί με τη σειρά (lChild := Item; Item := nil), και το μονοπάτι σφάλματος πρέπει να κάνει Exit μετά την απελευθέρωση του μισοχτισμένου κόμβου αντί να βγαίνει από τον βρόχο επιστρέφοντας ένα κρεμάμενο δέντρο
Πώς κατατάσσει το HotXLS αριθμούς, κείμενο και booleans σε μια σύγκριση;
Το HotXLS κατατάσσει μικτούς τύπους όπως το Excel: κάθε αριθμός είναι μικρότερος από κάθε τιμή κειμένου, και κάθε τιμή κειμένου είναι μικρότερη από κάθε boolean. Το TXLSCalculator.CompareVariants στο lxCalc.pas ταξινομεί και τους δύο τελεστέους με το GetRetValueType στην απαρίθμηση TXLSRetValueType = (xlVariantValue, xlNumberValue, xlStringValue, xlBooleanValue), και όταν οι δύο κλάσεις διαφέρουν απλώς συγκρίνει τα ordinals τους, οπότε η σειρά δήλωσης εκείνου του enum είναι ο κανόνας μεταξύ τύπων. Μέσα σε μία κλάση η σύγκριση είναι η φυσική, με μία Excel-ική ιδιαιτερότητα για κείμενο: και τα δύο strings περνούν πρώτα από lxUpperCase, οπότε το ="abc"="ABC" είναι TRUE. Αυτή η κατάταξη είναι ο λόγος που το αποτέλεσμα της αλυσίδας δεν συλλογίζεται χωρίς αυτήν. Το TRUE<3 δεν είναι coercion του TRUE σε 1, είναι boolean συγκρινόμενο με αριθμό, και το boolean κερδίζει. Οι ημερομηνίες είναι serial numbers για τη μηχανή (η κλάση varDate ταξινομείται ως xlNumberValue), οπότε μια ημερομηνία είναι πάντα κάτω από οποιοδήποτε κείμενο, συμπεριλαμβανομένου κειμένου που τυχαίνει να μοιάζει με ημερομηνία
Με τι ισούται ένα κενό κελί σε μια σύγκριση;
Ένα κενό κελί που χρησιμοποιείται ως τελεστέος σύγκρισης ισούται με 0 όταν η άλλη πλευρά είναι αριθμός, ισούται με "" όταν η άλλη πλευρά είναι κείμενο, και από το v2.384.53 ισούται με FALSE όταν η άλλη πλευρά είναι λογική τιμή, οπότε με κενό A1 τα =A1=0, =A1="" και =A1=FALSE είναι όλα TRUE. Το TXLSCalculator.CompareVarValues, που εξυπηρετεί και τους έξι τελεστές σύγκρισης, αντικαθιστά το κενό πριν καλέσει το CompareVariants: αν ακριβώς ένας τελεστέος είναι Null γίνεται WideString('') όταν ο συγκάτοικός του είναι string, False όταν ο συγκάτοικός του είναι boolean, και 0 αλλιώς. Δύο κενά εξακολουθούν να συγκρίνονται ίσα μεταξύ τους χωρίς αντικατάσταση. Το αριθμητικό μονοπάτι μετέτρεπε πάντα το κενό σε 0, γι' αυτό το =A1+1 έδινε 1, αλλά το CompareVariants κρατούσε το Null ως δική του κατώτατη κατάταξη, κάτω από κάθε αριθμό, και οι τελεστές σύγκρισης χρησιμοποιούσαν εκείνη την κατάταξη απευθείας
var
  Wb: IXLSWorkbook;
  Sh: TXLSWorksheet;
begin
  Wb := TXLSWorkbook.Create;
  Sh := Wb.Sheets.Add;
  Sh.Range['B1', 'B1'].Value := 5;      // το A1 μένει κενό σκόπιμα

  Writeln(VarToStr(Wb.Calculate('=A1=0')));    // True
  Writeln(VarToStr(Wb.Calculate('=A1=""')));   // True
  Writeln(VarToStr(Wb.Calculate('=A1<B1')));   // True: το κενό συγκρίνεται ως 0
  Writeln(VarToStr(Wb.Calculate('=A1<0')));    // False· True πριν το v2.384.3
end;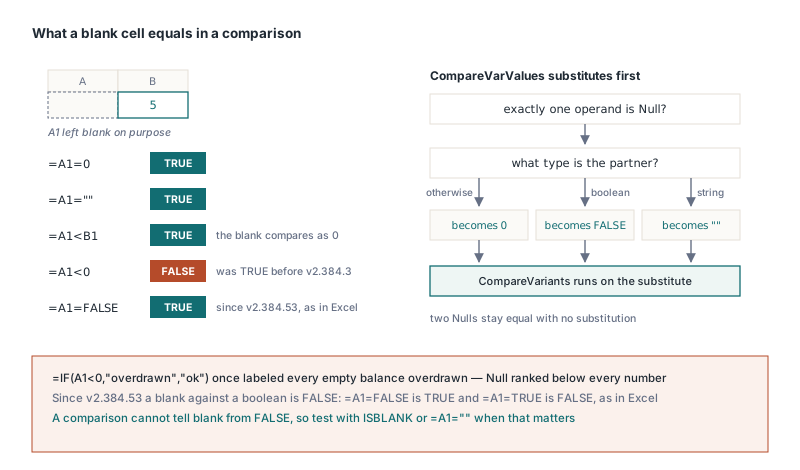
Η τελευταία γραμμή είναι εκείνη που πόνεσε στην πράξη. Υπό την παλιά κατάταξη, ένα κενό ήταν μικρότερο από κάθε αριθμό, αρνητικούς συμπεριλαμβανομένων, οπότε το =IF(A1<0,"overdrawn","ok") έγραφε κάθε κενό κελί υπολοίπου ως υπερβαλλόμενο, και το =A1=0 ήταν FALSE για ένα κελί που οποιοσδήποτε χρήστης θα περιέγραφε ως μηδέν. Ένα όριο έμεινε μετά το v2.384.3: η αντικατάσταση διάλεγε μόνο ανάμεσα σε 0 και κενό string, οπότε ένα κενό συγκρινόμενο με boolean γινόταν 0, που κατατάσσεται κάτω τόσο από TRUE όσο και από FALSE, και το =A1=FALSE σε κενό A1 αξιολογούνταν FALSE. Από το HotXLS 2.384.53 ένα κενό συγκρινόμενο με λογική τιμή μεταχειρίζεται ως FALSE και στις δύο μηχανές XLS και XLSX, όπως κάνει το Excel: με κενό A1, τα =A1=FALSE και =A1<TRUE επιστρέφουν TRUE και το =A1=TRUE επιστρέφει FALSE. Αυτό σημαίνει επίσης ότι η σύγκριση δεν μπορεί να ξεχωρίσει κενό από FALSE, ούτε στο Excel ούτε στο HotXLS· όταν ένα φύλλο χρειάζεται εκείνη τη διάκριση, τεστάρετε με ISBLANK ή =A1=""
Γιατί ένα SUMIF με sum range ενός κελιού επέστρεφε 0;
Το SUMIF επέστρεφε 0 επειδή το HotXLS στενεύει την επανάληψη στο μικρότερο από τα δύο ranges, ενώ το Excel κρατά το σχήμα του criteria range και χρησιμοποιεί το sum range μόνο για το πάνω αριστερό κελί του. Το =SUMIF(A1:A10,">5",B1) σημαίνει επομένως B1:B10 στο Excel, μια διευκόλυνση στην οποία βασίζονται πολλά χειροποίητα templates. Ο κοινός worker TXLSCalculator.GetValueItemRange2 συρρικνούσε τις μετρήσεις γραμμών και στηλών του σε αυτές του value range, που μείωνε το παράδειγμα σε ένα μόνο τεστ του A1 απέναντι στο B1. Το v2.384.3 αφαιρεί το στένωμα: ο βρόχος πλέον περπατά το criteria range και διαβάζει κάθε τιμή στην ίδια μετατόπιση από την πάνω αριστερή γωνία του sum range. Επειδή το CalcSumIF και το CalcAverageIF καλούν και τα δύο εκείνον τον worker, το AVERAGEIF παίρνει το ίδιο αναπλάθωμα, και ένα sum range μεγαλύτερο από το criteria range κόβεται στο σχήμα του criteria για τον ίδιο λόγο. Το όρισμα criteria στη μέση είναι όρισμα κλάσης αξίας και τα δύο εξωτερικά είναι κλάσης αναφοράς, η διάκριση που καλύπτει το άρθρο για implicit intersection και κλάσεις ορισμάτων
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Row: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Sales');
    for Row := 1 to 10 do
    begin
      Sheet.Cells[Row, 1].Value := Row;          // στήλη criteria: 1..10
      Sheet.Cells[Row, 2].Value := Row * 100;    // ποσά: 100..1000
    end;
    Sheet.Cells[1, 4].Formula := '=SUMIF(A1:A10,">5",B1)';     // sum range ενός κελιού
    Sheet.Cells[2, 4].Formula := '=SUMIF(A1:A10,">5",B1:B10)'; // ρητό sum range
    if Book.Recalculate = lxOk then
      // Και τα D1 και D2 είναι 4000 (600+700+800+900+1000)· το D1 ήταν 0 πριν το v2.384.3
      Writeln(VarToStr(Sheet.Cells[1, 4].Value), ' ', VarToStr(Sheet.Cells[2, 4].Value));
  finally
    Book.Free;
  end;
end;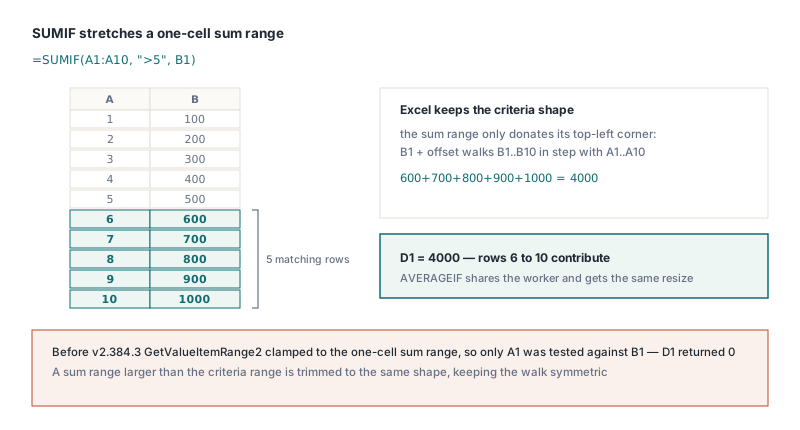
INDIRECT και YEARFRAC: δύο πιο σιωπηλές διορθώσεις
Το INDIRECT σέβεται πλέον το δεύτερο όρισμά του, και κείμενο μετά από έγκυρη αναφορά είναι σφάλμα αντί να αγνοηθεί. Με a1 FALSE το κείμενο κάνει parse ως απόλυτο R1C1, οπότε το =INDIRECT("R2C3",FALSE) διαβάζει το C2· ο παλιός κώδικας αγνοούσε τη σημαία, διάβαζε το "R2" ως στήλη R, γραμμή 2, και επέστρεφε σιωπηλά το λάθος κελί. Η σημαία δρομολογείται βάσει του variant τύπου της (boolean, αριθμός ή κείμενο) επειδή η απευθείας μετατροπή string variant σε Double σηκώνει εξαίρεση. Σχετικό R1C1 κείμενο όπως το R[1]C[1] επιστρέφει #REF!, αφού το INDIRECT δεν έχει origin κελιού τύπου για να το λύσει απέναντί του, και κείμενο A1 με χαρακτήρες στην ουρά, "B2 junk", επιστρέφει επίσης #REF!. Το YEARFRAC με basis 0 εφαρμόζει πλέον τους κανόνες NASD για τελευταία ημέρα Φεβρουαρίου που το DAYS360 είχε ήδη υλοποιήσει: όταν και οι δύο ημερομηνίες είναι η τελευταία μέρα του Φεβρουαρίου η τελική μέρα γίνεται 30, μετά μια αρχή στην τελευταία μέρα του Φεβρουαρίου γίνεται 30. Από 2024-02-29 έως 2025-02-28 η μέτρηση είναι πλέον 360 ημέρες, κλάσμα ακριβώς 1, όπου το προηγούμενο Days360US μετρούσε 359
Τι εγγυώνται αυτά τα fixes, και ποιο ήταν το μάθημα;
Η συμπεριφορά της αλυσίδας συγκρίσεων εγγυάται από ένα τεστ που συγκρίνει και τις δύο μηχανές με τιμές μετρημένες στο Excel 16, και εκείνο το τεστ υπάρχει επειδή η πρώτη περιγραφή του fix ήταν λάθος. Το release note του v2.384.3 έλεγε αρχικά ότι το folding από αριστερά προς τα δεξιά έκανε το =1<2<3 TRUE, που είναι ακριβώς αυτό που παρήγε ο παλιός right-associative parser και το αντίθετο από ό,τι επιστρέφουν και το Excel και ο νέος κώδικας. Κανείς δεν είχε αξιολογήσει το παράδειγμα· είχε γραφτεί από τη διαίσθηση ότι «το 1 είναι μικρότερο από το 2 που είναι μικρότερο από το 3». Η σημείωση διορθώθηκε και το τεστ των επτά τύπων προστέθηκε σε επόμενο commit, και ο κανόνας που βγήκε από εκεί ισχύει για όποιον τεκμηριώνει σημασιολογία spreadsheets: τρέξτε το παράδειγμα στο Excel πριν γράψετε την αναμενόμενη τιμή. Η αντικατάσταση κενού τελεστέου και το αναπλάθωμα του SUMIF ακολουθούν την ίδια συμπεριφορά Excel, συμπεριλαμβανομένης της περίπτωσης κενό-απέναντι-σε-boolean από το v2.384.53, και τα conditional aggregates που πρέπει επιπλέον να προσπερνούν φιλτραρισμένες ή κρυμμένες γραμμές ακολουθούν τους ξεχωριστούς κανόνες του άρθρου για κρυμμένες γραμμές στα SUBTOTAL και AGGREGATE
Το HotXLS είναι εγγενές spreadsheet component για Delphi και C++Builder που διαβάζει, επανυπολογίζει και γράφει XLS, XLSX, ODS και CSV χωρίς εγκατεστημένο Excel, και οι κανόνες σύγκρισης, κενού και SUMIF που περιγράφονται εδώ ζουν στη μηχανή υπολογισμών που μοιράζονται και οι δύο αρχιτεκτονικές workbook. Η πλήρης λίστα συναρτήσεων και οι επιλογές αδειοδότησης είναι στη σελίδα προϊόντος του HotXLS Delphi spreadsheet component