Ένα defined name που παραπέμπει σε ολόκληρη στήλη διαβάζεται από το Excel ως ένα μεμονωμένο κελί όταν εμφανίζεται σε scalar θέση: το =Vertical+1 στη γραμμή 7 σημαίνει «το κελί της γραμμής 7 του Vertical», όχι όλη η περιοχή. Το HotXLS Delphi Component εφαρμόζει αυτό το implicit intersection στο v2.382.4 σε δύο επίπεδα, κατά την αξιολόγηση και κατά την εξαγωγή dependencies, γιατί ένα template δανείου με 4805 τύπους έδειξε ότι το σωστό value δεν φτάνει. Όταν ο dependency walker απλώνει το όνομα σε όλη του την περιοχή, ένας downstream τύπος που τρέφεται από οποιοδήποτε κελί εκείνης της περιοχής κλείνει ένα cycle που δεν υπάρχει, και το TXLSXWorkbook.Recalculate απορρίπτει ολόκληρο το βιβλίο εργασίας
Το template στη συγκεκριμένη περίπτωση είναι ένα κλασικό βιβλίο εργασίας απόσβεσης δανείου. Με κάθε cached value δηλητηριασμένο στο 777 και μια πλήρη εκτέλεση Recalculate, και οι δύο αρχιτεκτονικές του engine επέστρεφαν 23, που είναι lxErrorRef, ο κωδικός circular reference. 3842 από τους 4805 τύπους δεν ταίριαζαν με την ανεξάρτητη αναμενόμενη τιμή, το B18 κρατούσε #VALUE!, το E18 ήταν ακόμα 777, και το πλήθος των πληρωμών στο J7 είχε διαβάσει τα placeholders μιας ημιτελούς στήλης υπολοίπου. Τρία ανεξάρτητα ελαττώματα κρύβονταν πίσω από έναν κωδικό επιστροφής, και το άρθρο αυτό περνά από το καθένα με τον κώδικα που το διόρθωσε
Γιατί μια scalar αναφορά σε όνομα στήλης δημιουργεί ψευδή cycle;
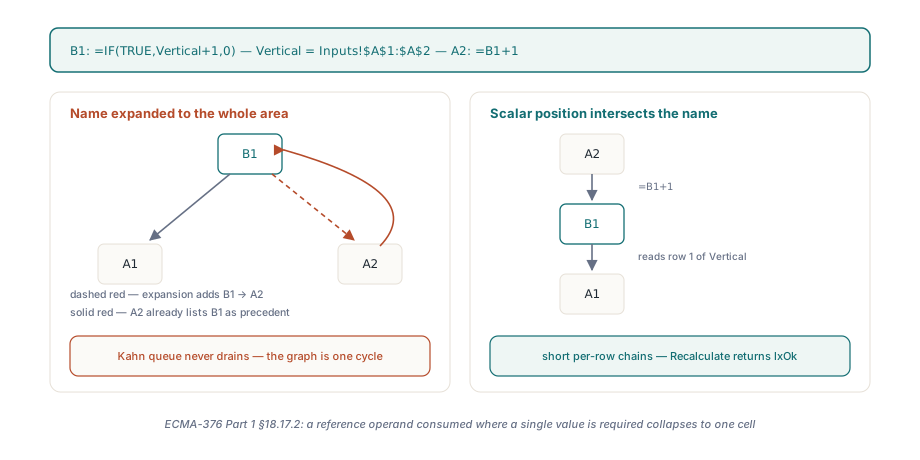
Γιατί ένα dependency graph ξέρει μόνο ακμές, και μια ακμή από τύπο σε περιοχή 480 γραμμών είναι 480 ακμές, από τις οποίες μία δείχνει πίσω μέσα από κελί που εξαρτάται από τον τύπο. Πάρε το =IF(TRUE,Vertical+1,0) στο B1 με το Vertical ορισμένο ως Inputs!$A$1:$A$2, και το =B1+1 στο A2. Το Excel αξιολογεί το B1 ως A1+1 και το A2 ως B1+1, μια ίσια αλυσίδα. Ένας walker που καταγράφει το B1 ως εξαρτώμενο από A1:A2 κάνει το A2 precedent του B1, το A2 ήδη απαριθμεί το B1 ως precedent, και η ουρά Kahn που κινεί το incremental recalculation στο HotXLS δεν βλέπει ποτέ κανέναν κόμβο να φτάνει in-degree μηδέν. Αυτό είναι το pattern από το οποίο φτιάχνονται τα templates δανείων: κάθε γραμμή περιόδου παραπέμπει σε named columns για το υπόλοιπο, το επιτόκιο και το πλήθος πληρωμών, κάθε όνομα απλώνεται σε όλο το πρόγραμμα, και κάθε γραμμή γράφει και η ίδια μέσα σε εκείνες τις στήλες. Απλώσε τα ονόματα και το graph είναι ένα γιγάνδιο strongly connected component. Αξιολόγησέ τα με implicit intersection και το graph είναι ένα σύνολο κοντών αλυσίδων, μία ανά γραμμή, που είναι ακριβώς αυτό που περιγράφει το ECMA-376 Part 1 §18.17.2 για ένα reference operand που καταναλώνεται όπου απαιτείται μοναδική τιμή
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // Scalar θέση: το Vertical καταρρέει σε A1 επειδή ο τύπος είναι στη γραμμή 1
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // Όνομα του οποίου η ορισμή είναι άλλο όνομα intersectάρει κι αυτό, οπότε A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // Όρισμα reference class: αθροίζεται όλη η περιοχή, χωρίς intersection
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // Η γραμμή 6 είναι εκτός A1:A2, το intersection είναι κενό και το πιάνει IFERROR
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2, A2 = 3, B2 = 3, B3 = 4, B6 = 42
      // Πριν το v2.382.4 το branch ήταν απρόσιτο: B1 -> A2 -> B1 ήταν cycle
    end;
  finally
    Book.Free;
  end;
end;
Πώς αποφασίζει το HotXLS ότι ένα όρισμα είναι scalar;
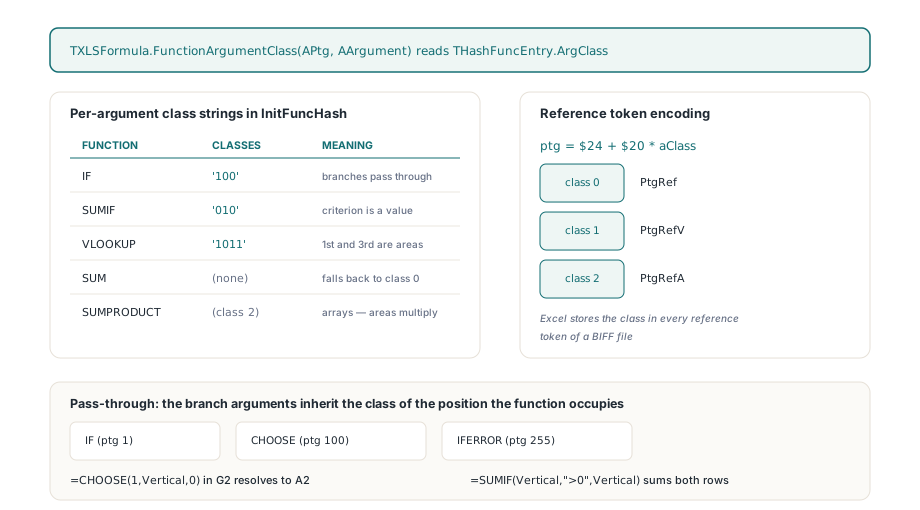
Το HotXLS διαβάζει την απάντηση από τον πίνακα συναρτήσεων και όχι από το σχήμα του ορίσματος. Κάθε εγγραφή στο TXLSFormula.InitFuncHash καταχωρείται μέσω THashFunc.SetValue με ένα προαιρετικό per-argument class string: το 'IF' κουβαλάει '100', το 'SUMIF' κουβαλάει '010', το 'VLOOKUP' κουβαλάει '1011', και το 'SUM' δεν κουβαλάει κανένα, οπότε όλα τα ορίσματά του πέφτουν πίσω στη function-level class 0. Το νέο TXLSFormula.FunctionArgumentClass(APtg, AArgument) εκθέτει εκείνο το byte μέσω THashFuncEntry.ArgClass, και αποτέλεσμα 1 σημαίνει value class. Αυτές είναι οι ίδιες τρεις κλάσεις που το [MS-XLS] §2.2.2 αναθέτει στα operand tokens, και ο encoder ήδη εξαρτιόταν από αυτές: όταν γράφει μια αναφορά υπολογίζει το ptg ως $24 + $20 * aClass, που δίνει PtgRef για class 0, PtgRefV για class 1 και PtgRefA για class 2. Ένα αρχείο BIFF γραμμένο από το Excel αποθηκεύει εκείνη την κλάση σε κάθε reference token, οπότε ένα engine του οποίου ο πίνακας ταιριάζει με το spec μπορεί να απαντήσει «είναι αυτό το όρισμα scalar;» χωρίς να κοιτάξει τα δεδομένα. Το μεσαίο όρισμα του SUMIF είναι το criterion, μια τιμή· το πρώτο και το τρίτο είναι περιοχές, references. Το SUMPRODUCT είναι καταχωρημένο με function-level class 2, array, γι' αυτό το =SUMPRODUCT(Vertical,Vertical) εξακολουθεί να πολλαπλασιάζει όλη την περιοχή
Τρεις συναρτήσεις δεν συμβουλεύονται τη δική τους εγγραφή πίνακα για τίποτα πέρα από το πρώτο όρισμα. Το IF (ptg 1), το CHOOSE (ptg 100) και το IFERROR (ptg 255) περνούν ανέπαφο ό,τι επιλέγουν, οπότε τα ορίσματα των branch τους κληρονομούν την κλάση της θέσης που καταλαμβάνει η ίδια η συνάρτηση. Αυτός ο μοναδικός κανόνας είναι που αφήνει το =CHOOSE(1,Vertical,0) στο G2 να λυθεί σε A2 ενώ το =SUMIF(Vertical,">0",Vertical) δίπλα του εξακολουθεί να αθροίζει και τις δύο γραμμές, και είναι ο κανόνας που ένα πρόγραμμα απόσβεσης εξασκεί περισσότερο από κάθε άλλο, γιατί τα κελιά των περιόδων του στηρίζονται στο IF για να τεστάρουν αν το δάνειο είναι ακόμα ανοιχτό
Μεταφέροντας την κλάση μέσα από το dependency walk
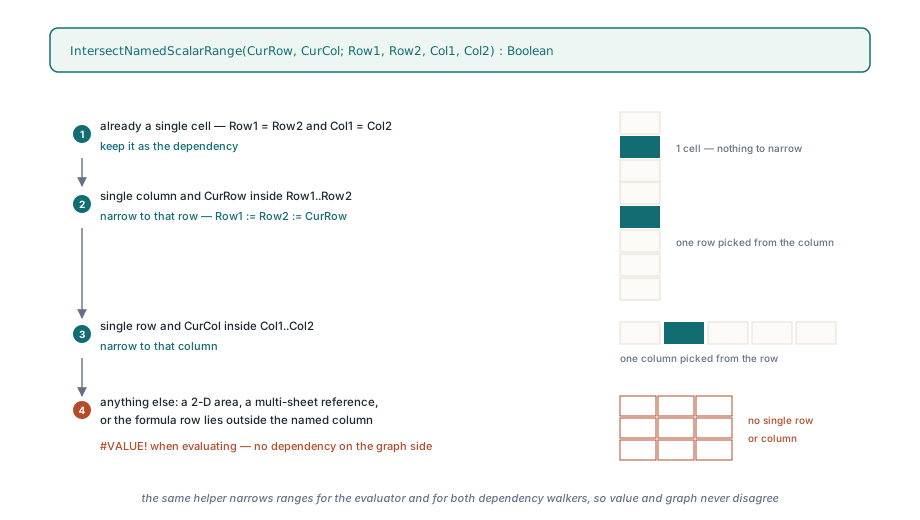
Ο dependency extractor στο lxCalc.pas είναι ένας αναδρομικός Walk πάνω στο μεταγλωττισμένο syntax tree, και υπάρχει δύο φορές, μία στο TXLSCalculator.ExtractDependencies για το graph ανά βιβλίο εργασίας και μία στο ExtractWorkspaceDependencies για το cross-workbook graph. Το v2.382.4 δίνει και στους δύο walkers δύο επιπλέον παραμέτρους. Το AScalar ξεκινά True στη ρίζα ενός τύπου, ξαναϋπολογίζεται για κάθε function child από το FunctionArgumentClass, και περνάει αμετάβλητο για τα branch ορίσματα των ptg 1, 100 και 255. Το ANameRoot γίνεται True μόνο όταν ο walker κατεβαίνει μέσα στη μεταγλωττισμένη ορισμή ενός ονόματος, και επιβιώνει μόνο μέσα από κόμβους SA_GROUP, τις παρενθέσεις, ώστε ένα όνομα ορισμένο ως =A1:A2+1 να μην μπερδεύεται με σκέτη περιοχή. Όταν και τα δύο flags είναι True σε έναν κόμβο SA_RANGE, το AddResolvedRange στενεύει την περιοχή με τον ίδιο helper που χρησιμοποιεί ο evaluator πριν καταγράψει το dependency. Ο helper είναι αρκετά κοντός για να παρατεθεί ολόκληρος
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // ήδη ένα κελί
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // μονή στήλη: πάρε τη γραμμή
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // μονή γραμμή: πάρε τη στήλη
    Result := True;
  end;
end;
Οτιδήποτε απορρίπτει ο helper, μια δισδιάστατη περιοχή, μια multi-sheet αναφορά ή ένας τύπος του οποίου η γραμμή πέφτει έξω από τη named στήλη, παράγει #VALUE! στην πλευρά της αξιολόγησης και καθόλου dependency στην πλευρά του graph, που είναι αυτό που κάνει το Excel για κενό intersection. Η πλευρά της αξιολόγησης ζει στο TXLSCalculator.GetValueItemName: αφαιρεί τα wrapper SA_GROUP από τη μεταγλωττισμένη ορισμή, και αν η ρίζα είναι SA_RANGE καλεί το GetRangeInfo, κάνει intersection, και φέρνει το ένα κελί μέσω FGetValue αντί να αξιολογήσει όλη την ορισμή. Οι external references μένουν στον παλιό δρόμο, γιατί δεν υπάρχει τοπική γραμμή πάνω στην οποία να γίνει intersection. Από πού προκύπτει εξαρχής η αποθήκευση και το scope ενός ονόματος καλύπτεται στο άρθρο για τα defined names και cross-sheet formulas· εδώ μετράει μόνο τι κάνει το engine αφού το όνομα λυθεί
Γιατί το MATCH πάνω σε μισοϋπολογισμένη στήλη διάβαζε 777;
Γιατί το lookup-array όρισμα του MATCH είναι scan reference, και οι scan references είχαν εξαιρεθεί σκόπιμα από τη σειρά αξιολόγησης. Το άρθρο για το lookup scan σύστησε το TXLSDepRange.LookupScan και έκλεισε με ενότητα που λεγόταν «τι παρατάς εξαιρώντας τις scan ακμές από τη διάταξη»: ένας lookup τύπος μπορεί να τρέξει πριν κάθε κελί του range του έχει ξαναϋπολογιστεί και να διαβάσει παλιές τιμές. Σε μια διαδραστική συνεδρία που συγκλίνει στο επόμενο πέρασμα αυτό δεν πειράζει. Σε ένα ομαδικό recalculation ενός δηλητηριασμένου template δεν συγκλίνει, και το PaymentCount, ορισμένο ως =MATCH(0.01,Balances,-1)+1, διάβασε τα placeholders 777 που καθόνταν ακόμα στη στήλη υπολοίπου και επέστρεψε πλήθος περιόδων που δεν μπορούσε να είναι σωστό
Το TXLSDepGraph.TopoOrder μεταχειρίζεται πλέον τις scan ακμές ως soft ακμές διάταξης. Δίπλα στο σκληρό in-degree κρατάει ένα array ScanInDeg, μετράει τα dirty scan precedents ανά κόμβο και το μειώνει όσο εκείνα τα precedents εκπέμπονται, χρησιμοποιώντας τις λίστες ScanPrecedents, ScanDependents και ScanPrecedentCount που η προηγούμενη αλλαγή αποθήκευε ήδη. Σε κάθε επανάληψη η ουρά Kahn σκανάρει το ready παράθυρό της για τον πρώτο κόμβο του οποίου το ScanInDeg είναι μηδέν και τον ανταλλάσσει στην κορυφή· αν κάθε ready κόμβος περιμένει ακόμα scan precedent, η κορυφή βγαίνει στη σταθερή της σειρά. Οι scan ακμές δεν μπαίνουν ποτέ στο σκληρό in-degree, οπότε ένα αυτοαναφορικό VLOOKUP πάνω στη δική του στήλη παραμένει νόμιμο, αλλά ένα lookup που μπορεί να περιμένει ένα precedent που τελειώνει πια το περιμένει. Το regression που το καρφώνει, το LookupScan_WaitsForDirtyFormulaValues, δηλητηριάζει τρία κελιά υπολοίπου στο 777 και περιμένει το PaymentCount να γυρίσει 3, μετά γυρνάει την είσοδο στο μηδέν και περιμένει το =IFERROR(PaymentCount,99) να δει το #N/A και να επιστρέψει 99
Από πού ήρθε η περικοπή στα τέσσερα δεκαδικά;
Από τη Variant αριθμητική του Delphi, και μόνο σε φωλιασμένες θέσεις. Οι δυαδικοί τελεστές στο TXLSCalculator.GetValueItem αντέγραφαν ήδη ένα top-level + ή - σε δύο τοπικά Double, οπότε το =B1-A1 ήταν μια χαρά. Μέσα στο =IF(TRUE,B1-A1,0) η ίδια αφαίρεση έτρεχε ως Value := Value - SubValue πάνω σε δύο Variants, και όταν ο ένας operand ήταν τιμή κελιού Int64 και ο άλλος Double, το αποτέλεσμα που παρατηρήσαμε ήταν Currency, ένας τύπος σταθερής υποδιαστολής με τέσσερα δεκαδικά, οπότε το 1066.1854641400994 μείον 120 γύριζε πεκομένο στα τέσσερα δεκαδικά. Σε ένα πρόγραμμα όπου κάθε πληρωμή σύνθεται από την προηγούμενη γραμμή, το λάθος αυτό περπατάει μέσα από εκατοντάδες περιόδους πριν φτάσει στα σύνολα
// TXLSCalculator.GetValueItem, branch δυαδικής αριθμητικής (lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// Μικτή Variant αριθμητική Int64/Double μπορεί να προβιβαστεί σε Currency.
// Η αριθμητική υπολογιστικών φύλλων οφείλει να κρατά ακρίβεια κινητής υποδιαστολής.
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
Ο φύλακας τρέχει πριν από SA_ADD, SA_SUB, SA_MUL και SA_DIV ομοίως, και το regression Arithmetic_MixedInt64AndDoubleKeepsPrecision αποθηκεύει Int64(120) στο A1 και 1066.1854641400994 στο B1, μετά τεστάρει τη φωλιασμένη διαφορά και άθροισμα στα 1E-10 και το γινόμενο και πηλίκο στα 1E-8 και 1E-12. Το HotXLS δεν ισχυρίζεται ότι ξέρει κάθε κανόνα προώθησης που εφαρμόζει το RTL σε μικτούς τύπους Variant ανά compiler έκδοση· ισχυρίζεται ότι η αριθμητική υπολογιστικών φύλλων είναι IEEE double, και πλέον κάνει και τους δύο operands double πριν τους δει ο τελεστής, κι έτσι η ερώτηση καταργείται
Τι εγγυάται το fix, και τι όχι
Μετά το v2.382.4 και οι δύο αρχιτεκτονικές του engine επιστρέφουν lxOk για το δηλητηριασμένο template, και οι 4805 cached values ταιριάζουν με την ανεξάρτητη ανα-γραμμή αναμενόμενη τιμή εντός 1E-7, και οι ισχυρισμοί ότι οι caches πράγματι δηλητηριάστηκαν, ότι το source hash είναι αμετάβλητο και ότι κάθε τύπος εξακολουθεί να υπάρχει ισχύουν όλοι. Καμία επανάληψη δεν ενεργοποιήθηκε και κανένας κωδικός σφάλματος δεν κατεστάλη για να φταστεί εκεί. Ένα γνήσιο cycle μέσα από όνομα, =B1 στο A1 με το B1 να διαβάζει ακόμα Vertical, εξακολουθεί να επιστρέφει σφάλμα, και το test NamedScalarRanges_IntersectWithoutFalseCycles τελειώνει ισχυριζόμενο ακριβώς αυτό
Τα όρια αξίζει να τα πεις ξερά. Το implicit intersection εφαρμόζεται μόνο σε όνομα του οποίου η μεταγλωττισμένη ορισμή, μετά την αφαίρεση παρενθέσεων, είναι περιοχή μονής στήλης ή μονής γραμμής σε ένα sheet· ένα δισδιάστατο όνομα σε scalar θέση είναι #VALUE!, όπως στο Excel, και μια συνάρτηση που δεν ξέρει ο πίνακας παίρνει class 0 από το FunctionArgumentClass, οπότε τα name ορίσματά της εξακολουθούν να απλώνονται ολόκληρα. Η soft διάταξη είναι προτίμηση, όχι εγγύηση: ένα cycle μόνο από scan ακμές εξακολουθεί να αξιολογείται σε σταθερή σειρά και να διαβάζει ό,τι είναι cached, που είναι η συμπεριφορά που το άρθρο του lookup scan δέχτηκε επίτηδες. Και το αποτέλεσμα όλου του template επαληθεύεται πάνω σε ανεξάρτητο expectation script, όχι πάνω σε άλλο spreadsheet engine, γιατί η reference office σουίτα δεν τελείωσε το recalculation του πρωτότυπου template μέσα σε προϋπολογισμό 60 δευτερολέπτων. Το HotXLS είναι ένα native Delphi και C++Builder spreadsheet component που διαβάζει, ξαναϋπολογίζει και γράφει XLS, XLSX, ODS και CSV χωρίς εγκατεστημένο Excel· το name intersection, ο πίνακας argument-class και η soft scan διάταξη ισχύουν για κάθε μορφή γιατί το calculation engine είναι κοινό, και η τρέχουσα κάλυψη συναρτήσεων απαριθμείται στη σελίδα προϊόντος του HotXLS Delphi spreadsheet component