Eine Seite Blocksatz-Fließtext kann aus einem Whitespace-Tabellen-Detektor als Raster mehrerer Spalten zurückkommen, jede Zelle mit einem zerbrochenen Halbsatz und der Confidence weit über jedem Schwellenwert, an den Sie denken würden. Auf dieser Seite gibt es keine Tabelle. Der Detektor hat Wortabstände gefunden, die breit genug waren, um als Spaltentrenner durchzugehen, und ein paar aufeinanderfolgende Zeilen, in denen diese Abstände an fast derselben X-Position landeten, und allein nach Ausrichtung sieht genau das wie eine Tabelle aus. Die Antwort ist, eine Spaltengrenze nicht mehr Zeile für Zeile zu beurteilen und stattdessen zu fragen, ob ein Streifen blanken Papiers die Seite zwischen den Spalten hinabläuft
Warum besteht Blocksatz einen Whitespace-Tabellen-Test?
Blocksatz besteht, weil eine Blocksatzzeile eine Reihe von Wörtern ist, getrennt durch Lücken, die die Layout-Engine gestreckt hat, und sobald eine gestreckte Lücke den Spaltenschwellenwert überschreitet, unterscheidet nichts auf dieser einzelnen Zeile sie von einem Spaltenzwischenraum. Die Whitespace-Strategie in PDFium Component funktioniert wie die meisten Whitespace-Detektoren. TPdf.ExtractTables gruppiert Wortboxen in visuelle Zeilen, teilt jede Zeile, wo immer der horizontale Abstand von einem Wort zum nächsten mindestens MinColumnGap beträgt (12 Punkte in TPdfTableExtractionOptions.Default), und clustert die linken Kanten der entstandenen Wortgruppen innerhalb von AlignmentTolerance zu Spaltenankern, das mit 3 Punkten defaulted. Ein Anker überlebt nur, wenn er auf mindestens MinRows Zeilen wiederkehrt, und jede Zeile des Kandidaten muss mindestens MinColumns distinkte Anker treffen. Für eine echte ausgerichtete Tabelle ist diese Regel richtig, und sie ist die Regel aus der Tabellenerkennungs-Übersicht
Die Arithmetik auf der Prosa-Seite ist weniger nachsichtig, als sie aussieht. Angenommen, eine 10-Punkt-Zeile in einer 180-Punkt-Newsletter-Spalte endet 30 Punkte vor dem rechten Rand, weil das nächste Wort nicht mehr passt, und die Zeile hält nur drei Wortzwischenräume, weil ihre Wörter lang sind. Eine Justage-Engine verteilt diese 30 Punkte auf die drei Zwischenräume, also wächst jeder von etwa 2,5 Punkten auf 12,5 Punkte und überschreitet den Default-MinColumnGap. Eine zweite Zeile braucht nur eine gestreckte Lücke, deren folgendes Wort innerhalb von 3 Punkten am Wort der ersten Zeile startet, und der Detektor hat einen Zwei-Zeilen-, Zwei-Spalten-Kandidaten
Wie die Streckung kodiert ist, spielt keine Rolle. ISO 32000-1 §9.3.3 wendet Wortabstand (Tw) nur auf den Single-Byte-Zeichencode 32 an, also positionieren Produzenten mit Multi-Byte-Fonts Wörter meist über numerische Anpassungen in einem TJ-Array (§9.4.3); entweder Weise kommen die Wortboxen identisch heraus. Die letzte Zeile jedes Absatzes ist linksbündig gesetzt und trägt gewöhnliche Leerzeichen, weshalb Fehlalarme gern den Body eines Absatzes abdecken und eine Zeile vor seinem Ende stoppen
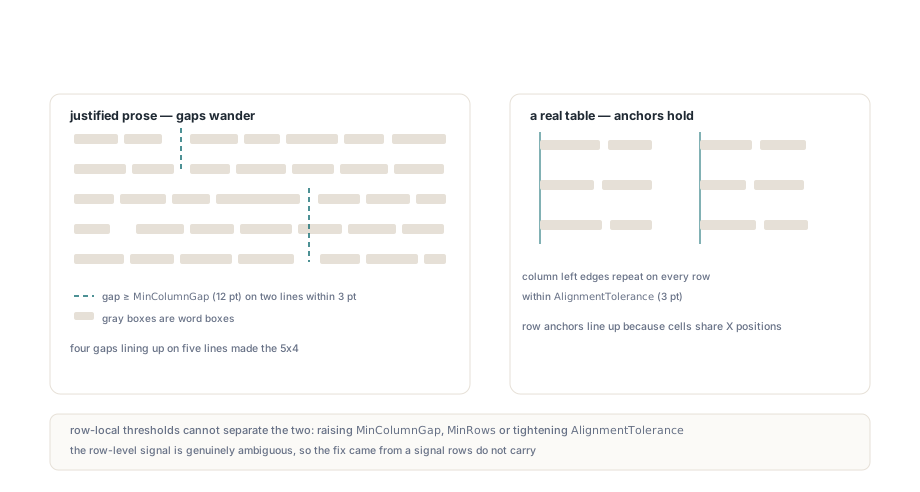
Ein schneller Weg, Ihr eigenes Korpus zu prüfen, ist, den Detektor über Dokumente laufen zu lassen, von denen Sie wissen, dass sie reine Prosa sind, etwa Briefe oder Pressemitteilungen, und jede Whitespace-Modus-Tabelle zu drucken, die er meldet. Die erwartete Ausgabe darauf ist nichts
uses
  SysUtils, PDFium;

// Listet jede Whitespace-ausgerichtete Tabelle im geladenen Dokument, damit
// sich Seiten, von denen Sie wissen, dass sie nur Prosa enthalten, schnell prüfen lassen
procedure ReportWhitespaceTables(Pdf: TPdf; MinRows: Integer = 2);
var
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Options := TPdfTableExtractionOptions.Default;  // MinColumnGap 12, AlignmentTolerance 3
  Options.MinRows := MinRows;
  Tables := Pdf.ExtractDocumentTables(Options);   // stellt die aktive Seite wieder her
  for I := 0 to High(Tables) do
    if Tables[I].DetectionMode = ptdmWhitespace then
      Writeln(Format('page %d: %dx%d whitespace table, confidence %.2f, ' +
        'first cell "%s"',
        [Tables[I].PageNumber, Tables[I].RowCount, Tables[I].ColumnCount,
         Tables[I].Confidence, Tables[I].Cells[0].Text]));
end;
Was jeder Schwellenwert kostet
Jeder zeilenbasierte Schwellenwert handelt eine Dokumentklasse gegen eine andere, und genau deshalb lässt man sie für dieses Problem in Ruhe. MinColumnGap auf 20 Punkte zu heben verliert die kompakten Spalten dichter Finanzberichte, wo der Zwischenraum zwischen einer Label-Spalte und ihren Werten oft kaum breiter als der Default ist. MinRows auf 3 zu heben verwirft echte Zweizeilen-Tabellen und senkt nur die Wahrscheinlichkeit für lange Absätze, denn eine Prosa-Seite bietet viele Gelegenheiten, dass sich drei Zeilen ausrichten. AlignmentTolerance unter 3 Punkte zu spannen fängt an, echte Spalten zu spalten, deren linke Kanten leicht driften, wie sie es auf gescannten Seiten mit einer OCR-Textschicht tun
MinConfidence sieht aus wie der natürliche Filter und ist der schwächste der vier. Eine Whitespace-Tabelle in PDFium Component punktet mit 0,58 plus 0,30 mal dem Anteil nicht-leerer Zellen, gekappt bei 0,88, der Punktzahl misst also, wie voll das Raster ist. Ein Absatz-Fragment füllt jede Zelle, was heißt, dass ein Prosa-Fehlalarm nahe am oberen Ende der Skala punktet, während eine echte Tabelle mit leeren Zellen niedriger punktet
Zwei Zeilen Blocksatz und zwei Zeilen einer zweispaltigen Tabelle können identische Wortgruppen an identischen Ankern produzieren. Der Beweis, der sie trennt, sitzt zwischen den Zeilen
Eine echte Spaltengrenze ist ein vertikaler Korridor
Eine echte Spaltengrenze ist ein vertikaler Streifen der Seite, der über jede Zeile, die er trennt, frei von Text bleibt. Eine Tabelle hat zwischen jedem Spaltenpaar einen davon, das liegt in der Konstruktion, denn die Zellen wurden gegen gemeinsame X-Positionen gesetzt. Ein Blocksatz-Absatz streckt seine Zwischenräume auf jeder Zeile an anderen horizontalen Positionen, also überlebt kein Streifen mehr als ein, zwei Zeilen. PDFium Component testet genau das, nachdem die Wortgruppen eines Kandidaten auf Ankerspalten verteilt wurden. Für jedes Paar benachbarter Spalten stiftet jede Zeile mit Inhalt in beiden Zellen das Intervall von der rechtesten Kante der Wörter der linken Zelle bis zur linkesten Kante der Wörter der rechten Zelle; die Intervalle werden über die Zeilen geschnitten, und der ganze Kandidat wird verworfen, wenn die Schnittmenge schmaler ist als die Hälfte von MinColumnGap — 6 Punkte beim Default
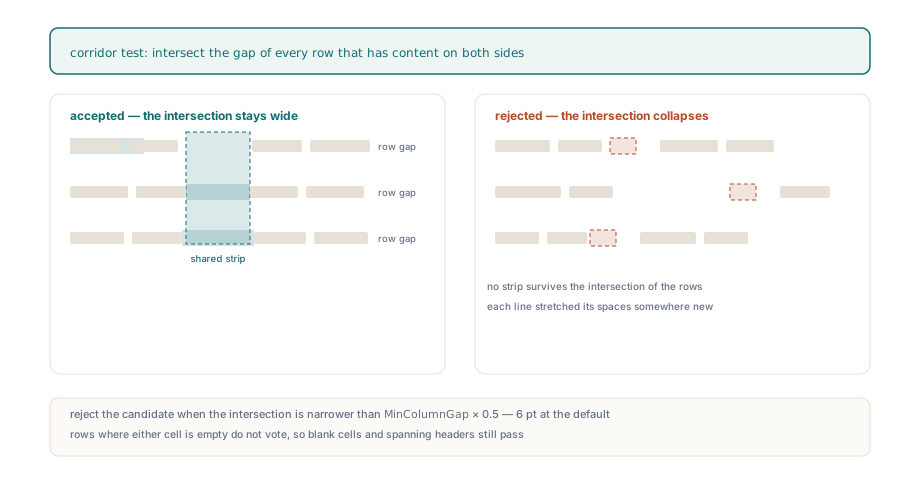
Zwei Details zählen bei unhandlichen echten Tabellen. Zeilen, in denen eine der Zellen leer ist, stimmen nicht mit ab, also besteht eine Tabelle mit leeren Zellen oder eine Header-Zeile, die weniger Spalten überspannt als der Body, weiterhin. Und die Korridorbreite wird aus MinColumnGap abgeleitet, statt eine eigene Option zu sein, denn beide Werte beschreiben dieselbe physische Sache: den Zwischenraum, den ein Designer zwischen Spalten lässt. Sie zu halbieren lässt Raum für die Zeile, in der ein langer Eintrag in der linken Spalte dicht an die nächste heranläuft
Der Check ist klein genug, um ihn im eigenen Layout-Code nachzubauen; die Zelllisten unten sind Ihre eigene Struktur, ein Array von Wortindizes pro Zelle in Row-Major-Ordnung
uses
  Math, PDFium;

type
  TIndexList = array of Integer;
  TCellIndexes = array of TIndexList;   // Ihre eigene Struktur: Row * ColumnCount + Column

// Liefert False, wenn einem benachbarten Spaltenpaar der textfreie vertikale
// Korridor von mindestens MinColumnGap / 2 Breite über den genutzten Zeilen fehlt
function HasTextFreeCorridors(const Words: TPdfWordBoxes;
  const Cells: TCellIndexes; RowCount, ColumnCount: Integer;
  MinColumnGap: Double): Boolean;
var
  Col, Row, I, LeftCell, RightCell, Supported: Integer;
  CorridorLeft, CorridorRight, RowLeft, RowRight: Double;
begin
  for Col := 0 to ColumnCount - 2 do
  begin
    CorridorLeft := -MaxDouble;
    CorridorRight := MaxDouble;
    Supported := 0;
    for Row := 0 to RowCount - 1 do
    begin
      LeftCell := Row * ColumnCount + Col;
      RightCell := LeftCell + 1;
      if (Length(Cells[LeftCell]) = 0) or (Length(Cells[RightCell]) = 0) then
        Continue;                             // leere Zellen stimmen nicht mit ab
      RowLeft := -MaxDouble;
      RowRight := MaxDouble;
      for I in Cells[LeftCell] do
        RowLeft := Max(RowLeft, Words[I].Rect.Right);
      for I in Cells[RightCell] do
        RowRight := Min(RowRight, Words[I].Rect.Left);
      CorridorLeft := Max(CorridorLeft, RowLeft);
      CorridorRight := Min(CorridorRight, RowRight);
      Inc(Supported);
    end;
    if (Supported > 0) and
       (CorridorRight - CorridorLeft < MinColumnGap * 0.5) then
      Exit(False);
  end;
  Result := True;
end;
Liniengitter-Tabellen aus dem Whitespace-Durchgang heraushalten
Eine Liniengitter-Tabelle würde doppelt gefunden, wenn der Whitespace-Durchgang jedes Wort auf der Seite sähe, denn ein sauberes Liniengitter ist konstruktionsbedingt auch eine perfekt ausgerichtete Whitespace-Tabelle. Für sich genommen ließe eine Mehr-als-die-Hälfte-Überlappungsregel einen Kandidaten durch, der die unteren Zeilen einer Liniengitter-Tabelle mit ein paar ausgerichteten Textzeilen darunter kombiniert, unter das Verhältnis bliebe und als zweite, größere Tabelle herauskäme, die in den Nachbarn hineinblutet
Sind sowohl DetectRuledTables als auch DetectWhitespaceTables an, was der Default ist, läuft ExtractTables deshalb zuerst den Linien-Durchgang und entfernt jedes Wort, dessen Mittelpunkt innerhalb der Bounds einer Liniengitter-Tabelle liegt, bevor der Whitespace-Durchgang startet. Der Mittelpunkt wird statt vollständiger Containment-Prüfung benutzt, damit ein Wort, das um einen Bruchteil eines Punktes über eine Umrandung reicht, der Tabelle folgt, zu der es visuell gehört. Die Whitespace-Strategie sieht dann nur freie Wörter, und eine kleine unlinierte Tabelle direkt unter einem Liniengitter wird nach eigenen Verdiensten beurteilt
Warum kann „Purpose of Request:“ als „of Purpose Request:“ herauskommen?
Wörter in einer Zelle kommen in falscher Reihenfolge heraus, wenn der Code, der „gleiche Zeile“ entscheidet, vertikale Zentren vergleicht, denn Wortboxen, die aus Glyph-Boxen gebaut sind, teilen kein Zentrum, selbst wenn sie eine Grundlinie teilen. FPDFText_GetCharBox liefert die enge Box der Tinte jedes Glyphs im Seitenraum, keine Box, die auf Ascent und Descent der Schrift gepolstert ist, und eine Wortbox ist die Vereinigung der Boxen ihrer Zeichen. In einem Formular-Label wie „Purpose of Request:“ tragen „Purpose“ und „Request:“ Unterlängen und „of“ nicht, also ist die Box für „of“ kürzer, und ihr Zentrum sitzt ein paar Punkte höher. Eine Routine, die nach Zentrum-Y mit einer 1-Punkt-Toleranz für „gleiche Zeile“ und dann nach linker Kante sortiert, setzt „of“ als eigene Zeile über die anderen beiden und gibt es zuerst aus
PDF bietet keinen Shortcut. ISO 32000-1 §9.4.4 platziert Glyphs per Verschiebung entlang der Grundlinie, und die einzigen vertikalen Metriken in der Datei sind pro Font: Ascent, Descent und FontBBox im Font-Descriptor (§9.8.1). Nichts sagt, dass zwei Glyphs eine Zeile teilen. Die engen Boxen, die Selection-Highlighting richtig aussehen lassen, wie in Textzeilen-Auswahl mit PDFium-Char-Boxen beschrieben, sind schlechter Input für einen Zentrumsdistanz-Vergleich
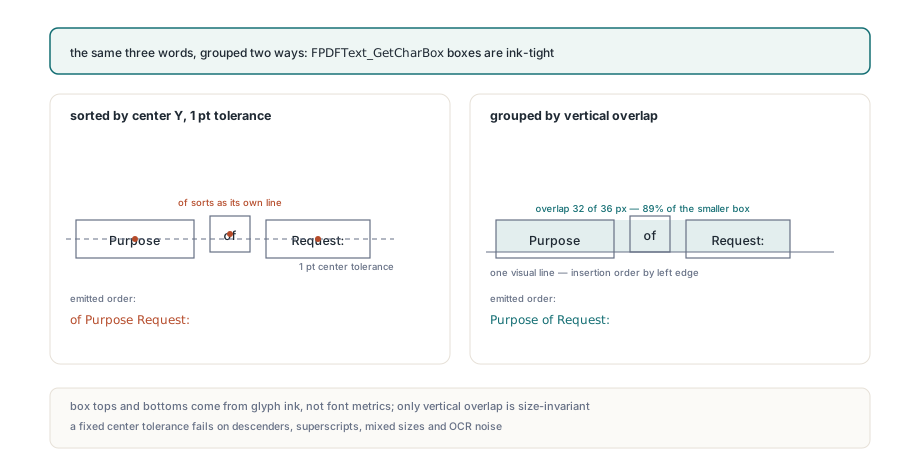
PDFium Component setzt Zelltext stattdessen per Überlappung zusammen. Ein Wort schließt sich einer visuellen Zeile an, wenn seine vertikale Überlappung mit den laufenden Bounds der Zeile mindestens 25 Prozent der kleineren der beiden Höhen beträgt, oder wenn die beiden Zentren innerhalb eines Punkts voneinander liegen; jede Zeile wird dann nach linker Kante sortiert, und Zeilen werden mit einem CR-LF-Paar verbunden. „Purpose“ und „of“ überlappen über die volle x-Höhe, weit mehr als ein Viertel der kürzeren Box, also landen sie auf einer Zeile und lesen sich in der richtigen Reihenfolge
Textzeilen in Ihrem eigenen Code nach Überlappung gruppieren
Dieselbe Falle wartet in jedem PDF-Layout-Code, der „gleiche Zeile“ entscheidet, indem er Zentren gegen eine feste Toleranz vergleicht. Unterlängen sind der mildeste Auslöser. Fette Labels neben kleineren Werten, hochgestellte Fußnoten-Marker und verrauschte OCR-Boxen verschieben Zentren alle um mehr als jede Toleranz, die benachbarte Zeilen von 10-Punkt-Text bei 12-Punkt-Leading noch trennt. Das Überlappungsverhältnis kümmert sich nicht um Größe: Zwei Boxen auf einer Grundlinie überlappen über ihre gemeinsame x-Höhe, und zwei Boxen auf benachbarten Zeilen überlappen um nichts
TPdf.PageWordBoxes liefert jedes Wort der aktiven Seite mit seinem Seitenraum-Rechteck in Rect, also braucht das Gruppieren einer Seite in visuelle Zeilen ein Prädikat und eine kurze Schleife
uses
  Math, PDFium;

function SameVisualLine(const A, B: TPdfRectangle): Boolean;
var
  Overlap, MinHeight: Double;
begin
  Overlap := Min(A.Top, B.Top) - Max(A.Bottom, B.Bottom);
  MinHeight := Min(A.Top - A.Bottom, B.Top - B.Bottom);
  Result := (MinHeight > 0) and (Overlap >= MinHeight * 0.25);
end;

procedure GroupPageIntoLines(Pdf: TPdf; out Lines: TArray<TPdfWordBoxes>);
var
  Words: TPdfWordBoxes;
  Bounds: TArray<TPdfRectangle>;   // laufende Vereinigung pro Zeile
  I, J, Found: Integer;
begin
  Words := Pdf.PageWordBoxes;            // braucht eine aktive Seite (Pdf.PageNumber)
  Lines := nil;
  Bounds := nil;
  for I := 0 to High(Words) do
  begin
    Found := -1;
    for J := High(Lines) downto 0 do
      if SameVisualLine(Bounds[J], Words[I].Rect) then
      begin
        Found := J;
        Break;
      end;
    if Found < 0 then
    begin
      SetLength(Lines, Length(Lines) + 1);
      SetLength(Bounds, Length(Bounds) + 1);
      Found := High(Lines);
      Bounds[Found] := Words[I].Rect;
    end;
    SetLength(Lines[Found], Length(Lines[Found]) + 1);
    Lines[Found][High(Lines[Found])] := Words[I];
    Bounds[Found].Left := Min(Bounds[Found].Left, Words[I].Rect.Left);
    Bounds[Found].Right := Max(Bounds[Found].Right, Words[I].Rect.Right);
    Bounds[Found].Top := Max(Bounds[Found].Top, Words[I].Rect.Top);
    Bounds[Found].Bottom := Min(Bounds[Found].Bottom, Words[I].Rect.Bottom);
  end;
  // Jede Zeile vor dem Lesen nach Rect.Left sortieren: PageWordBoxes liefert
  // Wörter in Content-Stream-Reihenfolge, die nicht der visuellen entsprechen muss
end;
Das Prädikat ist der Teil, der sich zu kopieren lohnt. Für alles über einen schnellen Dump hinaus: Beginnen Sie beim strukturierten Textmodell, das bereits Blöcke, Zeilen und eine Lesereihenfolgen-Quelle trägt, wie in strukturierter PDF-Textextraktion mit Lesereihenfolge beschrieben
Was Tabellen-Aufrufer weiterhin kontrollieren
Tabellen-Aufrufer bekommen den Korridor-Test, das Linien-zuerst-Wortfiltern und Überlappungs-basierten Zelltext, ohne ihre Optionen anzufassen. Der Korridor-Schwellenwert steht fix auf der Hälfte von MinColumnGap, der eine Wert, den Sie für die Spaltenzwischenraum-Breite justieren, regiert also beide. Die Whitespace-Strategie behält eine Untergrenze von zwei Zeilen, selbst wenn MinRows auf 1 gesetzt wird; nur die Linien-Strategie akzeptiert Einzeilen-Raster, die ExtractDocumentTables für Tabellenfragmente benutzt, die oben auf einer Seite fortgesetzt werden. Dasselbe Options-Record wandert in TPdfReflowOptions.TableOptions, also erbt Reflow-Ausgabe dieselben Entscheidungen, wenn DetectTables an ist
Der Korridor-Test entscheidet über Zeilen, die auf beiden Seiten einer Grenze Inhalt haben, ein Zweizeilen-Kandidat wird also über genau zwei solche Zeilen beurteilt. Für Archive, die überwiegend Prosa sind und selten echte Zweizeilen-Tabellen enthalten — Verträge, Korrespondenz, Essays — setzen Sie MinRows auf 3 und akzeptieren die verlorenen Zweizeilen-Tabellen. Für Finanz- und formularlastige Dokumente halten Sie den Default von 2, denn kurze echte Tabellen sind dort häufig. Linksbündiger Flattersatz behält gewöhnliche einfache Leerzeichen und produziert selten eine Lücke auch nur in der Nähe von 12 Punkten
PDF hat kein allgemeines Tabellenobjekt. ISO 32000-1 §14.8.4.3.4 definiert ein Table-Strukturelement, aber nur Tagged PDF trägt es, also ist das Raster für alles andere ein Rückschluss aus der Geometrie, und der Confidence-Wert einer Whitespace-Tabelle geht nie über 0,88 hinaus
Die Erkennungsoptionen, die TPdfTable.ToCsv- und ToJson-Serialisierung und die TableExtractionLab-Demo für Delphi, C++Builder und Lazarus sind auf der PDFium Component for Delphi-Produktseite beschrieben