Eine Tabelle, die sich über drei Seiten eines Word-Exports erstreckt, kommt nie näher als 72 Punkte an die Unterkante des Papiers. Ein-Zoll-Ränder sind 72 Punkte, und die Textverarbeitung hört auf, Zeilen am Rand zu platzieren. Ein Verknüpfer, der Fragmente nur dann zusammenschließt, wenn sie innerhalb von 36 Punkten an den Seitenkanten liegen, sieht drei unabhängige Tabellen mit identischen Spalten. Die Frage, die funktioniert, ist eine andere: Liegt irgendetwas außer einer laufenden Kopf- oder Fußzeile zwischen dem Ende eines Fragments und dem Start des nächsten?
Diese Frage bringt zwei eigene Fallen mit. Ein Formular kann eine Tabelle am Ende von Seite 1 beenden und oben auf Seite 2 eine andere Tabelle mit denselben Spaltenbreiten öffnen. Und ein liniengerastertes Gitter kann eine einzelne Zeile über den Umbruch drücken, zu kurz für einen Detektor, der zwei Zeilen will, bevor er etwas eine Tabelle nennt
Zwei Kantentests in ExtractDocumentTables
PDFium Component markiert Fortsetzungen in TPdf.ExtractDocumentTables, dem dokumentweiten Gegenstück zum seitenweisen ExtractTables, behandelt im Artikel zur Tabellenerkennung und -extraktion. Mit gesetztem DetectContinuations, wie in TPdfTableExtractionOptions.Default, extrahiert die Methode jede Seite, sortiert die Tabellen nach Seitennummer und dann auf jeder Seite von oben nach unten, und prüft jedes Nachbarpaar in dieser Liste. Verglichen werden nur Nachbarn. Ein Fortsetzungskandidat ist also stets die unterste Tabelle auf Seite N, gepaart mit der obersten auf Seite N+1, und eine kleine Tabelle unter einer langen auf Seite N nimmt in dieser Paarung den Platz der langen ein. Sitzt eine kurze Notiztabelle unter einer langen, verknüpfen Sie diese Fragmente in Ihrem eigenen Code über Seitennummern und ColumnCount
Der erste Test ist rein geometrisch. Die Unterkante des früheren Fragments muss innerhalb von ContinuationMargin Punkten der Seitenunterkante liegen, die Oberkante des späteren innerhalb desselben Abstands von der Oberkante der nächsten Seite. Der Default ist 36 Punkte, ein halber Zoll. Berichte aus Layout-Engines, die eine feste Content-Box füllen, schaffen das leicht. Ein Word-Export mit Ein-Zoll-Rändern liegt auf jeder Seite um mindestens 36 Punkte daneben, und den Rand so weit aufzuweiten, dass er besteht, geht schief, denn dieselbe Zahl setzt die Kopf- und Fußzeilenbänder des zweiten Tests
Dieser zweite Test, der inhaltsbasierte, ist der, der Textverarbeitungs-Ausgaben handhabt. Die beiden kombinieren per ODER: Einer von beiden öffnet das Tor
Was zählt als Text zwischen zwei Fragmenten?
Jedes Wort auf einer Seite zählt als Fließtext, sofern es nicht vollständig im laufenden Kopf- oder Fußzeilenband liegt; beide Bänder sind ContinuationMargin Punkte tief. Pro Seite notiert ExtractDocumentTables die unterste Unterkante unter den Wörtern, deren Oberkante über dem Fußzeilenband liegt, und die oberste Oberkante unter den Wörtern, deren Unterkante unter dem Kopfbando liegt, der eigene Zelltext der Tabelle eingeschlossen. Ist die Tabelle der letzte Fließtext-Inhalt auf Seite N, sitzt ihre Unterkante auf oder unter dem tiefsten Wort, und der Test besteht innerhalb von AlignmentTolerance, das standardmäßig 3 Punkte beträgt. Das spätere Fragment muss die Spiegelbedingung am oberen Rand von Seite N+1 erfüllen
Die Bänder zu ignorieren hat eine Grundlage in der Spezifikation. ISO 32000-1 §14.8.2.2 behandelt laufende Köpfe, Fußzeilen und Seitennummern als Paginierungs-Artefakte, Inhalt, der nur existiert, weil das Dokument in Seiten geschnitten wurde. Eine getaggte Datei kann sie mit /Artifact deklarieren, wie der Artikel zu Marked Content erklärt; die Exporte, die Tabellenflicken am dringendsten brauchen, tragen selten Tags, also vertritt die Position das Tag. Beim Default-Band wird eine Seitennummer ignoriert, deren Glyphen 30 Punkte über der Unterkante enden. Eine Haftungzeile, die bis auf 40 Punkte heranreicht, ist Fließtext und blockiert die Verknüpfung
Auf einer Seite ohne Textebene fallen die gespeicherten Extreme auf die Seitenbegrenzungen zurück, der inhaltsbasierte Test besteht trivial, und die restlichen Schranken entscheiden. Als Bilder oder Vektorumrisse gezeichnete Fußzeilen sind aus demselben Grund unsichtbar und blockieren nie eine Verknüpfung
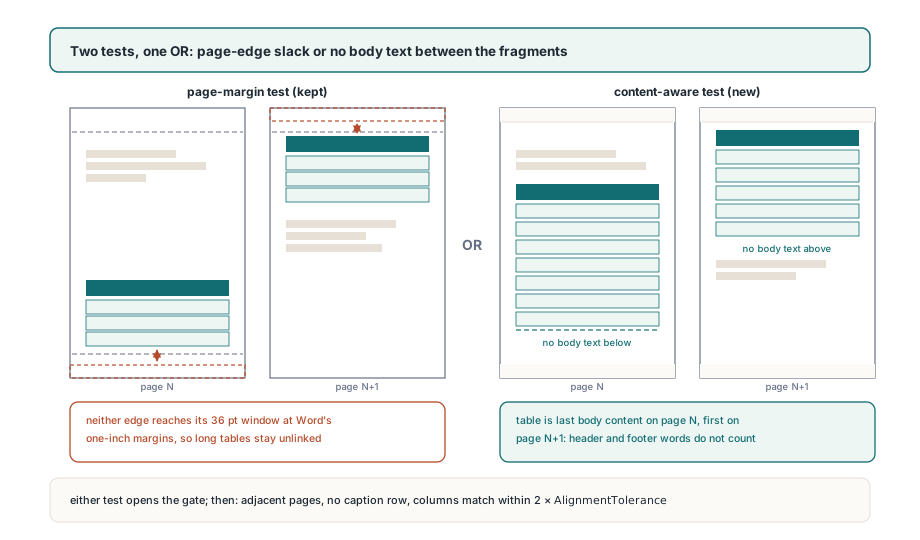
Einen Kantentest zu bestehen öffnet nur das Tor. Die Seiten müssen aufeinanderfolgen, das spätere Fragment darf nicht mit einer Überschriftzeile beginnen, und die Spaltengrenzen müssen innerhalb des Doppelten von AlignmentTolerance fluchten, bei den Defaults 6 Punkte. Hält all das, wird das frühere Fragment ptcStart mit einer frischen Gruppennummer oder wechselt von ptcEnd zu ptcMiddle, falls es bereits eine Kette schloss, und das spätere Fragment wird ptcEnd in derselben Gruppe. Eine über drei Seiten verteilte Tabelle liest sich als Start, Mitte, Ende. Gruppennummern beginnen bei 1; Gruppe 0 mit ptcNone heißt, die Tabelle steht allein. ToJson schreibt dieselben Daten als "continuationGroup" und "continuation" (none, start, middle oder end), sodass ein Dienst, der JSON empfängt, selbst flicken kann
Das Listing unten nimmt einen Word-Export mit einer rund 50 Punkte tiefen zweizeiligen Fußzeile an, deshalb geht der Rand auf 54, damit beide Zeilen im Band bleiben
uses
  System.SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;  // DetectContinuations = True
    Options.ContinuationMargin := 54;               // Fußzeile mit rund 50 pt Tiefe angenommen

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d, %d x %d',
          [Tables[I].PageNumber, Tables[I].RowCount,
           Tables[I].ColumnCount]));
      end;
  finally
    Pdf.Free;
  end;
end.
Wie eine voll breite erste Zeile zwei Tabellen auseinanderhält
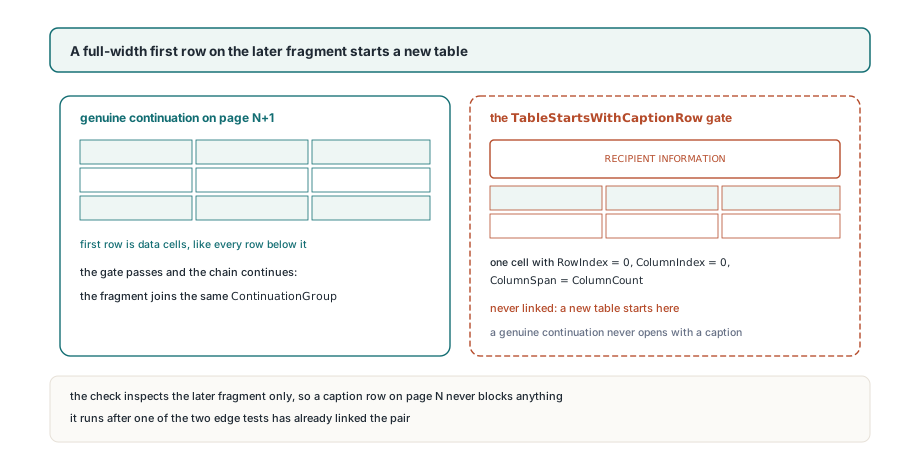
Ein späteres Fragment, dessen erste Zeile eine einzelne Zelle über alle Spalten ist, wird als neue Tabelle gemeldet, selbst wenn ein Kantentest besteht und die Spalten passen. Formulare sind der Ort, an dem der inhaltsbasierte Test übergreifen würde: Eine Tabelle endet nahe der Unterkante von Seite 1, der nächste Abschnitt öffnet auf Seite 2 mit identischen Spaltenbreiten, und jede geometrische Prüfung besteht. Der Unterschied ist die Eröffnungszeile der zweiten Tabelle, eine Abschnittsüberschrift wie RECIPIENT INFORMATION, gesetzt als eine über die volle Breite verbundene Zelle. Eine echte Fortsetzung beginnt so nicht, denn die Überschrift einer Tabelle bleibt auf der Seite, auf der die Tabelle beginnt
Die Regel liest nur die Zellen des späteren Fragments. Dieses Fragment braucht mindestens zwei Spalten und eine Zelle mit RowIndex = 0, ColumnIndex = 0 und ColumnSpan = ColumnCount. Das frühere Fragment wird nie inspiziert; eine Tabelle, deren eigene Überschrift oben auf Seite N sitzt, verknüpft sich also normal mit ihrer Fortsetzung auf Seite N+1
Der Spaltenvergleich danach ist strenger als eine gleiche Spaltenanzahl. Die Grenzpositionen jedes Fragments werden aus seinen Zellrechtecken neu gebaut; eine Grenze, die unter einer verbundenen Zelle verborgen ist, wird ergänzt, indem sie gleichmäßig zwischen den nächsten bekannten Grenzen beidseits verteilt wird. Dann wird jedes Grenzpaar verglichen, und eine Differenz über 6 Punkte weist die Verknüpfung zurück. Zwei Vier-Spalten-Tabellen mit anderen Proportionen bleiben getrennt. Ebenso eine echte Fortsetzung, deren Generator eine Spalte zwischen den Seiten um 8 Punkte verschob; AlignmentTolerance zu erhöhen, um sie zu akzeptieren, lockert auch das Clustering, das während der Erkennung verwendet wird
Eine liniengerasterte Zeile über einem Seitenumbruch
Ein liniengerastertes Gitter, das eine einzelne Zeile auf die nächste Seite drückt, behält diese Zeile, wenn es sich in eine Kette einfügt, und verliert sie, wenn es das nicht tut. Der Default-MinRows von 2 verhindert, dass ein Paar verwaister Linien als Tabelle gemeldet wird. Eine über den Umbruch gedrückte Zeile ist etwas anderes: Sie sind echte Daten, und sie fallen zu lassen, würde die zusammengefügte Tabelle um eine Zeile zu kurz machen, ohne dass ein Fragment den Abstand erklären bliebe
Der Dokumentenscan handelt das in drei Schritten ab. Sind DetectContinuations und DetectRuledTables beide an, läuft der Liniendetektor auf jeder Seite mit auf 1 gesenkter Zeilenuntergrenze. Dann werden Fortsetzungen über das Gesamtergebnis markiert. Schließlich wird jede Tabelle mit weniger Zeilen als das vom Aufrufer gesetzte MinRows entfernt, die nicht in einer Kette landete. Ein Einzeilen-Gitter mitten auf einer gewöhnlichen Seite geht durch diesen Filter und verschwindet, genau wofür MinRows da ist
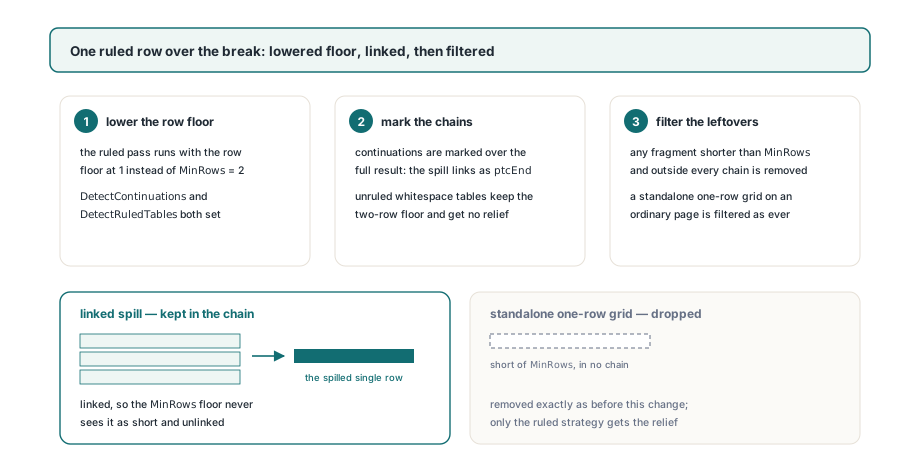
Lassen Sie MinRows auf 2. Es selbst auf 1 zu setzen, schaltet den finalen Filter ab, und jedes Einzeilen-Liniengitter auf jeder Seite kommt zurück
Die Ausnahme gilt nur für liniengerasterte Gitter. Die Whitespace-Strategie braucht mindestens zwei fluchtende Zeilen, um eine Tabelle zu erkennen; sie hält eine interne Untergrenze von 2, was auch immer MinRows sagt; ExtractTables akzeptiert MinRows = 1, aber nur die Linienerkennung ehrt es. Bei einer unlinierten Tabelle, die eine Zeile überläuft, geben Ihnen die Wortboxen der Seite oder die in strukturierten Textblöcken und Lesereihenfolge beschriebenen Blöcke die Positionen, um diese Zeile selbst zurückzuholen
Eine Kette zurück zu einer Tabelle zusammenfügen
Ketten kommen zusammenhängend zurück. Verknüpfungen entstehen nur zwischen Nachbarn im sortierten Array; auf ein ptcStart-Fragment folgen also direkt seine ptcMiddle- und ptcEnd-Fragmente, und eine Schleife, die bei ptcNone oder ptcStart zurücksetzt und bei ptcNone oder ptcEnd ausschreibt, muss nie etwas über Gruppennummern nachschlagen
Die wiederholte Kopfzeile ist der knifflige Teil: Word kann sie auf jeder Seite wiederholen, andere Generatoren tun es nicht. Das IsHeader-Flag an TPdfTableCell kann das nicht entscheiden, denn es wird nach Position vergeben, RowIndex < HeaderRowCount, getrennt für jedes Fragment. Zeile 0 einer Fortsetzung ist als Kopfzeile markiert, ob sie die Kopfzeile wiederholt oder Daten trägt, und der Einzeilen-Überlauf aus dem vorigen Abschnitt ist es ebenfalls. Die Routine unten vergleicht den Text der ersten Zeile jeder Fortsetzung mit der ersten Zeile der Kette und lässt sie nur bei exakter Übereinstimmung fallen
Sie baut Zeilen außerdem aus Cells, statt die ToCsv-Ausgabe in Zeilen zu splitten. Eine Zelle, deren Text in der Zelle umbricht, kommt mit einem CR LF zwischen ihren Sichtzeilen zurück, ToCsv hält diesen Umbruch innerhalb des quotierten Felds, und die erste Zeile des CSV-Texts zu löschen, würde eine zweizeilige Kopfzelle halbieren
// Reader-seitige Helper (nicht Teil der Bibliothek): jede Kette als eine
// tab-getrennte Datei neu bauen, auf Folgeseiten wiederholte Kopfzeilen fallen lassen
function RowText(const T: TPdfTable; Row: Integer): string;
var
  Parts: array of string;
  I: Integer;
begin
  SetLength(Parts, T.ColumnCount);
  for I := 0 to High(T.Cells) do
    if (T.Cells[I].RowIndex = Row) and (T.Cells[I].ColumnIndex >= 0) and
       (T.Cells[I].ColumnIndex < T.ColumnCount) then
      Parts[T.Cells[I].ColumnIndex] :=
        StringReplace(string(T.Cells[I].Text), #13#10, ' ', [rfReplaceAll]);
  Result := '';
  for I := 0 to High(Parts) do
  begin
    if I > 0 then
      Result := Result + #9;
    Result := Result + Parts[I];
  end;
end;

procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R, FirstRow: Integer;
  Header: string;
  Lines: TStringList;
begin
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      FirstRow := 0;
      if Tables[I].Continuation in [ptcNone, ptcStart] then
      begin
        Lines.Clear;
        Header := RowText(Tables[I], 0);
      end
      else if (Trim(Header) <> '') and (RowText(Tables[I], 0) = Header) then
        FirstRow := 1;                     // auf dieser Seite wiederholte Kopfzeile
      for R := FirstRow to Tables[I].RowCount - 1 do
        Lines.Add(RowText(Tables[I], R));
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Lines.SaveToFile(Format('%s\table%d-page%d.tsv',
          [Folder, I, Tables[I].PageNumber]));
    end;
  finally
    Lines.Free;
  end;
end;
Der exakte Vergleich ist die richtige Wahl. Eine von der Textverarbeitung wiederholte Kopfzeile matcht Zeichen für Zeichen, während ein unscharfer Match irgendwann eine Datenzeile verschlucken würde, die der Kopfzeile ähnelt. Eine verirrte zusätzliche Kopfzeile ist in der Ausgabe leicht zu erkennen; eine fehlende Datenzeile nicht
Das Fußzeilenband messen statt raten
ContinuationMargin macht drei Jobs mit einer Zahl: Seitennaht für den ersten Test, Fußzeilenbandtiefe und Kopfbandtiefe für den zweiten. Eine tiefere Fußzeile als das Band lässt ihre obere Zeile in der Fließtext-Zone zurück; das frühere Fragment wirkt, als folge ihm Text, und die Kette bricht an dieser Seite. Ein zu tief gesetztes Band beginnt, echten Inhalt zu verschlucken: Eine kurze Abschlusszeile knapp über dem unteren Rand fällt hinein, und die Tabelle über dieser Zeile kann sich dann mit allem verknüpfen, was die nächste Seite eröffnet
Das Dokument selbst kann die Zahl liefern. TPdf.PageWordBoxes liefert jedes Wort der aktuellen Seite mit einem seitenräumlichen Rect, dessen Top größer als sein Bottom ist; das höchste Top unter den Wörtern unterhalb des Fließtextrands ist also die Fußzeilentiefe. Die Sonde unten nimmt einen Wert knapp unter dem unteren Layout-Rand, 70 für eine Ein-Zoll-Seite, und behält 36 Punkte als Untergrenze für Dokumente ohne Fußzeile
// Reader-seitiger Helper (nicht Teil der Bibliothek): das höchste Wort-Top,
// das auf irgendeiner Seite unter BodyMargin gefunden wird, also die Tiefe der Fußzeilenzone
function MeasureFooterDepth(Pdf: TPdf; BodyMargin: Double): Double;
var
  P, I: Integer;
  Words: TPdfWordBoxes;
begin
  Result := 0;
  for P := 1 to Pdf.PageCount do
  begin
    Pdf.PageNumber := P;
    Words := Pdf.PageWordBoxes;
    for I := 0 to High(Words) do
      if (Words[I].Rect.Bottom < BodyMargin) and
         (Words[I].Rect.Top > Result) then
        Result := Words[I].Rect.Top;
  end;
end;

// nutzt System.Math für Max
Options := TPdfTableExtractionOptions.Default;
Options.ContinuationMargin := Max(36.0, MeasureFooterDepth(Pdf, 70) + 2);
Tables := Pdf.ExtractDocumentTables(Options);
Das Band ist an beiden Enden gleich tief; messen Sie deshalb auch einen tiefen laufenden Kopf gegen die Seitenoberkante und nehmen Sie den größeren Wert. Halten Sie die Zugabe bei ein paar Punkten; jeder zusätzliche Punkt ist ein Punkt Fließtext, den der inhaltsbasierte Test nicht mehr sieht
Ein Layout besiegt die Überschriftenregel per Konstruktion: ein Generator, der ein verbundenes „continued“-Banner als erste Zeile jedes Fortsetzungs-Fragments schreibt. Jedes solche Fragment wird als neue Tabelle gemeldet; verknüpfen Sie sie in Ihrem eigenen Code über fortlaufende Seitennummern, gleiche ColumnCount und den Bannertext in Zeile 0
Die Fortsetzungsmarkierung, die Überschriftenregel und die Einzeilen-Ausnahme laufen alle in ExtractDocumentTables, das sich in den Delphi-, C++Builder- und Lazarus-Builds gleich verhält. Die vollständige Liste der Tabellenextraktions-Optionen steht auf der PDFium Component for Delphi-Seite