Objektnummer 1 ist nicht Seite 1. Diese eine Tatsache bringt mehr PDF-verarbeitenden Code zum Stolpern als jeder andere Teil des Formats, und der Grund zeigt sich erst, wenn man aufhört, darauf zu schauen, was ein Viewer rendert, und anfängt, den Objektgraphen zu betrachten, den der Viewer tatsächlich liest
Eine PDF-Datei ist eine Sammlung nummerierter indirekter Objekte. Jedes trägt eine Objektnummer und eine Generationsnummer, und andere Objekte zeigen mit einer Referenz der Form N G R darauf – 3 0 R meint die aktuelle Version von Objekt 3. Seiten sind Objekte wie jede andere, aber wo sie in der Datei sitzen und welche Nummern sie tragen, sagt nichts über die Anzeigereihenfolge. Die Reihenfolge kommt aus dem /Pages-Baum. Wer Objekte numerisch durchscannt, assembliert bei einem ordentlichen Anteil realer Dateien die Seiten in der falschen Reihenfolge
Im Baum steckt auch eine Menge weniger offensichtliches Verhalten. Seine Form entscheidet, wie schnell ein Viewer zu Seite 8.214 springen kann, seine inneren Knoten reichen Seitengröße und Schriften stillschweigend an die Blätter unter ihnen weiter, und die /Count-Summen, die die ganze Struktur schnell machen, werden von nichts durchgesetzt. Wir gehen durch alle drei, angefangen mit der Reihenfolge selbst
Der Seitenbaum legt die Reihenfolge fest
Jedes PDF hat einen Dokumentkatalog (ISO 32000-2 §7.7.2), und der /Pages-Eintrag des Katalogs zeigt auf den Wurzelknoten des Seitenbaums. Diese Wurzel ist ein Dictionary mit /Type /Pages, einem /Kids-Array aus indirekten Referenzen und einem /Count, der die Zahl der Blattseiten darunter angibt. Die Anzeigereihenfolge ist ein Tiefendurchlauf von links nach rechts durch diesen Baum. Das ist die ganze Regel
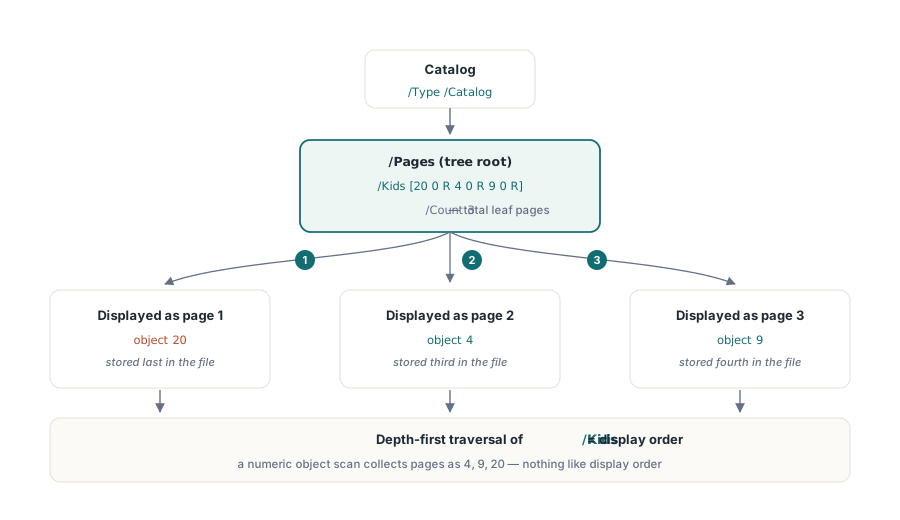
Eine minimale Drei-Seiten-Datei macht das konkret:
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% Objekt 4 steht dritt in der Datei, ist aber Seite 2 in der Anzeigereihenfolge
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% Objekt 9 steht viert, ist aber Seite 3
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% Objekt 20 steht zuletzt, ist aber Seite 1; Kids[0] entscheidet, nicht die Objektnummer
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj
Das /Kids-Array liest sich [20 0 R 4 0 R 9 0 R], also ist Objekt 20 Seite 1, Objekt 4 ist Seite 2 und Objekt 9 ist Seite 3. Code, der Objekte in numerischer Reihenfolge durchläuft und alles mit /Type /Page einsammelt, bekommt diese Datei falsch. Schlimmer noch: Die Ausgabe sieht trotzdem plausibel aus – richtige Seitenzahl, erkennbarer Inhalt auf jeder Seite, falsche Reihenfolge
Generatoren erzeugen solche Layouts aus ganz gewöhnlichen Gründen. Eine Bibliothek, die vorab Objektnummern für alle Seiten reserviert, nummeriert sie in Erstellungsreihenfolge und schreibt die Bytes dann in der Reihenfolge, die ihrem Serializer passt. Ein Merge-Tool nummeriert die Objekte jedes Quelldokuments um, um Kollisionen zu vermeiden, also landen die Seitenobjekte verstreut in der kombinierten Objekttabelle, während das neue /Kids-Array der Wurzel die korrekte Reihenfolge hält. Und inkrementelle Updates hängen neue Objekte mit frischen Nummern ans Dateiende, sodass eine in einer Revision hinzugefügte Seite nahe am Ende des Byte-Stroms liegt, selbst wenn sie an Position 1 gehört
Genau der letzte Fall beißt zu. Ein Testkorpus aus einem einzigen Tool kann komplett bestehen, und dann kommen Dateien aus einem Merge-Workflow oder Dokumente, die ein paar Revisionen durchlaufen haben, durcheinander heraus. Heuristische Fixes halten nicht, denn das Versagen hängt vom Generator und von der Bearbeitungshistorie der Datei ab. Die echte Lösung ist kurz: Beim Katalog starten, /Pages auflösen, /Kids rekursiv durchlaufen und die Blätter in der Reihenfolge ausgeben, in der man ihnen begegnet. Unsere Fallstudie zum Debuggen der Seitenreihenfolge verfolgt genau dieses Symptom über eine Fehldiagnose bis zur Ursache, mit dem rekursiven Traversierungscode und qpdf-Schritten zur Kontrolle des Ergebnisses
Fan-Out ist eine Performance-Entscheidung
Die Spezifikation erlaubt zwei Formen. Schlichte Generatoren emittieren einen flachen Baum, einen einzigen Wurzel-/Pages-Knoten, dessen /Kids nichts außer /Page-Blättern hält. Nichts zwingt einen Writer zur Verschachtelung, und ein Dokument mit 10.000 Seiten und 10.000 Blattverweisen in einem einzigen Array ist konform. Die PDF-Referenz empfiehlt dennoch einen ausbalancierten Baum für große Dokumente, und gängige Generatoren folgen diesem Rat mit einem moderaten Fan-Out – typischerweise ein paar Dutzend Kinder pro Zwischenknoten, wobei jeder Zwischenknoten sein eigenes /Kids und seinen eigenen /Count hat
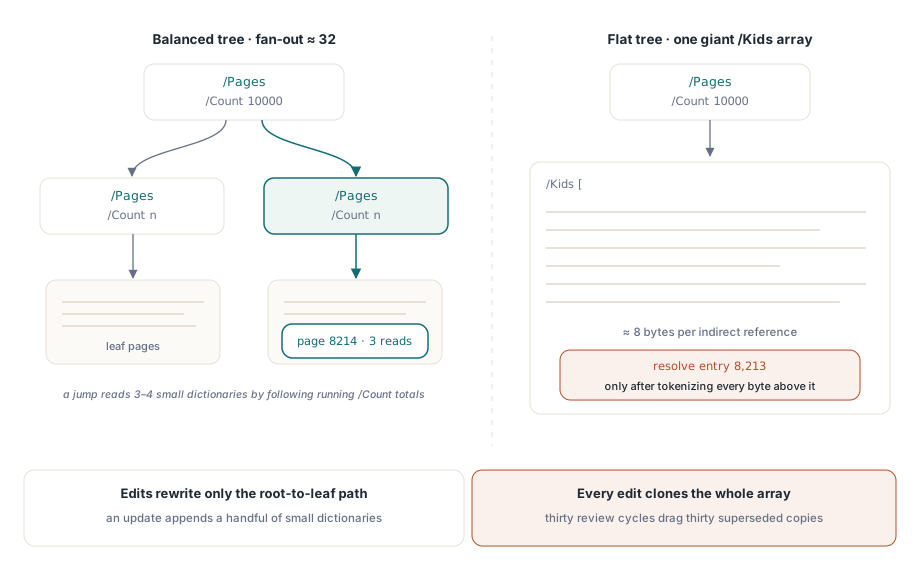
Der Grund liegt darin, was ein Viewer lesen muss, bevor er überhaupt etwas anzeigen kann. Nehmen wir einen direkten Sprung zu Seite 8.214 dieser 10.000-Seiten-Datei. Bei einem flachen Baum muss der Viewer zunächst den Wurzelknoten parsen, und dieser Wurzelknoten ist ein einziges riesiges Array: bei rund acht Byte pro indirekter Referenz ein 80-KB-Objekt, das vollständig tokenisiert werden muss, bevor Eintrag 8.213 aufgelöst werden kann. Bei einem ausbalancierten Baum mit Fan-Out 32 liest derselbe Sprung die Wurzel, vergleicht laufende /Count-Summen, um das richtige Kind auszuwählen, und steigt ab — insgesamt drei oder vier kleine Dictionaries, jedes nur wenige hundert Byte groß. Das ist der O(log n)-Direktzugriff, für den der Baum entworfen wurde, und es ist der ganze Grund, warum /Count an Zwischenknoten existiert: Er erlaubt einem Reader, einen kompletten Teilbaum zu überspringen, ohne auch nur ein einziges Objekt darin zu öffnen
Die Baumform bestimmt auch die Kosten des Bearbeitens. Ein inkrementelles Update, das eine Seite einfügt, muss jeden Knoten neu schreiben, dessen /Kids oder /Count sich geändert hat – also den Pfad vom Elternknoten des neuen Blatts bis zur Wurzel. In einem ausbalancierten Baum ist dieser Pfad eine Handvoll kleiner Dictionaries, die an die Datei angehängt werden. In einem flachen Baum ist der „Pfad“ das riesige Wurzel-Array, das bei jeder Revision vollständig dupliziert wird. Ein Vertrag, der dreißig Prüf- und Kommentierungszyklen durchläuft, kann am Ende dreißig überholte Kopien desselben 80-KB-Arrays in seinem Byte-Strom mitschleppen
Für verarbeitenden Code hat Verschachtelung eine drastischere Folge. Man kann nicht annehmen, dass die erste Ebene von /Kids Seiten enthält, also muss jedes Kind geprüft werden: /Type /Pages heißt rekursieren, /Type /Page heißt Blatt. Code, der nach der ersten Ebene aufhört, funktioniert auf jeder flachen Datei, der er begegnet, und lässt dann beim ersten Generator, der sich für Verschachtelung entscheidet, stillschweigend ganze Teilbäume fallen
Innere Knoten tragen vererbte Attribute
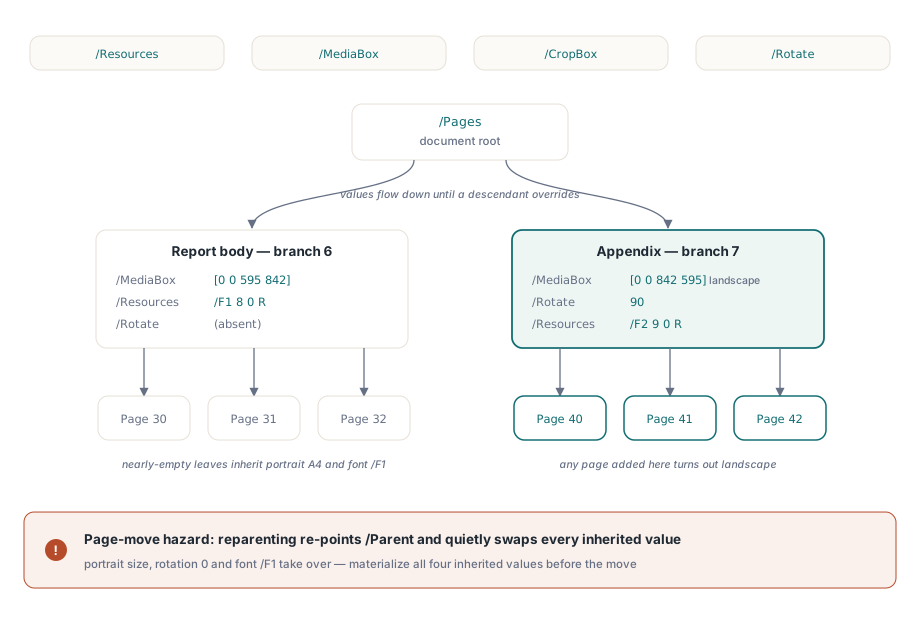
Zwischenknoten dienen nicht nur der Weiterleitung. Vier Seitenattribute sind vererbbar (ISO 32000-2 §7.7.3.4): /Resources, /MediaBox, /CropBox und /Rotate. Jedes davon darf auf einem /Pages-Knoten sitzen, wo es für jedes Blatt darunter gilt, sofern kein Nachfahre es überschreibt. Ein Writer, der einen Bericht mit einem Anhang im Querformat erzeugt, kann dieses Layout direkt im Baum ausdrücken:
5 0 obj   % Dokumentwurzel
<< /Type /Pages /Count 6 /Kids [6 0 R  7 0 R] >>
endobj

6 0 obj   % Berichtskörper: Hochformat A4, Fließtextschrift
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [30 0 R  31 0 R  32 0 R]
   /MediaBox [0 0 595 842]
   /Resources << /Font << /F1 8 0 R >> >> >>
endobj

7 0 obj   % Anhang: Querformat A4, gedreht, eigene Schrift
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [40 0 R  41 0 R  42 0 R]
   /MediaBox [0 0 842 595] /Rotate 90
   /Resources << /Font << /F2 9 0 R >> >> >>
endobj

40 0 obj  % Anhangseite: erbt Größe, Drehung, Schriften
<< /Type /Page /Parent 7 0 R /Contents 43 0 R >>
endobj
Die Objekte 40 bis 42 sind fast leer. Seitengröße, Drehung und Schriftressourcen kommen alle von Knoten 7, was die Datei kompakt und selbstwartend hält: Fügt man eine vierte Seite unter dem Anhangsknoten hinzu, kommt sie im Querformat heraus, ohne dass irgendwer sie anfasst
Es bedeutet auch, dass die Eigenschaften einer Seite nicht alle auf der Seite liegen. Objekt 40 hat keinen /MediaBox-Schlüssel, und das ist völlig legal – ein Reader, der den fehlenden Schlüssel als fehlerhafte Eingabe behandelt, weist gültige Dateien zurück. Die Suche muss die /Parent-Kette hinaufgehen, bis sie den Eintrag findet oder die Wurzel erreicht. Dieser Weg braucht einen Zyklusschutz. Eine beschädigte Datei kann eine /Parent-Referenz tragen, die auf einen bereits besuchten Knoten zurückzeigt, und ohne ein Set besuchter Objekte dreht die Suche sich für immer
Derselbe Mechanismus erzeugt die klassische Gefahr beim Verschieben von Seiten. Angenommen, ein Tool verschiebt Objekt 40 in den Berichtskörper, indem es die beiden /Kids-Arrays bearbeitet und /Parent auf Knoten 6 umbiegt. Die Verschiebung ist strukturell gültig, doch Objekt 40 erbt nun die Hochformat-/MediaBox, keine Drehung und die Schrift /F1 — während sein Content-Stream weiterhin /F2 auswählt, das sich nicht mehr auflösen lässt. Die Seite schrumpft, verliert ihre Drehung und ihren Text in einer einzigen Bearbeitung. Robuster Umordnungscode materialisiert daher die aufgelösten Werte aller vier vererbbaren Attribute auf dem Seiten-Dictionary, bevor er es neu verankert. Wer schon einmal eine Seite in einem Editor gezogen und dabei ihre Größe oder Ausrichtung sich ändern gesehen hat, hat genau diesen Mechanismus beobachtet
Abflachen: legal, üblich, gelegentlich teuer
Viele Tools gehen den umgekehrten Weg. Minimale Writer erzeugen einen einstufigen Baum, weil das einfach ist, und viele Zusammenführungs- und Aufteilungswerkzeuge bauen jeden gelesenen Baum in ein einziges flaches /Kids-Array um, weil das Erzeugen einer ausbalancierten Struktur zusätzliche Arbeit ist und flache Ausgabe immer konform ist. Ein korrekter Neuaufbau muss dabei gleichzeitig die Vererbung auflösen: Jedes Attribut, das ein Blatt geerbt hat, muss auf das Blatt kopiert oder — falls im ganzen Dokument einheitlich — auf die neue Wurzel gehoben werden, sonst verändert die Ausgabe die Geometrie genau wie im Fall des Seitenverschiebens
Bei typischen Dokumenten ist das Abflachen harmlos. Es schadet erst in großem Maßstab, auf die beiden bereits beschriebenen Arten: Das Wurzel-Array wird zu einem großen Objekt, das jedes Öffnen und jeder Seitensprung vollständig parsen muss, und jede strukturelle Bearbeitung schreibt es komplett neu. Was das Abflachen nicht zerstört, ist die Deduplizierung über indirekte Referenzen — ein flacher Baum, in dem alle 10.000 Seiten auf dasselbe /Resources-Dictionary-Objekt zeigen, bleibt weiterhin dedupliziert. Verloren geht nur die Möglichkeit, den Eintrag auf der Seite wegzulassen und ihn von einem Vorfahren liefern zu lassen
Wenn /Count lügt
/Count ist reine Buchführung: Er muss der Anzahl der Blattseiten im Teilbaum des Knotens entsprechen, und nichts im Dateiformat erzwingt das. Zwei Beschädigungsmuster erklären die meisten der in freier Wildbahn beobachteten lügenden Zähler
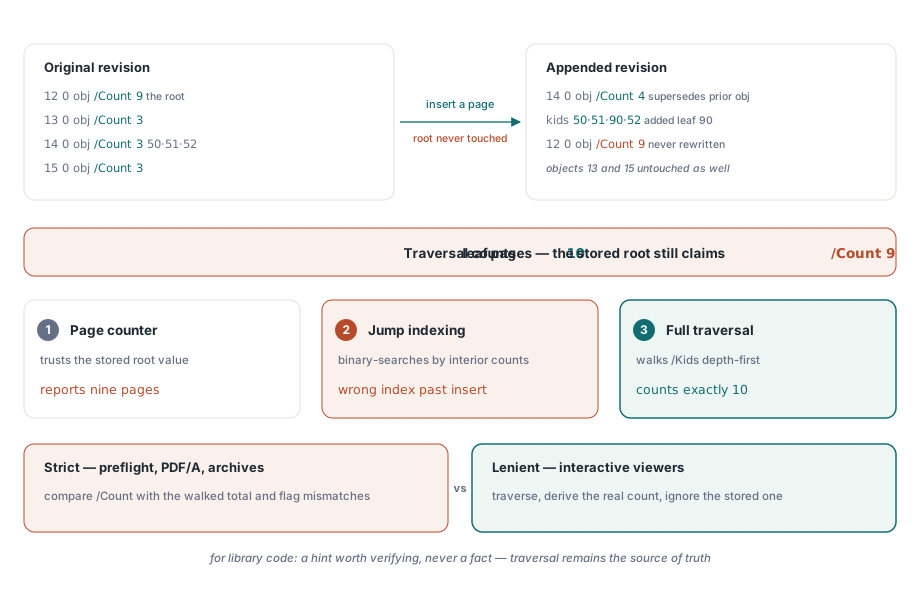
Das erste ist der veraltete Zähler, der von einem inkrementellen Update zurückgelassen wird. Ein Editor fügt eine Seite ein, schreibt den unmittelbaren Elternknoten mit neuem /Kids und aktualisiertem /Count neu, hängt beides an die Datei an — und rührt die Vorfahren nie an:
% Ursprüngliche Revision
12 0 obj
<< /Type /Pages /Count 9 /Kids [13 0 R  14 0 R  15 0 R] >>
endobj

14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 3
   /Kids [50 0 R  51 0 R  52 0 R] >>
endobj

% Angehängte Revision: eine Seite wurde in den mittleren Zweig eingefügt.
% Objekt 14 wird ersetzt; Objekt 12 wird nie neu geschrieben
14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 4
   /Kids [50 0 R  51 0 R  90 0 R  52 0 R] >>
endobj
Der Baum enthält jetzt zehn Blätter, aber die Wurzel sagt weiterhin neun. Ein Viewer, der der Wurzel vertraut, meldet neun Seiten in seiner Seitenanzeige. Einer, der innere Zähler für eine binäre Suche beim Seitensprung nutzt, berechnet für jede Seite nach dem Einfügepunkt einen falschen Index. Ein vollständiger Durchlauf findet zehn. Drei verschiedene Antworten, eine Datei
Es gibt einen leiseren Weg, an derselben Datei zu scheitern. Code, der den Wurzelzähler liest, den Baum durchläuft und aufhört, sobald er so viele Seiten gesammelt hat, wie der Zähler verspricht, sieht Seite zehn nie. Keine Exception, keine Warnung, nur ein Dokument, das eine Seite zu kurz ist. /Count als Schleifengrenze oder Bounds-Check zu verwenden ist der Fehler; der Durchlauf muss laufen, bis der Baum erschöpft ist, was auch immer die gespeicherte Zahl sagt
Das zweite Muster ist der Zähler, der niemals richtig sein konnte: negativ, null bei einem gefüllten Knoten oder absurd riesig. Diese stammen aus Fuzzing, aus Übertragungsschäden und gelegentlich aus Rechenfehlern in Editoren. Sie sind speziell für Code gefährlich, der /Count für die Allokation vertraut — ein Array anhand eines /Count von -3 zu dimensionieren, löst bestenfalls einen Bereichsfehler aus, und dasselbe mit einem /Count von zwei Milliarden zu tun, ist eine Denial-of-Service-Allokation. Der Wert ist nicht vertrauenswürdige Eingabe, wie jede andere Zahl in der Datei
Parser teilen sich in zwei Lager. Strikte Konsumenten – Preflight-Tools, PDF/A-Validatoren, Archivierungspipelines – vergleichen /Count mit dem Ergebnis des Durchlaufs und weisen die Datei zurück oder markieren sie. Interaktive Viewer sind fast durchweg tolerant: Sie durchlaufen den Baum, ermitteln den tatsächlichen Zähler und ignorieren den gespeicherten Wert stillschweigend – genau deshalb kann eine Datei mit veraltetem Zähler jahrelang unbeanstandet kursieren, bis sie in einem automatisierten Workflow auf einen strikteren Parser trifft. Für Bibliothekscode halten wir den Mittelweg für den richtigen Standard: /Count als Hinweis für die Vorabreservierung verwenden, und für das Überspringen von Teilbäumen, sobald er verifiziert ist, während der Durchlauf die maßgebliche Quelle bleibt
In Produktion kündigen sich diese Fehler selten als Baumprobleme an. Sie zeigen sich als durcheinandergebrachte Seiten, einer fehlenden Seite am Ende eines Merge oder einer Seite, die nach einer Umordnung ihre Größe oder Ausrichtung wechselt. Die Fallstudie zum Debuggen verfolgt einen solchen Bericht durch den Baum zurück. Für die umliegende Dateianatomie (Objekte, Cross-Reference-Daten, Trailer) ist der Überblick über die PDF-Dateistruktur der richtige Einstieg
Die HotPDF Delphi Component übernimmt all das intern: Sie durchläuft verschachtelte Bäume beliebiger Tiefe, löst vererbte Attribute auf, wenn Seiten kopiert oder verschoben werden, und verifiziert /Count gegen die tatsächliche Blattzahl, statt ihm zu vertrauen, sodass Seitenindizes in ihrer API immer logische Seiten bedeuten