Das klassische Symptom sieht nach einem Off-by-one aus: Eine Seitenkopieroutine bittet um Seite 1 eines dreiseitigen Dokuments und bekommt konsequent Seite 2. Die Indexlogik hält der Prüfung stand. Der Aufruf verwendet einen 0-basierten logischen Index, die Arithmetik stimmt, die Randbedingungen sind sauber. Trotzdem kommt jedes Mal die falsche Seite heraus
Die Ursache liegt überhaupt nicht im Kopiercode. Sie liegt darin, wie der Loader sein Seiten-Array aufbaut, und sie ist eine der leichtesten Fallen beim PDF-Parsing, in die man tappen kann
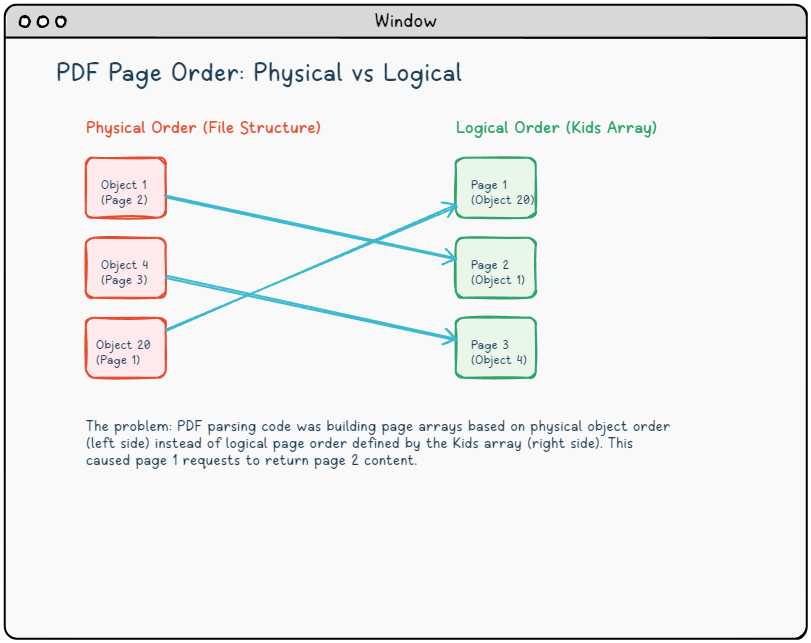
Zwei Ordnungen, eine Quelle der Verwirrung
Eine PDF-Datei ist eine Sammlung indirekter Objekte, jedes identifiziert durch eine Objektnummer. Die Dateistruktur verpflichtet diese Nummern zu nichts, was die Lesereihenfolge angeht. Objekt 1 kann Seite 2 enthalten; Objekt 20 kann Seite 1 enthalten. Was tatsächlich die Lesereihenfolge definiert, ist der Seitenbaum: eine Hierarchie von /Pages-Dictionaries, deren /Kids-Arrays Seitenreferenzen in der Sequenz listen, in der ein Viewer sie anzeigen soll (ISO 32000-1 §7.7.3)
Hier ist ein Seitenbaum, der die Falle offenlegt:
{ Pages-Baumwurzel, Objekt 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { logische Seite 1 }
         1 0 R    { logische Seite 2 }
         4 0 R]   { logische Seite 3 }
>>
endobj
Die Datei listete Objekt 1 und Objekt 4 im Bytestrom zufällig vor Objekt 20 auf. Jeder Parser, der indirekte Objekte in Dateireihenfolge durchläuft und sie beim Finden von Seiten-Dictionaries in ein PageArr einträgt, landet bei Objekt 1 an Index 0, Objekt 4 an Index 1 und Objekt 20 an Index 2. Logische Seite 1 sitzt in PageArr[2]. Die Anfrage nach Seitenindex 0 holt stattdessen logische Seite 2
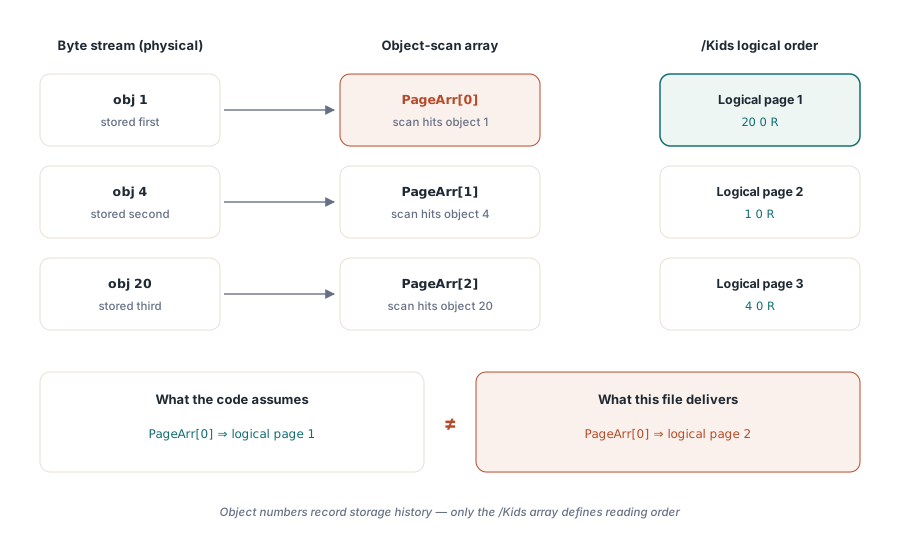
Die Hypothese bestätigen
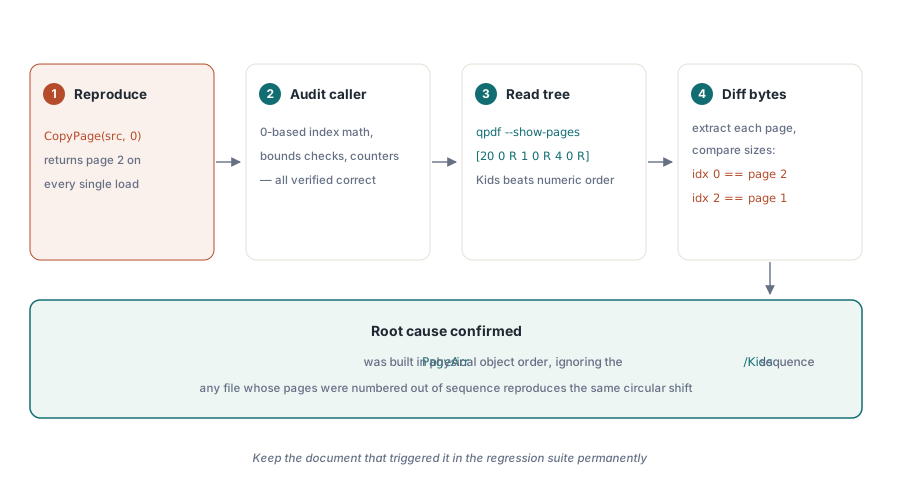
Bevor Sie Code ändern, beweisen Sie die Diskrepanz, statt sie anzunehmen. Das Kommandozeilenwerkzeug qpdf macht das unkompliziert:
{ Shell }
qpdf --show-pages input.pdf
{ Die Ausgabe enthüllt die Kids-Reihenfolge: 20 0 R, dann 1 0 R, dann 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ Zeigt das Pages-Dictionary mit /Kids in Lesereihenfolge }
Das separate Extrahieren jeder Seite und der Vergleich der Dateigrößen bestätigt das Mapping: Was ein Objekt-Scan als PageArr[0] liefert, ist der Inhalt von logischer Seite 2, und PageArr[2] hält logische Seite 1. Die zirkuläre Verschiebung ist der heiße Verdächtige. Sie erklärt auch, warum das Symptom über viele verschiedene Quelldokumente hinweg auftaucht: Jedes PDF, dessen Seitenobjekte zufällig niedrigere Objektnummern tragen als eine frühere logische Seite, löst es aus
Es gibt einen naheliegenden Grund, warum PDFs in diesen Zustand geraten. Ein inkrementelles Update behält die Objektnummern der Objekte, die es ändert, aber alles, was es hinzufügt — etwa ein vorn eingefügtes Deckblatt — bekommt eine neue Nummer über allem, was bereits in der Datei ist, während seine Referenz an den Anfang des Kids-Arrays rückt. Werkzeuge, die Dokumente zusammenführen oder umorganisieren, nummerieren Objekte in der Reihenfolge um, die ihnen passt. Manche Generatoren schreiben Seiten einfach in der Reihenfolge, die für das Streaming der Inhalte günstig ist, nicht in logischer Seitensequenz. Das PDF-Format verlangt von keinem davon das Gegenteil
Der richtige Ansatz: dem Kids-Array folgen
Bauen Sie die Seitenliste, indem Sie der /Kids-Kette von der Catalog-Wurzel aus folgen, nicht indem Sie indirekte Objekte scannen. Der Durchlauf muss rekursiv sein, weil ein großes Dokument seine Seiten gewöhnlich über Zwischen-/Pages-Knoten verteilt, und er sollte sich gegen einen fehlerhaften Baum absichern, der auf einen eigenen Vorfahren zurückzeigt. Im Entwurf unten stehen TPdfDict und TPdfArray für die Dictionary- und Array-Typen Ihres Parsers:
type
  TPageList = array of TPdfDict;

procedure CollectPages(Node: TPdfDict; var Pages: TPageList;
  Depth: Integer = 0);
var
  Kids: TPdfArray;
  Child: TPdfDict;
  I: Integer;
begin
  if Depth > 64 then  // ein Zyklus oder ein pathologisch tiefer Baum
    raise EPdfError.Create('Page tree too deep or cyclic');
  Kids := Node.GetArray('Kids');
  if Kids = nil then
    Exit;
  for I := 0 to Kids.Count - 1 do
  begin
    Child := Kids.ResolveDict(I);  // der indirekte Referenz folgen
    if Child = nil then
      Continue;
    if Child.GetName('Type') = 'Pages' then
      CollectPages(Child, Pages, Depth + 1)  // Zwischenknoten
    else
    begin
      SetLength(Pages, Length(Pages) + 1);   // Blatt: nächste Seite in Anzeigereihenfolge
      Pages[High(Pages)] := Child;
    end;
  end;
end;

// Verwendung: beim /Pages-Eintrag des Catalog starten
SetLength(Pages, 0);
CollectPages(Catalog.ResolveDict('Pages'), Pages);
if Length(Pages) <> Catalog.ResolveDict('Pages').GetInteger('Count') then
  LogWarning('Page tree /Count disagrees with the pages actually found');
Zwei Details sind absichtlich so. Ein Blatt ohne /Type-Eintrag wird trotzdem als Seite behandelt, weil manche Writer ihn weglassen und Viewers diese Dateien trotzdem öffnen. Und der abschließende /Count-Vergleich kostet nichts, fängt aber abgeschnittene oder von Hand editierte Bäume, bevor ein Aufrufer sie indiziert
Wenn Sie Dokumente mit HotPDF laden, ist diese Ordnung beim Laden bereits aufgelöst: Seitenindizes folgen der Anzeigereihenfolge des Seitenbaums, eingeschlossen verschachtelter /Pages-Knoten, sodass Index 0 immer die erste Seite ist, die ein Viewer zeigt. Der Durchlauf oben ist relevant, wenn Ihr eigener Code die PDF-Struktur direkt parst
Kopieren über logische Indizes mit CopyPageFromDocument
Weil HotPDF die Seitenreihenfolge beim Laden auflöst, bedeuten logische Seitenindizes genau das, was Aufrufer erwarten. Das höher gelegene CopyPageFromDocument nimmt einen 0-basierten logischen Index und kopiert die richtige Seite in das Zieldokument:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { Logische Seite 0 kopieren (die erste Seite, die der Nutzer sieht) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
Weil der Index ein Anzeigereihenfolge-Index ist, verhält sich CopyPageFromDocument auch bei Dokumenten korrekt, bei denen physische und logische Ordnung auseinanderlaufen. Für Batch-Operationen nimmt InsertPagesFromDocument ein Array logischer Indizes entgegen und kopiert sie in einem Durchlauf
Was das über das PDF-Parsing verrät
Die PDF-Spezifikation ist eindeutig: Die logische Seitenreihenfolge wird durch das /Kids-Array des Seitenbaums definiert, nicht durch Objektnummern oder Byte-Offsets (ISO 32000-1 §7.7.3.2). Jeder Parser, der eine andere Ordnung als Abkürzung verwendet, liefert bei der Mehrheit der Dokumente korrekte Ergebnisse, weil die meisten Generatoren Seiten in natürlicher Reihenfolge schreiben und sequenzielle Objektnummern vergeben. Der Fehler versteckt sich, bis jemand ein PDF lädt, das inkrementell editiert, von einem anderen Werkzeug umorganisiert oder von Software erzeugt wurde, die ein anderes Layout wählte
Wer nur gegen selbst erzeugte PDFs testet, verpasst diese Problemklasse komplett. Die Behandlung der Seitenreihenfolge braucht ein Testkorpus aus Dokumenten unterschiedlichster Quellen: inkrementelle Speicherungen, gescannte Dokumente mit eingefügten Deckblättern, PDFs von Werkzeugen, die den Objektgraphen anders linearisieren oder optimieren. Jedes Dokument, dessen physische und logische Ordnung auseinanderlaufen, verdient einen festen Platz in diesem Korpus
Die Seite der HotPDF Delphi Component deckt die komplette API für Seitenoperationen ab, einschließlich CopyPageFromDocument, InsertPagesFromDocument und MovePage