Ein Delphi-Loader, der ein XLSX-Paket mit acht Blättern auf acht Worker-Threads parst, kann eine CPU-Kurve zeigen, die kaum über einen Kern hinaus steigt, und ein Sweep der Thread-Zahl von zwei bis acht lässt die Stoppuhr fast dort, wo sie war. Mit zwei Threads kann das Laden sogar langsamer ausgehen als eine schlichte serielle Schleife. Der Parsing-Code nimmt keine eigenen Locks und die Blätter teilen sich keine Daten, also passiert das Warten an einer Stelle, die der Quelltext nie erwähnt: im Speichermanager, den jeder dieser Worker für jeden Elementnamen, Attributwert und jede Zelle aufruft
Die Thread-Zahl ist der Regler, nach dem jeder zuerst greift. Bei allokationsgebundenem Code bewegt er kaum etwas. Was die Kurve bewegt, ist die Zahl der Heap-Allokationen, die jede Zelle kostet
Wie HotXLS Open in drei Phasen aufteilt
HotXLS parst die Arbeitsblätter eines XLSX-Pakets mit mehreren Blättern standardmäßig auf Worker-Threads. TXLSXWorkbook.ParallelParse startet mit True und ParallelParseThreads mit 0, was einen Worker pro logischem Prozessor bedeutet, den das Betriebssystem meldet, nie mehr Worker als zu parsende Blätter. Nur eine der drei Phasen von Open läuft auf diesen Workern. Phase A ist seriell: Sie liest den Workbook-Teil, Shared Strings und Styles, legt jedes Blatt mit Namen und Sichtbarkeit an und parst die Relationships-Datei jedes Blatts, sodass Hyperlink- und Tabellenziele bereits aufgelöst sind. Spätestens wenn ein Worker startet, ist jede Nachschlagetabelle, die er konsultiert, vollständig und wird nur noch gelesen
Phase B übergibt jedes Arbeitsblatt an einen Worker. Die Worker beanspruchen Blattindizes über einen gemeinsamen Zähler mit einem interlocked Increment, sodass eine Arbeitsmappe mit einem großen Blatt und sieben kleinen sich ohne Scheduler selbst ausbalanciert: Wer ein kleines Blatt fertig hat, nimmt einfach den nächsten Index. Der ZIP-Container ist der Teil, der sich nicht naiv teilen lässt, denn ein Deflate-Stream trägt Zustand von einem Block zum nächsten, und zwei Threads können denselben Dekompressor nicht gemeinsam weiterschalten. Jeder Worker öffnet daher seinen eigenen Dekompressor über seinen eigenen Blatt-Eintrag und leitet das XML direkt in seinen eigenen Reader. Das Datei-Handle ist die einzige geteilte Ressource, und der Lock darum umfasst jeweils einen einzigen Seek-and-Read komprimierter Bytes. Dekomprimierung und Parsing laufen beide parallel, und das XML eines Arbeitsblatts liegt nie vollständig entpackt im Speicher. Nach dem Parsing liest der Worker seinen Eintrag bis zum Ende, damit die ZIP-Größen- und CRC-Prüfungen weiterlaufen
Phase C kehrt auf einen einzelnen Thread zurück für die Teile, die an jedem Blatt hängen: Kommentare und threaded comments, Zeichnungen und Diagramme, Tabellen und Druckeinstellungen. In den meisten Arbeitsmappen sind diese neben dem Zellen-XML klein
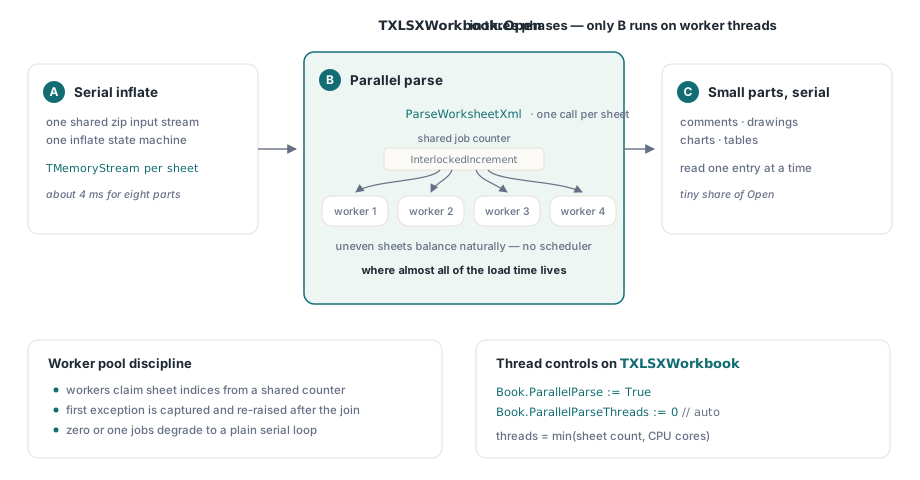
Fehler kommen auf dem aufrufenden Thread zurück. Löst ein Blatt während des Parsens eine Exception aus, stoppt der Pool die Vergabe neuer Indizes, wartet auf die noch laufenden Worker und löst dann aus Open die Exception des kleinsten fehlgeschlagenen Blatts erneut aus, sodass der Report der Blattreihenfolge folgt und der Aufrufer nie mit einer Exception konfrontiert wird, die aus einem Worker-Thread entkommt. Mit RecoveryMode auf True wird ein Blatt, das sich nicht parsen lässt, stattdessen übersprungen, eine Warnung landet in Diagnostics, und die übrigen Blätter laden normal. ParallelParse auf False lässt denselben Parser die Blätter nacheinander durchlaufen und liefert identische Ergebnisse
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    // Beide Werte sind die Vorgaben; ausgeschrieben bleibt die Wahl
    // im Code-Review sichtbar
    Book.ParallelParse := True;
    Book.ParallelParseThreads := 0;  // 0 = ein Worker pro logischer CPU, begrenzt auf die Blattzahl
    Book.RecoveryMode := False;      // ein Blatt, das sich nicht parsen lässt, löst aus Open aus
    if Book.Open('quarterly-ledger.xlsx') <> 1 then
      raise Exception.Create('open failed');
    // hier ist jedes Blatt vollständig geladen; Zellen wie gewohnt lesen
  finally
    Book.Free;
  end;
end;
Warum machen zusätzliche Threads einen allokationslastigen Parser langsamer?
Das Parsen von Arbeitsblättern besteht größtenteils aus kleinen Allokationen, und der Standard-Speichermanager von Delphi lässt Threads darauf abwechseln. Ein naiver XML-Reader erzeugt einen String für jeden Elementnamen, einen weiteren für jeden Attributnamen und -wert, einen Variant für die Zelle und einen String für ihren Text. Der Standard-Speichermanager hält kleine Blöcke in nach Größe gruppierten Pools und bewacht jeden Pool mit einem Lock. Ein Thread, der den Lock belegt vorfindet, tritt zurück und schläft, bevor er es erneut versucht. Wenn acht Worker dieselbe Handvoll winziger Größen anfordern, kollidieren sie ständig an denselben Pools, und Threads, die im Quelltext unabhängig aussehen, laufen am Ende nacheinander
Davon sind beide Symptome aus der Einleitung erklärt. Die CPU-Zeit bleibt nahe der Wanduhrzeit, weil ein schlafender Thread keine CPU verbrennt, und der Thread-Sweep bleibt flach, weil die Pool-Locks, nicht die Kerne, das Tempo vorgeben. Zwei Threads können gegen einen glatt verlieren: Jede Allokation zahlt jetzt für das Hin- und Herreichen eines Locks zwischen Kernen, während die serielle Schleife nie um Konkurrenz weiß
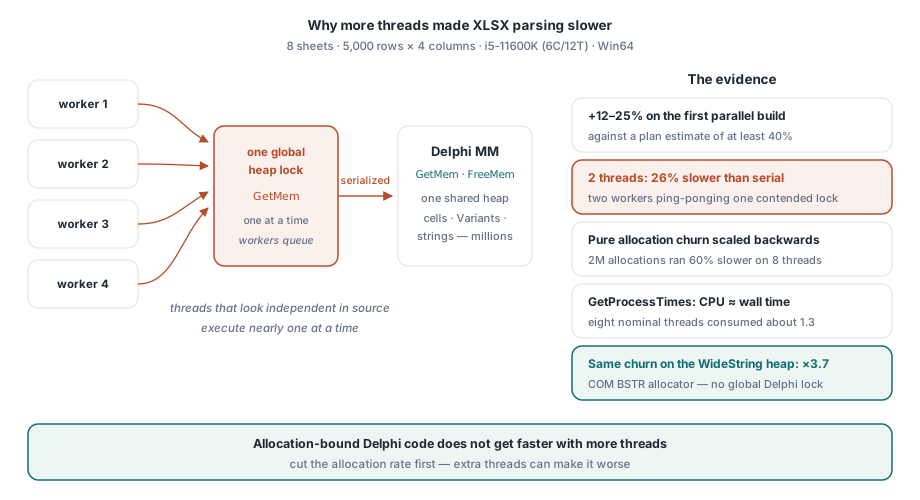
Ein String-Typ steht unter Windows außerhalb davon. Ein WideString ist ein COM-BSTR, allokiert vom OLE-String-Allokator des Systems statt vom Delphi-Speichermanager, deshalb stellt sich WideString-Verkehr nie bei den Delphi-Pools an. HotXLS speichert Zelltext als WideString, was für das parallele Laden mehr zählt als es je für den seriellen Pfad tat
Die Konkurrenz in den eigenen Arbeitsmappen messen
Zwei Zahlen verraten, ob ein Laden allokationsgebunden ist: wie sich die Wanduhrzeit verändert, wenn die Worker-Zahl steigt, und wie viel CPU der Prozess über dasselbe Intervall verbraucht hat. Bleibt CPU-Zeit geteilt durch Wandzeit nahe 1,0, während acht Worker nominell beschäftigt sind, stellen sie sich eher an, als dass sie parsen. Der Sweep unten öffnet dieselbe Datei mit einem bis acht Workern und druckt beide Größen. Er ist ein Messgeschirr für das eigene Testprojekt; nur die TXLSXWorkbook-Mitglieder kommen aus HotXLS
uses
  Winapi.Windows, System.SysUtils, System.Math, System.Diagnostics;

// Eigener Helfer: User- plus Kernel-CPU-Zeit dieses Prozesses in Millisekunden
function ProcessCpuMs: Int64;
var
  Created, Exited, Kernel, User: TFileTime;
begin
  GetProcessTimes(GetCurrentProcess, Created, Exited, Kernel, User);
  Result := (Int64(Kernel) + Int64(User)) div 10000;  // 100-ns-Ticks zu ms
end;

procedure SweepThreads(const FileName: string);
var
  N: Integer;
  Book: TXLSXWorkbook;
  SW: TStopwatch;
  Cpu0, Cpu: Int64;
begin
  for N := 1 to 8 do
  begin
    Book := TXLSXWorkbook.Create;
    try
      Book.ParallelParseThreads := N;  // 1 fährt die schlichte serielle Schleife
      Cpu0 := ProcessCpuMs;
      SW := TStopwatch.StartNew;
      if Book.Open(FileName) <> 1 then
        raise Exception.CreateFmt('open failed: %s', [FileName]);
      SW.Stop;
      Cpu := ProcessCpuMs - Cpu0;
      Writeln(Format('%d workers: %d ms wall, CPU/wall %.2f',
        [N, SW.ElapsedMilliseconds, Cpu / Max(Int64(1), SW.ElapsedMilliseconds)]));
    finally
      Book.Free;
    end;
  end;
end;
Lässt man den Sweep mehrmals laufen und behält je Worker-Zahl die beste Zahl, zahlt der erste Lauf auch für einen kalten Disk-Cache mit. Eine flache Wandzeitkurve mit CPU/Wand nahe 1 heißt, der Speichermanager ist die Decke. Sinkt die Wandzeit weiter, während CPU/Wand gegen die Worker-Zahl klettert, ist die Datei parsegebunden und die zusätzlichen Worker arbeiten ihren Platz ab
Eine flache Kurve führt zur nächsten Frage: Welche Allokationen sind dafür verantwortlich? Ein Speichermanager-Wrapper, der Aufrufe nach Größe zählt, beantwortet das in wenigen Minuten ganz ohne Profiler. Die Version unten zählt nur GetMem und lässt FreeMem und ReallocMem auf den ursprünglichen Manager zeigen, was reicht, um zu sehen, woher der Verkehr kommt
// Diagnose für das eigene Testgeschirr; nicht Teil von HotXLS
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);  // der Small-Block-Verschleiß, den man im Blick behalten will
  Result := OldMM.GetMem(Size);
end;

procedure InstallCounter;
begin
  GetMemoryManager(OldMM);
  NewMM := OldMM;
  NewMM.GetMem := CountingGetMem;
  SetMemoryManager(NewMM);
end;

procedure RemoveCounter;
begin
  SetMemoryManager(OldMM);
end;
Installiert den Zähler direkt vor Open, nehmt ihn direkt danach wieder heraus und teilt AllocCount durch die Zahl der Zellen in der Datei. Diese Pro-Zelle-Größe ist die Kennzahl, die man von Build zu Build verfolgt, und der Anteil der Blöcke mit 32 Byte oder darunter zeigt, ob kurze Strings dominieren. Prüft das, bevor ihr einen Zellen-Objektpool schreibt: Jedes Zellenobjekt ist eine Allokation, und die kurzlebigen Strings, die beim Parsen dieser Zelle entstehen, übersteigen sie leicht um ein Mehrfaches
Wo sich die Allokationen im Arbeitsblatt-XML verstecken
Eine Zelle wie <c r="B7" s="3" t="s"><v>42</v></c> sieht auf der Platte winzig aus. Ein geradliniger Reader macht daraus trotzdem eine Reihe frischer Strings: die Elementnamen c und v, drei Attributnamen, drei Attributwerte und den Textinhalt. Jeden UTF-8-Token über die RTL zu konvertieren fügt ein zwischendrin liegendes UnicodeString hinzu, bevor der endgültige WideString existiert. Keiner dieser Strings überlebt die Zelle, und jeder einzelne ist eine Reise durch den Speichermanager
Der HotXLS-XML-Reader greift die beiden größten Quellen an. Elementnamen im Arbeitsblatt-XML kommen aus einem sehr kleinen Vokabular (row, c, v, f, is), deshalb hält der Reader einen kurzen Cache bereits bekannter Namen, vergleicht die rohen Bytes jedes neuen Namens mit diesem Cache und liefert bei einem Treffer den gecachten String. Die gecachten Kopien sind bewusst AnsiString. AnsiString ist referenzgezählt, also kostet die Herausgabe einer gecachten Instanz ein einziges Erhöhen des Zählers und gar keine Allokation. Ein Cache aus WideString-Namen brächte nichts: WideString hat keinen Referenzzähler, und jede Zuweisung erzeugt eine neue Systemallokation
Attributnamen, Attributwerte und Zelltext nehmen den anderen Weg. Der Reader dekodiert UTF-8 direkt aus seinem Scan-Puffer in zwei Durchgängen: Der erste zählt UTF-16-Codeeinheiten, der zweite füllt einen WideString, der genau in dieser Länge einmalig allokiert wird. Das ist eine Allokation pro Token, und sie landet beim System-String-Allokator statt bei den Delphi-Pools. Zeichenreferenzen wie A und die vordefinierten Entities löst der Scanner auf, bevor die Dekodierung beginnt, sodass der Dekoder nur plain UTF-8 zu sehen bekommt. Für Bytefolgen, die kein gültiges UTF-8 sind, reicht der Dekoder die betroffenen Bytes einzeln durch, wo die RTL-Konvertierung sie verwerfen oder ersetzen würde, sodass eine beschädigte Datei um die schlechte Stelle herum noch lesbaren ASCII liefert. Gültige Eingaben dekodieren sich so oder so in denselben Text
Beide Kniffe lassen sich in den eigenen Delphi-Parsing-Code übernehmen. Strings zu cachen spart nur dann Allokationen, wenn der String-Typ referenzgezählt ist, und das Dekodieren direkt in den Zieltyp erspart das Temporäre, das die bequemen RTL-Konvertierungsfunktionen bei jedem Aufruf erzeugen
Welche Arbeitsmappen profitieren, und welche Einstellungen man wählt
Paralleles Parsing arbeitet auf Arbeitsblatt-Granularität, also entscheidet die Form der Arbeitsmappe den größten Teil des Ausgangs. Mehrere Blätter vergleichbarer Größe sind der beste Fall, darunter die Dateien, die man durch das Duplizieren eines Vorlagen-Arbeitsblatts einmal pro Region oder Monat erhält. Eine Arbeitsmappe, die aus einem einzigen riesigen Blatt besteht, parst auf einem Worker, was auch immer ParallelParseThreads sagt; für diese Form passt der Streaming-Direct-Reader besser, weil er die ganze Arbeitsmappe nie im Speicher aufbaut. Zeit für Kommentare, Diagramme und Zeichnungen bleibt in der seriellen Phase C. Eine Datei mit null oder einem Blatt überspringt den Pool und fährt die schlichte serielle Schleife
Wenn nur manche Blätter zählen, listet man ihre Namen vor dem Open-Aufruf in SelectedSheets. Die übrigen Blätter werden weiterhin mit Namen und Sichtbarkeit angelegt, aber ohne Zellen, die Worker gehen leer aus, und LoadSheet füllt eines nachträglich, wenn der Nutzer es öffnet
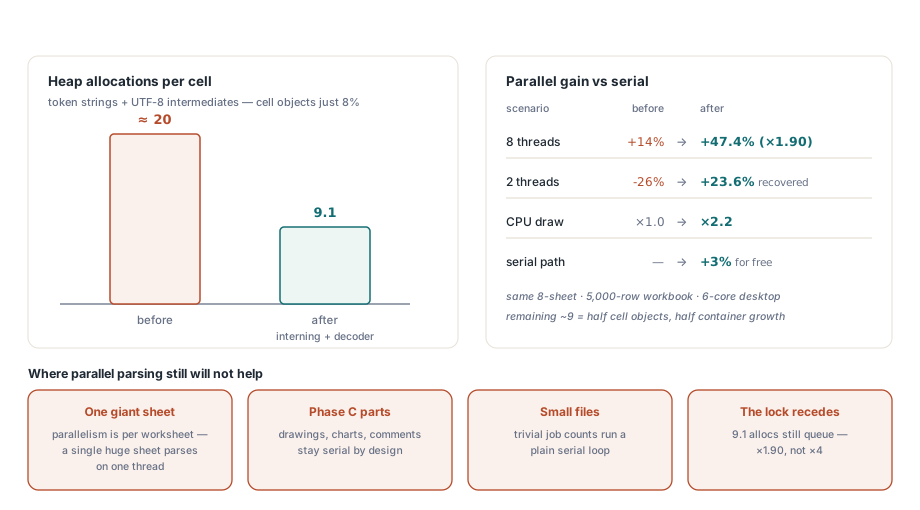
Lässt ParallelParse für Desktop-Werkzeuge und Batchjobs an, die jeweils eine Arbeitsmappe öffnen. Diese Vorgabe ist die sicherere: Die Ergebnisse entsprechen dem seriellen Pfad, und eine Eigenschaft schaltet es ab, falls je eine Threading-Frage auftaucht. Anders bei einem Server, der ohnehin mehrere Arbeitsmappen gleichzeitig öffnet. Jeder Request-Thread allokiert ebenfalls, also bringt jeder zusätzliche Parse-Worker einen weiteren Mitstreiter für dieselben Speichermanager-Pools; setzt dort ParallelParseThreads auf 2 und erhöht es erst, wenn der Sweep von oben, auf diesem Server unter normaler Last gefahren, zeigt, dass sich die zusätzlichen Worker selbst tragen. Weniger Allokationen pro Zelle heben die Decke, ohne sie zu entfernen. Zellenobjekte und Containerwachstum laufen weiterhin über die Delphi-Pools, weshalb der Gewinn aus acht Workern deutlich unter dem Achtfachen bleibt. Den Rest des Load-and-Save-Werkzeugkastens, von der Wiederverwendung von Styles bis zu Bulk-Row-Callbacks, behandelt der Leitfaden zur Leistung bei großen Arbeitsmappen in Delphi
Der Worker-Pool, die Schalter ParallelParse und ParallelParseThreads und der allokationsarme XML-Reader kommen alle in der HotXLS Delphi Excel Component, die XLS, XLSX und ODS direkt aus Delphi- und C++Builder-Code liest und schreibt, ohne dass Excel auf der Maschine installiert ist