Eine ODS-Arbeitsmappe mit einer Pivot-Tabelle läuft durch eine Bibliothek, eine einzige Quellzelle wird bearbeitet, und die gespeicherte Datei öffnet mit intakten Zellwerten und ohne die Pivot: content.xml enthielt beim Rein gehen ein <table:data-pilot-table> und beim Raus gehen null. Die naheliegende Reparatur ist, die Pivot-XML als String rüberzukopieren. Das stellt die Elementanzahl wieder her, und dann verweigert ein namespace-bewusster Parser das gespeicherte Part kurzerhand mit einem Unbound-Prefix-Fehler. Beide Fehler haben eine Wurzel. Ein Stück XML reist nur dann sicher, wenn die Namespace-Deklarationen, von denen es abhängt, mitreisen
Wo eine ODS-Pivot-Definition in content.xml wohnt
Eine OpenDocument-Pivot-Tabelle, die das Format Data Pilot nennt, ist eine Definition, die nach den Sheets in content.xml abgelegt wird, und ein Writer, der dieses Part aus seinem eigenen Objektmodell neu baut, behält sie nur, wenn das Modell einen Ort dafür hat. ODF 1.3 Part 3 §9.6 beschreibt den Container: <table:data-pilot-tables> hält ein <table:data-pilot-table> pro Pivot, jedes mit einem table:source-cell-range, einer Menge von table:data-pilot-field-Kindern, einer table:target-range-address und einer table:buttons-Liste. Die Ergebniszellen, die die Pivot anzeigt, sitzen als gewöhnliche Zellen im Worksheet. Ein Writer, der nur Zellen, Styles, Validierungen, benannte Ausdrücke und Datenbankbereiche neu erzeugt, produziert also eine völlig valide Tabelle mit denselben Zahlen auf dem Schirm und keiner Pivot dahinter
Das HotXLS Delphi Excel Component liest den gesamten <table:data-pilot-tables>-Teilbaum beim OpenODS aus content.xml heraus, bevor es eine einzige Zelle parst, und versucht dann, die Sammlung in sein Pivot-Modell zu übersetzen. Eine Definition in der schlichten Form, die das Modell abbildet – lokaler Quellbereich, ein Zeilenfeld, Aggregat-Measures und gespeicherte Ergebnisse, die zu den Quelldaten passen –, wird zu einer TXLSPivotTable in der PivotTables-Liste des Worksheets, dasselbe Objekt, das man von einer XLSX-Pivot bekommt und mit berechneten Feldern erweitern und aus Delphi auffrischen kann. Alles außerhalb dieser Form behält die Sammlung als eingefangenes XML, und SaveAsODS schreibt es zurück. Schon ein Attribut in einem Namespace, den der Übersetzer nicht kennt, genügt: Von LibreOffice gespeicherte Pivots können loext:- und calcext:-Attribute tragen, und ein loext:-Attribut schickt die Definition auf den eingefangenen Pfad
Der Fallback ist alles oder nichts, pro Mappe. Fällt bei einer Sammlung aus drei Pivots auch nur eine aus dem übersetzbaren Schema, bleiben alle drei als eingefangenes XML. Sie aufzuteilen ließe content.xml mit zwei Wahrheitsquellen für denselben Container zurück, die Hälfte neu gebaut aus Objekten, die andere Hälfte wiedergegeben aus Text, und jede Unstimmigkeit zwischen den Hälften würde in der Datei des Users landen. Die Sammlung ganz zu lassen ist der sicherere Default, und es ist dieselbe Politik, die HotXLS auf unbekannte extLst-Blöcke in XLSX anwendet: Was das Modell nicht tragen kann, bleibt, wie es geschrieben wurde
Warum bricht eine herausgeschnittene Pivot-Definition die gespeicherte Datei?
Eine mit Stringsuche aus content.xml herausgeschnittene Pivot-Definition verliert die Namespace-Deklarationen, die ihren Präfixen Bedeutung geben, und Namespaces in XML behandelt einen Präfix ohne Deklaration als Wohlgeformtheitsfehler. Der String-Ansatz ist kurz: Das Part in einen WideString dekodieren, <table:data-pilot-tables mit Pos finden, das passende schließende Tag dahinter finden, und alles dazwischen kopieren. Der herauskommende Text sieht vollständig aus. Er enthält loext:ignore-selected-page="true" an einem Seitenfeld und calcext:repeat-item-labels="false" auf jeder Ebene, aber die xmlns:loext- und xmlns:calcext-Deklarationen, die diese Präfixe binden, sitzen am Dokument-Root, <office:document-content>, tausende Zeichen früher
Namespaces in XML 1.0 §6.1 hält eine Deklaration vom Start-Tag, das sie trägt, bis zum passenden End-Tag im Scope, und jeder präfixierte Name darin löst gegen sie auf. Schneidet man einen Teilbaum aus dem Dokument, schneidet man ihn aus diesem Scope heraus. Fügt man das Fragment in ein neues Dokument ein, löst jeder Präfix nur auf, wenn das neue Root ihn zufällig deklariert. HotXLS schreibt sein eigenes <office:document-content> mit den Namespaces, die sein Writer benutzt, darunter office, table, text, style, fo, draw, calcext, tableooo und of. In der herausgeschnittenen Kopie löst table: auf, calcext: löst auf, und loext: löst nicht auf. Ein einziger ungebundener Präfix genügt, damit ein namespace-bewusster Parser das gesamte Part verwirft, die Pivot degradiert also nicht gracefully; auch die Sheet-Daten drumherum werden unlesbar
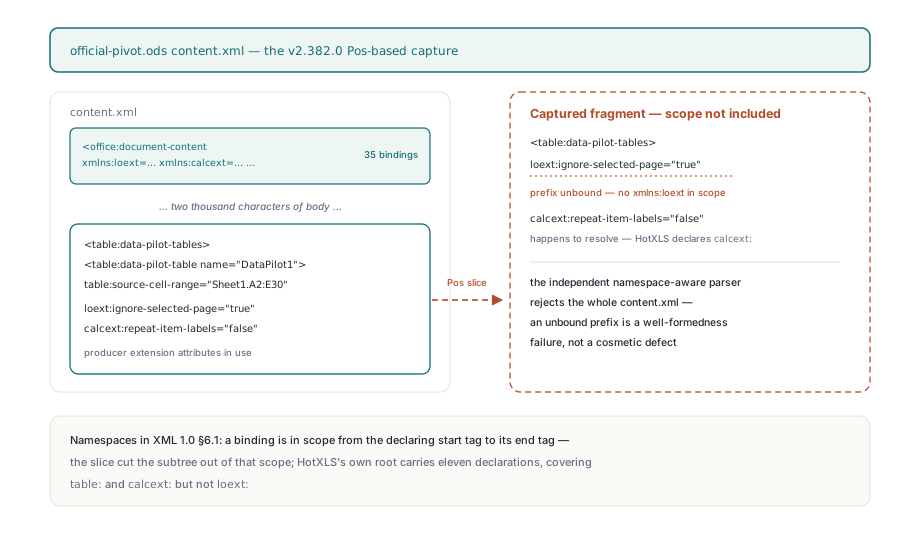
Stringsuche hat weitere blinde Flecken, die einer Reader-basierten Erfassung nie begegnen. Pos matcht den Tag-Text innerhalb eines Kommentars, innerhalb einer CDATA-Sektion oder innerhalb eines Attributwerts, der ihn zitiert. Verschachtelte Elemente desselben Namens kann es nicht unterscheiden. Und es matcht den wörtlichen Präfix table:, während ODF einem Producer erlaubt, den Table-Namespace an jeden beliebigen Präfix zu binden
Wie HotXLS den Namespace-Scope aufs Fragment bringt
HotXLS fängt den Pivot-Teilbaum mit einem Streaming-XML-Reader ein, der jede Namespace-Deklaration zusammen mit der Tiefe verfolgt, in der sie auftauchte, und kopiert die noch wirksamen Deklarationen im Moment des Ziel-Element-Treffers aufs öffnende Tag des Fragments. Der Stack wächst bei jedem Start-Tag, das xmlns oder xmlns:prefix deklariert, und schrumpft, wenn das Element, das eine Bindung deklariert hat, geschlossen wird. Leere Elemente brauchen dieselbe Behandlung: <x xmlns:p="..."/> erzeugt nie ein separates End-Tag-Ereignis, also muss der Pop auch beim leeren Start-Tag feuern, sonst leckt eine Bindung in die Geschwister
Am Ziel läuft die Erfassung den Stack vom innersten Binding nach außen durch und schreibt jeden Präfix genau einmal. Von innen nach außen zu gehen ist genau das, was Shadowing implementiert. Bindet <office:spreadsheet> einen Präfix neu, den das Root schon deklariert hatte, ist der nähere Wert der, der an der Pivot gilt, genau wie §6.1 es verlangt, und eine Menge bereits geschriebener Präfixe hält den äußeren Wert davon ab, hinterherzukommen. Einen Präfix, den das Pivot-Element selbst deklariert, überspringt die Erfassung, denn xmlns:table doppelt auf einem Tag zu schreiben wäre ein anderer Wohlgeformtheitsfehler
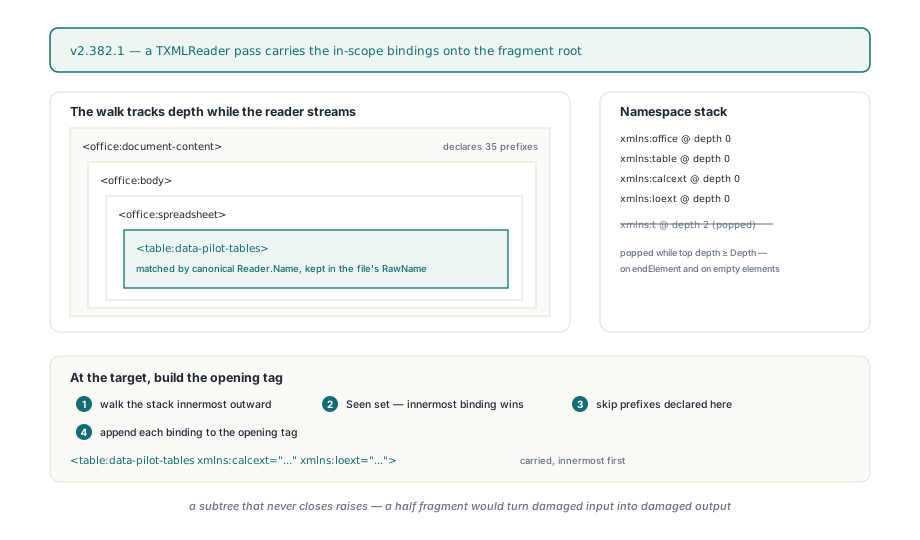
Das Ziel wird über den Namespace gematcht, ein Producer, der <t:data-pilot-tables> schreibt mit t an die ODF-Table-URI gebunden, wird also weiterhin erkannt, während die eingefangenen Tags die Schreibweise aus der Datei behalten. Whitespace-Textknoten kommen exakt wie geschrieben zurück. Attribut-Quoting und die Wahl zwischen <x/> und <x></x> werden normalisiert, denn das Fragment wird aus Reader-Ereignissen neu serialisiert statt Byte für Byte kopiert. Endet content.xml, während der Pivot-Teilbaum noch offen ist, wie in einer abgeschnittenen Datei, scheitert das Öffnen mit einer Exception, statt eine halbe Definition zurückzuhalten, die beim nächsten Speichern zurückgeschrieben würde
Der mitgeführte Satz ist bewusst großzügig. Die Erfassung kopiert jede Bindung im Scope, egal ob der Teilbaum sie benutzt, das Fragment-Root wiederholt also xmlns:table und xmlns:calcext, obwohl das gespeicherte Dokument-Root sie ebenfalls deklariert. Einen Präfix in einem verschachtelten Scope neu zu deklarieren ist unter Namespaces in XML legal, und eine Datei von einem Producer, der Dutzende Namespaces an seinem Root deklariert, wächst um ein paar Kilobyte. Die Liste zu stutzen hieße, den Teilbaum nach jedem Präfix in Elementnamen, Attributnamen und Attributwerten mit QNames zu durchsuchen, und ein einziger Miss dort bringt den Unbound-Prefix-Fehler sofort zurück. Ein paar redundante Deklarationen kosten weit weniger als dieses Risiko
Eine Mappe mit Pivot öffnen, bearbeiten und speichern
Aus Aufrufersicht gibt es nichts einzuschalten: Die Pivot-Definition reist mit einem gewöhnlichen OpenODS und SaveAsODS mit. Worksheets werden ab 1 nummeriert, und beide Methoden geben bei Erfolg 1 zurück:
uses
  System.SysUtils, lxHandleX;

procedure EditPivotSource(const InFile, OutFile: string);
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.OpenODS(InFile) <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InFile]);
    // E2 liegt innerhalb eines Pivot-Quellbereichs von Sheet1.A2:E30
    Book.Sheets[1].Cells[2, 5].Value := 1250.0;
    if Book.SaveAsODS(OutFile) <> 1 then
      raise Exception.CreateFmt('Cannot save %s', [OutFile]);
  finally
    Book.Free;
  end;
end;
In der gespeicherten content.xml sitzt die Pivot-Sammlung innerhalb von <office:spreadsheet> direkt nach den <table:named-expressions>, die der Writer erzeugt, und vor <table:database-ranges>. Eine Mappe, die sowohl einen AutoFilter trägt, den HotXLS als Datenbankbereich schreibt, als auch eine Pivot, legt die beiden Elemente nebeneinander, und wenn die eigene Pipeline einen strengen ODF-Schema-Validator fährt, ist dieses Paar die erste Anlaufstelle
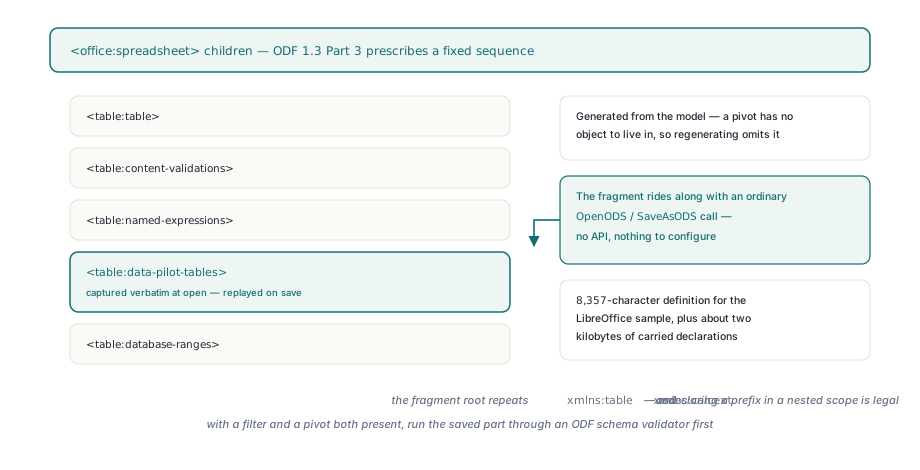
Die Bearbeitung in dem Beispiel ändert einen Quellwert und lässt die Ergebniszellen der Pivot, wie sie waren. Eine eingefangene Definition wird wiedergegeben, wie geschrieben: HotXLS rechnet sie nicht nach, und die Tabellenkalkulationsanwendung, die die Datei öffnet, berechnet die Pivot bei ihrem nächsten Refresh neu. Dasselbe gilt für ihre Adressen. Benennt man Sheet1 um oder verschiebt den Quellblock, zeigt die gespeicherte Definition weiter auf Sheet1.A2:E30, was die konsumierende Anwendung beim Auffrischen als kaputten Bereich meldet. Sheet-Namen und Quellblock in jeder Mappe stabil halten, deren Pivots auf diese Weise reisen
Welchen Weg ist eine bestimmte Pivot gegangen?
Die schnellste Prüfung ist die PivotTables-Liste des Worksheets: Eine übersetzte Definition taucht dort als TXLSPivotTable auf, eine eingefangene nicht. Der Konversionsbericht beantwortet die zweite Hälfte der Frage, was mit der Pivot in einem anderen Ausgabeformat passieren würde. GetConversionReport inspiziert die Mappe, ohne sie zu speichern oder neu zu berechnen, und der Aufrufer besitzt den zurückgegebenen Bericht:
uses
  System.SysUtils, lxHandleX, lxDiagnostics;

function DescribeOdsPivots(Book: TXLSXWorkbook): string;
var
  I, Modeled: Integer;
  Report: TXLSConversionReport;
begin
  Modeled := 0;
  for I := 1 to Book.Sheets.Count do          // Sheets ist 1-basiert
    Inc(Modeled, Book.Sheets[I].PivotTables.Count);

  Report := Book.GetConversionReport(xlsConversionOpenXmlWorkbook);
  try
    for I := 0 to Report.Count - 1 do
      if (Report[I].Feature = 'OpenDocumentPivotTables') and
         (Report[I].Fidelity = xlsConversionDropped) then
        Exit('Captured ODF pivot XML: keep this workbook on .ods');
  finally
    Report.Free;
  end;

  if Modeled > 0 then
    Result := Format('%d pivot table(s) in the pivot model', [Modeled])
  else
    Result := 'No pivot definitions';
end;
Der Ausgabepfad zählt, denn eingefangenes XML ist ODF-Vokabular, und nur der ODS-Writer gibt es aus. Als .xlsx gespeichert hat die eingefangene Sammlung kein SpreadsheetML-Gegenstück, und der Bericht listet sie unter OpenDocumentPivotTables mit xlsConversionDropped. Der binäre .xlsb-Writer lehnt eine Mappe ab, die sie noch trägt. Eine übersetzte Pivot ist ein gewöhnliches Modellobjekt und folgt stattdessen den Regeln des Zielformats. Die Unterschiede zwischen den ODS-Import- und -Export-Pfaden gelten hier wie überall, und für Dateien mit Pivot ist der sichere Weg .ods rein, .ods raus
Eine weitere Regel folgt aus dem Alles-oder-Nichts-Fallback. Eine Mappe gibt entweder eine eingefangene Sammlung wieder oder schreibt ihre Pivots aus dem Modell; beides in einer content.xml zu mischen kommt nie vor. Fügt man mit AddPivotTable eine Pivot zu einer Mappe hinzu, die bereits eingefangenes Pivot-XML trägt, bricht der ODS-Save mit einem Fehler ab, statt erzeugtes XML neben wiedergegebenes XML zu kleben
Das gespeicherte Part mit einem zweiten Parser prüfen
Eine Elementanzahl beweist nichts über Namespaces. Ein regulärer Ausdruck, der data-pilot-table-Start-Tags in der gespeicherten content.xml findet, sieht Text, und die herausgeschnittene Kopie aus dem zweiten Abschnitt besteht diesen Test. Ein namespace-bewusster Parser, der mit der Bibliothek, die die Datei geschrieben hat, nichts zu tun hat, ist ein weit strengerer Richter, und Delphi bringt einen bereits mit. Die Funktion unten ist eine Prüfung für die eigene Testsuite; TZipFile und TXMLDocument kommen aus der Delphi-RTL, nicht aus HotXLS:
uses
  System.SysUtils, System.Classes, System.Zip,
  Xml.xmldom, Xml.XMLIntf, Xml.XMLDoc;

// Eigener Test-Helper: True, wenn content.xml aus einem .ods-Paket
// in einem namespace-bewussten DOM-Parser lädt
function OdsContentParses(const OdsFile: string; out Error: string): Boolean;
var
  Zip: TZipFile;
  Bytes: TBytes;
  Stream: TBytesStream;
  Doc: IXMLDocument;
begin
  Error := '';
  Zip := TZipFile.Create;
  try
    Zip.Open(OdsFile, zmRead);
    Zip.Read('content.xml', Bytes);
  finally
    Zip.Free;
  end;
  Stream := TBytesStream.Create(Bytes);
  try
    Doc := TXMLDocument.Create(nil);
    try
      Doc.LoadFromStream(Stream);     // ein ungebundener Präfix scheitert hier
      Result := True;
    except
      on E: EDOMParseError do
      begin
        Error := E.Message;
        Result := False;
      end;
    end;
  finally
    Stream.Free;
  end;
end;
Fährt man ihn über jede .ods, die der eigene Code speichert, dann geht man für Dateien mit Pivot einen Schritt weiter und vergleicht den Pivot-Teilbaum von Eingabe und Ausgabe nach dem Parsen: Tag, sortierte Attribute, Text und Kinder, rekursiv, mit Namen, die zu Namespace-URI plus lokalem Namen expandiert wurden. Dieser Vergleich lässt eine umgeschriebene Präfix-Schreibweise durch und erwischt einen ungebundenen, genau die Linie zwischen harmlos und kaputt. Füttert man ihn mit Dateien von jedem Producer, den die User tatsächlich einsetzen. Ein Dokument, das den Table-Namespace an einen anderen Präfix bindet, einen Präfix am Pivot-Element selbst deklariert oder einen in <office:spreadsheet> neu bindet, fordert die Skip- und Shadowing-Regeln auf eine Weise, die eine einzelne LibreOffice-Datei nicht schafft
Der ODS-Reader und -Writer, das Pivot-Modell für XLSX wie ODS und der oben benutzte Konversionsbericht sind allesamt Teil des HotXLS Delphi Excel Component; dessen Produktseite deckt die vollständige XLSX-, XLS- und ODS-Lese-Schreib-Unterstützung für Delphi und C++Builder ab