Das Suchfeld eines Viewers hebt „Acme Corp“ auf Seite 2 einer Rechnung hervor, doch eine Byte-Suche im dekomprimierten Seiten-Stream nach denselben neun Zeichen kommt leer zurück. Allein für das erste Wort kann der Stream etwas wie <0024004600500048> Tj halten: Zweibyte-Glyph-Codes in einer eingebetteten Subset-Schrift, wobei der Abstand zwischen den zwei Wörtern von einem Positionierungs-Offset statt einem Leerzeichen produziert wird. Diesen Namen zu ersetzen heißt: diese Codes nach Unicode dekodieren, dort matchen, zu den exakten Bytes zurückgehen, die den Treffer produziert haben, und neue Codes schreiben, die dieselbe Schrift versteht. Enthält das Subset nie einen Glyphen, den der neue Text braucht, gibt es keine Codes zu schreiben
Die Anfragen dahinter sind gewöhnliche Dokumentpflege. Eine Firma benennt sich um, und dreitausend archivierte Rechnungen tragen weiterhin den alten Namen. Eine Vertragsschablone ging mit dem Ablaufdatum des Vorjahres raus. Eine ausgemusterte Teilenummer muss in jedem Datenblatt zur Nachfolgernummer werden. In einem Textverarbeitungsprogramm kostet jedes davon dreißig Sekunden; in einem PDF läuft jedes in die Art hinein, wie Seiten tatsächlich gespeichert sind
Was eine PDF-Seite statt Text speichert
Eine PDF-Seite hält positionierte Glyphen, keinen editierbaren Text. Nach ISO 32000-1 §9.4 treibt der Content Stream Text-Show-Operatoren wie Tj und TJ, die Sequenzen von Zeichen-Codes an Positionen malen, die die Textmatrix setzt. Diese Codes sind Indizes in die Kodierung, die der aktuelle Font deklariert. Der Weg zurück zu lesbaren Zeichen kann über eine /ToUnicode-CMap (§9.10.3), ein /Encoding mit einem /Differences-Array oder eine CID-Mapping-Kette für Type0-Fonts laufen. Es gibt kein Absatz-Objekt und keinen Textfluss, und nichts zwingt einen Produzenten, ein sichtbares Wort als einen String zu speichern: [(Ac) -12 (me)] TJ ist eine völlig gewöhnliche Art, ein Wort zu unterschneiden
Ersetzen legt eine zweite Anforderung obendrauf auf das Dekodieren. Ein Textextraktor darf die Byte-Positionen wegwerfen, sobald er das Unicode raus hat. Ein Ersetzer braucht sie, denn er muss wissen, welche Bytes welchen String-Operanden welchen Glyphen produziert haben, um exakt diesen Bereich umzuschreiben und alles andere in Ruhe zu lassen. Deshalb ist ein schlichtes StringReplace über die Stream-Bytes das falsche Werkzeug, selbst auf Dateien, die zufällig WinAnsi-Kodierung nutzen. Es weiß nicht, welches ( zu einem String gehört und welches Tf den Font wählt, der diesen Bytes ihre Bedeutung gibt
Die dekodierte Glyphen-Sequenz durchsuchen
Die HotPDF Delphi Component durchsucht ein geladenes Dokument mit SearchLoadedPageText und SearchLoadedDocumentText, die die Nadel gegen die dekodierte Unicode-Glyphen-Sequenz jeder Seite matchen, nie gegen rohe Stream-Bytes. Ein Treffer ist also ein Treffer, wie auch immer der Font ihn kodiert hat. Beim Dekodieren merkt sich jeder Glyph seinen String-Operanden, das TJ-Array-Element und den Byte-Offset, aus dem er stammt, worauf der Replace-Schritt später baut. Derselbe Glyphen-Interpreter treibt die API aus dem Artikel zum Extrahieren von Text aus einem geladenen PDF in Delphi; die Suche behält einfach die Quellpositionen, die die Extraktion wegwirft
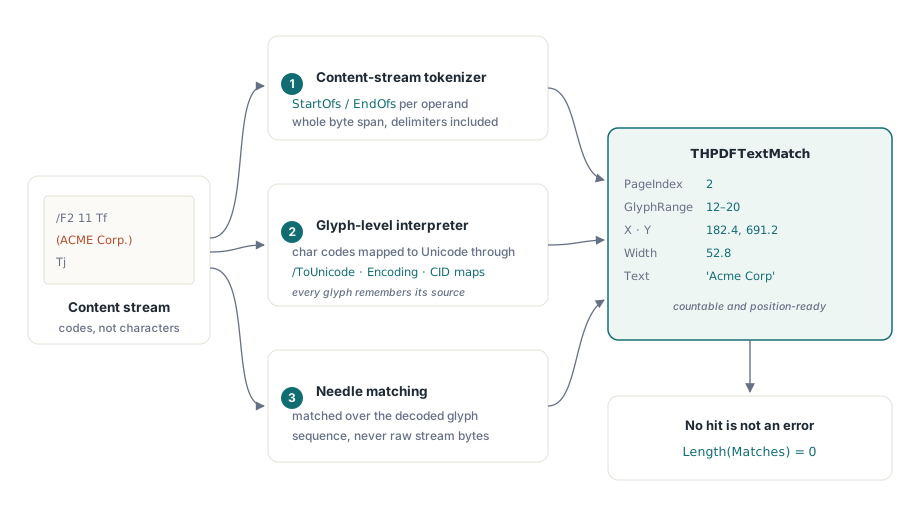
Jeder Treffer kommt als THPDFTextMatch-Record zurück: PageIndex, die inklusive Glyphen-Range in GlyphStart und GlyphEnd, der User-Space-Ursprung in X und Y, die Width des Treffers, den Quell-TokenIndex und ItemIndex sowie den gematchten Text. PageIndex ist nullbasiert. Eine Nadel, die nicht vorkommt, liefert ein leeres Array und ein True-Ergebnis, daher braucht der Aufrufcode keinen Spezialfall für „nichts gefunden“
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to High(Matches) do
          WriteLn(Format('page %d at (%.1f, %.1f), width %.1f: "%s"',
            [Matches[I].PageIndex + 1, Matches[I].X, Matches[I].Y,
             Matches[I].Width, Matches[I].Text]));
  finally
    Pdf.Free;
  end;
end;
Ob diese Schleife überhaupt etwas druckt, hängt vor allem anderen an den Leerzeichen. Der Suchtext wird aus den Glyphen gebaut, die die Seite tatsächlich malt, ein Zeichen pro Glyph, und ein TJ-Offset, der zwei Wörter visuell trennt, ist eine Zahl im Array statt einem Glyph. Ein Produzent, der Wortabstände mit Offsets statt mit einem Leerzeichen setzt, liefert „AcmeCorp“ in der Glyphen-Sequenz, und die Nadel „Acme Corp“ wird nicht matchen. Wenn sich ein sichtbarer Ausdruck weigert zu matchen, suchen Sie zuerst sein längstes Einzelwort und schauen auf den Text dessen, was zurückkommt
Groß- und Kleinschreibung ist das andere, was man prüfen sollte. Mit CaseSensitive auf False vergleichen Builds ab Delphi XE2 Zeichen über das Unicode-Simple-Lowercase-Mapping, das lokalunabhängig ist, daher matcht É auf é und griechische oder kyrillische Großbuchstaben auf ihre Kleinformen. Builds mit älteren Compilern falten nur A–Z. Das Mapping ist ein Zeichen zu einem Zeichen, wodurch jede Nadelposition exakt auf einen Glyph ausgerichtet bleibt; die Folge ist, dass ß nicht auf SS matcht. Für Ganzwort-UI-Flüsse wirft SearchLoadedPageTextWholeWord Treffer weg, die innerhalb eines längeren Worts sitzen, und GetLoadedSearchHitRect macht aus einem Treffer ein einzelnes Rechteck fürs Hervorheben
Suche und Ersetzen arbeiten beide auf den eigenen /Contents-Streams der Seite. Text, der in einem Form XObject gemalt wird, wo viele Tools gestempelte Header und Footer ablegen, lebt in einem separaten Stream, den die Seite mit Do aufruft, und liegt außerhalb beider Operationen
Gematchte Bytes mit ReplaceLoadedDocumentText umschreiben
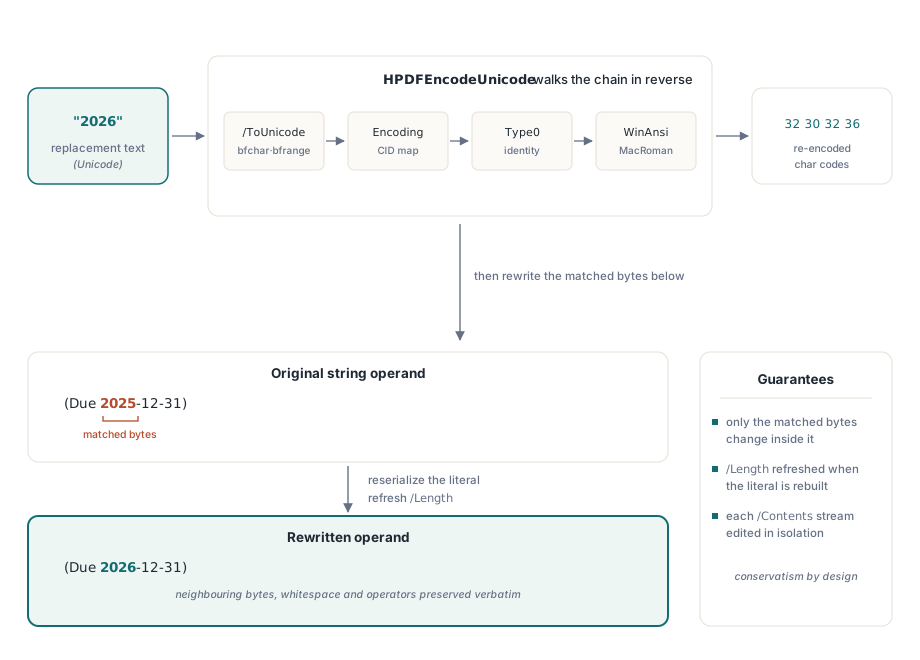
ReplaceLoadedPageText und ReplaceLoadedDocumentText schreiben jedes Vorkommen einer Nadel um, indem sie die Font-Dekodierung rückwärts laufen lassen. Jedes Ersetzungszeichen wird über dieselbe Kette nachgeschlagen, die der Dekoder benutzt, nur rückwärts: /ToUnicode-bfchar- und bfrange-Einträge, CID-Mappings für Type0-Fonts, Identity-Mappings und die vordefinierten WinAnsi- und MacRoman-Tabellen. Die entstandenen Char-Codes werden als Literal-String zurückgeschrieben, oder als Hex-String, wenn irgendein Byte außerhalb des druckbaren ASCII fällt, nach denselben Escape-Regeln, die der Content-Stream-Parser liest
Nur die vom Match abgedeckten Bytes ändern sich. Ungematchte Bytes im selben Operanden, der Whitespace zwischen Tokens, Kommentare und jeder umgebende Operator gehen unangetastet durch. bca innerhalb von abcabc zu ersetzen ergibt a + Ersetzung + bc. Die Ersetzung darf kürzer oder länger als die Nadel sein, und jeder Stream im /Contents-Array einer Seite wird für sich verarbeitet, sodass die Seite wohlgeformt bleibt. Liegt ein Match über mehrere String-Operanden hinweg, etwa Hello gespeichert als [(He) -20 (llo)] TJ, wird die Ersetzung in den Operanden geschrieben, wo der Match beginnt, und die gematchten Bytes werden aus den folgenden Operanden entfernt
var
  Pdf: THotPDF;
  Rewrites: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, Rewrites) then
        WriteLn(Format('%d operand rewrites', [Rewrites]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
Die Seite wird nicht neu gesetzt. PDF hat kein Reflow, also nimmt eine Ersetzung, die breiter ist als das Original, schlicht mehr horizontalen Raum ein und kann in laufen, was rechts daneben gemalt wurde; die Position des nächsten Glyphen war vom Produzenten festgelegt und rückt nicht. Daten, Versions-Strings, Teilenummern und Schreibkorrekturen ähnlicher Länge sind die Arbeit, für die diese Methode gebaut ist. Einen Absatz umzuformulieren müsste alles Downstream neu setzen, diese Änderung gehört ins Quelldokument
Warum kann eine Font-Subset keine Zeichen aufnehmen, die sie nie enthielt?
Ein Ersetzungszeichen, das die eingebettete Subset nie enthielt, hat keinen Char-Code, zu dem es rückübersetzt werden könnte. Subset ein Produzent einen Font, decken seine /ToUnicode-CMap und Kodierung nur die Glyphen ab, die das ursprüngliche Dokument benutzte, und die Glyphen-Outlines für alles andere sind schlicht nicht in der Datei. Hat das Dokument in dieser Schrift nie ein großes E gedruckt, wählt keine Byte-Sequenz eines aus. Diese Grenze sitzt in der Datei, nicht im Werkzeug, das ersetzt
ReplaceLoadedDocumentText behandelt eine nicht kodierbare Ersetzung konservativ: Lässt sich auch nur ein einziges Zeichen nicht rekodieren, wird das ganze Vorkommen übersprungen. Es gibt keine Ausnahme und keinen halb ersetzen String, und der Originaltext bleibt lesbar. Im Datumsbeispiel oben muss die Ziffer 6 irgendwo in ebendieser Schrift existieren, damit der Umschrieb gelingt. Angenommen, die Schrift hat nur je „2025“ und ein paar Auftragssummen ohne 6 gedruckt: Die Daten bleiben, wie sie sind
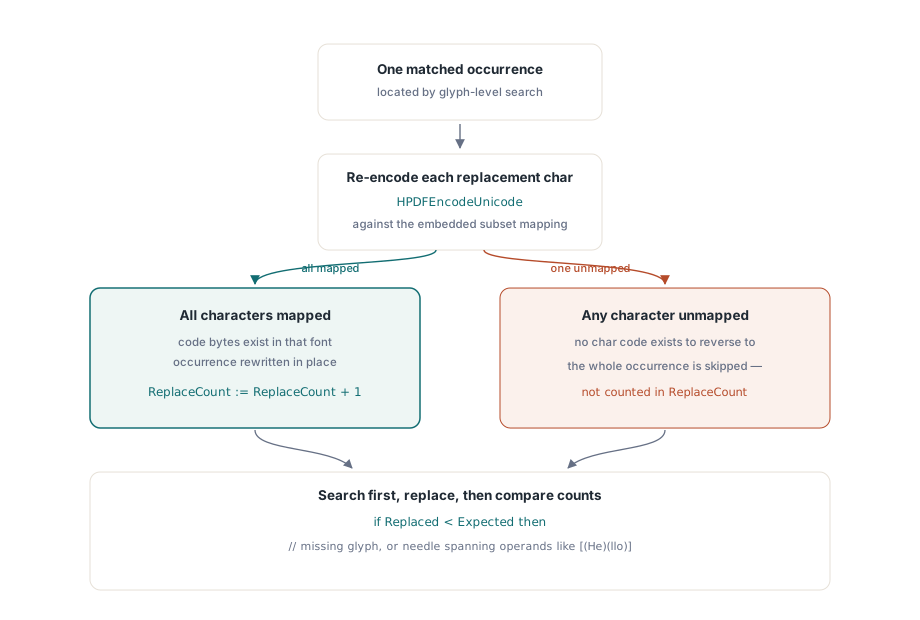
ReplaceCount meldet Operanden-Umschriebe, und ein über mehrere Operanden verteilter Match kann mehr als einen Umschrieb ausmachen. Ein Zähler unter der Trefferzahl heißt trotzdem, dass etwas übersprungen wurde, aber die exakte Antwort liefert die erneute Suche nach dem Replace. Was die zweite Suche findet, ist das, was übrig geblieben ist, mit Seite und Position
procedure ReplaceAndAudit(Pdf: THotPDF; const OldText, NewText: UnicodeString);
var
  Before, After: THPDFTextMatchArray;
  Rewrites, I: Integer;
begin
  // Die erneute Suche funktioniert nur, wenn NewText selbst nicht OldText enthält
  Pdf.SearchLoadedDocumentText(OldText, True, Before);
  Pdf.ReplaceLoadedDocumentText(OldText, NewText, True, Rewrites);
  Pdf.SearchLoadedDocumentText(OldText, True, After);
  WriteLn(Format('%d found, %d operand rewrites, %d left',
    [Length(Before), Rewrites, Length(After)]));
  for I := 0 to High(After) do
    WriteLn(Format('  left on page %d at (%.1f, %.1f)',
      [After[I].PageIndex + 1, After[I].X, After[I].Y]));
end;
Wenn die Subset knapp ist: Vorschau und Anwenden mit einem neuen Font
Für Vorkommen, die die Byte-Ebene-Methode nicht kodieren kann, nehmen PreviewLoadedPageTextReplacement und ApplyLoadedPageTextReplacement einen anderen Weg: Sie entfernen die gematchten Glyphen und malen die Ersetzung an Ort und Stelle mit einem Font Ihrer Wahl, in der Originalgröße und auf der Original-Grundlinie. Der Default THPDFLoadedTextReplacementOptions nutzt Arial in der Font-Größe des gematchten Texts, dimensioniert die Box auf die Breite des gematchten Texts und lässt Atomic an. Ein einzelner zurückgewiesener Match auf der Seite rollt dann die anderen zurück. Die Vorschau liefert einen Plan mit einem Ergebnis pro Match, jedes mit einem Status und, bei Zurückweisung, einem Reason
var
  Opts: THPDFLoadedTextReplacementOptions;
  Plan, Applied: THPDFLoadedTextReplacementPlan;
  I: Integer;
begin
  // Pdf ist ein geladenes THotPDF; PageIndex ist eine nullbasierte Seite, die die Prüfung markiert hat
  Opts := THPDFLoadedTextReplacementOptions.Default;
  Opts.Appearance.FontName := 'Arial';
  Opts.Appearance.OverflowPolicy := ltopShrinkToFit;
  Opts.Appearance.MinFontSize := 6;
  if not Pdf.PreviewLoadedPageTextReplacement(PageIndex, 'Acme Corp',
    'Apex Corporation', True, Opts, Plan) then
    for I := 0 to High(Plan.Results) do
      if Plan.Results[I].Status = ltrsRejected then
        WriteLn(Format('match %d at (%.1f, %.1f): %s',
          [I, Plan.Results[I].X, Plan.Results[I].Y, Plan.Results[I].Reason]));
  if (Plan.RejectedCount = 0) and (Plan.ReadyCount > 0) then
  begin
    Pdf.ApplyLoadedPageTextReplacement(Plan, Applied);
    WriteLn(Format('%d of %d matches applied',
      [Applied.AppliedCount, Applied.MatchedCount]));
  end;
end;
Die Zurückweisungsgründe lohnen das Ausdrucken, weil sie direkt auf die Seitengeometrie abgebildet sind. Ein Match, der von einer Textzeile in die nächste hinübergeht, wird zurückgewiesen, ebenso vertikaler Text. Mit der Default-Policy ltopReject für Überlauf wird auch eine Ersetzung zurückgewiesen, die nicht in die gematchte Breite passt. ltopShrinkToFit stattdessen schraubt die Größe Richtung MinFontSize herunter, weshalb das Beispiel es für eine Ersetzung setzt, die fünf Zeichen länger ist als die Nadel. Eine Ersetzung mit Zeichen, die der gewählte Font nicht zeigen kann, wird ebenfalls zurückgewiesen
Der Plan trägt einen Fingerabdruck des Seiten-Contents und der Fonts. Ändert irgendetwas die Seite zwischen Vorschau und Anwenden, wirft ApplyLoadedPageTextReplacement eine EInvalidOpException, statt in eine Seite zu schreiben, die die Vorschau nie gesehen hat. Seiten mit unbalancierten q/Q- oder BT/ET-Paaren und Dokumente mit Signaturfeldern werfen eine EArgumentException; signierte Dokumente verlangen inkrementelle Updates, damit die signierte Revision intakt bleibt
Die Ersetzung auf Byte-Ebene geht zuerst, und der Font-Tausch-Weg läuft nur auf Seiten, wo die Prüfung den alten Text noch findet. Der Umschrieb auf Byte-Ebene behält den Original-Font, seine Metriken und sein Kerning, daher passt der bearbeitete Text zu seinen Nachbarn in der Zeile. Der Vorschau-Weg malt in einer anderen Schrift, und in einer Zeile, die in einer kondensierten oder Serifen-Schrift gesetzt ist, sieht ein aufmerksamer Leser die Änderung. Wenn das Ziel ist, dass Text verschwindet statt umformuliert zu werden, ist echte Content-Entfernung das bessere Werkzeug; der Artikel zum Redigieren und Umstrukturieren geladener PDFs in Delphi behandelt diesen Weg
Was sich in der gespeicherten Datei ändert
Ein von ReplaceLoadedPageText bearbeiteter Content Stream wird unkomprimiert gespeichert. Der Stream wird zum Bearbeiten dekodiert, und wenn die neu gebauten Bytes zurückgeschrieben werden, fallen seine Einträge /Filter und /DecodeParms weg und /Length wird aufgefrischt. Das PDF ist gültig und rendert normal; der Preis ist eine größere Datei für jeden bearbeiteten Stream. Ein Batch über tausende Rechnungen sollte dieses Wachstum einplanen oder danach einen Komprimierungsdurchlauf fahren
Der Vorschau-und-Anwenden-Weg ändert ein wenig mehr. Eine angewandte Seite bekommt einen einzigen neuen unkomprimierten Content Stream anstelle ihres ursprünglichen /Contents, dazu ihre eigene Kopie des Resource-Dictionary mit dem Ersetzungs-Font. Alles andere im Dokument bleibt unangetastet: unberührte Streams behalten ihre Kompression, vorhandene Fonts und Bilder werden nicht umgeschrieben, und Seiten ohne Treffer werden nie zum Schreiben geöffnet. Wie umgeschriebene Objekte beim Speichern in der Cross-Reference-Struktur landen, behandelt der Artikel zu Object Streams und inkrementellen Updates in HotPDF
Suche, Ersetzen auf Byte-Ebene, Vorschau-und-Anwenden, Extraktion und Redaktion laufen alle auf demselben Content-Stream-Interpreter, von Delphi 5 bis zum aktuellen RAD Studio, ohne externe Abhängigkeiten. Methoden-Referenzen, die Ersetzungs-Optionen und eine Trial-Version stehen auf der HotPDF-Delphi-Component-Produktseite