Lässt eine PDF einen Font nicht einbetten, rendert die HotPDF-Komponente diesen Text mit einem installierten Windows-Font, den HPDFMapBaseFontToSystem auswählt: Sie dekodiert den /BaseFont-Namen, schneidet den Stil-Anteil ab, probiert mehrere Schreibweisen durch, bis GDI bestätigt, dass die Familie installiert ist, misst fehlende Standard-14-Breiten an metrikkompatiblen Fonts und wandelt Einbyte-Codes vor dem Zeichnen in Unicode um. Jeder dieser Schritte existiert, weil der naheliegende Ansatz an echten Dateien scheitert. Der RenderLoadedPageToBitmap-Seiten-Renderer kommt mit eingebetteten Programmen gut klar; dies hier ist die Geschichte der Fonts, die gar nicht in der Datei sind
Warum zeichnet GDI lautlos die falsche Schrift für einen nicht eingebetteten Font?
GDI meldet nie einen fehlenden Font: Gibt man CreateFontIndirect einen ihm unbekannten Namen, wählt es lautlos einen Ersatz, oft eine andere Serifenschrift ohne Bold-Schnitt. Reicht man den PDF-Namen fast unverändert durch, treffen TimesNewRoman,Bold, TimesNewRomanPS-BoldMT und SegoeUI-Semibold allesamt nichts und kommen in dem heraus, was GDI zufällig wählt. Namen können noch übler sein. ISO 32000-1 §7.3.5 erlaubt, ein beliebiges Byte als #xx zu schreiben, und CJK-Producer buchstabieren Fontnamen routinemäßig als escapte UTF-8- oder Legacy-Codepage-Bytes; ein Mapper, der den Dekodier-Schritt überspringt, fragt GDI nach einer Schriftart, die aus den Escapes selbst benannt ist. HPDFMapBaseFontToSystem dekodiert die Escapes zuerst, liefert eine gültige UTF-8-Bytefolge als ihre Zeichen zurück und liest andere hohe Bytes in der System-Codepage
Wer den Stil abschneidet, stößt auf Heuristik-Gelände. Ein Komma beendet immer die Familie (Arial,Bold ergibt Arial), aber ein Bindestrich nur dann, wenn das Wort dahinter ein Stil ist: Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra oder Condensed. Diese Regel lässt MS-Mincho ganz und macht aus Calibri-Light ein Calibri. HotPDF probiert dann Schreibweisen der Familie, gefolgt von Schreibweisen der Familie ohne PSMT-, MT- oder PS-Suffix. Diese Schreibweisen decken jede Wahl von Leerzeichen an den Stellen ab, an denen ein Wort beginnen kann: vor einem Großbuchstaben, dem ein Kleinbuchstabe vorangeht (MyriadPro wird zu Myriad Pro), am letzten Großbuchstaben einer Folge, der ein Kleinbuchstabe folgt (UIGothic), und nach einem führenden MS (MSPGothic) – von der vollständig getrennten Form bis hinunter zum Namen, wie er dasteht; über vier solcher Stellen hinaus werden nur die getrennte und die zusammengeschriebene Form probiert. Leerzeichen darf man nicht blind setzen, denn Windows hält manche Wörter zusammen: SimSun ist exakt unter dieser Schreibweise installiert, während MicrosoftYaHei, MicrosoftJhengHei und MSPGothic zu Microsoft YaHei, Microsoft JhengHei und MS PGothic gehören. Ein Mapper, der vor jeden inneren Großbuchstaben ein Leerzeichen setzt, sucht MicrosoftYaHei als Microsoft Ya Hei und findet es nie. Ein Kandidat gilt als installiert, wenn CreateFontIndirect gefolgt von GetTextFace den angeforderten Namen zurückliefert, oder wenn die name-Tabelle des gewählten Fonts ihn als Familie führt, als voller oder typografischer Familienname in jeder Sprache; die Antwort wird pro Name gecacht, Dokumente mit vielen nicht installierten Fonts befragen Windows also nicht bei jedem Namen auf jeder Seite
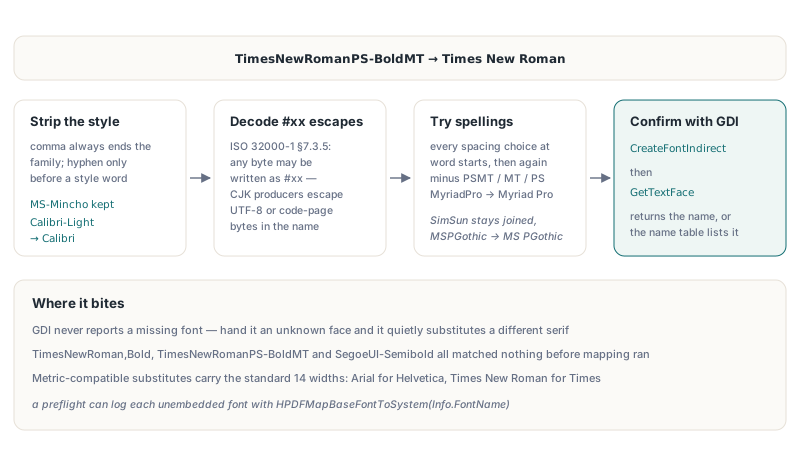
Weil die Mapping-Funktion in der Unit HPDFRenderFontMetrics öffentlich ist, kann ein Preflight-Report zeigen, mit welcher installierten Familie jeder nicht eingebettete Font gerendert wird — mit der Font-Enumeration, die THotPDF für geladene Dokumente ohnehin anbietet:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
Wie misst HotPDF Standard-14-Fonts ohne /Widths?
HotPDF misst die fehlenden Advances am installierten Font mit denselben Metriken, denn ISO 32000-1 §9.6.2.2 erlaubt den Standard-14-Fonts, /Widths wegzulassen, und die Bibliothek schifft keine AFM-Tabellen mit. Arial trägt Helvetica-Metriken, Times New Roman trägt Times und Courier New trägt Courier, HPDFMeasureBaseFontWidths erzeugt also das passende Face bei lfHeight = -1000 und ruft GetCharWidth32W; bei dieser Höhe ist das Ergebnis bereits in den 1/1000-em-Einheiten, die PDF-Breiten benutzen. Der Renderer wandelt jeden Code zuerst über /Encoding, /BaseEncoding und /Differences in Unicode um, mit StandardEncoding als Default. SVG-Export und Textextraktion teilen sich eine weitere Falle: Ein Standard-Type-1-Font ganz ohne /Encoding hat dennoch eine implizite StandardEncoding, und ein Decoder, der sie nicht mitbaut, trägt keine Encoding-Information, also geht jede gemessene Breite ungenutzt. HotPDF liefert die implizite StandardEncoding und markiert sie als vordefiniertes Encoding; sie stattdessen in den CMap-Namen-Pfad zu leiten, würde jeden Code als 0 dekodieren, und jede Breite folgt diesem Wert
Bold, Italic und die 1-basierten Font-Descriptor-Flags
Der /Flags-Eintrag eines Font-Descriptors nummeriert seine Bits ab 1, nicht ab 0, ForceBold ist also Bit 19 ($40000) und Italic ist Bit 7 ($40), gemäß ISO 32000-1, Tabelle 123. Der Off-by-one liegt leicht drin: Ab null gezählt sieht $20000 wie ForceBold aus, aber es ist Bit 18, SmallCap, und ein Gewichtstest darauf rendert jede Small-Caps-Schrift fett. Die Falle versteckt sich auch gut, denn /FontDescriptor ist fast immer eine indirekte Referenz: Code, der nur direkte Objekte liest, erreicht den Flags-Zweig überhaupt nie, und dieselbe Blindheit ignoriert /Widths 12 0 R und setzt Text mit einem Fallback-Advance. Indirekte Referenzen aufzulösen und die Bit-Konstanten an Tabelle 123 festzupinnen gehört zusammen:
const
  // ISO 32000-1, Tabelle 123, zählt Bitpositionen ab 1
  FD_ITALIC     = $00040;  // Bit 7
  FD_SMALLCAP   = $20000;  // Bit 18, keine Gewichtung
  FD_FORCEBOLD  = $40000;  // Bit 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;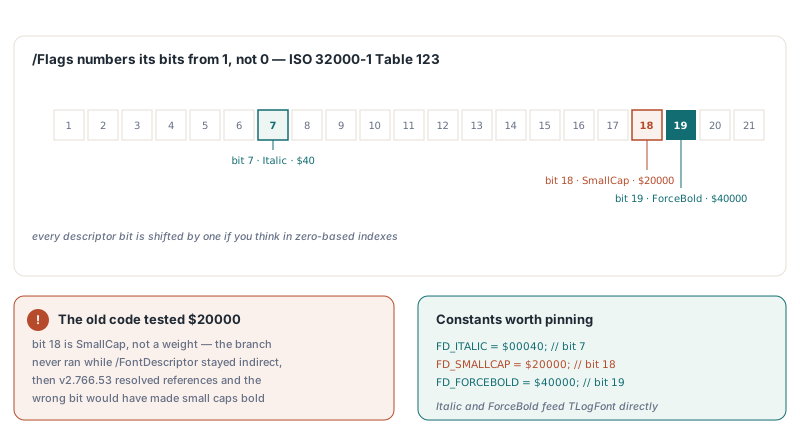
Warum bekommen CJK-Fonts mit UCS2-CMap die falschen Breiten?
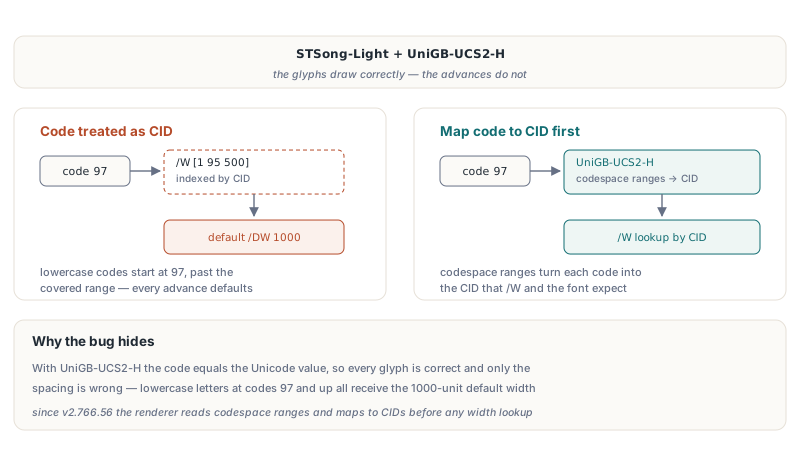
CJK-Text mit einer vordefinierten UCS2-CMap zeichnet die richtigen Glyphen, aber die falschen Abstände, wenn ein Renderer den Code als CID behandelt – denn /W ist per CID indiziert, nicht per Zeichencode. Mit STSong-Light und UniGB-UCS2-H fällt der Code zufällig mit dem Unicode-Wert zusammen, GDI zeichnet also die richtigen Zeichen, und der Fehler versteckt sich in den Advances: Kleinbuchstaben kommen als Codes ab 97 an, liegen außerhalb eines /W-Eintrags wie [1 95 500] und bekommen alle die Default-Breite /DW von 1000. Der HotPDF-Renderer liest Codes durch die CMap-Codespace-Bereiche (ISO 32000-1 §9.7.6.2) und bildet sie auf CIDs ab, bevor er Breiten nachschlägt. Er arbeitet aus den eingebauten UCS2- und UTF16-Tabellen und eingebetteten CMap-Streams; eine Identity-Näherung für etwas wie GBK-EUC-H würde nur so tun, als sei sie unterstützt, während sie falsche Ausgabe produziert, also wird sie absichtlich nicht benutzt
Warum werden akzentuierte Zeichen auf chinesischem Windows zu Fragezeichen?
Einbyte-Codes dürfen nie an die ANSI-(„A“)-GDI-Funktionen durchgereicht werden, denn GetGlyphOutlineA und GetGlyphIndicesA interpretieren Bytes in der System-Codepage, während TextOutA den Zeichensatz des gewählten Fonts benutzt. Auf einem chinesischen System wird das Arial-Byte $A9 (das Copyright-Zeichen in Windows-1252) zu einem GBK-Führende-Byte und als „?“ gerendert, und jeder Outline-Pfad, der die A-Funktionen ruft, stolpert direkt hinein. HotPDF fragt den realisierten Font mit GetTextCharset nach seinem Zeichensatz, wandelt ihn über TranslateCharsetInfo in eine Codepage um, schickt das Byte durch MultiByteToWideChar und ruft die W-Funktionen; Symbol-Fonts benutzen stattdessen U+F000 plus den Code. Encodings, die mit Windows-1252 nicht einverstanden sind – /Differences, StandardEncoding, MacRomanEncoding – werden in Unicode umgesetzt, bevor irgendein System-Font sie sieht
Wie weit kommt das Zeichnen mit System-Fonts?
System-Font-Rendering ist von Natur aus eine Näherung, und lokalisiertes Windows dreht dabei eine Schraube: GetTextFace meldet den Familiennamen in der Systemsprache, eine reine Namensvergleich würde Microsoft YaHei auf chinesischem Windows oder Yu Mincho auf japanischem Windows also als fehlend beurteilen. Deshalb wird ein Face, das unter anderem Namen zurückkommt, ebenfalls in der name-Tabelle des Fonts nachgeschlagen. Metrische Kompatibilität gibt es für die Familien Helvetica, Times und Courier; Symbol mappt auf Symbol und ZapfDingbats auf Wingdings, was ein Notbehelf statt einer Entsprechung ist. Der Preflight oben läuft durch das /Resources-Dictionary jeder Seite, Fonts, die nur aus Form XObjects heraus referenziert werden, brauchen also einen eigenen Durchlauf. Lässt sich ein Code immer noch nicht zeichnen, meldet ihn das Tracking nicht aufgelöster Glyphen zur Zeichenzeit – ein besseres Signal als der Blick auf Thumbnails
Die dauerhafte Antwort sitzt auf der Autor-Seite. HotPDF selbst schreibt mit FontEmbedding per Default auf True, ersetzt also einen eingebetteten Arial sogar dann, wenn der Code SetFont mit Helvetica aufruft, und eingebetteter Text läuft durch den eingebetteten Font-Glyphen-Renderer statt durch eines der Rateverfahren oben. Eine billige Absicherung für eingehende Dateien ist eine Warnung vor dem Rendern, wenn eine gemappte Familie nicht in der Screen-Font-Liste steht:
// VCL: Screen.Fonts listet installierte Familiennamen auf (Forms-Unit)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
Für die vollständige Komponente, inklusive Seiten-Rendering, Textextraktion und Font-Subsetting auf der Schreibseite, siehe die HotPDF Delphi PDF component Produktseite