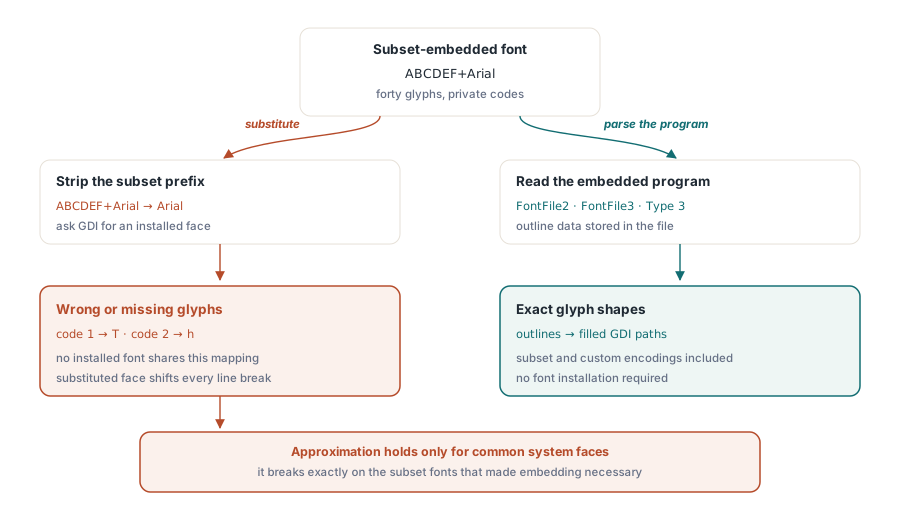
Eine Thumbnail-Leiste für einen Stapel Lieferantenrechnungen sieht auf den ersten Blick richtig aus: Tabellenlinien an ihrem Platz, Logo scharf, Spalten fluchten. Zoomt man in eine hinein, ist der Kundenname eine Reihe hohler Kästchen, während die Summenspalte Buchstaben hält, die nichts ergeben. Jede kaputte Rechnung verwendet dieselbe Schrift, ABCDEF+Arial, und jede davon liest sich in einem Desktop-PDF-Viewer auf derselben Maschine einwandfrei. Der Thumbnail-Code nahm den Schriftnamen, warf das sechsstellige Subset-Tag weg, fragte Windows nach Arial und reichte ihm die rohen Zeichencodes von der Seite. Diese Codes gehörten nie zu Arial. Ein treues Bitmap aus einer PDF-Seite zu bekommen verlangt zwei Dinge: den Content-Stream der Seite als Programm auszuführen und Text aus den in der Datei gespeicherten Glyphenkonturen zu zeichnen statt aus den Schriften, die die Rendering-Maschine zufällig installiert hat
Eine PDF-Seite ist etwas, das man ausführt
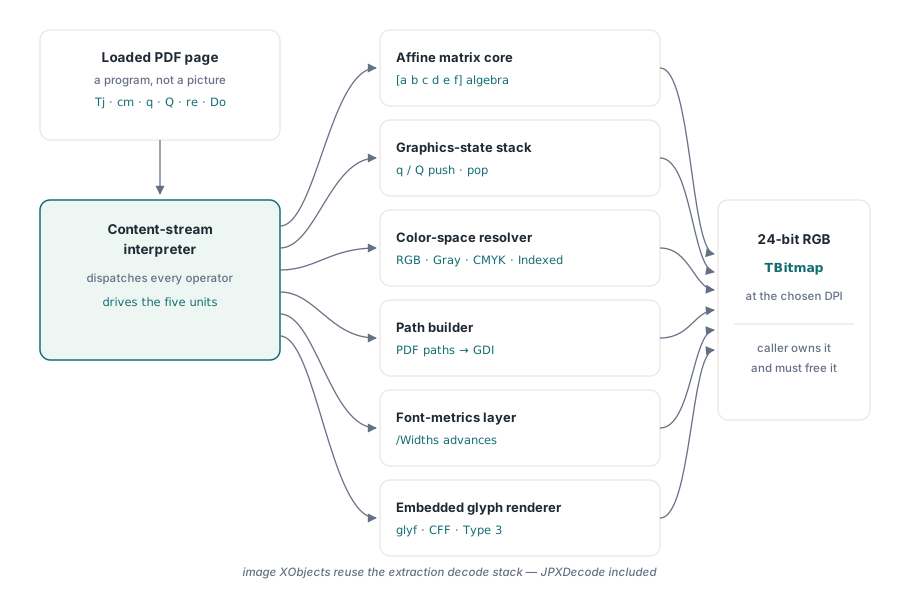
ISO 32000-1 §8 beschreibt eine Seite als Content-Stream: Operatoren, die die Transformationsmatrix mit cm ändern, den Grafikzustand mit q und Q sichern und wiederherstellen, Pfade bauen, Schriften mit Tf wählen, Glyphen mit Tj platzieren und Bilder und Formen mit Do malen. Nichts in der Datei hält fest, wie irgendein Pixel aussieht. Um zu einem Bitmap zu kommen, muss etwas diesen Stream gegen eine aktuelle Transformationsmatrix, einen Zustandsstapel, einen Clipping-Pfad und ein Paar aus Füll- und Strichfarbräumen ausführen und dann alles rasterisieren, was herauskommt
HotPDFs RenderLoadedPageToBitmap ist dieser Interpreter. Er läuft durch die Operatoren einer geladenen Seite, hält Matrix und Grafikzustand so, wie die Spezifikation sie definiert, löst Farbräume auf, verwandelt PDF-Pfade in GDI-Pfade und nimmt Glyphenvorschübe aus dem /Widths-Array der Schrift statt aus GDI. Bild-XObjects laufen durch dieselben Dekodierer, die die Bibliothek für Extraktion nutzt, also tauchen jeder Bildfilter, den HotPDF für die Extraktion dekodieren kann, eingeschlossen JPXDecode-komprimierte JPEG-2000-Bilder, auch in der gerenderten Seite auf
Eine geladene Seite in Delphi in ein TBitmap rendern
THotPDF.RenderLoadedPageToBitmap(PageIndex, DPI) nimmt einen nullbasierten Seitenindex und eine Auflösung in Punkten pro Zoll, wobei 72 DPI eine PDF-Einheit auf ein Pixel mappen, und liefert ein neues 24-Bit-RGB-TBitmap. Ein Index außerhalb des Bereichs oder eine Seite, die sich nicht bauen lässt, liefert nil, statt zu werfen. Das passt zu einem Viewer, der eine kaputte Seite überspringen und mit dem Rest weitermachen sollte. Das Bitmap gehört dem Aufrufer
var
  Pdf: THotPDF;
  Bmp: TBitmap;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('report.pdf') > 0 then
    begin
      Bmp := Pdf.RenderLoadedPageToBitmap(0, 144);  // erste Seite bei 144 DPI
      if Bmp <> nil then
      try
        Image1.Picture.Assign(Bmp);
      finally
        Bmp.Free;  // der Aufrufer besitzt das zurückgegebene Bitmap
      end;
    end;
  finally
    Pdf.Free;
  end;
end;
Die Pixeldimensionen folgen aus dem sichtbaren Bereich der Seite. Der Renderer nimmt /CropBox, geclippt auf /MediaBox, wie ISO 32000-1 §14.11.2 die sichtbare Region definiert, verwendet /MediaBox, wenn keine brauchbare Crop-Box existiert, skaliert mit DPI/72 und rundet auf. Eine US-Letter-Seite ohne eigene Crop-Box kommt deshalb bei 72 DPI exakt als 612×792 Pixel zurück. Eine A4-Seite (595.28×841.89 Punkte) bei 96 DPI ergibt 794×1123, denn 793.7 und 1122.5 runden beide auf. Ein /Rotate von 90 oder 270 tauscht Breite und Höhe, und der Flip vom PDF-Ursprung unten links zum GDI-Ursprung oben links passiert innerhalb der Seitenmatrix, sodass das Bild aufrecht und ohne Nachbearbeitung ankommt
DPI ist der einzige Skalierungsregler, und er deckt die üblichen Jobs ab. Thumbnails mit 36 oder 48 DPI sind klein und schnell. Eine Bildschirmvorschau mit 96 oder 144 DPI entspricht der typischen Anzeigedichte. Export mit 300 DPI liefert drucktaugliche Ausgabe — zum Preis eines 2550×3300-Bitmaps pro Letter-Seite, grob 24 MiB je Stück bei drei Bytes pro Pixel
Warum zeichnen ersetzte Schriften die falschen Glyphen?
Falsche Glyphen in einer gerenderten PDF bedeuten fast immer, dass der Rasterizer eine installierte Schrift für die in der Datei eingebettete eingesetzt hat. Die Abkürzung aus dem Rechnungsbeispiel ist verlockend, weil sie oft funktioniert: Subset-Präfix aus /BaseFont streifen, eine GDI-Schrift unter dem Restnamen anfordern, den String zeichnen. Bei plain Arial- oder Times-New-Roman-Text mit Standard-Encoding beschwert sich niemand
Subset-Schriften brechen das als Erstes. Ein Subset trägt vielleicht nur die vierzig Glyphen, die ein Dokument benutzt, nummeriert in einer Reihenfolge, die nur dieser einen Datei gehört, also könnte Code 1 „T“ sein und Code 2 „h“. Eine installierte Schrift kann das nicht wissen. Eigene Encodings, Symbol- und Barcode-Schriften und jede Schriftart, die auf der Rendering-Maschine fehlt, scheitern aus demselben Grund. Und selbst wenn der Ersatz jedes Zeichen hat, weichen seine Vorschubbreiten von der eingebetteten Schrift ab, also wachsen oder schrumpfen Zeilen, und rechtsbündige Spalten fluchten nicht mehr
Text aus dem eingebetteten Font-Programm zeichnen
HotPDF zeichnet Text aus den in der PDF gespeicherten Font-Programmen. Trägt eine Schrift ein eingebettetes TrueType-Programm (/FontFile2) oder ein CFF-Programm (/FontFile3), wird jede Glyphe aus diesen Daten konturiert und als GDI-Pfad gefüllt, mit Schriftgröße, Textmatrix und aktueller Transformationsmatrix zu einer Transformation verschachtelt. Subset-Schriften, private Encodings und Schriftarten, die die Maschine nie gesehen hat, kommen in ihren echten Formen heraus. Wie ein Zeichencode zu einer Glyphe gelangt, hängt vom Schrifttyp ab, und jeder Typ hat seine eigene Falle:
- TrueType-Konturen: Konturen stammen aus den Tabellen
glyfundloca. Quadratische Segmente werden zu den kubischen Béziers angehoben, die GDI zeichnet — eine exakte Konversion —, der implizierte On-Curve-Punkt zwischen zwei aufeinanderfolgenden Off-Curve-Punkten wird rekonstruiert, und Composite-Glyphen steigen in ihre Komponenten hinab, mit der Transformation jeder Komponente angewendet - CID-keyed TrueType:
Type0-Schriften überCIDFontType2erreichen Glyphen-IDs über/CIDToGIDMap, entwederIdentity(auch die Voreinstellung, wenn der Eintrag fehlt) oder einen expliziten Map-Stream, und nehmen Vorschübe aus/Wund/DW, sodass Zwei-Byte-Identity-H-Text um die richtige Menge weiterschreitet. Vordefinierte CJK-CMaps und eingebettete CMap-Streams dekodieren variabel lange Codes vor dem Lookup - CFF-Programme:
Type1C,CIDFontType0Cund in einen OpenType-Container gepacktes CFF laufen durch einen Type 2-Charstring-Interpreter, der Linien, Kurven, die Flex-Familie, Hint-Masken sowie lokale und globale Subroutinen-Aufrufe mit angewandtem Subroutinen-Bias beherrscht. CID-keyed Programme mappen jeden Code durch den Charset der Schrift — wichtig für Subsets, deren Glyphenreihenfolge von der CID-Reihenfolge abweicht — und wählen das private Wörterbuch je Glyphe überFDArrayundFDSelect - Simple TrueType-Schriften: Ein-Byte-Codes laufen durch die eingebettete
cmap, erst über die Unicode-Untertabellen (3,1) und (3,10), dann über die (3,0)-Symbol-Untertabelle, sowohl direkt als auch am U+F000-Spiegel, den Symbol-Schriften benutzen, und zuletzt über die alte Macintosh-(1,0)-Tabelle
Zwei Regeln setzen obendrauf auf. Das /Encoding-Wörterbuch einer simple Schrift wird in der Reihenfolge aufgelöst, die ISO 32000-1 §9.6.6 vorschreibt: /Differences überstimmen das Basis-Encoding, und das überstimmt die eingebaute Abbildung des Programms. TeX und andere PostScript-stämmige Toolchains stützen sich schwer darauf, also verdreht eine falsche Reihenfolge genau die Mathe- und Symboltexte, in denen eine falsche Glyphe am schwersten zu entdecken ist. Type3-Schriften, deren Glyphen kleine Content-Streams eigener Art sind, werden durch denselben Interpreter abgespielt, mit Font-Matrix, Schriftgröße und Textmatrix verschachtelt; Glyphenraum-/Widths laufen durch /FontMatrix, wie §9.6.5 es verlangt, und eine Glyphenprozedur, die eine d1-Bounding-Box deklariert, wird darauf geclippt, sodass eine missratene Barcode-Glyphe nicht außerhalb ihrer Zelle malen kann
Lässt sich ein einzelner Code nicht mappen, weil das Programm beschädigt ist oder dem Subset diese Glyphe fehlt, wird genau dieses eine Zeichen mit der installierten Schrift desselben Namens gezeichnet, während der Rest des Laufs die eingebetteten Konturen benutzt. Den ganzen Lauf fallen zu lassen würde das Problem verstecken; ein einzelner seltsamer Buchstabe fällt eher auf. Schriften ohne brauchbares eingebettetes Programm nehmen den Pfad über die installierte Schrift, beschrieben in Nicht-eingebettete Schriften mit Systemschriften rendern
Wie hält man wiederholtes Rendern schnell?
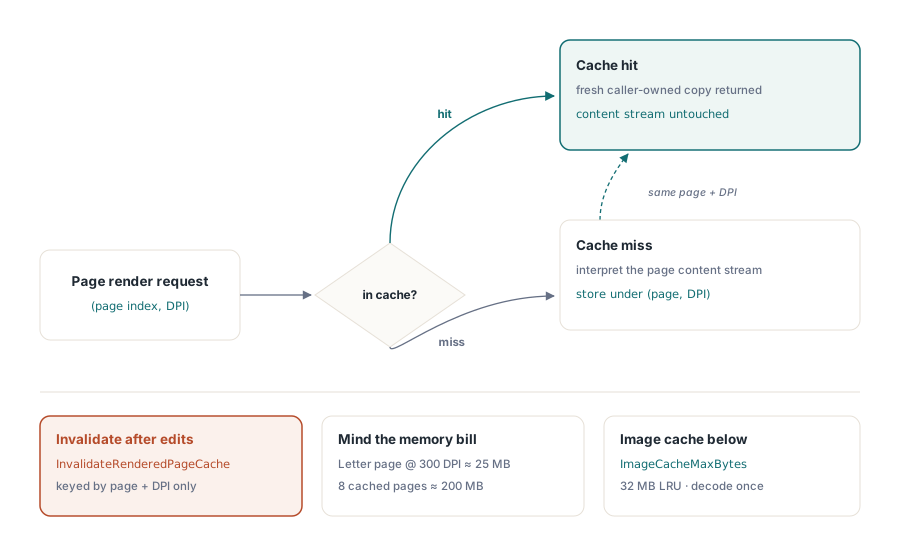
Für alles Interaktive den Aufruf RenderLoadedPageToBitmapCached statt der plain Methode nehmen. Sie hält kürzlich gerenderte Seiten in einem Most-Recently-Used-Cache, Schlüssel: Seitenindex, DPI und die aktuellen Render-Einstellungen (Color Intent, Overprint-Vorschau, Fallback-Policy und welche Optional-Content-Layer sichtbar sind), und ein Treffer gibt eine frische, aufrufereigene Kopie zurück, ohne den Content-Stream erneut zu interpretieren. Das Umschalten zwischen zwei Seiten oder eine Größenänderung, die dieselbe Seite mit derselben DPI neu anfordert, trifft jedes Mal den Cache. Für einen Einmal-Export, der jede Seite genau einmal besucht, ist das plain RenderLoadedPageToBitmap der bessere Aufruf, denn die gecachte Variante kopiert jedes Bitmap, das sie zurückgibt, und würde Seiten vorhalten, nach denen niemand wieder fragt
// Thumbnail-Leiste: der erste Durchlauf rendert, das Zurückscrollen trifft den Cache
Pdf.RenderCacheCapacity := 32;   // Eintragsgrenze; Voreinstellung ist 8
for I := 0 to Pdf.LoadedPageCount - 1 do
begin
  Bmp := Pdf.RenderLoadedPageToBitmapCached(I, 48);
  if Bmp <> nil then
  try
    ThumbList.AddThumbnail(I, Bmp);  // Ihr eigener UI-Code
  finally
    Bmp.Free;
  end;
end;

// Auch 300-DPI-Seiten cachen? Geben Sie dem Raster-Cache ein größeres Byte-Budget
// (Policy: THPDFCacheAdmissionPolicy)
if Pdf.GetCacheAdmissionPolicy(clkRaster, Policy) then
begin
  Policy.MaxTotalBytes := Int64(512) * 1024 * 1024;
  Pdf.SetCacheAdmissionPolicy(clkRaster, Policy);
end;

// Nach direkten Änderungen am Seiteninhalt:
Pdf.InvalidateRenderedPageCache;  // das nächste Rendering spiegelt die Änderung
RenderCacheCapacity ist nur eine von zwei Grenzen. Der Raster-Cache hat außerdem ein Byte-Budget, standardmäßig 128 MiB, mit einer Obergrenze von 64 MiB je Eintrag, und er rechnet beim Budgetieren vier Bytes pro Pixel. Angenommen, ein Viewer cached Letter-Seiten mit 300 DPI: Jeder Eintrag wird mit rund 32 MiB angerechnet, also passen drei hinein, was auch immer RenderCacheCapacity sagt. Mit 48 DPI wird dieselbe Seite mit etwa 0,82 MiB angerechnet, und bis zu 32 Thumbnails aus der Schleife oben bleiben in unter 27 MiB resident. Ist der Cache voll, verdrängt eine einmal angefragte Seite vielleicht keine oft angefragte; sie wird trotzdem gerendert und zurückgegeben, nur nicht behalten. Blättert ein Viewer in vorhersagbarer Reihenfolge, füllt PrefetchLoadedPages denselben Cache auf einem Worker-Thread voraus
Das Laden eines neuen Dokuments leert den Cache. Mehrere Seitenbearbeitungs-Aufrufe der Bibliothek selbst, etwa FlattenLoadedFormFields, werfen die betroffenen Seiten von selbst aus dem Cache; nach jeder direkten Änderung an Seitenobjekten oder Content-Streams rufen Sie InvalidateRenderedPageCache auf, denn der Cache kann nicht merken, dass sich die Bytes hinter einer Seite geändert haben. Darunter sitzt ein zweiter Speicher für dekodierte Bild-XObjects, begrenzt durch ImageCacheMaxBytes (standardmäßig 32 MiB), sodass ein Logo oder Briefkopf, der auf jeder Seite wiederkehrt, einmal pro Dokumentladen dekodiert wird statt bei jedem Do-Operator. InvalidateRenderedPageCache leert auch diesen. Sollen Thumbnails einen Anwendungsneustart überleben, deckt die Disk-Ebene des Render-Caches diesen Fall ab
Herausfinden, wann eine Seite angenähert wurde
Die meisten Seiten erreichen nie einen Fallback, denn der Renderer deckt weit mehr ab als Text und Bilder. CalGray-, CalRGB-, Lab- und ICC-basierte Farbräume werden mit dem gerade geltenden Rendering Intent konvertiert, den RenderColourIntent übersteuern kann, und ConfigureRenderICCWorkflow nimmt Proof- und Output-ICC-Profile für Softproofing entgegen. Indizierte Paletten, Separation- und DeviceN-Tints sowie gesampelte Type-0-Funktions-Farblookups sind abgedeckt. Funktionsbasierte, axiale, radiale und Mesh-Shadings rendern sowohl über den sh-Operator als auch über Shading-Patterns, und Transparency-Gruppen, Knockout-Gruppen sowie Alpha- oder Luminosity-Soft-Masks komponieren mit ihren Blend-Modes, wie in Blend-Mode-Gruppen und Luminosity-Masks beschrieben
Reale Dateien enthalten weiterhin Dinge, die sich nicht exakt zeichnen lassen: eine Ressource, die die Seite nennt, aber nie definiert; ein Bild, dessen Daten sich nicht dekodieren lassen; ein Form XObject, das sich selbst malt. RenderFallbackPolicy entscheidet, was dann passiert. Die Voreinstellung rfpIgnore zeichnet die nächste Annäherung und macht weiter. rfpReport tut dasselbe, zeichnet aber für jeden Fallback eine Diagnose auf, bis zu RenderFallbackDiagnosticLimit Einträgen (Voreinstellung 256). rfpStrict wirft stattdessen eine Exception, statt ein angenähertes Bitmap zurückzugeben. Form-Verschachtelung stoppt bei 32 Ebenen, und ein Form, das sich selbst referenziert, wird übersprungen, sodass eine kaputte oder feindliche Datei nicht unbegrenzt rekursieren kann
// rfpReport und THPDFRenderFallbackDiagnostics sind in HPDFPageRenderer deklariert
var
  Diags: THPDFRenderFallbackDiagnostics;
  J: Integer;
begin
  Pdf.RenderFallbackPolicy := rfpReport;
  Bmp := Pdf.RenderLoadedPageToBitmap(PageIndex, 150);
  try
    Diags := Pdf.GetLastRenderFallbackDiagnostics;
    for J := 0 to High(Diags) do
      Log.Add(Format('page %d: %s %s - %s', [PageIndex + 1,
        string(Diags[J].OperatorName), string(Diags[J].ObjectName),
        string(Diags[J].Reason)]));
    if Pdf.LastRenderFallbackDroppedCount > 0 then
      Log.Add(Format('%d more fallbacks not recorded',
        [Pdf.LastRenderFallbackDroppedCount]));
  finally
    Bmp.Free;  // Free ist auf nil gefahrlos
  end;
end;
QA- und Ingestion-Builds mit rfpReport fahren. Das Bitmap ist identisch zu dem, was rfpIgnore produziert, und das Protokoll zeigt, welche Seiten angenähert wurden und warum, bevor ein Kunde meldet, dass Seite 14 seltsam aussieht. rfpStrict bleibt der Archivkonvertierung vorbehalten, wo eine still angenäherte Seite schlimmer ist als eine fehlgeschlagene. Ein Cache-Treffer stellt die Diagnosen wieder her, die bei der ersten Erzeugung der Seite aufgezeichnet wurden, also liefert GetLastRenderFallbackDiagnostics dieselbe Antwort, ob die gecachte Variante nun Arbeit geleistet hat oder nicht
RenderLoadedPageToBitmap, die gecachte Variante und der Textpfad über eingebettete Glyphen sind Teil der HotPDF Delphi Component, einer nativen VCL-Bibliothek für Delphi und C++Builder ohne externe DLLs, die dieselben geladenen Dokumente, die Sie rendern, auch erzeugt, bearbeitet und aus ihnen Text extrahiert