Eine PDF, die von einer lokalen Platte sofort öffnet, kann mehrere Sekunden brauchen, um ihre erste Seite zu zeigen, wenn dieselben Bytes von einem HTTP-Server kommen, der Range-Requests beantwortet, obwohl die Datei nur ein paar Megabytes hat und die Leitung schnell ist. Bandbreite ist nicht das Problem. Die Anzahl der Requests ist es, und die Heilung besteht darin, hunderte winzige verstreute Lesevorgänge in ein paar Dutzend gecachte Blöcke zu verwandeln und dann nur weiter vorwegzulesen, solange das Zugriffsmuster sequenziell bleibt
Warum lädt dieselbe PDF von der Platte sofort und über HTTP im Schneckentempo?
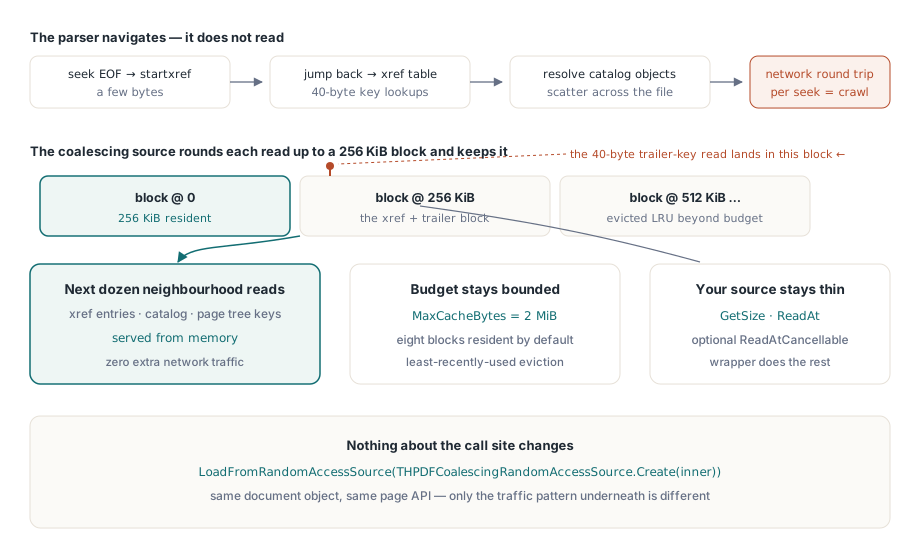
Ein PDF-Parser liest eine Datei nicht von vorne nach hinten. Er navigiert in ihr. Die Struktur in ISO 32000-1 §7.5 legt den Einstiegspunkt ans Ende: Der Parser sucht im letzten Kilobyte nach startxref, springt zurück zur Kreuzreferenz-Tabelle, löst das Trailer-Dictionary auf, folgt einer Referenz zum Katalog, dann zum Wurzelknoten des Seitenbaums, dann zu einem Seitenknoten, dann zum Ressourcen-Dictionary dieser Seite. Jeder Sprung liest ein paar Dutzend Bytes von einem anderen Offset, und eine inkrementell aktualisierte Datei wiederholt den Spaziergang einmal pro Revision entlang der /Prev-Kette
Auf einer lokalen Datei ist dieses Muster fast gratis, denn das Betriebssystem hält die umgebende 4-KiB-Page bereits in seinem Datei-Cache, und die zweite Lesung kostet eine Speicherkopie. Ein Netzwerktransport hat keine solche Lokalität. Jede Lesung wird zu einem Request mit eigener Latenz, und die Arithmetik ist brutal: Bei 40 ms pro Round Trip ergeben 300 kleine Lesungen zwölf Sekunden Wartezeit, während die Leitung meist idle sitzt. Weniger zu lesen ist keine Option, denn der Parser braucht exakt die Bytes, nach denen er fragt. Ändern kann sich nur, wie viel jeder physische Request zurückbringt
Ihren Transport in THPDFCoalescingRandomAccessSource einwickeln
HotPDF lädt Dokumente von jeder Klasse, die von THPDFRandomAccessSource abstammt, und THPDFCoalescingRandomAccessSource sitzt zwischen dieser Klasse und dem Parser. Jede Lesung wird auf einen ausgerichteten Block aufgerundet, und der Block bleibt im Speicher. BlockSize defaultet auf 262.144 Bytes, MaxCacheBytes auf 2.097.152, also bleiben acht Blöcke resident, und der am längsten nicht benutzte geht, wenn das Budget voll ist. Die 40-Byte-Nachfrage des Parsers nach einem Trailer-Schlüssel zieht die 256 KiB darum herum herein, und das nächste Dutzend Lesungen in dieser Nachbarschaft (Kreuzreferenz-Einträge, der Katalog, Seitenbaum-Schlüssel) kommt aus dem Speicher
Ihre eigene Klasse bleibt dünn. Zwei Methoden sind Pflicht: GetSize und ReadAt. Überschreiben Sie ReadAtCancellable, wenn Ihr HTTP-Client einen laufenden Request abbrechen kann, und überschreiben Sie IsRangeAvailable, wenn die Quelle ein noch laufender Download ist. Der Wrapper stellt diese Frage vor jedem Abruf: Liegt ein ganzer Block noch nicht vor, versucht er es erneut mit nur den angefragten Bytes, und fehlen auch die, kommt die Lesung verkürzt zurück, statt zu blockieren
type
  // TMyHttpClient steht für Ihre eigene HTTP-Client-Klasse
  THttpRangeSource = class(THPDFRandomAccessSource)
  private
    FClient: TMyHttpClient;
    FUrl: string;
    FSize: Int64;
  public
    constructor Create(const AUrl: string);
    function GetSize: Int64; override;
    function ReadAt(Offset: Int64; var Buffer; Count: Longint): Longint; override;
    function ReadAtCancellable(Offset: Int64; var Buffer; Count: Longint;
      CancellationToken: THPDFCancellationToken): Longint; override;
  end;

var
  Raw: THttpRangeSource;
  Cached: THPDFCoalescingRandomAccessSource;
  Pdf: THotPDF;
begin
  Raw := THttpRangeSource.Create('https://files.example.com/contract.pdf');
  // OwnsSource=True: der Wrapper gibt Raw frei; 256-KiB-Blöcke, 8-MiB-Budget
  Cached := THPDFCoalescingRandomAccessSource.Create(Raw, True, 262144, 8388608);
  Cached.MaxReadAheadBlocks := 8;   // gültiger Bereich 1..32
  Pdf := THotPDF.Create(nil);
  try
    // OwnsSource=True erneut: Pdf gibt Cached frei, das Raw freigibt
    if Pdf.LoadFromRandomAccessSource(Cached, True) > 0 then
      RenderFirstPage(Pdf);   // Ihr eigener Code
  finally
    Pdf.Free;
  end;
end;
Asynchroner Prefetch und adaptives Read-Ahead sind beide an, sobald der Wrapper konstruiert ist, also berührt das Sample nur die Fenster-Deckelung. Der Konstruktor validiert seine Argumente vorab: BlockSize muss zwischen 4.096 und 16.777.216 Bytes liegen, und MaxCacheBytes muss mindestens einen Block fassen, sonst bekommen Sie eine ERangeError, bevor ein einziges Byte sich bewegt hat
Den expliziten Wrapper brauchen Sie streng genommen nicht. Geben Sie LoadFromRandomAccessSource eine schlichte Quelle, wickelt HotPDF sie für Sie ein, mit der Raw-Cache-Politik, die Sie über GetCacheAdmissionPolicy und SetCacheAdmissionPolicy lesen und ändern können, mit der clkRawCompressed-Schicht: acht Einträge, insgesamt 2 MiB, 256 KiB pro Eintrag. Übergeben Sie Ihren eigenen THPDFCoalescingRandomAccessSource, wird er exakt so verwendet, wie er konfiguriert ist. Für alles, was ein Netzwerk überquert, bauen Sie den Wrapper selbst; Sie bekommen die Read-Ahead-Regler und den vollständigen Statistik-Record, während der automatische Pfad nur Hit-, Miss-, Aufnahme- und Verdrängungszähler über GetCacheAdmissionStatistics meldet
Wie weit sollte vorausgelesen werden?
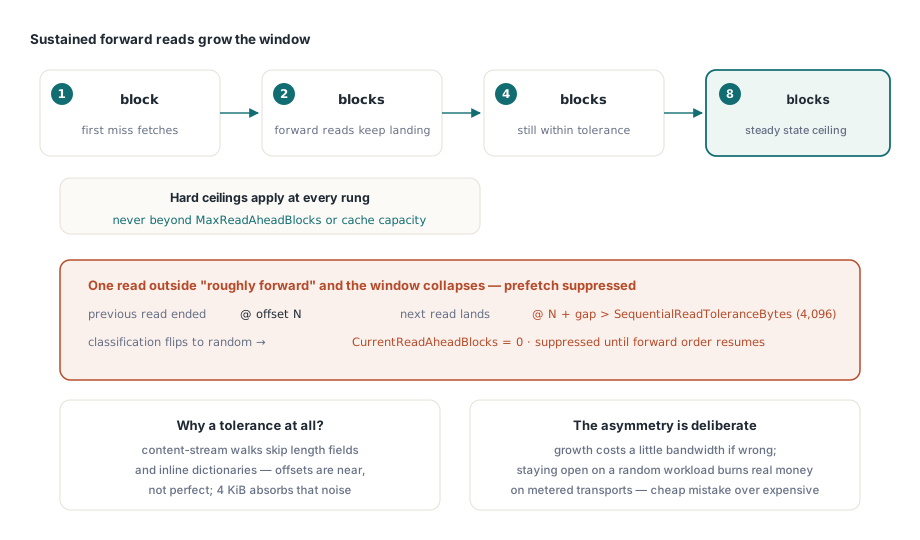
Adaptives Read-Ahead entscheidet pro Dokument. Mit gesetztem AdaptiveReadAheadEnabled wird jede Lesung, die der Parser durch das geladene Dokument macht, als sequenziell oder zufällig klassifiziert, und das Prefetch-Fenster folgt einem Punktestand. Zwei aufeinanderfolgende Vorwärtslesungen öffnen das Fenster auf zwei Blöcke, vier auf vier, sechs auf acht. Das Fenster übersteigt nie MaxReadAheadBlocks, und es übersteigt nie die Anzahl der Blöcke, die in MaxCacheBytes passen, also kann ein kleiner Cache nicht von seinem eigenen Prefetch überflutet werden
Eine Lesung, die rückwärts springt oder zu weit hinter dem Ende der vorherigen landet, lässt den Punktestand unter null fallen. Das Fenster schließt sich, jeder Prefetch, der woanders hin wollte, wird abgebrochen, und SuppressedPrefetchCount steigt. Zwei Vorwärtslesungen später öffnet sich das Fenster wieder mit einem einzelnen Block. Diese Verzögerung ist der Punkt: Eine glückliche zusammenhängende Lesung mitten in einer Kreuzreferenz-Jagd startet keine Spekulation neu
SequentialReadToleranceBytes, standardmäßig 4.096, definiert „zu weit“. Ein Parser, der einen Content-Stream abläuft, produziert keine perfekt zusammenhängenden Offsets; er überspringt hier ein Längenfeld, dort ein Inline-Bild-Dictionary. Lesungen, die innerhalb der Toleranz des vorherigen Endes landen, gelten weiterhin als vorwärts. Zu niedrig gesetzt und ein normaler Vorwärtsscan wird als zufällig klassifiziert, also kommt Read-Ahead nie in Gang. Zu hoch gesetzt und echte Zufallszugriffe sehen sequenziell aus, und Sie holen Megabytes, die niemand liest. Der Setter akzeptiert jeden Wert von null bis BlockSize und setzt den Punktestand bei einer Änderung zurück
Das Wachstum ist allmählich, der Kollaps sofort, und diese Asymmetrie ist Absicht. Zu viel zu holen bei einer Zufalls-Last verbrennt echte Bandbreite und bei einem getakteten Transport echtes Geld; zu wenig bei einer sequenziellen kostet ein paar zusätzliche Round Trips. Lassen Sie AdaptiveReadAheadEnabled eingeschaltet. Ausgeschaltet prefetcht der Wrapper nach jeder Lesung einen Block, egal nach welchem Muster, was genau das falsche Verhalten ist, solange der Parser zwischen Kreuzreferenz-Abschnitten hüpft
Die Klassifikation wird von dem Stream getrieben, aus dem HotPDF während eines Ladens liest. Wenn Ihr eigener Code ebenfalls Bytes durch den Wrapper zieht, etwa um eine Datei zu hashen oder einen Anhang zu extrahieren, rufen Sie nach jeder Lesung ObserveReadPattern mit Offset und Länge auf, damit das Fenster auch auf diesen Verkehr reagiert. Wenn Sie bereits wissen, welche Bytes als Nächstes gebraucht werden, startet PrefetchRange direkt einen Hintergrund-Abruf; IsPrefetchActive meldet, ob noch einer läuft
Heiße Blöcke behalten, wenn der Cache voll ist
Schlichte Least-Recently-Used-Verdrängung hat eine bekannte Schwäche. Ein langer Vorwärtsdurchlauf, etwa durch ein großes eingebettetes Bild, drückt jeden Block hinaus, zu dem der Parser immer wieder zurückkehrt, inklusive der Kreuzreferenz- und Katalog-Blöcke, die er auf der nächsten Seite wieder braucht. THPDFCoalescingRandomAccessSource zählt mit, wie oft jeder Block angefragt wurde, und sobald das Budget voll ist, kommt ein neuer Block nur in den Cache, wenn er mindestens so oft angefragt wurde wie der Block, den er ersetzen würde. Sonst geht die Lesung direkt an Ihre Quelle für genau die angefragten Bytes, und RejectionCount und FrequencyRejectionCount halten es fest
Diese Regel ist standardmäßig an (das AdaptiveAdmission-Konstruktorargument). ConfigureCacheAdmission ändert das Byte-Budget, die Deckelung pro Eintrag, ein optionales Eintragsanzahl-Limit und die Aufnahmeregel an einem laufenden Wrapper; sie bricht jeden laufenden Prefetch ab und stutzt den Cache auf der Stelle auf die neuen Limits
Cancellation, die den Transfer tatsächlich stoppt
Prefetch läuft auf einem einzelnen Hintergrund-Thread, und der Wrapper bricht ihn ab, sobald es sich nicht mehr lohnt, ihn zu Ende zu bringen. Eine Vordergrund-Lesung für Bytes außerhalb des prefetchten Bereichs bricht ihn ab, also wartet die Seite, die der Benutzer angefragt hat, nie hinter spekulativem Verkehr. Eine Zufallslesung bricht ihn ab. Den Wrapper zu zerstören oder CancelPrefetch oder ClearCache aufzurufen bricht ihn ab und wartet, bis der Thread endet. Jedes davon setzt das THPDFCancellationToken, das der Prefetch-Thread in Ihr ReadAtCancellable hineinreicht
Ob die Bytes tatsächlich aufhören zu fließen, hängt von Ihrem Override ab. Das Default-ReadAtCancellable auf THPDFRandomAccessSource prüft das Token vor und nach einem schlichten ReadAt, was für eine File Share reicht, aber eine halb fertige 256-KiB-HTTP-Antwort bis zum Ende laufen lässt. Ein Client, der den Response-Body in Chunks liest, kann das Token zwischen den Chunks prüfen und abbrechen:
function THttpRangeSource.ReadAt(Offset: Int64; var Buffer;
  Count: Longint): Longint;
begin
  Result := ReadAtCancellable(Offset, Buffer, Count, nil);
end;

function THttpRangeSource.ReadAtCancellable(Offset: Int64; var Buffer;
  Count: Longint; CancellationToken: THPDFCancellationToken): Longint;
var
  Status: Integer;
begin
  if CancellationToken <> nil then
    CancellationToken.ThrowIfCancellationRequested('http range read');
  // GetRange und ihr Callback sind die API Ihres Clients: er sendet
  // „Range: bytes=Offset-(Offset+Count-1)“ und ruft das Callback zwischen Body-Chunks auf
  Result := FClient.GetRange(FUrl, Offset, Count, Buffer, Status,
    function: Boolean
    begin
      Result := (CancellationToken <> nil) and
        CancellationToken.IsCancellationRequested;
    end);
  // 200 statt 206 bedeutet, der Server hat Range ignoriert und die ganze Datei geschickt
  if Status <> 206 then
    raise EStreamError.CreateFmt('Range request not honored (HTTP %d)', [Status]);
  if CancellationToken <> nil then
    CancellationToken.ThrowIfCancellationRequested('http range read');
end;
Die Statusprüfung deckt die Falle ab, die die meisten HTTP-Quellen zuerst treffen. RFC 9110 §14 erlaubt einem Server, einen Range-Header zu ignorieren und mit 200 und der vollständigen Repräsentation zu antworten, und manche CDN- und Proxy-Konfigurationen tun genau das für bestimmte Dateien. Eine Quelle, die die ersten Count Bytes einer 200-Antwort kopiert, reicht dem Parser Bytes ab Offset null, egal welchen Offset sie angefragt hat. Auch die Rückgabewerte zählen: Der Wrapper wirft eine EStreamError, wenn ReadAt eine negative Anzahl oder mehr Bytes als angefragt meldet, und er behandelt null als Datenende
Das einzige Token ungleich null, das Ihre Quelle empfängt, gehört zum Prefetch-Thread. Parser-Lesungen während eines Ladens erreichen Ihr ReadAtCancellable mit nil-Token, also ist das Stoppen des Ladens selbst ein separater Schalter: Weisen Sie THotPDF.OperationCancellationToken ein Token zu, und das Dokument-Laden prüft es unterwegs. Dasselbe Token-Modell treibt die Queue, die in Hintergrund-Rendering mit einer Request-Queue beschrieben wird, also kann ein Viewer ein Laden, seine Renders und seinen spekulativen Netzverkehr von einem einzigen Schließen-Handler aus abbrechen
Die Range-Cache-Statistiken lesen
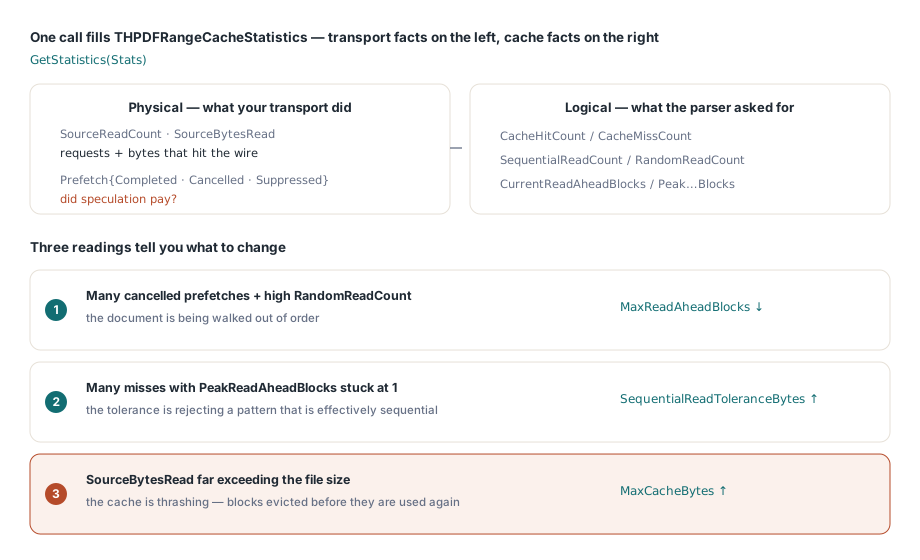
GetStatistics füllt einen THPDFRangeCacheStatistics-Record, der auseinanderhält, was Ihr Transport tat und was der Cache tat. SourceReadCount und SourceBytesRead sind physischer Verkehr. CacheHitCount und CacheMissCount sind logischer Verkehr. SequentialReadCount und RandomReadCount zeigen, wie das Zugriffsmuster klassifiziert wurde, CurrentReadAheadBlocks und PeakReadAheadBlocks zeigen, wie weit das Fenster sich öffnete, und die vier Prefetch-Zähler zeigen, ob sich die Spekulation gelohnt hat. CachedRangeCount, CachedBytes, EvictionCount und RejectionCount beschreiben den Cache selbst
var
  S: THPDFRangeCacheStatistics;
begin
  Cached.GetStatistics(S);
  Log(Format('physical %d reads / %d bytes, hits %d, misses %d',
    [S.SourceReadCount, S.SourceBytesRead, S.CacheHitCount, S.CacheMissCount]));
  Log(Format('pattern: %d sequential, %d random, peak window %d blocks',
    [S.SequentialReadCount, S.RandomReadCount, S.PeakReadAheadBlocks]));
  Log(Format('prefetch: %d issued, %d completed, %d canceled, %d suppressed',
    [S.PrefetchRequestCount, S.PrefetchCompletedCount,
     S.PrefetchCancelledCount, S.SuppressedPrefetchCount]));
  Log(Format('cache: %d blocks / %d bytes, %d evicted, %d rejected',
    [S.CachedRangeCount, S.CachedBytes, S.EvictionCount, S.RejectionCount]));

  // Ablehnungen auf einem meist sequenziellen Dokument: ihm mehr Raum geben
  if S.RejectionCount > S.CacheHitCount then
    Cached.ConfigureCacheAdmission(16 * 1024 * 1024, Cached.BlockSize, 0);
end;
Drei Ablesungen sagen Ihnen, was zu ändern ist. Viele abgebrochene Prefetches neben einer hohen Zufallslesungs-Anzahl bedeuten, dass das Dokument in falscher Reihenfolge durchlaufen wird, also senken Sie MaxReadAheadBlocks und hören auf, für Bandbreite zu zahlen, die Sie wegwerfen. Viele Misses mit einem auf 1 feststeckenden Peak-Fenster bedeuten, dass die Toleranz ein effektiv sequenzielles Muster abweist, also erhöhen Sie SequentialReadToleranceBytes. SourceBytesRead weit über der Dateigröße bedeutet, dass Blöcke verdrängt werden, bevor sie wieder verwendet werden; erhöhen Sie MaxCacheBytes, bevor Sie irgendetwas anderes anfassen. Die Ablehnungsschwelle im Sample ist unsere eigene Startheuristik, also justieren Sie sie an Ihrem Verkehr
Linearisierte Dateien ändern die Rechnung
Wenn Sie den Producer kontrollieren, verwandelt das Linearisieren des Dokuments das Problem, statt es zu justieren. ISO 32000-1 Anhang F stellt die Objekte der ersten Seite und eine Hint-Tabelle an den Dateianfang, also kann ein Viewer Seite eins aus den ersten Bytes rendern, ohne den Rest anzufassen. HotPDF legt diesen Pfad über GetProgressiveLinearizedLoadInfo und ReadProgressiveLinearizedFirstPageSection offen, die beide dieselbe THPDFRandomAccessSource nehmen, die Sie auch für Coalescing einwickeln würden; die Schreibseite ist in linearisierte PDFs mit Hint-Tabellen erzeugen behandelt
Die beiden Techniken lassen sich kombinieren. Coalescing macht jedes Dokument über eine langsame Leitung erträglich, inklusive Dateien von Drittanbietern, die Sie nicht neu speichern können; Linearisierung bringt die erste Seite schnell bei Dokumenten, die Sie selbst erzeugen. Dateien auf einer lokalen Platte, die zu groß für den Speicher sind, sind ein anderes Problem ohne Round-Trip-Latenz, die sich amortisieren ließe, und die Mapped-File- und Lazy-Stream-Pfade in dem Direct-File-API-Workflow passen besser zu ihnen
Die Random-Access-Source-Klassen, der Coalescing-Wrapper, die Cache-Aufnahmepolitiken und die Aufrufe für progressives linearisiertes Laden kommen alle mit HotPDF, einer nativen Delphi- und C++Builder-PDF-Komponente mit vollem Quellcode. Lizenzierung und die vollständige API-Referenz stehen auf der HotPDF-Delphi-PDF-Komponentenseite