Das erste Objekt einer linearisierten PDF muss die exakte Länge der Datei angeben, in der es sitzt, byte-genau, und es muss innerhalb der ersten 1024 Bytes erscheinen. ISO 32000-1 Anhang F nennt diesen Eintrag /L, und ein Reader, der ihn von der realen Dateigröße abweichen sieht, wird angewiesen, das Dokument als gewöhnliche PDF zu behandeln und jede Linearisierungs-Hint darin zu ignorieren. Der Writer muss also die Länge einer Datei ausdrucken, die er noch nicht fertig geschrieben hat, neben dem Offset eines Hint-Streams, dem Ende der ersten Seite und der Position einer Cross-Reference-Tabelle nahe dem Dateiende. Alle vier Zahlen rücken, sobald sich irgendwas vor ihnen in der Größe ändert
Der Lohn heißt Fast Web View. Eine gewöhnliche PDF hält ihre Cross-Reference-Tabelle am Ende, ein Browser, dem ein 200-seitiger eingescannter Bericht übergeben wird, kann Seite 1 also nicht orten, bevor das letzte Byte da ist; eine linearisierte Datei rückt Seite 1 und einen kleinen Cross-Reference-Abschnitt nach vorn, sodass ein Client mit HTTP-Range-Requests die erste Seite früh malt. Was folgt, ist die Writer-Seite. Das Reader-Bild liefert die Erklärung zu PDF-Linearisierung und Fast Web View
Wie HotPDF eine linearisierte Datei anordnet
HotPDF schreibt linearisierte Ausgaben, wenn THotPDF.LinearizeOutput auf True steht, und die Datei folgt der physischen Ordnung, die Anhang F vorschreibt, Teil für Teil. Nach dem Header kommt das Linearisierungsparameter-Dictionary, dann der Cross-Reference-Abschnitt der ersten Seite samt Trailer, der Katalog mit den übrigen Dokumentebenen-Objekten, der primäre Hint-Stream, die erste Seite mit jedem Objekt, das sie braucht, die restlichen Seiten der Reihe nach, die zwischen späteren Seiten geteilten Objekte, alles Übrige und schließlich die Haupt-Cross-Reference-Tabelle
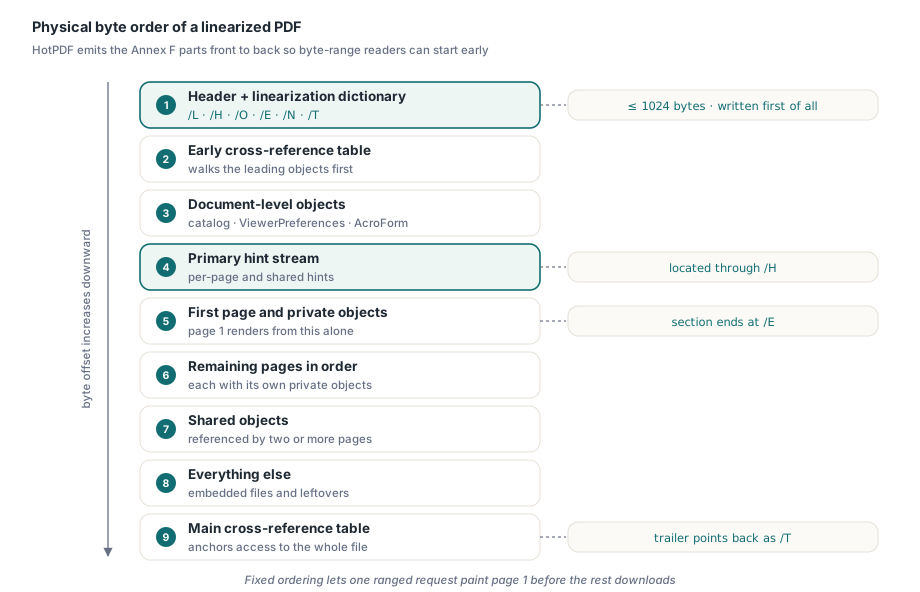
Nichts im Dokumentmodell sagt, zu welchem Teil ein Objekt gehört. Das arbeitet der Writer beim Speichern von EndDoc aus dem Referenzgraphen aus, indem er von jedem Seitenobjekt aus läuft und zählt, wie viele Seiten jedes indirekte Objekt erreichen. Ein Objekt, das nur eine Seite erreicht, wandert in deren Abschnitt. Ein von mehreren Seiten erreichtes Objekt ist geteilt, mit einer Wendung, die eine flüchtige Lektüre der Spezifikation übersieht: Ist Seite 1 unter den Nutzerseiten, wandert das Objekt trotzdem in den Erste-Seite-Abschnitt, denn Seite 1 muss allein aus den führenden Bytes rendern können. Nur rein zwischen späteren Seiten geteilte Objekte warten im geteilten Teil. Der Katalog, worauf auch immer seine Einträge /ViewerPreferences, /OpenAction, /Threads und /AcroForm zeigen, und das Verschlüsselungs-Dictionary eines geschützten Dokuments bilden die Dokumentebenen-Gruppe. Seitenbaum-Knoten werden in den hinteren Teil geschoben, damit sie die erste Seite nie aufblähen
Öffnet man die Ausgabe in einem Hex-Editor, wirkt die Nummerierung rückwärts. Der vordere Block, vom Linearisierungs-Dictionary bis zum Hint-Stream, trägt die höchsten Objektnummern der Datei, während alles danach ab 1 nummeriert ist. Der kleine Cross-Reference-Abschnitt vorne deckt genau diesen hohen Block ab, die Haupttabelle deckt 1 bis N ab
Eine Record-Initialisierungsfalle in Partitionslisten
Listen wie diese schreibt man naturgemäß als Record mit dynamischem Array plus separatem Zähler, und genau diese Form versteckt eine Delphi-Falle. Der Compiler initialisiert die verwalteten Felder eines lokalen Records. Das schlichte Integer daneben bekommt nichts. Unter Win32 hält der Stack-Slot oft zufällig null, der erste Append landet also bei Index 0 und jeder Test läuft grün; unter Win64 kann der Slot Reste halten, und der erste Append schreibt an einen beliebigen Index
type
  TPartList = record
    Values: TArray<Integer>;  // verwaltet: vom Compiler geleert
    Count: Integer;           // unverwaltet: was der Stack gerade hielt
  end;

procedure Append(var List: TPartList; Value: Integer);
begin
  if List.Count = Length(List.Values) then
    SetLength(List.Values, List.Count * 2 + 16);
  List.Values[List.Count] := Value;
  Inc(List.Count);
end;

procedure BuildParts;
var
  FirstPage, Shared: TPartList;
begin
  FirstPage := Default(TPartList);   // erforderlich, nicht kosmetisch
  Shared := Default(TPartList);
  Append(FirstPage, 12);
  Append(Shared, 40);
end;
HotPDFs Writer weist jeder Partitionsliste Default zu, bevor er sie anfasst. Ein grüner Win32-Lauf sagt nichts darüber, ob so ein Record initialisiert wurde
Warum muss das Layout konvergieren, bevor das erste Byte geschrieben wird?
Weil der Datei-Kopf Offsets hält, die nach hinten zeigen, und die Ziffernzahl dieser Offsets alles hinter sich verschiebt. Der Erste-Seite-Trailer trägt einen /Prev-Eintrag mit dem Byte-Offset der Haupt-Cross-Reference-Tabelle. Schreiben Sie diesen Offset als 99998, dann stellen Sie fest, dass die Tabelle wirklich bei 100003 landet, und der Trailer wächst um eine Ziffer. Der Erste-Seite-Abschnitt wächst mit, jedes Objekt dahinter rückt um ein Byte, und die Haupttabelle sitzt jetzt bei 100004. Ein einziger Durchlauf trifft das nur durch Glück
HotPDF bricht den Kreislauf in zwei Zügen. Das Parameter-Dictionary wandert in einen festen 384-Byte-Slot, mit Leerzeichen gepolstert, sodass /L, /H, /E und /T beliebig viele Ziffern fassen können, ohne ein einziges Objekt zu verschieben; bräuchte der Dictionary-Text je mehr als 384 Bytes, würde der Schreibvorgang eine Exception werfen, statt die Datei zu verschieben. Damit bleibt /Prev die einzige freie Variable, und sie läuft durch eine Fixpunkt-Schleife. Jedes Objekt wird zunächst in einen Zähl-Stream serialisiert, der Längen protokolliert und keine Bytes behält. Ein Layout-Durchlauf weist dann Abschnitt für Abschnitt Offsets zu und berichtet, wo die Haupttabelle landen würde, und diese Antwort wird die Eingabe des nächsten Durchlaufs. Die Schleife stoppt, wenn der vorgeschlagene Offset stillsteht, und gibt nach acht Versuchen mit einer Exception auf
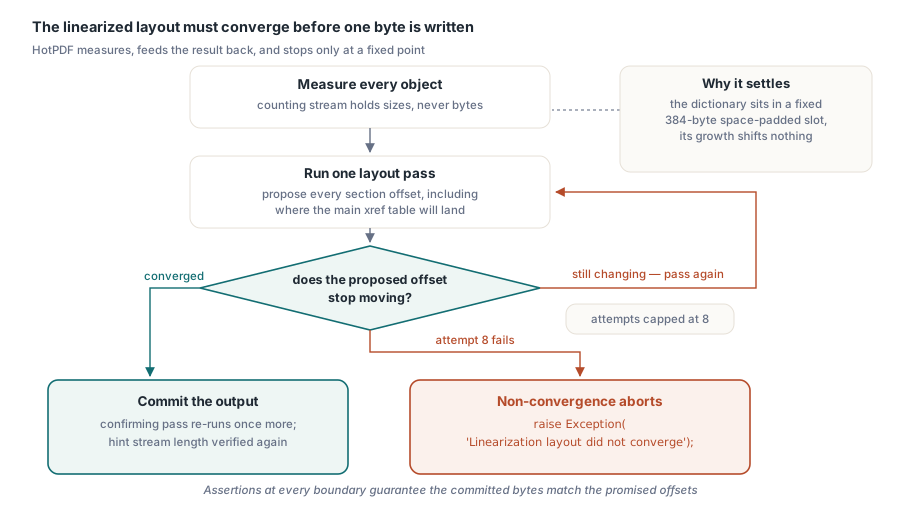
Nur eine Ziffernzahländerung verschiebt etwas, ein dritter Durchlauf ist also nur nahe einer Zehnerpotenz-Grenze nötig, etwa im Fall 99998. Nach der Konvergenz fährt der Writer einen bestätigenden Durchlauf, baut den Hint-Stream mit echten Offsets neu und prüft, dass sich seine Länge nicht änderte; die Offsets sitzen in Feldern fester Breite, Platzhalter- und finale Version müssen also übereinstimmen. Danach geht die Ausgabe direkt in den Ziel-Stream, ohne gepufferte zweite Kopie, und an jeder Abschnittsgrenze werden die geschriebenen Bytes mit dem versprochenen Offset verglichen. Eine Abweichung wirft aus EndDoc
Hint-Tabellen, und wo Anhang F zwei Lesarten zulässt
Der primäre Hint-Stream trägt zwei Tabellen. Die Page-Offset-Hint-Tabelle hält für jede Seite fest, wie viele Objekte ihr Abschnitt enthält, wie lang dieser Abschnitt in Bytes ist und von welchen geteilten Objekten sie abhängt. Die Shared-Object-Hint-Tabelle listet die Länge jeder Gruppe geteilter Objekte. Mit beiden kann ein Reader Seite 37 direkt anfordern, und der /S-Eintrag des Streams gibt die Position innerhalb des Streams an, wo die geteilte Tabelle beginnt
Zwei Details in Anhang F F.4 gehen leicht schief. Das erste: Die in den Hint-Tabellen gespeicherten Offsets sind logische Offsets, berechnet, als existierte der primäre Hint-Stream nicht. Das erste Seitenobjekt und das erste geteilte Objekt sitzen physisch beide hinter dem Hint-Stream, der Writer subtrahiert also die Länge des Hint-Objekts, bevor er ihre Offsets aufzeichnet. Ein Writer, der stattdessen physische Offsets notiert, landet mit jeder resultierenden Range-Anfrage exakt um die Größe des Hint-Objekts daneben
Das zweite ist eine echte Mehrdeutigkeit. Der Text von F.4 beschreibt jede Tabelle als einen durchgehenden Bit-Stream, höchstwertiges Bit zuerst, und listet die Shared Groups der ersten Seite und die späteren Shared Groups als zwei getrennte Sequenzen. Hint-Streams im Umlauf polstern jede Spalte auf eine Byte-Grenze und behandeln die Shared Groups als eine kombinierte Liste, und das ist die Form, die Hint-lesende Clients nachweislich akzeptieren. HotPDF schreibt das byte-ausgerichtete, kombinierte Layout. Das ist die richtige Seite: Eine Tabelle, die dem Buchstaben von F.4 genügt, sich für die lesenden Clients aber verkantet, scheitert genau dort, wo Linearisierung einlen sollte, und ein Download der ganzen Datei legt das Problem nie offen
Linearisierte Ausgaben aus Delphi einschalten
Auf der API-Seite ist der Schalter ein Boolean. LinearizeOutput defaultet auf False, und der Writer fragt es ab, wenn EndDoc das Dokument serialisiert — also zusammen mit den anderen Ausgabeoptionen vor BeginDoc setzen und in Ruhe lassen. Jeder oben beschriebene Fehlschlag (Nicht-Konvergenz, ein übergroßes Parameter-Dictionary, eine Grenzabweichung, die unten behandelte 4-GiB-Decke) zeigt sich als Exception aus EndDoc, was einen Fallback unkompliziert macht
procedure WriteReport(const FileName: string; Linearize: Boolean);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.FileName := FileName;
    PDF.Version := pdf17;
    PDF.LinearizeOutput := Linearize;   // vor BeginDoc setzen
    PDF.BeginDoc;                       // erzeugt Seite 1
    PDF.CurrentPage.TextOut(72, 72, 0, 'Quarterly summary');
    PDF.AddPage;
    PDF.CurrentPage.TextOut(72, 72, 0, 'Details');
    PDF.EndDoc;                         // Layout und Schreiben passieren hier
  finally
    PDF.Free;
  end;
end;

procedure PublishReport(const FileName: string);
begin
  try
    WriteReport(FileName, True);
  except
    on E: Exception do
    begin
      LogWarning('Linearization failed: ' + E.Message);  // Ihr eigener Logger
      WriteReport(FileName, False);                       // stattdessen eine gewöhnliche PDF
    end;
  end;
end;
Der Fallback erzeugt eine gewöhnliche PDF, die jeder Viewer öffnet; er verliert nur die schnelle erste Seite. Für eine Report-Pipeline ist dieser Trade leicht, denn ein träges erstes Zeichnen ist ein Ärgernis, ein fehlender Bericht ein Vorfall
Die Deployment-Seite schlägt den Code. Linearisierung zahlt sich nur aus, wenn der Server HTTP-Range-Requests ehrt; ein Endpoint, der die Datei als Ganzes streamt, kauft Ihnen einen langsameren Schreibvorgang und eine größere Datei für nichts. Lassen Sie LinearizeOutput aus für Dateien, die gemailt, angehängt oder heruntergeladen werden, bevor sie jemand ansieht. Schalten Sie es an für Dokumente, die ein Browser direkt von einer URL öffnet, nachdem Sie bestätigt haben, dass die Antwort Accept-Ranges: bytes trägt
Warum schaltet LinearizeOutput Object Streams ab?
Weil jeder Hint-Tabellen-Eintrag eine Byte-Range beschreibt, und ein in einen /ObjStm-Container gepacktes Objekt keine eigene Byte-Range hat; es existiert nur als Scheibe eines anderen komprimierten Streams, der als Ganzes geholt und entpackt werden muss. Mit aktiviertem LinearizeOutput schreibt HotPDF klassische Text-Cross-Reference-Tabellen und ungepackte indirekte Objekte, selbst wenn auch UseXRefStream oder UseObjectStreams gesetzt ist. Der linearisierte Pfad hat beim Speichern Vorfahrt, Ihr Code hat also keinen Konflikt aufzulösen
Der Preis ist die Dateigröße, denn die kleinen Dictionarys, die ein Object Stream zusammenkomprimieren würde, bleiben jetzt lose. Zählt kompakte Ausgabe mehr als die Latenz der ersten Seite, ist der Trade-off in Object Streams und inkrementelle Updates in HotPDF ausgebreitet. Office-Exporteure geraten von der anderen Seite in dieselbe Spannung, weshalb manche von ihnen das in hybride Cross-Reference-Streams in Office-erzeugten PDFs beschriebene Layout ausgeben
Linearisierung braucht zudem PDF 1.2 oder neuer. Bei niedrigerer Version stuft HotPDF das Dokument beim Speichern auf 1.2 hoch. Mit gesetztem StrictVersionLock wirft es stattdessen eine Exception — eine Version, die Sie mit Absicht festgenagelt haben, sollte sich nicht hinter Ihrem Rücken ändern
Die 4-GiB-Decke für linearisierte Ausgaben
Hint-Tabellen speichern Offsets und Längen in 32-Bit-Feldern, eine linearisierte Datei kann also nichts jenseits von 4 GiB adressieren, und HotPDF erzeugt lieber keine, als Offsets zu schreiben, die überlaufen. Die Decke kommt von den Feldbreiten, die Anhang F definiert
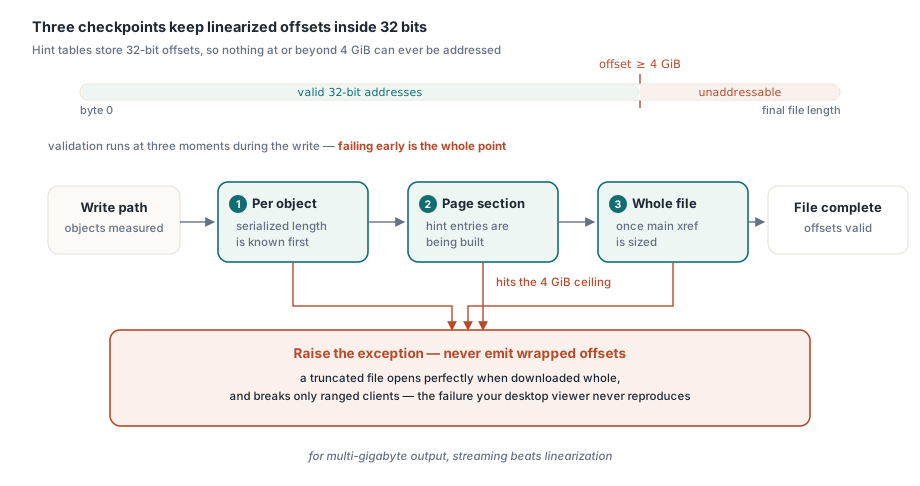
Der Check läuft an drei Stellen, alle bevor das erste Byte das Ziel erreicht: an jedem Objekt, sobald seine serialisierte Länge feststeht, an jeder Seitensektionslänge beim Aufbau der Hint-Einträge und an der finalen Dateilänge, sobald die Haupt-Cross-Reference-Tabelle dimensioniert ist. Überlaufende Offsets wären die schlechteste Art zu scheitern: Ein Viewer, der die ganze Datei lädt, kann die Hints ignorieren, während der Byte-Range-Client zu falschen Bytes springt — Desktop-Tests reproduzieren den Fehler also nie. Für Ausgaben im Multi-Gigabyte-Bereich ist die Streaming-Route in der Direct File API für große PDF-Workflows die richtige Adresse
Prüfen, ob eine eingehende Datei linearisiert ist
THotPDF.IsLoadedLinearized meldet, ob das geladene Dokument sich als linearisiert ausweist. Die Prüfung passiert vor dem Parsen: HotPDF liest bis zu 1024 Bytes ab Position null der Quelle, findet das erste Objekt und schaut in diesem Objekt nach /Linearized mit dem Wert 1. Kommentare, Literal-Strings und Hex-Strings werden übersprungen, der Name in einem String zählt also nicht, und der Scan stoppt an stream oder endobj. Akzeptiert wird nur 1 oder ein Äquivalent wie 1.0
Die Antwort wird beim Laden gecacht, denn wenn der Anwendungscode fragt, hat der Parser die Stream-Position längst verschoben und LoadFromFile seinen Quell-Stream bereits freigegeben
Das Flag meldet, was die Datei behauptet. Anhang F fügt eine zweite Bedingung hinzu: /L muss zur tatsächlichen Dateilänge passen, und ein nach der Linearisierung angehängtes inkrementelles Update bricht diese Passung, Reader behandeln die Datei also wieder als gewöhnliche. Eine Pipeline, die Dateien von Editoren annimmt, die ihre Saves anhängen, kann die beiden Zahlen selbst vergleichen
// Ihr eigener Helfer, nicht Teil von HotPDF: vergleicht /L mit der realen Größe
// Vereinfachtes Parsen; es nimmt ein einzelnes Leerzeichen nach /L an
function DeclaredLengthMatches(const FileName: string): Boolean;
var
  FS: TFileStream;
  Head: AnsiString;
  ActualSize: Int64;
  P, Q: Integer;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    ActualSize := FS.Size;
    SetLength(Head, 1024);
    SetLength(Head, FS.Read(Head[1], 1024));
  finally
    FS.Free;
  end;
  P := Pos(AnsiString('/L '), Head);
  Result := P > 0;
  if not Result then
    Exit;
  Inc(P, 3);
  Q := P;
  while (Q <= Length(Head)) and (Head[Q] in ['0'..'9']) do
    Inc(Q);
  Result := StrToInt64Def(string(Copy(Head, P, Q - P)), -1) = ActualSize;
end;

procedure InspectUpload(const FileName: string);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    if PDF.LoadFromFile(FileName) <= 0 then
      Exit;
    if not PDF.IsLoadedLinearized then
      Writeln('Not linearized')
    else if not DeclaredLengthMatches(FileName) then
      Writeln('Linearized, but modified after linearization')
    else
      Writeln('Ready for Fast Web View');
  finally
    PDF.Free;
  end;
end;
LinearizeOutput und IsLoadedLinearized sind Teil der HotPDF Delphi Component für Delphi und C++Builder, und deren Produktseite dokumentiert, wie sie mit Cross-Reference-Streams, Object Streams und Version Lock zusammenspielen