Das Content-Stream-Fragment [(Reference)-333(Manual)] TJ malt zwei Wörter mit einem klaren Abstand dazwischen und enthält doch gar kein Leerzeichen. Der Abstand ist Stiftbewegung: ISO 32000-1 §9.4.3 weist den Reader an, den nächsten Glyphen um 333 Tausendstel der Fontgröße nach rechts zu verschieben, bevor Manual gemalt wird. Ein Extraktor, der Zeichen kopiert und Geometrie ignoriert, liefert ReferenceManual, und ein Suchindex, der davon gespeist wird, matcht die Phrase “Reference Manual” nie. TeX-Ausgabe, viele Distiller-Dateien und die meisten Blocksatz-Layouts trennen Wörter auf diese Weise
Bei Zeilenbrüchen hakt’s von der anderen Seite. Ein hochgestelltes Superscript zerreißt seine Zeile in zwei, ein diagonales DRAFT-Wasserzeichen kommt mit einem Zeichen pro Zeile, und ein beschnittener Proof führt die Druckerei-Beschnittzeile an, die kein Viewer je zeigt. Keine dieser Dateien ist kaputt. Jede benutzt eine legale Art, Text zu platzieren, die ein zeichenkopierender Extraktor falsch liest
Wortabstände, neu gebaut aus der Glyphengeometrie
THotPDF.ExtractLoadedPageText in der HotPDF Delphi Component entscheidet Wortgrenzen aus Glyphenpositionen, und ein Leerzeichen im Stream ist nur eines der Signale, die sie liest. Entlang der Schreibrichtung der vorigen Glyphe misst sie den Abstand vom Ende derer eigenen Breite zum Ursprung des aktuellen Glyphen und fügt ein Leerzeichen ein, wenn der Abstand 0,15 der Boxhöhe des aktuellen Glyphen überschreitet, gemessen von Ascent bis Descent im User Space. Für das TJ-Fragment oben liegt ein Drittel em für jeden gewöhnlichen Text-Font gemütlich hinter dieser Linie, als Seitentext gibt’s also Reference Manual
Zwei Bedingungen halten das Leerzeichen zurück. Nichts wird ergänzt, wenn der Text bis dahin schon mit einem Blank endet oder der nächste Glyph eines ist (space, tab, no-break space, ideographic space), Producer, die Leerzeichen zeigen, bekommen’s also nie doppelt. Nichts wird auch zwischen zwei CJK-Zeichen ergänzt. Ideographien, Kana, Hangul und Fullwidth-Formen zählen alle, denn Blocksatz dehnt eine chinesische oder japanische Zeile auseinander, ohne dass diese Dehnung eine Wortgrenze bedeutet. Unabhängig davon fällt eine Glyphen-Box mit Höhe null auf die Tf-Größe als Höhe zurück. Jede Zahl, die die Regel nutzt, liegt auf den Glyphen-Records, eine Datei mit komisch wirkenden Abständen lässt sich also Glyphe für Glyphe nachspielen
uses
  SysUtils, HPDFDoc, HPDFContentStream;

// Gibt die Abstände aus, die ExtractLoadedPageText in Leerzeichen verwandeln würde.
// Nur horizontaler Text; ExtractLoadedPageGlyphs liefert den Seiten-
// Content-Stream ohne Form-XObject-Text und ohne den Crop-Filter
procedure DumpWordGaps(Pdf: THotPDF; PageIndex: Integer);
var
  Glyphs: THPDFGlyphArray;
  I: Integer;
  Height, Gap: Double;
begin
  if not Pdf.ExtractLoadedPageGlyphs(PageIndex, Glyphs) then
    Exit;
  for I := 1 to High(Glyphs) do
  begin
    if Glyphs[I].Vertical or Glyphs[I - 1].Vertical then
      Continue;
    // Ascent-to-Descent-Höhe der Glyphen-Box, im User Space
    Height := Sqrt(Sqr(Glyphs[I].QuadX[3] - Glyphs[I].QuadX[0]) +
      Sqr(Glyphs[I].QuadY[3] - Glyphs[I].QuadY[0]));
    if Height <= 0 then
      Height := Abs(Glyphs[I].FontSize);
    // Abstand vom Ende der eigenen Breite der vorigen Glyphe
    Gap := Glyphs[I].BaselineStartX - Glyphs[I - 1].GlyphEndX;
    if (Height > 0) and (Gap > 0.15 * Height) then
      Writeln(Format('U+%.4x gap %.2f height %.2f: space',
        [Glyphs[I].Unicode, Gap, Height]));
  end;
end;
Warum vom Ende der eigenen Glyphenbreite messen statt von der Stiftposition?
Weil die Stiftposition nach einem Glyphen bereits Spationierung enthält, die mit Wortgrenzen nichts zu tun hat. ISO 32000-1 §9.4.4 definiert die horizontale Verschiebung als Glyphenbreite mal Fontgröße, plus Character Spacing Tc, plus Word Spacing Tw, alles skaliert mit Horizontal Scaling Tz. Jeder Glyphen-Record trägt beide Enden: BaselineEndX / BaselineEndY halten die volle Verschiebung, während GlyphEndX / GlyphEndY nur den Font-Advance bei aktueller Größe und Tz halten. Beide laufen auseinander bei Dateien, die mit negativem Tc Tracking festziehen und den Raum danach nach jedem Glyphen über eine TJ-Anpassung zurückschicken. Von der Stiftposition aus gemessen sieht jede Rückgabe wie ein Abstand aus, und ein chinesischer Begriff wie “95后” kommt’s als “9 5 后” heraus. Von der eigenen Glyphenbreite gemessen gibt die Anpassung nur zurück, was Tc genommen hat, und der Begriff bleibt intakt
Die Schwelle hängt aus verwandtem Grund an der Glyphen-Boxhöhe statt an der Tf-Größe. Word-Exporte machen’s oft so: 1 Tf, und die echte Größe wandert in eine skalierte Tm, der Fontgröße-Operand liest sich also als 1, während der Text 10 Punkt hoch ist. Eine Regel, die an diesem Operand hängt, würde die Schwelle auf so einer Seite bei 0,15 Punkt ansiedeln, und gewöhnliche Kerning-Paare fingen an, als Wortgrenzen durchzugehen. Die Boxhöhe wird gemessen, nachdem jede Matrix angewandt wurde, 1 Tf mit skalierter Matrix und ein schlichtes 10 Tf produzieren also denselben Text
Zwei Grenzfälle folgen direkt aus der Geometrie. Eine Überschrift mit sehr weiter Spationierung, bei der Tc allein mehr als 0,15 der Texthöhe zwischen Buchstaben öffnet, extrahiert als S P A C E D. So sieht die Seite aus, und geben wir’s lieber so zurück, als eine Heuristik zu ergänzen, die ratet, welche weiten Abstände Tracking sind und welche Wörter; so ein Ratsch fängt an, echte Wortgrenzen in eng gesetzten Blocksatz-Spalten zu verschlucken, und das ist für die Suche der schlechtere Fehler. Stücke, die auf einer Grundlinie in falscher Reihenfolge gemalt werden, produzieren einen negativen Abstand und gehen ohne Leerzeichen zusammen. In fortlaufendem Fließtext ist der Fall selten
Wann beginnt im extrahierten Text eine neue Zeile?
ExtractLoadedPageText beginnt eine neue Zeile, wenn die Bewegung vom Ursprung der vorigen Glyphe zum aktuellen, projiziert auf die Normale der vorigen Schreibrichtung, mehr als die halbe größere Boxhöhe der beiden Glyphen beträgt. Bewegung entlang der Grundlinie zählt nie zu einem Zeilenumbruch, so weit der Stift auch springt
Eine Regel, die die rohe Y-Bewegung mit der halben Tf-Größe vergleicht, scheitert in zwei Richtungen. Mit 1 Tf und einer skalierten Tm schrumpft’s auf eine halbe Einheit, ein Superscript, der um einen Text-Rise von 0,4 gehoben wurde, bricht also die Zeile. Ebenso das kleine Grundlinien-Zittern, das manche Layout-Engines zwischen Läufen hinterlassen. Dieselbe Regel ignoriert X komplett. Text unter einer gedrehten Tm, etwa jenes diagonale Wasserzeichen, wandert mit jedem Glyphen die Seite hinunter und kommt mit einem Zeichen pro Zeile heraus, während die Projektion einen 45-Grad-Lauf exakt wie einen horizontalen behandelt
Die größere der beiden Höhen zu nehmen zählt, wenn sich Größen auf einer Zeile mischen. Ein 36-Punkt-Schauwort, gefolgt von einer 8-Punkt-Beschriftung ein paar Punkte tiefer, wird an der halben Höhe des großen Glyphen gemessen, so bleibt’s beisammen; an der kleinen Glyphe allein gemessen, landet die Beschriftung auf einer eigenen Zeile. Der Text-Rise ist Teil des Glyphenursprungs, deshalb wird die gehobene Grundlinie eines Superscript gegen dieselbe halbe Höhe gemessen
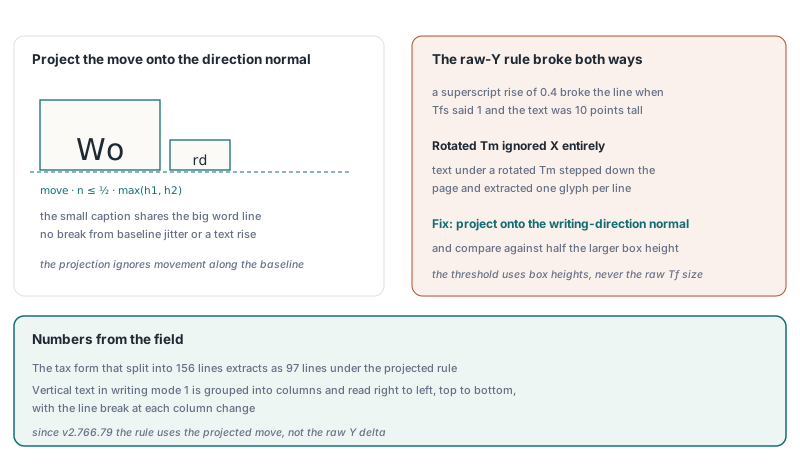
Vertikaler Text im Writing Mode 1 (§9.7.4.3) nimmt einen eigenen Pfad. Diese Glyphen werden an ihrem Ursprungs-X zu Spalten gruppiert, mit der halben Fontgröße als Spaltentoleranz, dann von rechts nach links und von oben nach unten gelesen, mit einem Zeilenumbruch bei jedem Spaltenwechsel. Eine Seite, die einen vertikalen japanischen Fließtext mit einem horizontalen laufenden Header mischt, kriegt’s ebenfalls an jedem Wechsel zwischen den beiden Richtungen
Welche Glyphen schaffen es in den Seitentext
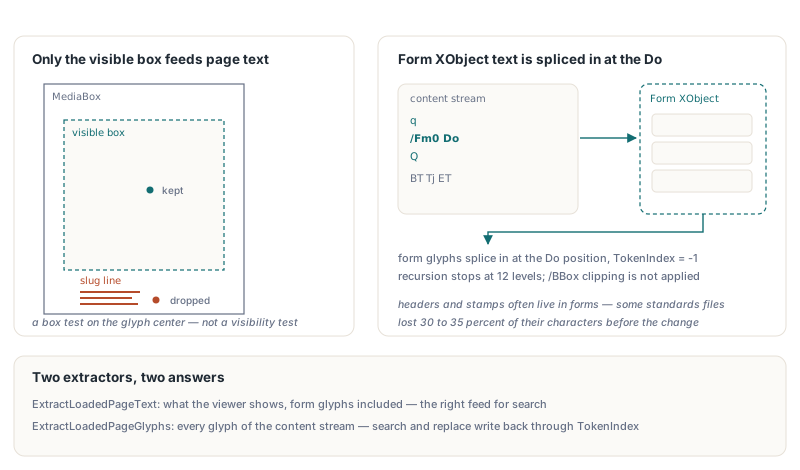
ExtractLoadedPageText liefert den Text, den ein Viewer zeigt. Sie behält nur Glyphen, deren Box-Zentrum innerhalb von GetLoadedPageVisibleBox liegt — der auf die MediaBox beschnittenen CropBox (§14.11.2) —, sodass Beschnittzeilen und andere Druckereimarken, die als Text außerhalb des Zuschnittbereichs gesetzt sind, herausfallen. ExtractLoadedPageGlyphs gibt weiterhin jeden Glyphen des Seiten-Content-Streams zurück, Beschnittzeile inklusive, für Jobs, die’s brauchen. Der Filter ist ein geometrischer Test auf einen Punkt pro Glyphe. Von einem Clipping-Pfad verdeckter, weiß gemalter oder von einem Bild überdeckter Text kommt weiterhin heraus, denn echte Sichtbarkeit zu entscheiden hieße, die Seite zu rendern
uses
  SysUtils, HPDFDoc, HPDFContentStream;

var
  Pdf: THotPDF;
  Raw, Merged: THPDFGlyphArray;
  PageText: UnicodeString;
  L, B, R, T: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('trimmed-proof.pdf');
    if Pdf.GetLoadedPageVisibleBox(0, L, B, R, T) then
      Writeln(Format('Visible box: %.1f %.1f %.1f %.1f', [L, B, R, T]));
    // jeder Glyph des Seiten-Content-Streams, Beschnittzeile inklusive
    if Pdf.ExtractLoadedPageGlyphs(0, Raw) then
      Writeln(Length(Raw), ' glyphs in the page content stream');
    // Seiten-Stream plus Form-XObject-Text, in Malreihenfolge, vor dem Crop
    if Pdf.ExtractLoadedPageGlyphsWithForms(0, Merged) then
      Writeln(Length(Merged), ' glyphs including forms');
    // was die Seite zeigt: Forms eingefügt, Glyphen außerhalb des Crops verworfen
    if Pdf.ExtractLoadedPageText(0, PageText) then
      Writeln(PageText);
    // dieselben Abstandsregeln auf den ungefilterten Stream angewandt, für einen Diff
    Writeln(HPDFAssemblePageText(Raw));
  finally
    Pdf.Free;
  end;
end.
Text, der über Form XObjects gemalt wird, ist Teil des Seitentexts. Header, Stempel und Wasserzeichen wohnen sehr oft in Forms, und wer nur den Seiten-Content-Stream liest, sieht’s nie. HotPDF notiert jedes Do samt der gerade geltenden CTM, interpretiert die Form bei ihrer /Matrix mal dieser CTM (§8.10.1) und fügt die Glyphen der Form an der Position des Do ein, rekursiv in verschachtelte Forms hinein. Eine Form ohne eigene /Resources leiht sich die des Streams, der sie malt — die ältere Anordnung, die §7.8.3 beschreibt. Glyphen, deren Zentrum außerhalb der /BBox der Form liegt, bleiben außen vor, denn diese Box beschneidet die Form beim Malen. Eine Form, die sich selbst malt, direkt oder über eine andere Form, wird kein zweites Mal betreten, und die Verschachtelung stoppt bei 12 Ebenen
Form-Glyphen tragen TokenIndex = -1 und ItemIndex = -1. Derselbe Grund hält ExtractLoadedPageGlyphs auf Seiten-Stream-Glyphen beschränkt: Suche, Ersetzen und Redaktion schreiben ihre Änderungen über TokenIndex zurück, und eine Form-Glyphe in diesem Array würde sie auf Bytes in einem anderen Stream zeigen lassen. Wer die zusammengeführte Liste auf Glyphenebene braucht, bekommt’s über ExtractLoadedPageGlyphsWithForms, in Malreihenfolge, bevor der Visible-Box-Filter läuft
Ein weiterer Durchlauf läuft vor den Abstandsregeln. Überdruckte Logos undFake Bold durch doppeltes Malen desselben Texts mit kleinem Versatz kommt sonst mit jedem Buchstaben doppelt heraus. Malt ein Glyph dasselbe Zeichen in derselben Größe innerhalb eines Zehntels dieser Größe entlang der Grundlinie, und eines Fünftels quer dazu, an einem früheren Glyphen, bleibt’s bei einer Kopie; Leerzeichen werden auf diese Weise nie entfernt. Der Artikel zu Fake Bold und doppelten Glyphen in der Textextraktion geht diesen Fall durch
Text-Zustand über q und Q hinweg
Text nach einem Q dekodiert in jedem Extraktor falsch, der bei q nur die CTM sichert. Die Text-State-Parameter, nämlich Font, Größe, Tc, Tw, Tz, TL, Rendering-Modus und Rise, gehören zum Graphics State (§9.3.1), Q muss sie also zusammen mit allem anderen auf dem Stack wiederherstellen (§8.4.2). Ein Muster entlarvt’s schnell: Ein Zwei-Byte-Identity-H-Font wird innerhalb von q … Q für eine einzelne Tabellenzelle gewählt, und der Text nach dem Q zeigt Ein-Byte-WinAnsi-Strings ohne eigenes Tf. Ein Interpreter, der den inneren Font behält, liest diese Bytes paarweise, und die Punktlinien eines Inhaltsverzeichnisses werden zu einem String beliebiger CJK-Zeichen. Der HotPDF-Interpreter schiebt alle acht Text-State-Werte bei jedem q zusammen mit der CTM auf den Stack und holt sie bei jedem Q wieder herunter
Alles oben gilt auf jeder Seite, also kann ein ganzes Dokument in einem Aufruf in eine UTF-8-Datei wandern. ExtractLoadedPagesTextToStream nimmt einen 1-basierten Seitenbereich (ein leerer String heißt alle Seiten), ein zwischen Seiten geschriebenes Trennzeichen und ein Flag für die Byte Order Mark und liefert die Zahl der extrahierten Seiten. Die Ausgabe wird an der aktuellen Position des Streams angehängt, im Speicher hält’s also nie mehr als den Text einer Seite
uses
  SysUtils, Classes, HPDFDoc;

var
  Pdf: THotPDF;
  Output: TFileStream;
  Pages: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('report.pdf');
    Output := TFileStream.Create('report.txt', fmCreate);
    try
      // leerer Bereich = alle Seiten; Form Feed zwischen Seiten; UTF-8-BOM
      Pages := Pdf.ExtractLoadedPagesTextToStream(Output, '', #12, True);
      Writeln(Pages, ' pages extracted');
    finally
      Output.Free;
    end;
  finally
    Pdf.Free;
  end;
end.
Die Text-API passend zum Job wählen
Für Suche und Indizierung ist ExtractLoadedPageText die richtige Futterquelle: Sie folgt der Content-Stream-Reihenfolge und spiegelt, was die Seite zeigt. Die Dekodierkette darunter, von /ToUnicode-Maps bis zu CID-Fonts, ist unter Text aus geladenen PDFs mit HotPDF extrahieren beschrieben. Content-Stream-Reihenfolge ist am schwächsten bei getaggten Dokumenten, deren Producer den laufenden Header zuletzt geschrieben oder zwei Spalten verschränkt hat; dafür läuft Structure-Order-Textextraktion den Strukturbaum in Authoring-Reihenfolge ab, statt sie aus der Geometrie zu schließen. In Tabellen gekapselte Daten sind besser bei typisierter Tabellenextraktion über Seitenumbrüche hinweg aufgehoben, die Zellen mit ihren Werten liefert. Code, der die Seite editiert, gehört auf ExtractLoadedPageGlyphs, deren Token-Indizes auf genau die Bytes zeigen, die sie umschreiben wird
Die Glyphen-Record-Felder aus diesen Beispielen, dazu der Rest der Textextraktions-API und ein Testbuild, sind auf der HotPDF Delphi PDF Component-Produktseite dokumentiert