Ein Designer wählt eine Schrift mit einstöckigem a für Überschriften, oder eine Null mit Schrägstrich für Tabellen, oder einen Satz von Schwungmajuskeln für ein Cover. Diese Glyphen stecken bereits in der Schrift. Sie sind lediglich nicht die Standardglyphen. Das Standard-a wird über die cmap-Tabelle einer Glyphen-ID zugeordnet, und die Alternativform sitzt einige Glyphen-IDs entfernt, erreichbar nur durch eine Substitutionsregel. Diese Alternativform in einer PDF-Datei zu erzeugen bedeutet, die Regel zu lesen und die Ersatzglyphe in den Inhaltsstrom auszugeben. Dieser Artikel beschreibt das Lesen dieser Regeln, der Single-Substitution-Variante, in Object Pascal ohne eine zugrundeliegende native Shaping-Bibliothek
Der Umfang ist bewusst eng gefasst. Stilistische Sätze und Alternaten sind Einzelglyphen-ein, Einzelglyphen-aus-Substitutionen. Sie sind der Teil des OpenType-Layouts, der sich mit einem kleinen, deterministischen Tabellen-Walk auflösen lässt, was sie für eine Pascal-Engine, die C-Abhängigkeiten vermeiden möchte, besonders geeignet macht
Warum reines Delphi statt HarfBuzz
HarfBuzz ist die naheliegende Antwort auf „forme diesen Text", und für vollständiges bidirektionales, Indisches oder Arabisches Shaping ist es die richtige Antwort. Es ist jedoch auch eine C-Bibliothek. Sie in ein Delphi- oder C++Builder-Produkt einzubinden bedeutet, für jede Zielplattform und -architektur ein natives Objekt auszuliefern, seine Aufrufkonvention einzuhalten, seinen Release-Rhythmus zu verfolgen und seine Lizenzbedingungen gegen die eigenen abzuwägen. Nichts davon ist für sich genommen schwierig. Alles zusammen ist eine dauerhaft bestehende Reibung, und sie kauft nichts, wenn die eigentliche Anforderung lautet: „Gib mir die ss01-Form dieses Buchstabens"
Single Substitution benötigt keine Shaping-Engine. Sie braucht einen Parser für eine Handvoll GSUB-Subtable-Formate und ein, zwei binäre Suchen. Das in Pascal zu schreiben hält die gesamte Toolchain innerhalb eines einzigen Compilers. Die Abfrage beantwortet eine Frage — welche Glyphe ersetzt diese Glyphe unter diesem Feature — und genau diese Frage stellt stilistische Arbeit; Bidi-Auflösung, indische Umordnung und kontextuelles Shaping sind Sequenzprobleme, die zu einem Shaping-Durchgang gehören
Die GSUB-Hierarchie, von oben nach unten
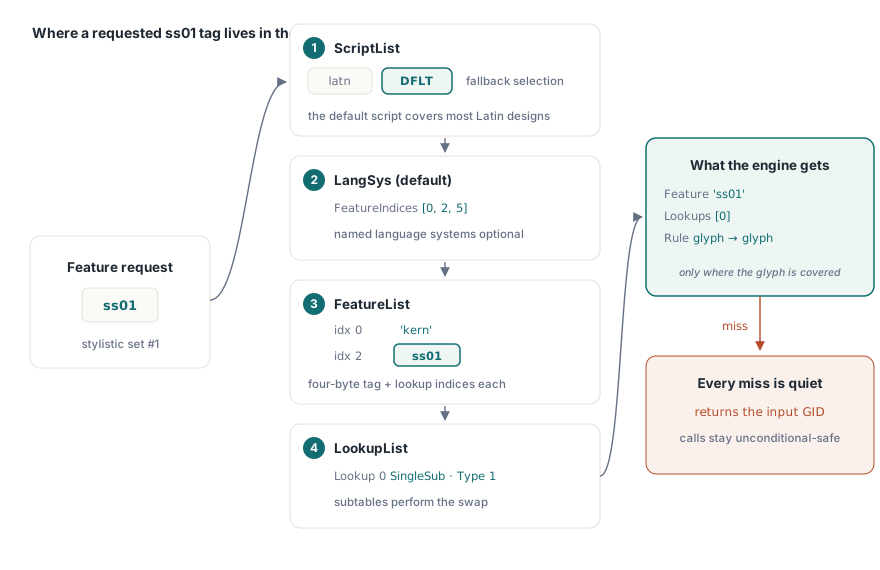
Die Glyphen-Substitutions-Tabelle ist als Kette von Indirektionen organisiert, und eine Substitutionsabfrage durchläuft diese Kette von oben. An der Spitze steht die ScriptList. Ein Skript-Tag wie latn wählt einen Eintrag aus, und das spezielle Tag DFLT ist das Standardskript, das greift, wenn kein spezifischeres Skript passt. Der Skript-Eintrag zeigt auf ein LangSys, das Sprachsystem, mit einem Standard-LangSys für den häufigen Fall und optionalen benannten für Sprachen, die ein anderes Verhalten erfordern. Türkisch ist das klassische Beispiel, wo das punktierte und punktlose i eine eigene Behandlung verlangen
Das LangSys benennt eine Menge von Feature-Indizes. Jeder Index zeigt in die FeatureList, wo ein Feature-Datensatz ein vierbytiges Tag trägt, ss01 unter anderen, und eine Liste von Lookup-Indizes. Diese Indizes zeigen schließlich in die LookupList, wo die eigentlichen Substitutions-Subtabellen liegen. ss01 aufzulösen bedeutet daher: das Skript finden, sein LangSys finden, das Feature mit dem Tag ss01 finden, die von ihm genannten Lookups sammeln und anwenden. HotPDF verwendet standardmäßig das DFLT-Skript und das Standard-LangSys, was der überwiegende Teil der lateinischen Textdesigns ausliefert, und bietet eine Möglichkeit, den Skript-Tag zu überschreiben, wenn eine Schrift ihre Features unter einem spezifischen Skript verdrahtet
Coverage-Tabellen entscheiden, wer teilnimmt
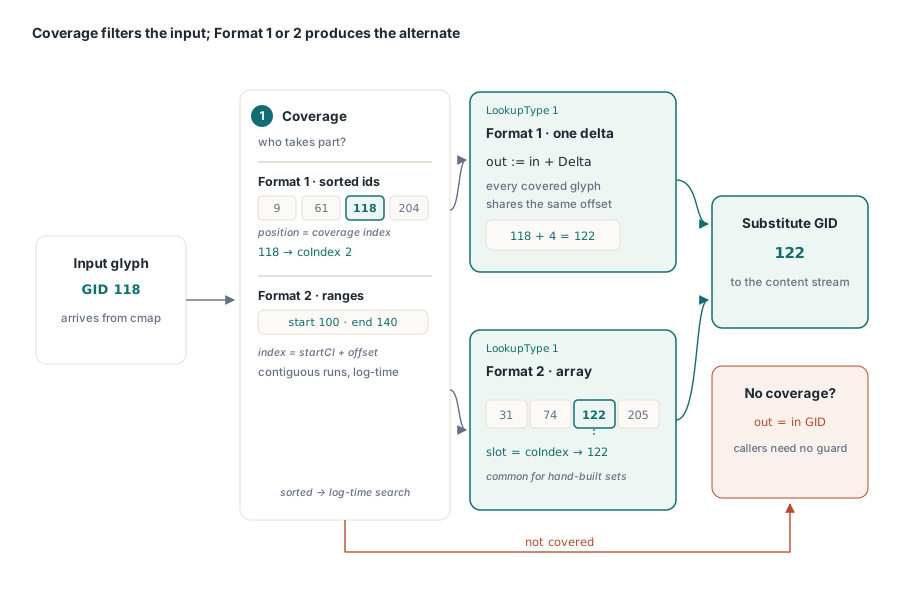
Jede Substitutions-Subtabelle beginnt mit derselben Frage: Nimmt diese Eingabe-Glyphe an dieser Regel teil, und wenn ja, wo sitzt sie in der eigenen Indizierung der Regel? Diese Frage beantwortet eine Coverage-Tabelle, und die Antwort ist ein Coverage-Index, eine kleine Ordinalzahl, die der Rest der Subtabelle verwendet, um nachzuschlagen, was aus der Glyphe wird
Coverage kommt in zwei Formaten. Format 1 ist eine Liste von Glyphen-IDs in aufsteigender Reihenfolge. Eine Glyphe wird per Binärsuche gefunden, und ihre Position in der Liste ist ihr Coverage-Index. Format 2 ist eine Liste von Bereichsdatensätzen, jeder mit einer Start-Glyphe, einer End-Glyphe und dem Coverage-Index, auf den die Start-Glyphe abgebildet wird. Eine Glyphe innerhalb eines Bereichs erhält ihren Coverage-Index durch Offset vom Bereichsanfang. Format 1 ist kompakt, wenn die teilnehmenden Glyphen verstreut sind, Format 2, wenn sie in zusammenhängende Läufe fallen. Beide sind sortiert, also werden beide in logarithmischer Zeit durchsucht, und beide liefern entweder einen Coverage-Index oder ein sauberes „nicht abgedeckt", das die Engine die Glyphe in Ruhe lassen lässt
Single Substitution, die zwei Formate
Single Substitution ist LookupType 1, und er bildet eine Glyphe auf genau eine Ersatzform ab. Auch er hat zwei Formate, und die Aufteilung ist eine Platzoptimierung. Format 1 speichert ein einziges vorzeichenbehaftetes Delta. Die Ausgabe-Glyphen-ID ist die Eingabe-Glyphen-ID plus diesem Delta, modulo 65536. So kodiert eine Schrift eine Substitution, bei der jede teilnehmende Glyphe denselben festen Abstand von ihrer Alternativform hat, beispielsweise ein Block von Mediävalziffern, die einen konstanten Abstand von den entsprechenden Versalziffern haben. Die Coverage-Tabelle sagt, welche Glyphen qualifizieren, und das eine Delta dient ihnen allen
Format 2 speichert ein explizites Array von Ersatz-Glyphen-IDs. Der Coverage-Index aus der Coverage-Tabelle ist der Index in dieses Array, sodass die Glyphe bei Coverage-Index 0 zum ersten Array-Eintrag wird, Coverage-Index 1 zum zweiten, und so weiter. Format 2 wird verwendet, wenn die Alternaten sich nicht an einem einheitlichen Offset befinden, was der häufige Fall bei handgestalteten stilistischen Sätzen ist. Die Abfrage ist von der Seite des Aufrufers aus in beiden Fällen gleich: Die Eingabe-Glyphe nehmen, durch Coverage laufen lassen, und wenn sie abgedeckt ist, das Delta anwenden oder den Array-Slot lesen
var
  Pdf: THotPDF;
  BaseGID, AltGID: Word;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.BeginDoc;
    Pdf.RegisterUnicodeTTF('C:\Fonts\MyStylisticFace.ttf');
    Pdf.CurrentPage.SetFont('My Stylistic Face', [], 12);

    // Standardglyphe für 'a' über die cmap der Schrift.
    BaseGID := Pdf.GetUnicodeGlyphForCodepoint(Ord('a'));

    // Stilistischer Satz 1: die Alternativform über GSUB LookupType 1 auflösen.
    AltGID := Pdf.GetSingleSubstituteGlyph(BaseGID, 'ss01');

    // AltGID = BaseGID bedeutet, das Feature hat diese Glyphe nicht verändert.
    if AltGID <> BaseGID then
      { AltGID in den Inhaltsstrom ausgeben };
  finally
    Pdf.Free;
  end;
end;
Der bemerkenswerte Teil des Vertrags ist das Pass-through. GetSingleSubstituteGlyph gibt die Eingabe-Glyphen-ID bei jedem Fehltreffer unverändert zurück: keine Schrift, keine GSUB-Tabelle, kein übereinstimmendes Feature, kein Coverage-Treffer. Das bedeutet, der Aufruf ist bedingungslos sicher. Sie fragen nach der Alternativform, und wenn es keine gibt, erhalten Sie genau das zurück, was Sie eingegeben haben, sodass der aufrufende Code nie einen Sonderfall für eine Schrift ohne das Feature behandeln muss
Was die stilistischen Feature-Tags bedeuten
Das Feature-Tag ist das gesamte Vokabular der Alternativform, nach der Sie fragen, und die für stilistische Arbeit relevanten Tags sind eine kurze Liste. Das führende Paar ist salt, stilistische Alternaten, der universelle Zugang zu den Alternativformen einer Glyphe, und ss01 bis ss20, die zwanzig nummerierten stilistischen Sätze, die eine Schrift definieren kann, jeder ein benanntes Bündel von Substitutionen, das der Designer zusammengruppiert. Eine Schrift könnte beispielsweise ein einstöckiges a und ein geradesbeiniges R unter ss03 platzieren, sodass das Aktivieren dieses einen Satzes beide Zeichen neu gestaltet
Darum herum sitzen noch einige weitere Single-Substitution-Tags. aalt ist Access-All-Alternates, die Vereinigung aller Alternativformen, die eine Glyphe hat, normalerweise als Glyphenpaletten-Feature präsentiert. titl wählt Titelversalien, die für große Größen geschnitten wurden. subs und sups tauschen echte Tiefstell- und Hochstellziffern ein, statt herunterskalierter Standardziffern. ordn erzeugt Ordinalformen, die hochgestellten Buchstaben in „1." und „2.". frac baut Brüche, obwohl vollständige Diagonalbrüche auch auf Ligatur- und kontextuelle Logik angewiesen sind, die über reine Single Substitution hinausgeht. Für die Einzelglyphen-Fälle ist der Mechanismus identisch mit ss01: das Tag an die Substitutionsabfrage übergeben und die Alternativglyphe zurücklesen
// Einen stilistischen-Satz-Feature versuchen, dann auf einfache Alternaten zurückfallen.
function ResolveAlternate(Pdf: THotPDF; BaseGID: Word;
  const PreferredTag: AnsiString): Word;
begin
  Result := Pdf.GetSingleSubstituteGlyph(BaseGID, PreferredTag);
  if Result = BaseGID then
    Result := Pdf.GetSingleSubstituteGlyph(BaseGID, 'salt');
  // Immer noch BaseGID, wenn kein Feature diese Glyphe abdeckt.
end;
cmap-Format 12 und die Ergänzungsebenen
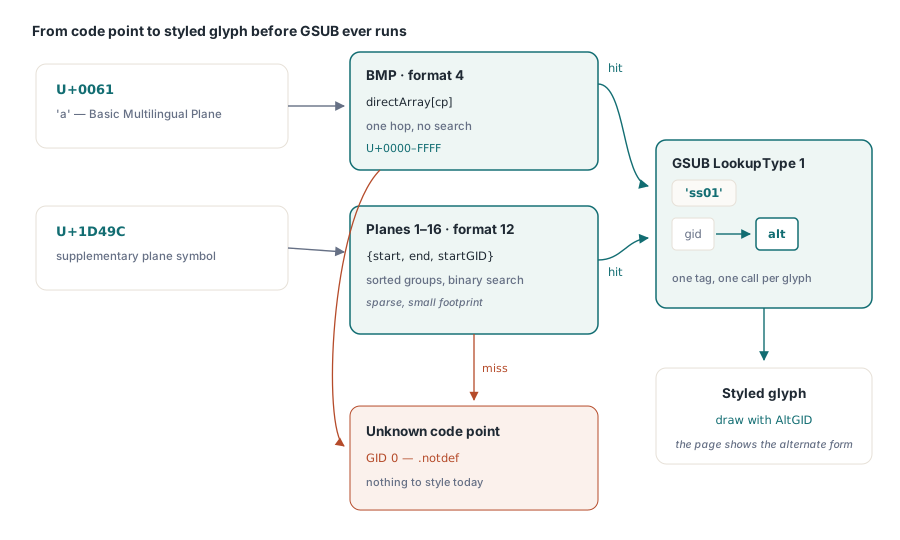
Bevor eine Substitution ausgeführt werden kann, muss ein Zeichen zu einer Glyphe werden, und das ist die Aufgabe der cmap-Tabelle. Die Substitutionsabfrage beginnt mit einer Glyphen-ID, daher ist der Weg immer Zeichen zu Glyphe über cmap, dann Glyphe zu Alternativform über GSUB. Der interessante Teil von cmap ist seine Reichweite. Eine Format-4-Subtabelle deckt die Basic Multilingual Plane, die ersten 65536 Codepunkte, ab, und das reicht für die meisten lateinischen Texte. Es reicht nicht für Codepunkte ab U+10000 aufwärts, die Ergänzungsebenen, wo mathematische alphanumerische Zeichen, viele Symbole und mehrere lebende Schriften heute leben
Format 12 ist die Subtabelle, die den gesamten Bereich U+0000 bis U+10FFFF abdeckt. Es handelt sich um eine sortierte Liste von Gruppen, jede Gruppe mit einem Start-Codepunkt, einem End-Codepunkt und einer Start-Glyphen-ID, sodass ein zusammenhängender Lauf von Codepunkten einem zusammenhängenden Lauf von Glyphen zugeordnet wird. HotPDF löst Codepunkte mit einer hybriden Strategie auf, die dem Aufbau der Daten entspricht. Codepunkte in der BMP werden aus einem direkt durch den Codepunkt indizierten Array bedient, eine einzelne Suche ohne Suche. Codepunkte in den Ergänzungsebenen werden aus einer nach Codepunkt sortierten, spärlichen Tabelle bedient, die per Binärsuche durchsucht wird. Das Ergebnis ist, dass GetUnicodeGlyphForCodepoint ein vollständiges Cardinal annimmt und über den gesamten Bereich korrekt antwortet, wobei Glyphen-ID 0, die .notdef-Glyphe, für jeden Codepunkt zurückgegeben wird, den die Schrift nicht abbildet
var
  Pdf: THotPDF;
  Cp: Cardinal;
  GID, StyledGID: Word;
begin
  // Ein Codepunkt der Ergänzungsebene: U+1D49C MATHEMATICAL SCRIPT CAPITAL A.
  Cp := $1D49C;
  GID := Pdf.GetUnicodeGlyphForCodepoint(Cp);  // Format-12-Lookup
  if GID <> 0 then
    StyledGID := Pdf.GetSingleSubstituteGlyph(GID, 'ss01')
  else
    StyledGID := 0;  // Die Schrift hat keine Glyphe für diesen Codepunkt
end;
Abfragen pro Glyphe gegenüber Sequenz-Shaping
Die Single-Substitution-APIs beantworten eine Art von Frage: LookupType 1, eine Glyphe hinein, eine Glyphe hinaus. Die anderen GSUB-Lookup-Typen arbeiten auf Sequenzen, wo eine Glyphe zu mehreren wird, mehrere zu einer, oder eine Regel nur dann auslöst, wenn eine Glyphe in einer bestimmten Nachbarschaft erscheint. Ein diagonaler Bruch, ein Devanagari-Konjunkt oder eine arabische Initial-Medial-Final-Kaskade ist ein solches Sequenzproblem, und es ist die Aufgabe eines Shaping-Durchgangs, nicht einer Abfrage pro Glyphe
Die Arbeitsteilung ist bewusst. Hier wählt der Aufrufer das Feature-Tag und wendet es Glyphe für Glyphe an, ohne dass etwas einen Textlauf inspiziert oder die Feature-Reihenfolge an seiner Stelle entscheidet. Genau das richtige Werkzeug für stilistische Sätze und Alternaten, die opt-in und lokal sind, und der Pfad pro Glyphe frei von Sequenzlogik zu halten ist es, was ihn klein und vorhersehbar lässt
Für Fälle, die sequenzielle Arbeit erfordern, wird die Geschichte komplexer Schriften in unserem Artikel über das Shaping komplexer Schriften in Delphi aufgegriffen. Wenn Ihre Substitutionen Teil eines größeren Berichtsauftrags sind, der auch Bilder und andere Schriften auf der Seite platziert, behandelt der Leitfaden zur Berichtsausgabe mit Schriften und Bildern, wie diese Teile zusammenpassen. All das läuft auf derselben Engine, dem HotPDF Delphi Component für Delphi und C++Builder, der die GSUB-Substitutionsabfragen zusammen mit den anderswo in diesem Blog behandelten Schrifteinbettungs-, Teilmengen- und Text-APIs mitliefert