Ein Nutzer tippt Müller in ein Suchfeld, bekommt nichts, kopiert denselben Namen aus dem PDF, fügt ihn wieder ins Feld ein und bekommt auf einmal Treffer. Beide Strings im Debugger angesehen, liefert Length 6 für den getippten und 7 für den eingefügten. Das getippte Wort trägt U+00FC, ein einzelnes vorkomponiertes ü; das Dokument speichert ein nacktes u gefolgt von U+0308 COMBINING DIAERESIS. Beide rendern dieselben Glyphen, und ein Code-Unit-Vergleich wird sie nie gleich nennen
Warum vergleichen sich identisch aussehende Strings als ungleich?
Unicode erlaubt absichtlich mehr als eine Kodierung für dasselbe abstrakte Zeichen und nennt die Kodierungen kanonisch äquivalent. Der Unicode Standard Annex #15 definiert zwei Normalformen, die für die Suche zählen: NFC, das vorkomponierte Codepunkte bevorzugt, und NFD, das jedes vorkomponierte Zeichen in einen Basisbuchstaben plus seine kombinierenden Zeichen in fester Reihenfolge zerlegt. Lateinische Buchstaben mit Diakritika gibt es in beiden Gestalten. Hangul-Silben ebenso, die als eine vorkomponierte Silbe oder als eine Folge aus zwei oder drei sich verbindenden Jamo auftreten können
Welche Gestalt in einem PDF landet, hängt von der Software ab, die es erzeugt hat, von der Plattform, auf der sie lief, und mitunter davon, wie die ToUnicode-Map einer Schrift gebaut war. Ein auf der einen Maschine getipptes und auf der anderen bearbeitetes Dokument kann beide Formen auf derselben Seite mischen. Keines davon ist für die suchende Person sichtbar. Tastatur und Eingabemethode erzeugen meist NFC, jeder zerlegte Inhalt in der Datei wird von ihrer Seite also unsuchbar
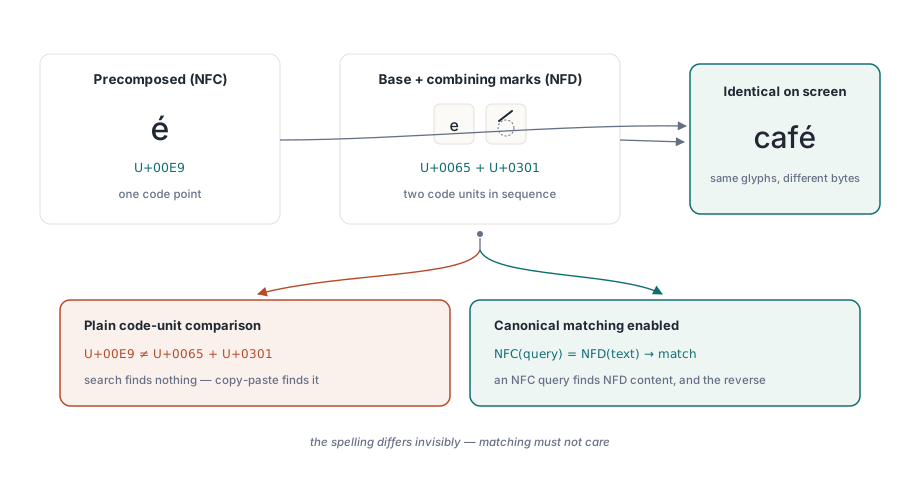
Der naheliegende Workaround wirft das Problem in denselben Eimer wie das Case-Folding: beide Seiten kleinbuchstabig, Akzente strippen, vergleichen. Das scheitert aus einem strukturellen Grund. Case-Folding und Accent-Stripping sind auf Code-Unit-Ebene eins zu eins, der gefaltete Text hat also exakt dieselbe Länge wie das Original, und ein Treffer an Position 17 in der gefalteten Kopie ist ein Treffer an Position 17 im extrahierten Text. Normalisierung ändert Längen. Ein vorkomponierter Buchstabe wird zu zwei oder drei Code-Units, eine zerlegte Sequenz kollabiert auf eine zurück, Hangul-Silben expandieren zu Jamo, und nach dieser Transformation zeigen die zurückkommenden Positionen nicht mehr auf den extrahierten Text
Suchen mit soCanonicalEquivalent in PDF Library for Delphi
In PDF Library for Delphi lässt das soCanonicalEquivalent-Mitglied von TPDFlibSearchOptions SearchText kanonische Zerlegungen der Abfrage und des Seitentexts vergleichen, eine NFC-Abfrage findet also NFD-Inhalt, und eine NFD-Abfrage findet NFC-Inhalt. Die Option ist Teil einer Menge, kombiniert sich also mit soWholeWord, soCaseSensitive, soWildcards und soDiacriticInsensitive ohne jede separate API:
uses
  SysUtils, Math, PDFlibrary;

var
  Lib: TPDFlib;
  Hits: array of TPDFlibSearchHit;
  Found, Stored, I: Integer;
  Slice: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contracts.pdf', '');
    Lib.SearchContextChars := 24;      // ContextBefore / ContextAfter füllen
    SetLength(Hits, 500);

    Found := Lib.SearchText('Bäcker',
      [soCanonicalEquivalent, soWholeWord, soGraphemeClusters],
      '', Hits);                       // leerer Seitenbereich = jede Seite

    // Found zählt alle Treffer; nur die ersten Length(Hits) wurden kopiert
    Stored := Min(Found, Length(Hits));
    for I := 0 to Stored - 1 do
    begin
      Slice := Copy(Hits[I].MatchText, Hits[I].MatchStart,
        Hits[I].MatchLength);
      Writeln(Format('page %d: [%s] %d code units, ...%s|%s|%s...',
        [Hits[I].Page, Slice, Hits[I].MatchLength,
         Hits[I].ContextBefore, Slice, Hits[I].ContextAfter]));
    end;
  finally
    Lib.Free;
  end;
end;
Zwei Details in dieser Schleife bringen Leute zu Fall. SearchText liefert die Gesamtzahl der Treffer, auch wenn der Puffer kleiner ist, bis Found - 1 zu iterieren läuft auf einem großen Dokument also über das Ende eines 500-Elemente-Arrays hinaus; mit Min begrenzen oder auf SearchTextEach umschwenken, das jeden Treffer an einen Callback übergibt und gar keinen Puffer braucht. Und MatchText ist der ganze Textblock, der den Treffer enthielt, mit MatchStart als 1-basiertem Index hinein, das getroffene Wort selbst ist also das oben gezeigte Copy
Fährt man das gegen eine Datei, die Bäcker zerlegt speichert, ist die gedruckte Länge 7, gegen eine NFC-Datei ist sie 6. Dieselbe Abfrage, dieselbe Optionsmenge. Der Slice ist immer der Text, wie er im Dokument liegt
Wo der Treffer im Originaltext landet
Genau diese Eigenschaft macht normalisierte Suche für alles brauchbar, was über eine Ja-nein-Antwort hinausgeht. PDF Library for Delphi merkt sich für jede Code-Unit, die der Normalisierer erzeugt, Anfang und Ende der ursprünglichen UTF-16-Spanne, aus der sie kam. Eine rekursive Zerlegung erbt die Spanne ihres Elternteils, eine Komposition verschmilzt die Spannen ihrer Eingaben, und wird ein Treffer gefunden, durchsucht die Suche das gemappte Intervall nach dem kleinsten Anfang und dem größten Ende
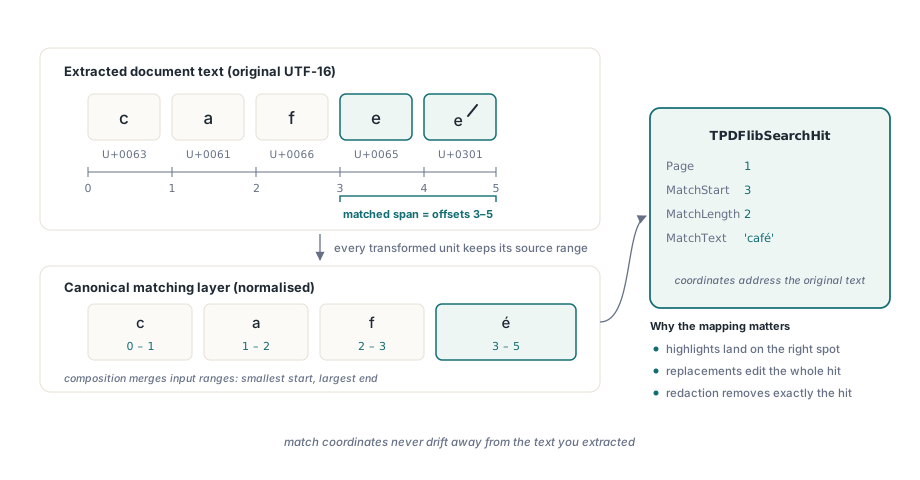
Als Ergebnis adressieren MatchStart, MatchLength, ContextBefore, ContextAfter und beide Ersetzungs-Einstiegspunkte den extrahierten Text, den der Aufrufer bereits hat. Eine Suche, die nur sagen könnte „in diesem Block steckt ein Treffer", aber nicht genau wo, wäre für eine Ergebniszahl okay und für alles andere falsch: Hervorhebungen würden sich pro akzentuiertem Buchstaben um ein, zwei Zeichen verschieben, und eine Ersetzung würde die falsche Textstelle umschreiben
Der Normalisierer reist in der Bibliothek mit. Er trägt kompakte Tabellen für kanonische Zerlegung, Komposition und kanonische Kombinationsklasse aus Unicode 15.1 mit sich, wendet für Hangul die algorithmischen Regeln statt Tabelleneinträgen an und sortiert kombinierende Zeichen während NFD stabil um. Keine externe Datendatei wird geladen, kein Normalisierungsaufruf des Betriebssystems gemacht, ein Windows-Dienst, ein Linux-Daemon und ein Free-Pascal-Build liefern für dieselbe Datei also identische Treffer. Wir haben es gern so, obwohl das Betriebssystem die Arbeit unter Windows übernehmen könnte: Ein auf dem einen Server gebauter und auf dem anderen befragter Suchindex darf nie divergieren, weil zwei Maschinen unterschiedliche Unicode-Versionen fahren
Die Option ist per Default aus, und dieser Default ist vernünftig. Den NFD-Text und seine Position Map aufzubauen kostet Zeit, und eine Suche über rein ASCII-Rechnungen braucht das nie. Ist soCanonicalEquivalent gesetzt, hält jeder Textblock zwei transformierte Kopien, eine mit kombinierenden Zeichen und eine ohne, ein Batch von Abfragen über denselben Block normalisiert ihn also einmal. Das nackte Case-Folding bleibt auf dem billigeren Eins-zu-eins-Pfad
Was schiefgeht, wenn ein Treffer mitten in einem Zeichen endet?
Kanonische Äquivalenz beantwortet „ist das derselbe Text", sagt aber nichts darüber, wo ein Treffer enden darf. Sucht man ein zerlegtes café mit soCanonicalEquivalent allein nach cafe ab, matchen die ersten vier Code-Units; das folgende kombinierende Acute bleibt außerhalb des Treffers. soWholeWord fängt das nicht, denn seine Wortzeichen folgen Identifier-Regeln (ASCII-Buchstaben, Ziffern und Unterstrich), und ein kombinierendes Zeichen zählt als Grenze. Die Hervorhebung deckt cafe ab, und eine Ersetzung lässt einen herrenlosen Akzent über dem schweben, was als Nächstes kommt
Dasselbe passiert weit über lateinische Akzente hinaus. Ein Flaggen-Emoji sind zwei Regional-Indicator-Codepunkte. Ein Familien-Emoji sind mehrere Figuren, verbunden durch Zero-Width-Joiner. Ein Devanagari-Konjunkt ist ein Konsonant, ein Virama und ein weiterer Konsonant, und ein vietnamesischer Vokal kann zwei gestapelte Zeichen tragen. Alles außerhalb der Basic Multilingual Plane ist in UTF-16 ein Surrogatpaar, und eines zu halbieren erzeugt ein unpaariges Surrogat, das viele Text-Pipelines durch U+FFFD ersetzen
soGraphemeClusters verlangt, dass beide Enden jedes Treffers, literal oder per Wildcard, auf erweiterte Graphemcluster-Grenzen fallen, wie der Unicode Standard Annex #29 sie definiert. Die Segmentierung deckt CR/LF-Paarung, Steuerzeichen, Hangul-Silbentypen, Extend und SpacingMark, Prepend, Emoji-ZWJ-Sequenzen, Regional-Indicator-Paare und Indic-Konjunkt-Trennungen ab, und sie setzt niemals eine Grenze in ein Surrogatpaar. Mit dem Flag matcht cafe ein zerlegtes café gar nicht mehr; soDiacriticInsensitive ergänzen, wenn akzentblinder Abgleich das ist, was man eigentlich will
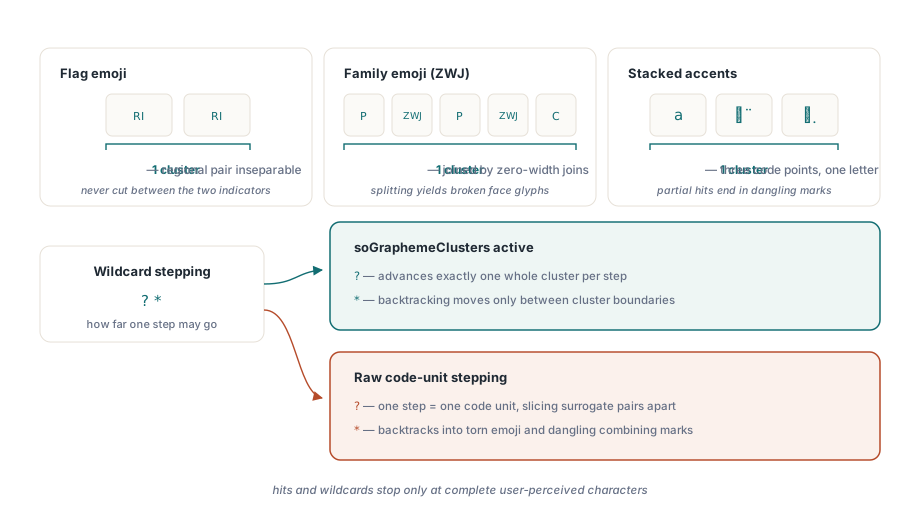
Bei den Wildcards ändert das Flag die Ergebnisse am sichtbarsten. Unter soCanonicalEquivalent wird der Seitentext in NFD verglichen, côté wird also zu c o U+0302 t e U+0301, egal wie die Datei es gespeichert hat. Ohne soGraphemeClusters konsumiert das ? in c?té exakt eine Code-Unit, das o, erwartet dann ein t und findet U+0302. Kein Treffer. Mit dem Flag rückt ? ein ganzes Cluster weiter, und das Backtracking für * bewegt sich ebenfalls nur zwischen Cluster-Grenzen:
// „?" schreitet ein wahrgenommenes Zeichen weiter, das matcht also côté
// ob das PDF es vorkomponiert oder zerlegt gespeichert hat
Found := Lib.SearchText('c?té',
  [soWildcards, soCanonicalEquivalent, soGraphemeClusters], '', Hits);

// Die Ersetzung nutzt dieselben cluster-sicheren Bereiche, sie teilt
// also nie ein Emoji und lässt keinen verwaisten Akzent zurück
Replaced := Lib.SearchAndReplaceTextInContent('naïve', 'plain',
  [soCanonicalEquivalent, soGraphemeClusters], '1-20');
if Replaced = 0 then
  Writeln(Lib.GetLastUnicodeReplacementDiagnostics)
else
  Lib.SaveToFile('contracts-edited.pdf');
SearchAndReplaceTextInContent schreibt den Text im Seiteninhalt um und liefert die Zahl der ersetzten Treffer zurück. Liefert sie null, sagt GetLastUnicodeReplacementDiagnostics warum, etwa dass sich ein Treffer nicht auf den Inhalt zurückmappen ließ, der ihn gezeichnet hat. Der andere Einstiegspunkt, SearchAndReplaceText, nimmt dieselbe Optionsmenge und legt die Ersetzung stattdessen über den getroffenen Block
Optionsmengen je Workload wählen
Drei Kombinationen decken die meisten Anwendungen ab. Für ein Suchfeld für Endanwender in einem Dokument-Viewer soCanonicalEquivalent plus soDiacriticInsensitive nehmen: Beide Kodierungsformen matchen, akzentuierte und unakzentuierte Schreibweisen ebenso, genau das erwarten Leute nach Jahren der Websuche. Für Rechts- oder Compliance-Prüfung, wo ein False Positive jemanden einen Nachmittag kostet, soCanonicalEquivalent mit soCaseSensitive und soWholeWord nehmen und die Akzentfaltung aus lassen, die Äquivalenz bleibt exakt und ignoriert nur, wie die Datei es zufällig kodiert hat
Bei allem, was das Dokument verändert, jedes Mal soGraphemeClusters ergänzen. Das ist die eine Stelle, die wir nicht dem Geschmack überlassen würden. Eine Suche, die eine um eine Code-Unit zu kurze Spanne zurückgibt, bringt nur die Leserin der Ergebnisse in die Irre; eine Ersetzung oder Entfernung, die dieselbe Spanne nutzt, schreibt den Fehler in die Datei, und niemand merkt es, bis die Seite wieder gedruckt oder extrahiert wird. Entfernung, die Inhalt zerstören statt überdecken muss, ist ein eigenes Thema, behandelt in echter Schwärzung und Inhaltsentfernung
Laufen mehrere Begriffe gegen dasselbe Dokument, SearchTextBatch bevorzugen. Er wertet jede nicht-leere Abfrage aus, während die Textblöcke einer Seite resident sind, jede Seite wird also einmal extrahiert und jeder Block einmal normalisiert, und jede Abfrage trägt ihre eigene Optionsmenge:
var
  Queries: array[0..2] of TPDFlibSearchQuery;
  BatchHits: array of TPDFlibSearchBatchHit;
  Count, I: Integer;
begin
  Queries[0].Query := 'Müller';
  Queries[0].Options := [soCanonicalEquivalent, soDiacriticInsensitive];
  Queries[1].Query := '서울';                // Hangul: NFC oder Jamo in der Datei
  Queries[1].Options := [soCanonicalEquivalent, soGraphemeClusters];
  Queries[2].Query := 'Nguyễn';
  Queries[2].Options := [soCanonicalEquivalent, soCaseSensitive,
    soWholeWord, soGraphemeClusters];

  SetLength(BatchHits, 2000);
  Count := Min(Lib.SearchTextBatch(Queries, '', BatchHits),
    Length(BatchHits));
  for I := 0 to Count - 1 do
    Writeln(Format('query %d -> page %d',
      [BatchHits[I].QueryIndex, BatchHits[I].Hit.Page]));
end;
Treffer kommen sortiert nach Seite, dann Block, dann Abfrage zurück, und QueryIndex ist die nullbasierte Position im übergebenen Array. SearchTextBatchEach ist die Callback-Form für Ergebnismengen, die sich vorab nicht dimensionieren lassen. Wie Textblöcke überhaupt extrahiert werden, beschreibt Textsuche und Seitenelement-Enumeration
Schriftsysteme, bei denen kanonische Äquivalenz nicht optional ist
Bei Koreanisch entscheidet kanonische Äquivalenz, ob ein Name überhaupt gefunden wird, denn vorkomponierte Silben und zerlegte Jamo tauchen in echten Dokumenten beide auf. Vietnamesisch stapelt einen Ton über einem Vokal, der vielleicht schon ein Breve oder einen Zirkumflex trägt, seine Kompositionsform hängt also komplett am Producer. Für Devanagari, Bengali und die anderen indischen Schriften entscheiden die Konjunkt-Regeln, ob eine Treffergrenze an einer Stelle landet, die ein Leser wiedererkennen kann. Japanisch und Chinesisch sind auf der Suchseite vergleichsweise unkompliziert, auf der Layoutseite nicht, behandelt in vertikaler Schreibrichtung für Japanisch und Chinesisch
Unsere Empfehlung ist ungeschminkt. Enthält der Bestand irgendeine Sprache außer Englisch, soCanonicalEquivalent zuerst anschalten und erst dann wieder aus, wenn man es auf den eigenen Dokumenten gemessen hat und die Kosten inakzeptabel findet. Der Fehler, den es verhindert, landet ausgerechnet auf den Namen, nach denen die Nutzer am meisten suchen
Dieselbe Unicode-bewusste Engine treibt Suche, Extraktion, Ersetzung und Schwärzung aus Delphi, C++Builder und Free Pascal an; Optionsmengen, die Batch-API und der Rest des Text-Werkzeugkastens sind auf der Produktseite der PDF Library for Delphi gelistet