Das Extrahieren des Textes einer Seite ist die einfache Hälfte des Problems. In dem Moment, in dem ein Benutzer ein Wort in ein Suchfeld eingibt und erwartet, dass der Viewer dorthin springt und ein gelbes Feld darum zeichnet, benötigen Sie etwas, das Ihnen die flache Textzeichenfolge nicht geben kann: die Seite, auf der sich jeder Treffer befindet, und das Rechteck, das er in PDF-Koordinaten einnimmt. Eine über eine Seite verkettete Zeichenfolge hat diese Geometrie verloren. Sie können die Teilzeichenfolge finden, aber Sie können nicht darauf zeigen
PDF Library for Delphi ist eine native Object-Pascal-PDF-Bibliothek für Delphi und C++Builder, und ab Version 3.78.0 beantwortet sie genau diese Frage. Drei Abfrage-APIs setzen auf dem vorhandenen Textblock-Extraktor auf: SearchText durchläuft einen Seitenbereich und gibt jeden Treffer mit seiner Seite und seinem achsenorientierten Rechteck zurück, EnumPageElements listet alles auf einer Seite auf (Textblöcke und eingebettete Bilder gleichermaßen), und GetTextInAreaEx meldet das Rechteck jedes Blocks innerhalb eines Bereichs, anstatt sie zu einer Zeichenfolgenliste abzuflachen. Keiner von ihnen berührt den Schreibpfad; sie sind reine leseseitige Ergänzungen über Mechanismen, die die Bibliothek bereits besaß
Warum die Geometrie in der Textblockliste liegt und nicht im Trichter
Der natürliche Instinkt ist es, wiederzuverwenden, was auch immer GetPageText intern ausführt. Dieser Pfad führt durch einen flüchtigen Extraktionstrichter („funnel“), der die Seitenzeichenfolge erzeugt und sich dann selbst freigibt, bevor der Aufruf zurückkehrt. Zu dem Zeitpunkt, an dem Sie das Ergebnis in den Händen halten, sind die Koordinaten pro Block verschwunden. Sie waren nie dazu gedacht, behalten zu werden
Die Koordinaten überleben jedoch in einer anderen Struktur. ExtractPageTextBlocks(3) gibt ein Handle für eine Textblockliste zurück, deren Elemente jeweils ein umschließendes Viereck (Bounding Quad) aus acht Double-Werten, einen Schriftnamen, eine Schriftgröße und den Text des Blocks tragen. Dieses Handle ist the einzige Ort, an dem die Geometrie nach der Extraktion erhalten bleibt. Aus diesem Grund baut jede der neuen Abfrage-APIs darauf auf und nicht auf dem Trichter. Die Wiederverwendung der Blockliste bedeutet, dass Suche, Aufzählung und Bereichsabfragen alle einen einzigen Extraktionsdurchgang und eine Definition des Blockorts teilen
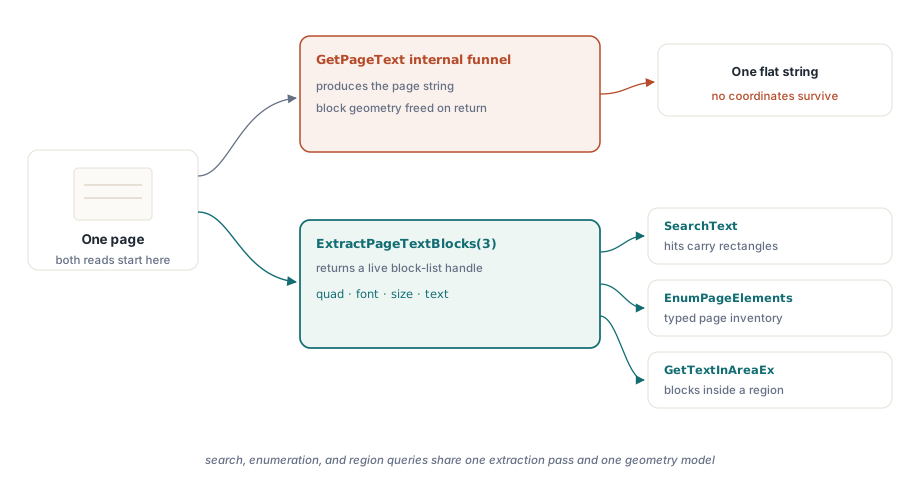
Daher ergibt sich die Form von SearchText aus dieser Einschränkung. Für jede Seite im Bereich extrahiert die Methode die Blockliste, liest den Text jedes Blocks mit GetTextBlockText, testet ihn gegen die Abfrage und reduziert für die passenden Blöcke das Viereck auf ein Rechteck. Der zurückgegebene Treffer ist ein kleiner Record:
type
  TPDFlibSearchHit = record
    Page: Integer;                       // Seite des Treffers, 1-basiert
    Left, Top, Right, Bottom: Double;    // achsenparalleles Trefferrechteck
    MatchText: WideString;               // der Blocktext, der die Suchanfrage enthielt
  end;
Das Begrenzungs-Array ist X/Y-interleaved, nicht vier Ecken
Dies ist das Detail, das zuerst Probleme bereitet. GetTextBlockBound(ListID, Index, BoundIndex) erwartet einen BoundIndex von 1 bis 8, und diese acht Werte sind nicht „Ecke 1, Ecke 2, Ecke 3, Ecke 4“ mit jeweils zwei gruppierten Feldern, wie man vielleicht vermuten würde. Es sind X, Y, X, Y, X, Y, X, Y: Die ungeraden Indizes sind X-Koordinaten, die geraden Indizes sind Y-Koordinaten, insgesamt also vier Punkte. Liest man sie in der falschen Paarung aus, ist das Rechteck Unsinn
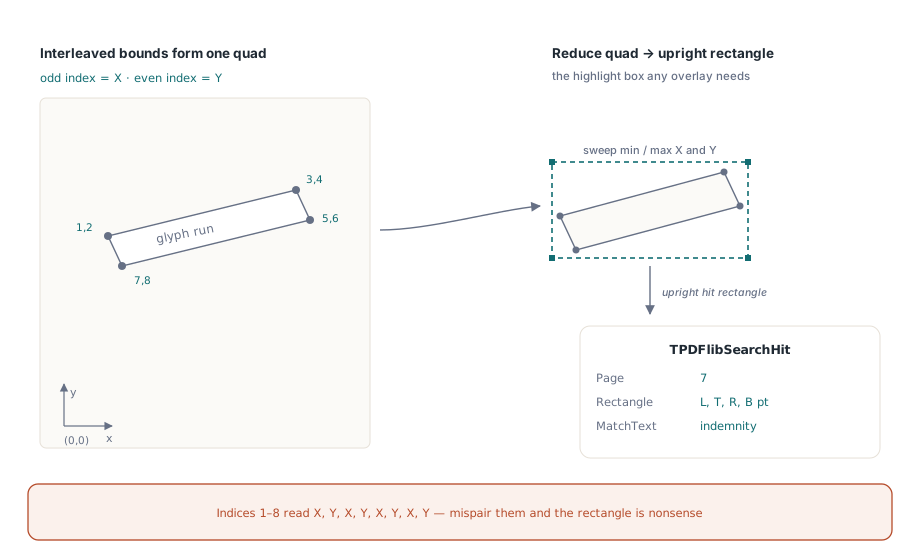
Der Grund, warum überhaupt ein Viereck vorliegt und nicht ein einfaches Rechteck, ist die Rotation. Ein schräg gesetzter Textblock hat ein echtes Vierpunkt-Begrenzungspolygon, und die acht Double-Werte beschreiben es getreu. Für den Anwendungsfall „Hervorheben und Springen“ wünschen Sie sich fast immer eine aufrechte Box. Daher reduziert die Bibliothek das Viereck auf ein achsenorientiertes Rechteck, indem sie das Minimum und Maximum von X und Y der vier Punkte ermittelt. Rotierter Text kollabiert auf die aufrechte Box, die ihn umschließt, was genau das ist, was eine Hervorhebungs-Überlagerung benötigt:
var
  Pdf: TPDFlib;
  Hits: array[0..255] of TPDFlibSearchHit;
  Found, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('contract.pdf', '');
    // Search pages 1 to 10, case-insensitive, substring match.
    Found := Pdf.SearchText('indemnity', [], '1-10', Hits);
    for I := 0 to Found - 1 do
      if I <= High(Hits) then
        WriteLn(Format('p%d: [%.1f %.1f %.1f %.1f] %s',
          [Hits[I].Page, Hits[I].Left, Hits[I].Top,
           Hits[I].Right, Hits[I].Bottom, Hits[I].MatchText]));
  finally
    Pdf.Free;
  end;
end;
Beachten Sie, dass das Rechteck in PDF-User-Space-Punkten vorliegt, mit dem Ursprung unten links auf der Seite — demselben Koordinatensystem, das Sie an Zeichen- und Annotationsaufrufe übergeben. Das ist Absicht: Das Rechteck, das ein Suchtreffer zurückliefert, können Sie direkt an eine Highlight-Annotation oder an ein „Hierhin scrollen“-Kommando weiterreichen, ohne irgendetwas umzurechnen
Groß-/Kleinschreibung, ganze Wörter und wo CJK sich unterscheidet
Der zweite Parameter ist ein TPDFlibSearchOptions-Set, gebildet aus soCaseSensitive und soWholeWord. Das leere Set [] ist der Regelfall: Eine fallunempfindliche Teilzeichenfolgensuche. Fügen Sie soCaseSensitive hinzu, um Indemnity und indemnity zu unterscheiden, oder fügen Sie soWholeWord hinzu, um zu verhindern, dass sign in signature matcht, oder kombinieren Sie beides
Der Abgleich ganzer Wörter erfordert eine Definition dessen, was eine Wortgrenze ist. Hier ist es wert, die Regel deutlich zu formulieren, da sie konstruktionsbedingt ASCII-zentriert ist. Ein Zeichen gilt als Teil eines Wortes, wenn es sich um einen ASCII-Buchstaben, eine ASCII-Ziffer oder einen Unterstrich handelt — die aus den Identifikationsregeln bekannte Klasse [A-Za-z0-9_]. Ein Treffer gilt nur dann als ganzes Wort, wenn die Zeichen unmittelbar davor und danach keine Wortzeichen sind (oder der Treffer am Rand des Blocks liegt)
Die Konsequenz für nicht-lateinische Schriften sollte man kennen, bevor man ein mehrsprachiges Suchfeld ausliefert. Da Han-Zeichen, Kana und andere Nicht-ASCII-Buchstaben aus dieser Klasse herausfallen, wird jede Grenze daneben als Nicht-Wort-Grenze interpretiert. In der Praxis bedeutet dies, dass sich die Ganzwortsuche in CJK-Texten so verhält, als ob jede Position eine gültige Wortgrenze wäre, so dass das Flag dort effektiv zu einer Teilzeichenfolgensuche degradiert. Dies ist eine dokumentierte Einschränkung, kein Fehler, und entspricht dem Verhalten, dem diese Funktion nachempfunden wurde. Wenn Ihr Korpus hauptsächlich aus CJK-Texten besteht, liefert Ihnen der Ganzwortmodus nicht die Segmentierung, die ein dedizierter Tokenizer liefern würde; planen Sie darum herum, anstatt sich darauf zu verlassen
Eine Implementierungs-Fußnote, die eine Klasse subtiler Fehler an anderer Stelle erklärt: Der fallunempfindliche Vergleich verwendet UpperCase auf dem WideString und nicht AnsiUpperCase. Die Ansi-Variante gibt einen AnsiString zurück, der nicht mit dem WideString übereinstimmen würde, den der Rest des Pfades verwendet. Das Mischen der beiden führt zu Typenkonflikten und, schlimmer noch, zu verlustbehaftetem Folding für Zeichen außerhalb der aktiven Codepage. Unicode rein, Unicode raus — auf dem gesamten Weg
Ein Seitenbereichs-Parser für die gesamte Bibliothek
Der dritte Parameter ist eine Seitenbereichszeichenfolge wie "1,3,5-9". Die Art und Weise, wie sie geparst wird, ist nicht speziell: Dasselbe PLParsePageRangeList, das PrintPages und die Seitenkopierroutinen unterstützt, verarbeitet sie auch hier, so dass ein Bereich, der korrekt gedruckt wird, auch korrekt durchsucht wird. Eine leere Bereichszeichenfolge ist das Signal für „jede Seite“, in diesem Fall erstellt SearchText die vollständige Liste selbst
Der Umfang ist entscheidend für die Kosten. Das Durchsuchen eines zehnseitigen Ausschnitts eines tausendseitigen Dokuments extrahiert Blöcke für zehn Seiten, nicht für tausend, da die Schleife nur die im Bereich genannten Seiten auswählt und extrahiert. Wenn Sie bereits wissen, dass sich eine Klausel im Anhang befindet, geben Sie dies im Bereich an und überspringen Sie den Rest der Datei
Intern, ändern Suche und Aufzählung beide die ausgewählte Seite bei der Iteration. Daher speichert jede Methode die ausgewählte Seite des Aufrufers beim Einstieg und stellt sie in einem finally-Block wieder her. Rufen Sie SearchText mitten im Aufbau einer Seite auf, befindet sich Ihre Auswahl genau dort, wo Sie sie vor dem Aufruf verlassen haben. Dieser Vertrag zum Speichern und Wiederherstellen ist die Art von Sache, die man erst bemerkt, wenn sie fehlt — weshalb sie genau dort vorhanden ist
Aufzählung einer ganzen Seite: Text und Bilder in einer Liste
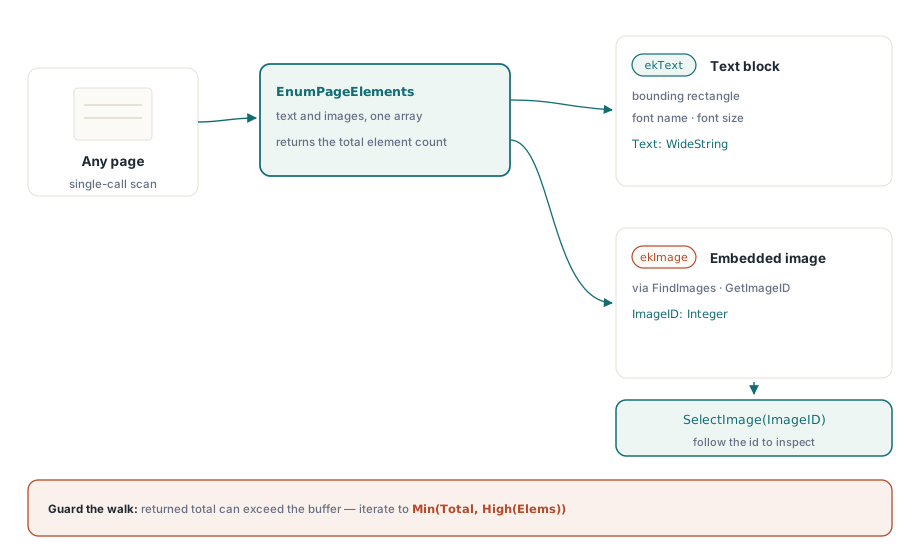
Die Suche beantwortet die Frage „Wo ist dieses Wort?“. Die andere Hälfte der Introspektion ist „Was befindet sich überhaupt auf dieser Seite?“, und das ist EnumPageElements. Sie gibt eine einheitliche Liste zurück, in der jedes Element entweder ein Textblock oder ein eingebettetes Bild ist, unterschieden durch ein Kind-Feld:
type
  TPDFlibPageElementKind = (ekText, ekImage);

  TPDFlibPageElement = record
    Kind: TPDFlibPageElementKind;
    Page: Integer;
    Left, Top, Right, Bottom: Double;
    Text: WideString;        // ekText
    FontName: WideString;    // ekText
    FontSize: Double;        // ekText
    ImageID: Integer;        // ekImage; nutzbar mit SelectImage / GetImageID
  end;
Textelemente stammen aus demselben ExtractPageTextBlocks-Durchlauf, so dass jedes Element bereits mit seinem Rechteck, seinem Schriftnamen und seiner Größe gefüllt ist. Bildelemente stammen aus der eingebetteten Bildliste der Seite über FindImages und GetImageID; die darin enthaltene ImageID ist das Handle, das Sie an SelectImage übergeben, um das Bild weiter zu untersuchen. Die beiden Arten landen in einem Array, so dass ein einziger Durchgang über eine Seite alles darauf sieht
var
  Pdf: TPDFlib;
  Elems: array[0..511] of TPDFlibPageElement;
  Total, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('report.pdf', '');
    Total := Pdf.EnumPageElements(1, Elems);
    for I := 0 to Total - 1 do
      if I <= High(Elems) then
        if Elems[I].Kind = ekText then
          WriteLn(Format('text  %s/%.1f  "%s"',
            [Elems[I].FontName, Elems[I].FontSize, Elems[I].Text]))
        else
          WriteLn(Format('image id=%d', [Elems[I].ImageID]));
  finally
    Pdf.Free;
  end;
end;
Es gibt hier eine Zählkonvention, die dem Rest der Bibliothek folgt und die Sie einhalten müssen, da Sie sonst uninitialisierten Speicher auslesen. Der Rückgabewert ist die gesamte Elementanzahl, die größer sein kann als das von Ihnen übergebene Array. Die Funktion füllt nur so viele Slots, wie hineinpassen, und zählt den Rest weiter — genau so, wie die Signaturaufzählung funktioniert. Die Schutzmaßnahme ist also immer dieselbe: Begrenzen Sie Ihre Schleife auf den kleineren Wert aus zurückgegebenem Zähler und High(Array), iterieren Sie niemals blind bis zum Zähler. Die obigen Beispiele zeigen aus diesem Grund die Prüfung I <= High(...). Wenn der Rückgabewert Ihren Puffer überschreitet, dimensionieren Sie ein größeres Array und rufen Sie die Methode erneut auf
Wenn Sie die systemnäheren Textblock-Aufrufe der Bibliothek verwendet haben, ist dies die typisierte, geometriebewusste Schicht darüber; die zugrunde liegende Extraktion entspricht der in PDF-Text-, Bild- und Schriftartenextraktion in Delphi mit PDF Library for Delphi beschriebenen. Und wenn das Ziel nicht „Wo ist dieser Text“, sondern „Wie ist dieses Dokument für unterstützende Technologien strukturiert“ lautet, ist die parallele leseseitige Geschichte der Strukturbaum der taggten PDF, der die logische Lesereihenfolge anstelle des physischen Blocklayouts offenlegt
Bereichsabfragen, wenn Sie bereits wissen, wo Sie suchen müssen
Manchmal haben Sie überhaupt keinen Suchbegriff, sondern ein Rechteck. Eine Formularvorlage platziert die Rechnungsnummer immer in der oberen rechten Ecke, oder ein gescanntes Layout reserviert einen festen Bereich für eine Tabelle. GetTextInAreaEx bedient diesen Fall. Es ist das die Grenzen tragende Gegenstück zu GetTextInArea: Wo der ältere Aufruf eine flache Liste von Zeichenfolgen für einen Bereich zurückgibt, liefert der neue das Rechteck jedes enthaltenen Blocks zusammen mit seinem Text, so dass Sie nicht nur erfahren, was in der Box steht, sondern auch, wo in ihr jede Zeile liegt
var
  Pdf: TPDFlib;
  Hits: array[0..63] of TPDFlibSearchHit;
  Found, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('invoice.pdf', '');
    Pdf.SelectPage(1);
    // Left, Top, Width, Height in PDF-Punkten auf der gewählten Seite
    Found := Pdf.GetTextInAreaEx(360, 720, 180, 60, Hits);
    for I := 0 to Found - 1 do
      if I <= High(Hits) then
        WriteLn(Hits[I].MatchText);
  finally
    Pdf.Free;
  end;
end;
Zwei Dinge, die man beachten sollte. GetTextInAreaEx arbeitet auf der aktuell ausgewählten Seite, rufen Sie also zuerst SelectPage auf; im Gegensatz zu SearchText erwartet die Methode keinen Bereich. Und ein Block wird beibehalten, wenn er das Abfragerechteck schneidet (intersects), nicht nur, wenn er vollständig darin enthalten ist, so dass eine Zeile, die die Grenze überschreitet, immer noch durchkommt. Das ist normalerweise das, was Sie für eine handgezeichnete Auswahlbox wünschen. Wenn Sie jedoch eine strikte Eingrenzung benötigen, können Sie die zurückgegebenen Rechtecke selbst filtern, da Sie sie nun vorliegen haben
Inbetriebnahme und Praxiseinsatz
Der rote Faden bei allen drei Aufrufen ist, dass Geometrie nichts mehr ist, was man nachträglich rekonstruieren muss. Ein Suchtreffer kennt seine Seite und seine Box. Ein Seitenelement kennt sein Rechteck und bei Text seine Schriftart. Eine Bereichsabfrage meldet, wo jede Zeile hinfällt. Das reicht aus, um eine echte Such- und Hervorhebungsfunktion, einen Klick-Lokalisierungsindex oder einen layoutbewussten Extraktor zu erstellen, ohne unter die öffentliche API zu fallen oder die Textextraktions-Pipeline von Hand neu aufzubauen
Diese Abfrage-APIs werden als Teil der PDF Library for Delphi Delphi-PDF-Bibliothek ausgeliefert, zusammen mit der vollständigen Textblock-Extraktionsschicht, auf der sie aufbauen, und dem Rest der leseseitigen Introspektions-Oberfläche für Delphi und C++Builder