Ein halber Punkt entscheidet es. In einem Report mit 10 Punkt Fließtext wird ein Abschnittstitel in 11 Punkt fett in Markdown zu einem gewöhnlichen Absatz, während eine 12-Punkt-Bildunterschrift auf dem Cover, in normalem Schnitt, als ### Quarterly figures zurückkommt. Das wirkt verdreht, bis man sich daran erinnert, was eine PDF-Seite tatsächlich speichert: Glyphen an Koordinaten, einen Schriftnamen und eine Größe. Nichts auf der Seite sagt "Überschrift". Jede Überschrift, die ein Konverter ausgibt, ist ein Schuss aus diesen drei Fakten, und der Schuss hat Schwellen
Warum eine PDF-Seite keine Absätze zum Exportieren hat
Eine PDF-Seite enthält textzeigende Operatoren, keine Absätze. Jeder Operator platziert einen Glyphenlauf an einer Position, in welcher Reihenfolge auch immer die erzeugende Anwendung ihn ausgegeben hat, und ISO 32000-1 legt dem Producer keine Pflicht auf zu sagen, dass zwei Läufe zum selben Satz gehören, geschweige denn zum selben Listenelement oder Tabellenfeld. Das Format beschreibt eine gedruckte Seite exakt, und es kommt dorthin, indem es die Struktur wegwirft, die die Seite hervorgebracht hat
Also baut jeder Konverter das wieder auf, was der Generator weggeworfen hat. Zeilen kommen aus geteilten Grundlinien und vertikalen Abständen. Absatzgrenzen kommen aus Abstands- und Einrückungswechseln. Eine Liste ist eine Folge von Blöcken, die mit einem Aufzählungszeichen oder einem Nummernmuster beginnen. Eine Tabelle ist ein Raster aus Textblöcken, deren Kanten sich über Zeilen und Spalten ausrichten. Auf Dokumenten, die gewöhnlichen typografischen Gewohnheiten folgen, funktioniert das gut; auf einer Broschüre, die für visuelle Wirkung gesetzt wurde, hat es kaum etwas festzuhalten
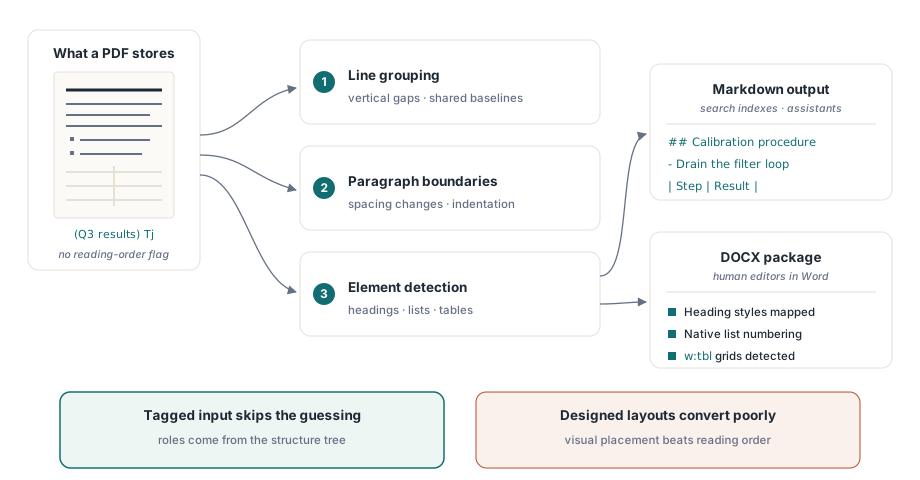
Getaggte PDFs sind die große Ausnahme. Trägt ein Dokument einen Strukturbaum, werden die Absatz-, Überschriften-, Listen- und Tabellenrollen vom Producer erfasst statt nachträglich geraten, weshalb sich die in Barrierefreiheitsstruktur getaggter PDFs beschriebene Arbeit auch bei der Konvertierungsqualität auszahlt. Kontrollieren Sie den Producer, ist das Taggen der Ausgabe das Prelligste, was Sie für jeden tun können, der sie später konvertiert
Woher die Überschriftenebenen kommen
PDF Library for Delphi entscheidet Überschriftenebenen auf zwei Arten, je nach Eingabe. Auf einer getaggten Seite behält ein Block mit Strukturrolle H1 bis H6 diese Ebene, und H oder Title wird Ebene 1. Auf einer ungetaggten Seite fällt der Export auf die Schriftgröße relativ zum Fließtext der Seite zurück und betrachtet nur einzeilige Absätze von 200 Zeichen oder weniger
Die Größenregel braucht beides, ein Verhältnis und eine absolute Lücke, gemessen gegen die dominierende Fließtextgröße:
| Markdown-Ausgabe | Größter Text der Zeile | Bei 10 pt Fließtext |
|---|---|---|
# | mindestens 1,6-fache Fließtextgröße und mindestens 4 pt größer | 16 pt und mehr |
## | mindestens 1,35-fache und mindestens 2,5 pt größer | 13,5 pt und mehr |
### | mindestens 1,15-fache und mindestens 1,25 pt größer | 11,5 pt und mehr |
Das erklärt das Eingangsbeispiel. Ein 11-Punkt-fetter Titel über 10-Punkt-Text verfehlt die dritte Stufe um einen halben Punkt, und der Schnitt spielt für die Ebene keine Rolle. Die Cover-Bildunterschrift mit 12 Punkt schafft sie. Die absolute Lücke existiert für kleine Fließtextgrößen: Bei 6-Punkt-Fußnotentext würde das Verhältnis allein eine 7-Punkt-Zeile zur Überschrift befördern, und die zusätzliche 1,25-pt-Anforderung verhindert das
Wir halten das für den richtigen Trade. Fett ist viel zu häufig im Fließtext (Einleitungsphrasen, definierte Begriffe, Summen in einer Ergebniszeile), um allein ein verlässliches Überschriftensignal zu sein, und ein Konverter, der jede fette Zeile befördert, produziert Markdown mit Dutzenden Scheinabschnitten. Ein paar rein fette Überschriften zu verlieren kostet weniger. Bauen Ihre Dokumente auf Fetttiteln in Fließtextgröße, ist der verlässliche Fix stromaufwärts: taggen, oder den Titel um anderthalb Punkte vergrößern
Fett und kursiv in der Ausgabe werden aus dem Schriftnamen gelesen. Ein Lauf, dessen Schriftname Bold, Black oder Demi enthält, wird **bold**; Italic oder Oblique wird *italic*. Producer, die Schriften unter opaken Namen wie F3 subsetten, oder Fett durch Umranden regulärer Glyphen faken, geben dem Export nichts zum Lesen, und dieser Text kommt unformatiert an
Markdown-Export für Retrieval-Pipelines
Der Markdown-Pfad ist der richtige, wenn das Ziel eine Text-Pipeline ist: eine Dokumentations-Site, ein Suchindex, ein gechunktes Korpus für einen Assistenten. ExportPageMarkdown gibt eine Seite als WideString zurück, ExportDocumentMarkdown einen Seitenbereich, und SaveMarkdownToFile und SaveMarkdownToStream schreiben denselben Text als UTF-8 ohne Byte-Order-Mark. Das fehlende BOM ist Absicht; eine ganze Reihe statischer Site-Generatoren und Diff-Tools behandelt es als Inhalt
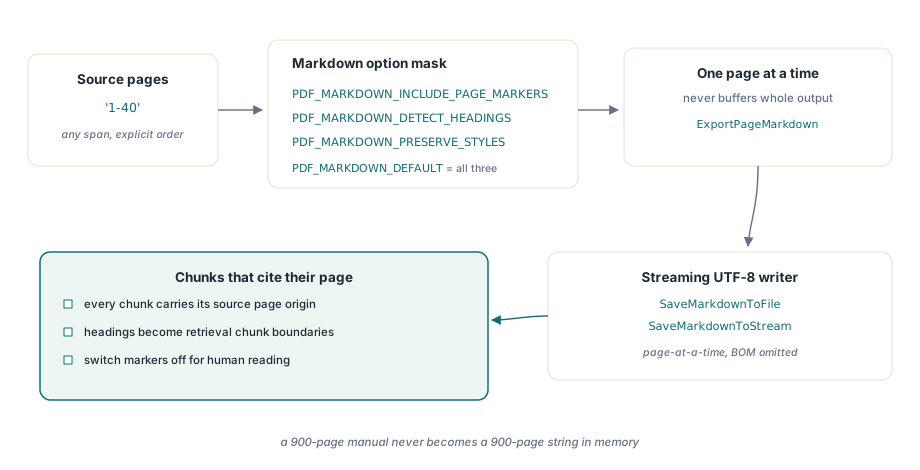
Optionen sind eine Bitmaske: PDF_MARKDOWN_INCLUDE_PAGE_MARKERS (1), PDF_MARKDOWN_DETECT_HEADINGS (2) und PDF_MARKDOWN_PRESERVE_STYLES (4), wobei PDF_MARKDOWN_DEFAULT alle drei kombiniert. Eine zweite, dokumentweite Einstellung steuert die Analyse selbst: SetStructuredTextOptions nimmt die PDF_STRUCTURED_*-Flags, und ihr Default erkennt Spalten, erkennt laufende Kopf- und Fußzeilen und fügt Tabellen, die über einen Seitenumbruch laufen, wieder zusammen
uses
  SysUtils, PDFlibrary;

var
  Pdf: TPDFlib;
  Exported: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    if Pdf.LoadFromFile('handbook.pdf', '') = 0 then
      raise Exception.Create('Cannot open handbook.pdf');

    // Die Erkennung von laufenden Kopf- und Fußzeilen ist per Default an;
    // EXCLUDE_FURNITURE ergänzt lässt sie auch aus der Ausgabe fallen
    Pdf.SetStructuredTextOptions(PDF_STRUCTURED_ADVANCED_DEFAULT or
      PDF_STRUCTURED_EXCLUDE_FURNITURE);

    // Seitenmarker und Überschriften, aber keine **- und *-Betonung
    Exported := Pdf.SaveMarkdownToFile('1-40',
      PDF_MARKDOWN_INCLUDE_PAGE_MARKERS or PDF_MARKDOWN_DETECT_HEADINGS,
      'handbook.md');
    if Exported = 0 then
      raise Exception.CreateFmt('Markdown export failed, error %d',
        [Pdf.LastErrorCode]);

    // JSON mit einem Eintrag pro Seite: readingSource ist tagged, mixed,
    // geometric oder geometric-columns
    Writeln(Pdf.GetLastStructuredTextDiagnostics);
  finally
    Pdf.Free;
  end;
end;
Für ein Retrieval-Korpus streichen wir PDF_MARKDOWN_PRESERVE_STYLES. Betonung wird Lauf für Lauf angewendet, eine fette Phrase aus mehreren Läufen kommt also als **Net** **revenue** heraus, was auf dem Bildschirm gut liest und jede Einbettung verrauscht. Seitenmarker sind der Gegensatzfall: behalten. Jeder Marker ist ein HTML-Kommentar, <!-- page: 12 -->, unsichtbar beim Rendern des Markdowns und trivial zu parsen, wenn man Chunks schneidet, sodass ein zurückgewonnener Absatz die Seite zitieren kann, aus der er stammt. Läuft eine Tabelle von der vorherigen Seite weiter, bleibt der Marker der neuen Seite weg, damit die Pipe-Tabelle in einem Stück bleibt
Zwei Verhalten fangen Leute, die seitenweise in einer Schleife exportieren. Erstens werden laufende Kopfzeilen durch Wiederholung erkannt: Ein Absatz in den oberen oder unteren 12 Prozent der Seite zählt als Ausstattung, wenn passender Text in demselben Band auf einer anderen Seite desselben Exports sitzt, mit normalisierten Ziffern, sodass "Seite 3 von 40" zu "Seite 4 von 40" passt. Ein einseitiger Aufruf hat keine andere Seite zum Vergleichen, eine ungetaggte Laufkopfe bleibt also im Text. Zweitens sind Bilder in Markdown inline als data:-URIs eingebettet, was die Datei in sich geschlossen hält und bedeutet, dass eine Seite mit einem großen Foto hunderte Kilobytes base64 zur Datei beisteuern kann. Hat Ihr Chunker ein Größenlimit, streichen Sie Zeilen, die mit 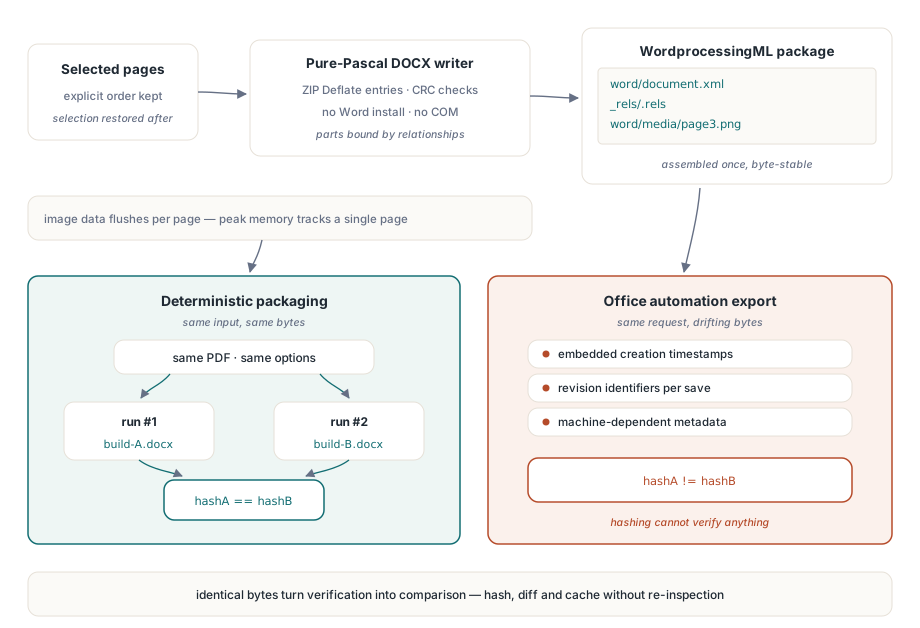
Zwei Entscheidungen halten das aufrecht. Jeder ZIP-Eintrag trägt dasselbe fixe DOS-Datum, den 1. Januar 1980, statt der Laufzeit, und der Core-Properties-Part hat keine Erstellungs- oder Änderungsdaten. Jeder Eintrag wird nur dann mit rohem Deflate komprimiert, wenn das ihn tatsächlich kleiner macht, PNG-Media, das bereits komprimiert ist, wird also unverändert gespeichert. Den ersten Punkt bestätigt unzip -v handbook.docx: Jede Zeile zeigt dasselbe Datum
Office-Automatisierung kann das nicht geben. Über Word zu speichern stempelt die aktuelle Zeit in die Paketmetadaten und die ZIP-Header, dasselbe Dokument zweimal konvertiert unterscheidet sich also in Weisen, die einen Hash zerschlagen. Dieselbe Überlegung steckt hinter den stabilen Datei-Identifiern in deterministischen PDF-IDs für reproduzierbare Builds: Ist die Ausgabe erst einmal reproduzierbar, wird Verifikation zu einem Vergleich
Welche Eingaben gut konvertieren, und welche niemals
Die Konvertierungsqualität schwankt stärker mit der Eingabe als mit dem Konverter, und es lohnt sich, Ihre Nutzer vorab darauf hinzuweisen. Getaggte PDFs und sauber erzeugte Geschäftsdokumente (Rechnungen, Berichte, Verträge) konvertieren gut: Überschriften landen als Überschriften, Tabellen überleben, Listen werden in Word neu nummeriert. Zweispaltige akademische Layouts kommen in der richtigen Leserichtung durch, wenn die Spaltengeometrie regelmäßig ist, und die Diagnostik meldet für diese Seiten geometric-columns. Tabellen, die über Seiten brechen, werden per Inferenz wieder zusammengefügt, also stichprobenartig nachprüfen. Stark gestaltetes Marketingmaterial, in dem Text für Wirkung statt in Leserichtung platziert ist, gibt jedem Konverter wenig zu bergen; rechnen Sie damit, das Ergebnis von Hand nachzuarbeiten
Gescannte Dokumente sind ein eigener Fall. Eine Seite, die ein einziges großes Bild ist, enthält keine Textobjekte, also gibt es nichts zu exportieren, bis eine Textebene existiert, und OCR zu fahren ist Voraussetzung für beide Formate. Bevor Sie sich auf einen großen Stapel festlegen, samplen Sie ein Dutzend repräsentativer Dateien und zählen Sie auf, was ihre Seiten enthalten, wie im Artikel zur Textsuche und Seitenelement-Aufzählung beschrieben; eine Seite mit Bildern und ohne Textläufe verrät in einer Sekunde mehr, als das gelesene Konvertat
Das Format nach dem wählen, was als Nächstes passiert. Markdown passt zu Maschinen und Pipelines: Überschriften werden zu Chunk-Grenzen, Tabellen bleiben als Pipe-Tabellen lesbar, und Seitenmarker geben jedem Chunk eine Zitation. DOCX passt zu Menschen, die das Dokument ändern wollen, denn was sie zurückwollen, ist eine editierbare Datei in Word, mit echten Listen und echten Tabellen, und der Text allein gibt ihnen das nicht
PDF Library for Delphi shippt für Delphi, C++Builder und Lazarus, mit DLL- und ActiveX-Editionen, die dieselben Markdown- und DOCX-Export-Aufrufe an C#, C++ und Skript-Hosts exponieren. Die Referenz für jedes Optionsflag und ein Testdownload liegen auf der PDF Library for Delphi Produktseite