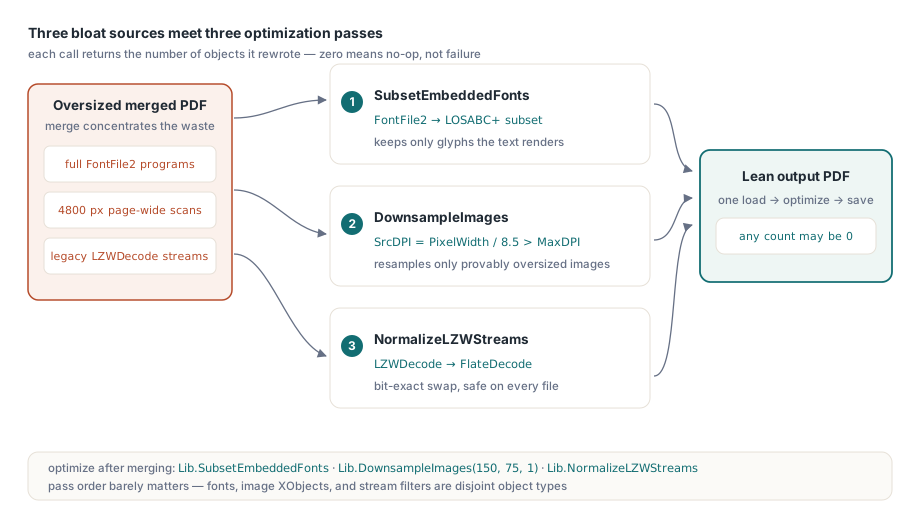
Um die PDF-Dateigröße in Delphi zu reduzieren, stellt die losLab PDF Library drei APIs zur Verfügung, die die drei größten Ursachen für unnötigen Ballast bekämpfen: SubsetEmbeddedFonts verkleinert jedes eingebettete TrueType-Schriftprogramm auf genau die Glyphen, die das Dokument tatsächlich rendert. DownsampleImages berechnet Rasterbilder neu, die eine Ziel-DPI überschreiten, und NormalizeLZWStreams ersetzt die veraltete LZWDecode-Komprimierung durch FlateDecode. Jede Funktion gibt die Anzahl der geänderten Objekte zurück, sodass eine Null Ihnen zeigt, dass der Durchgang wirkungslos blieb und nicht stillschweigend fehlgeschlagen ist
Warum ist mein zusammengeführtes PDF größer als seine Quelldateien?
Ein zusammengeführtes oder programmgesteuert generiertes PDF ist meist aus einem von drei Gründen überdimensioniert: vollständig eingebettete Schriftarten, Bilder, deren Auflösung weit über der Anzeigeauflösung liegt, und Streams, die immer noch mit dem veralteten LZW-Filter komprimiert sind. ISO 32000-1 §9.9 erlaubt es einem Erstellungsprogramm, das komplette Schriftart-Programm einzubetten. Die meisten Erstellungsprogramme tun genau das, weil es der sichere Standard ist. Eine vollständige Arial FontFile2 umfasst Hunderte von Kilobyte; betten Sie diese in ein Dutzend Quelldateien ein und führen Sie sie zusammen, tragen Sie am Ende ein Dutzend Kopien von Glyphenumrissen für Zeichen mit sich herum, die niemand getippt hat. Die Zusammenführung selbst erzeugt den Ballast nicht, sie konzentriert ihn lediglich in einer einzigen Datei, in der die Gesamtgröße schließlich sichtbar wird
Bilder sind der zweite Übeltäter. Ein 4800 Pixel breiter Scan, der in einem viertelseitigen Rahmen platziert wird, liefert etwa die 40-fache Pixeldatenmenge, die eine 300-DPI-Druckpipeline nutzen kann. Der dritte Grund ist unauffälliger: Streams, die mit LZWDecode gefiltert wurden. ISO 32000-1 §7.4.4 spezifiziert sowohl LZWDecode als auch FlateDecode und weist darauf hin, dass Flate in der Regel mindestens genauso gut komprimiert. In der Praxis ist die Flate-Ausgabe bei identischen Daten durchweg kleiner, und LZW überlebt meist in Dateien, die irgendwann in ihrer Geschichte Werkzeuge aus den 1990er-Jahren durchlaufen haben. Der Rest dieses Artikels führt durch die drei Durchgänge der losLab PDF Library, die jedes Problem beheben, und kombiniert sie anschließend in einer einzigen Pipeline
Schriftarten-Subsetting mit SubsetEmbeddedFonts
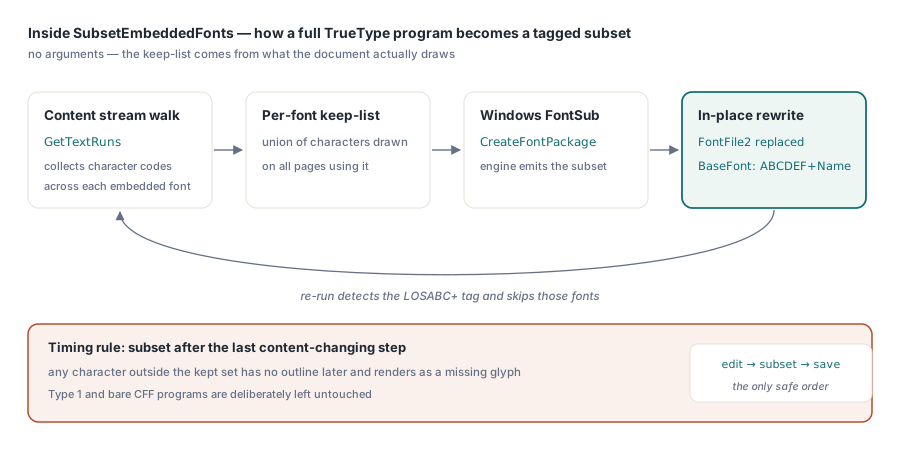
SubsetEmbeddedFonts verkleinert jede eingebettete TrueType-Schriftart in einem geladenen Dokument auf die Zeichen, die das Dokument tatsächlich verwendet. Es benötigt keine Parameter, da es die Liste der beizubehaltenden Zeichen direkt aus den Inhaltsströmen ableitet. Intern durchläuft der Schritt den Inhaltsstrom jeder Seite mittels GetTextRuns, sammelt die unter jeder Schriftartressource referenzierten Zeichencodes, erstellt eine Behalteliste und übergibt das ursprüngliche Schriftprogramm an die Windows FontSub-Engine (CreateFontPackage), um das Subset zu erzeugen. Das neu geschriebene Programm ersetzt den FontFile2-Stream an Ort und Stelle, und der Name der BaseFont erhält das Präfix LOSABC+ — die Konvention aus sechs Großbuchstaben und einem Pluszeichen, die ISO 32000-1 §9.6.4 für Subset-Schriftarten vorschreibt. Dieses Präfix macht den Aufruf auch idempotent: Führen Sie den Durchgang zweimal aus, werden bereits verarbeitete Schriftarten erkannt und übersprungen. Dies macht die Einbindung in einen Stapeljob, der Dateien möglicherweise erneut verarbeitet, sicher
var
  Lib: TPDFlib;
  Fonts: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('merged-report.pdf', '') = 1 then
    begin
      Fonts := Lib.SubsetEmbeddedFonts;
      // Fonts = Anzahl der neu geschriebenen FontFile2-Programme;
      // 0 bedeutet, dass nichts eingebettet war oder alles bereits ein Subset ist
      Lib.SaveToFile('merged-report-subset.pdf');
    end;
  finally
    Lib.Free;
  end;
end;
Zwei Implementierungsdetails sind wissenswert, da sie die Grenzen der API erklären. Erstens zielt der Durchgang auf FontFile2 ab, deckt also eingebettete TrueType-Programme ab. Schriftarten, die als Type 1 oder reines CFF eingebettet sind, bleiben unberührt, um Risiken zu vermeiden. Zweitens basiert er auf FontSub, was SubsetEmbeddedFonts zu einer rein Windows-basierten Funktion macht. Ein subtilerer Punkt der Implementierung: Ob eine Schriftart geeignet ist, wird durch die tatsächliche Auflösung der Referenzkette FontDescriptor → FontFile2 entschieden und nicht durch das Vertrauen in eine Heuristik für eingebettete Flags. Dies liegt daran, dass Schriftarten in einem geladenen Dokument nie die erstellungsseitige Buchführung durchlaufen haben, die solche Flags setzt. Existiert der aufgelöste Stream, ist die Schriftart ein Kandidat; wenn nicht, wird sie ohne Fehler übersprungen
Der ehrliche Kompromiss: Eine Subset-Schriftart enthält nur die Glyphen, die zum Zeitpunkt des Subsettings vorhanden waren. Wenn ein nachfolgendes Tool oder Ihr eigener Code später Text in derselben Schriftart hinzufügt, besitzt jedes Zeichen außerhalb des Subsets keinen Umriss und wird als fehlende Glyphe gerendert. Führen Sie das Subsetting als letzten inhaltlichen Änderungsschritt aus, niemals vor einer Bearbeitungsphase. Dieselbe Vorsicht gilt, wenn Sie planen, die Schriftart später zur Wiederverwendung wieder zu extrahieren. Der Artikel über das Extrahieren von Text, Bildern und Schriftarten mit PDF Library for Delphi beschreibt, was ein extrahiertes Subset-Programm leisten kann und was nicht
Wie entscheidet DownsampleImages, welche Bilder verkleinert werden?
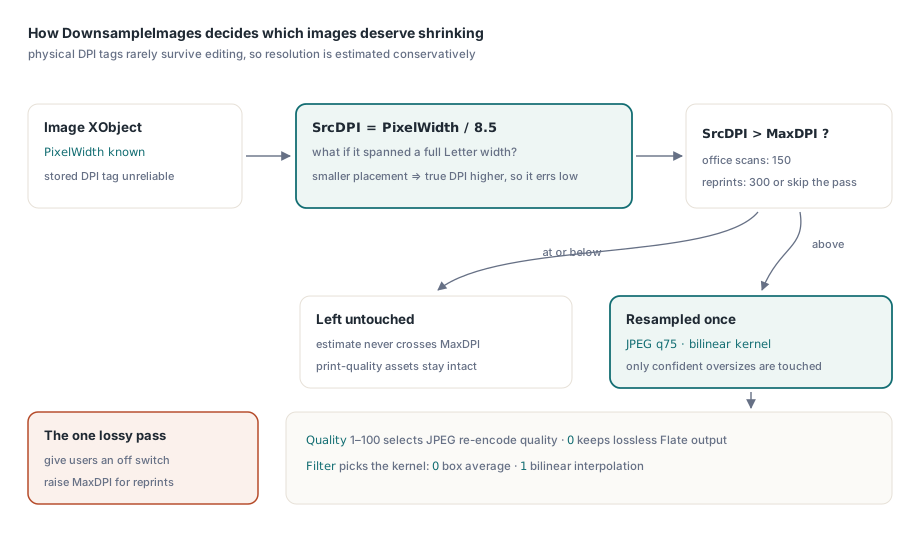
DownsampleImages(MaxDPI, Quality, Filter) berechnet nur die Bilder neu, die mit Sicherheit als überabgetastet eingestuft werden können, wobei eine bewusst konservative DPI-Schätzung verwendet wird. Ein PDF-Bild-XObject speichert Pixelabmessungen, aber keine vertrauenswürdige physische Auflösung. Jedes DPI-Tag aus dem Quellbild überlebt einen Lade-Bearbeitungs-Speicher-Zyklus selten. Daher schätzt der Durchgang SrcDPI = PixelWidth / 8.5, was praktisch die Frage stellt: Wenn dieses Bild die volle Breite einer Letter-Seite einnehmen würde, wie hoch wäre seine Auflösung? Nur Bilder, deren Schätzung MaxDPI überschreitet, werden verarbeitet. Diese Voreingenommenheit ist beabsichtigt: Ein Bild, das klein auf der Seite platziert ist, hat eine tatsächliche DPI, die höher ist als die Schätzung. Der Durchgang löst also eher zu selten aus, als dass er ein Bild mit Druckqualität beeinträchtigt, das er nicht messen kann
Der Parameter Quality von 1 bis 100 wählt die Qualität der JPEG-Neu-Codierung, während 0 die Ausgabe als verlustfreies Flate im PNG-Stil beibehält. Filter wählt den Resampling-Kernel, 0 für Box-Mittelwert und 1 für bilinear. Für gescannte Büro-Dokumente ist DownsampleImages(150, 75, 1) ein sinnvoller Ausgangspunkt. Für alles, was möglicherweise nachgedruckt wird, erhöhen Sie MaxDPI auf 300 oder überspringen Sie den Durchgang ganz. Das Downsampling ist der einzige verlustbehaftete Schritt der drei, weshalb er hinter einer Einstellung liegen sollte, die Ihre Benutzer deaktivieren können
Konvertieren von alten LZW-Streams mit NormalizeLZWStreams
NormalizeLZWStreams ist ein geschenkter Gewinn: Es dekomprimiert verlustfrei jeden LZWDecode-Stream und komprimiert ihn an Ort und Stelle neu mit FlateDecode, wobei es die Anzahl der konvertierten Streams zurückgibt. Es verarbeitet sowohl einen einzelnen Eintrag /Filter /LZWDecode als auch LZW, das innerhalb eines Filter-Chain-Arrays auftaucht, wobei nur das LZW-Glied ersetzt und der Rest der Kette beibehalten wird. Prädiktorparameter (Predictor, Columns, Colors, BitsPerComponent) werden aus den DecodeParms des Streams gelesen und an den Decompressor übergeben, sodass prädiktorkodierte Bilddaten korrekt verarbeitet werden. Da es sich bei beiden Filtern um bitgenaue Codecs handelt, sind die dekodierten Bytes vorher und nachher identisch; nur die Container-Komprimierung ändert sich. Deshalb kann dieser Durchgang bedenkenlos auf jede Datei angewendet werden
Bei einem Dokument ohne LZW-Streams gibt der Aufruf einfach 0 zurück und fasst nichts an, also meldet eine frisch erzeugte reine-Flate-Datei null Konvertierungen. Diese No-op-Garantie zählt, wenn der Durchgang in einer Pipeline sitzt, die Tausende heterogener Dateien verarbeitet, einige von 2024, einige von 1998
Die vollständige Pipeline zur Dateigrößenoptimierung in Delphi
Die drei Durchgänge lassen sich zu einer einzigen Funktion „Laden-Optimieren-Speichern“ kombinieren. Die Reihenfolge spielt dabei eine geringere Rolle als gedacht, da sie auf völlig unterschiedlichen Objekttypen operieren: Schriftarten, Bild-XObjects und Stream-Filtern. Das Subsetting an den Anfang zu stellen, bleibt dennoch die ordentlichste Wahl, da es sich um den Schritt mit einer Bearbeitungsreihenfolgebeschränkung handelt
function OptimizePDF(const Src, Dst: string): Boolean;
var
  Lib: TPDFlib;
  Fonts, Images, Streams: Integer;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(Src, '') <> 1 then
      Exit;
    Fonts   := Lib.SubsetEmbeddedFonts;        // TrueType FontFile2 -> Subset
    Images  := Lib.DownsampleImages(150, 75, 1); // >150 DPI -> JPEG q75, bilinear
    Streams := Lib.NormalizeLZWStreams;        // LZWDecode -> FlateDecode
    Result := Lib.SaveToFile(Dst) = 1;
    // Log Fonts/Images/Streams: Drei Nullen bedeuten, dass die Datei bereits schlank war
  finally
    Lib.Free;
  end;
end;
Verifizieren Sie die Pipeline mit einem Round-Trip: Dokument erstellen, speichern, neu laden, die Optimierung ausführen, erneut speichern, und dann drei Dinge behaupten: Die Ausgabe ist kleiner, die zurückgegebenen Zählerwerte entsprechen den Erwartungen, und ein erneutes Laden der optimierten Datei lässt sich weiterhin parsen und rendern. Diese Erstellen-Optimieren-Laden-Schleife gegen eine Stichprobe Ihrer eigenen Produktionsdateien nachzubilden und den extrahierten Text vorher und nachher zu vergleichen, ist eine einstündige Investition, die Integrationsfehler lange aufdeckt, bevor ein Kunde eine fehlerhafte Rechnung öffnet
// Round-Trip-Prüfung: Die optimierte Datei muss sich weiterhin sauber laden lassen
Lib := TPDFlib.Create;
try
  Assert(Lib.LoadFromFile('merged-report-opt.pdf', '') = 1);
  Assert(Lib.GetPageCount > 0);
finally
  Lib.Free;
end;
Wo passt die Pipeline in einen Zusammenführungsworkflow? Nach dem Zusammenführen, nicht währenddessen. Wenn Sie zuerst zusammenführen und das einzelne Ergebnis optimieren, wird jede eingebettete Schriftart einmal gegen die Vereinigungsmenge aller verwendeten Zeichen verkleinert, anstatt pro Quelldatei. Wenn der Zusammenführungsdurchsatz der Flaschenhals ist, bietet PDF Library for Delphi einen schnellen Pfad auf Byte-Ebene, der das vollständige Parsen von Objekten vermeidet, wie im Artikel über schnelles PDF-Zusammenführen mit Byte-Referenz-Verschiebung beschrieben. Für Eingaben, die zu groß sind, um vollständig im Speicher gehalten zu werden, behandelt der Direktzugriff beim Zusammenführen und Aufteilen großer PDFs den Streaming-Weg. Beide lassen sich natürlich mit einem abschließenden Optimierungsdurchlauf der zusammengeführten Ausgabe kombinieren
Wofür die drei Durchgänge gedacht sind
Das Optimierungstrio der losLab PDF Library fasst nichts an, was die Dokumentsemantik verändert. SubsetEmbeddedFonts verkleinert jede eingebettete Schrift unabhängig; doppelte Schriften über zusammengeführte Quellen hinweg in einem Programm zu vereinen, ist eine andere, riskantere Transformation. DownsampleImages wird nur aktiv, wenn seine konservative DPI-Schätzung den Schwellenwert überschreitet, sodass ein Grenzfall-Bild seine Pixel behält, selbst wenn ein Mensch erkennen könnte, dass es für seinen Rahmen überdimensioniert ist. Und die Durchgänge arbeiten auf Stream-Ebene, deshalb verlangt eine Datei, die durch Tausende verwaister Objekte aufgebläht ist, ein Speichern im Umschreibungsstil. Innerhalb dieser Grenzen beseitigt die Kombination aus Schriftarten-Subsetting, Bild-Downsampling und LZW-zu-Flate-Normalisierung die drei klassischen Quellen für PDF-Dateigrößen-Ballast, mit je einem vorhersehbaren API-Aufruf. Die drei Funktionen werden als Teil der losLab PDF Library für Delphi, C# und VB.NET geliefert, zusammen mit den oben besprochenen Merge-, Extraktions- und Rendering-APIs