Sie fügen einem Herstellerhandbuch einen neuen Label-Bereich hinzu, damit der Anhang als App-a, App-b lesbar ist statt A-1, A-2, speichern und öffnen die Datei wieder. Die Seitenbox zeigt weiter A-1. Öffnen Sie den Katalog in einem Texteditor, zeigt das /PageLabels-Dictionary den Grund: Es trägt ein vom Producer geerbtes /Kids-Array und, direkt daneben, ein frisches /Nums-Array mit Ihrem Bereich. ISO 32000-1 lässt die Wurzel eines Number Trees das eine oder das andere der beiden Keys haben, und ein Reader, der an der Wurzel /Kids findet, steigt darin hinab und schaut nicht weiter
Wie ein PDF Page-Label-Bereiche speichert
Page Labels sind die Zeichenketten, die ein Viewer in seiner Seitenbox zeigt, statt des physischen Seitenindex, und ISO 32000-1 §12.4.2 speichert sie als Number Tree unter dem Katalog-Key /PageLabels. Jeder Key ist ein 0-basierter Seitenindex, an dem ein Labeling-Bereich beginnt, und jeder Wert ist ein Label-Dictionary mit bis zu drei Einträgen: /S für den Nummerierungsstil (D, R, r, A oder a), /P für einen Prefix-String und /St für die Nummer der ersten Seite im Bereich, die auf 1 defaultet. Ein Bereich läuft bis zum nächsten Key. Die Spezifikation verlangt zudem einen Eintrag für Seitenindex 0, sodass jede Seite des Dokuments in irgendeinem Bereich liegt
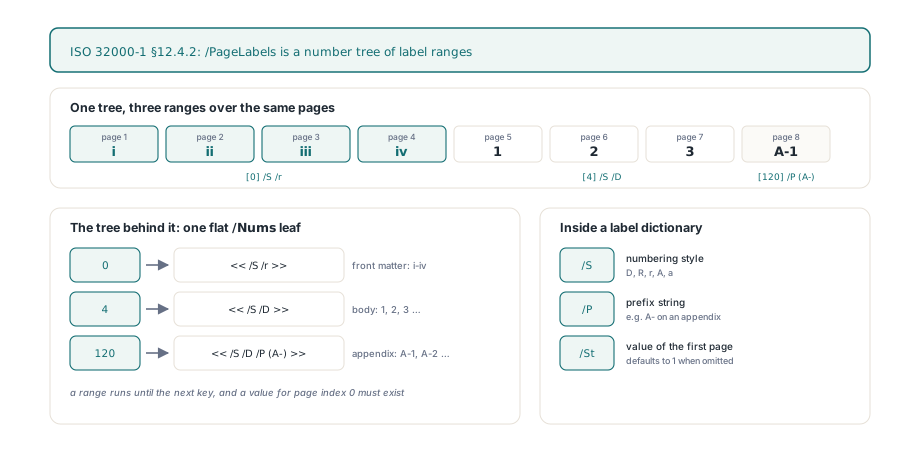
In PDF Library for Delphi ist der Schreiber TPDFlib.AddPageLabels(Start, Style, Offset, Prefix), und er mappt auf dieses Dictionary mit drei Regeln, die man sich merken sollte. Start ist 1-basiert wie jedes andere Seitenargument in der Bibliothek und geht als Start - 1 in den Tree. Style läuft von 0 bis 5: 0 schreibt gar kein /S, das Label ist dann der Prefix allein (praktisch für eine einzelne Seite mit dem Label Cover), und 1 bis 5 werden zu D, R, r, A und a. Ein Stil außerhalb 0..5 lässt den Aufruf 0 zurückgeben und das Dokument unangetastet. Offset wird nur dann zu /St, wenn es größer als null ist; bei 0 bleibt der Key weg, was jeder Reader als 1 liest
Ein typisches Buch aus einem Layout-Tool braucht drei Bereiche: kleine römische Ziffern für den Vorspann, arabische Zahlen für den Hauptteil und einen Anhang mit Prefix
uses
  PDFlibrary;

var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('handbook.pdf', '') <> 1 then
      Exit;
    // Seiten 1-4: i, ii, iii, iv (kleine römische Ziffern)
    Lib.AddPageLabels(1, 3, 1, '');
    // Seiten 5-120: 1, 2, 3 ... (dezimal, ab 1 neu beginnend)
    Lib.AddPageLabels(5, 1, 1, '');
    // Seiten ab 121: A-1, A-2 ... (dezimal mit Prefix)
    Lib.AddPageLabels(121, 1, 1, 'A-');
    WriteLn(Lib.GetPageLabel(5));    // 1
    WriteLn(Lib.GetPageLabel(122));  // A-2
    Lib.SaveToFile('handbook-labeled.pdf');
  finally
    Lib.Free;
  end;
end;
Page Labels kamen mit PDF 1.3, jeder Aufruf bittet das Dokument daher auch, seine Ausgaboversion auf mindestens 1.3 anzuheben. Haben Sie die Version mit LockSaveVersion festgenagelt, wird diese Bitte ignoriert und die Sperre hält, denn die Bibliothek überstimmt keine Version, die Sie mit Absicht gewählt haben. Wenn Sie schon sperren, dann in jedem Job, der Labels schreibt, auf 1.3 oder höher
Warum verschwindet ein neuer Bereich, wenn die Wurzel /Kids hat?
Der Bereich verschwindet, weil ISO 32000-1 §7.9.7 (Tabelle 37) der Wurzel eines Number Trees entweder /Kids oder /Nums gibt, nie beides, und Reader /Kids wählen, wenn es da ist. Producer langer Dokumente teilen den Tree oft in Zwischenknoten, jeweils mit einem /Limits-Paar, und hängen sie an eine Wurzel, die nur /Kids hat. Eine Insert-Routine, die nur /Nums kennt, schaut auf diese Wurzel, findet kein Array, legt eines neben das bestehende /Kids und wirft den neuen Bereich hinein. Das Schreiben gelingt, die Datei bleibt parsebar. Jeder Viewer steigt danach über /Kids hinab, sieht die drei ursprünglichen Bereiche des Producers und fasst das verirrte Array nie an — genau das Symptom aus dem Eingangsabsatz
Der Ausweg besteht darin, die Wurzel nicht mehr als Container zu behandeln, der nachwachsen einen zweiten Einstiegspunkt bekommen könnte. Findet AddPageLabels /Kids an der Wurzel, läuft es zuerst jedes Blatt des bestehenden Trees von links nach rechts ab und sammelt jeden Key mit seinem Label-Dictionary ein, um aus dieser Liste ein einziges flaches /Nums-Array zu bauen. /Kids, /Limits und übrig gebliebene /Nums werden von der Wurzel entfernt, bevor das flache Array angehängt wird, und erst dann kommt der neue Bereich mit einem gewöhnlichen sortierten Insert hinein. Auch das Entfernen von /Limits ist wichtig: Tabelle 37 erlaubt es nur an Zwischen- und Blattknoten, eine Wurzel, die es behält, ist malformed, selbst wenn sie jetzt /Nums trägt
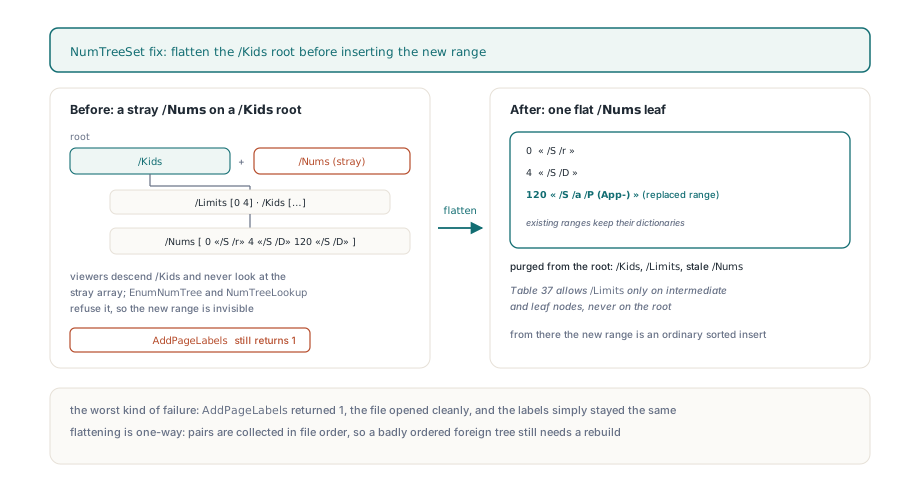
Ein Nebeneffekt ist leicht zu übersehen. Erreicht Sie eine Datei schon kaputt — beide Keys an der Wurzel, weil ein früheres Werkzeug den naiven Insert gemacht hat —, folgt der Blatt-Walk dem /Kids, genau wie ein Viewer, die Bereiche des verirrten Arrays werden also nicht mitgenommen. Ein Viewer hat diese Bereiche auch nie gezeigt, die Labels nach dem Edit passen also zu dem, was Reader ohnehin sahen
Der flachgemachte Tree wird anschließend nicht wieder in balancierte /Kids-Knoten überführt, und wir halten das für die richtige Entscheidung bei genau diesem Tree. Balancing zahlt sich bei Name Trees mit tausenden Destinations oder Embedded Files aus. Ein Page-Label-Tree hat einen Eintrag pro Labeling-Bereich, und selbst ein großes Referenzhandbuch braucht selten mehr als ein paar Dutzend; ein einziges Blatt ist auch das, was die meisten Producer schreiben, wenn sie nicht um des Teilens willen teilen. Ein Rebalancing-Durchlauf würde Code hinzufügen, der bei jedem Speichern schiefgehen kann, für einen Nachschlagegewinn, den bei so einem kleinen Tree niemand messen könnte
// Den Anhang umlabeln in einer Datei, deren /PageLabels-Wurzel /Kids nutzt
if Lib.LoadFromFile('vendor-manual.pdf', '') = 1 then
begin
  WriteLn('Before: ', Lib.GetPageLabel(121));  // z. B. A-1
  // Derselbe Startindex wie der bestehende Bereich, sein Dictionary wird also ersetzt
  if Lib.AddPageLabels(121, 5, 1, 'App-') = 1 then
  begin
    WriteLn('After: ', Lib.GetPageLabel(121));  // App-a
    WriteLn('Front: ', Lib.GetPageLabel(2));    // ii, unverändert
    Lib.SaveToFile('vendor-manual-relabeled.pdf');
  end;
end;
Weil der neue Bereich auf demselben Seitenindex wie ein bestehender Key beginnt, ersetzt der Insert das Dictionary dieses Keys, statt einen zweiten Eintrag für Seitenindex 120 anzuhängen. Die römischen und dezimalen Bereiche aus den Producer-Blättern kommen mit ihren ursprünglichen Dictionarys durch, eingeschlossen vorhandener /St-Werte
Der Blatt-Walk muss auch malformed Trees überleben. Ein /Kids-Eintrag, der auf einen eigenen Vorfahren zurückzeigt, oder zwei Zweige, die sich ein Blatt teilen, tauchen in Dateien aus beschädigten Pipelines auf. Die Traversierung merkt sich, welche Knoten sie schon besucht hat, ein Zyklus wird also einmal abgelaufen und dann liegen gelassen, und ein geteiltes Blatt liefert seine Bereiche einmal. Denselben Fragen bei Name Trees geht der Artikel zum Umgang mit Name-Tree-Zyklen, schlechten /Limits und großen Blättern nach
Ein /Nums-Array paarweise abgehen
Ein /Nums-Array ist ein flacher Zug abwechselnder Einträge, [key0 value0 key1 value1 ...], und nur die geraden Positionen sind Keys. Dieses Layout lädt zu einem klassischen Fehler ein. Eine Schleife, die Element für Element geht und fragt "ist das eine Zahl?", vergleicht Werte, als wären sie Keys, sobald ein Wert zufällig numerisch ist. Gewinnt dieser Vergleich einen Kleiner-Test, landet der Einfügepunkt auf einem ungeraden Index, das neue Paar rutscht mitten in ein bestehendes, und alle späteren Keys und Werte tauschen die Plätze
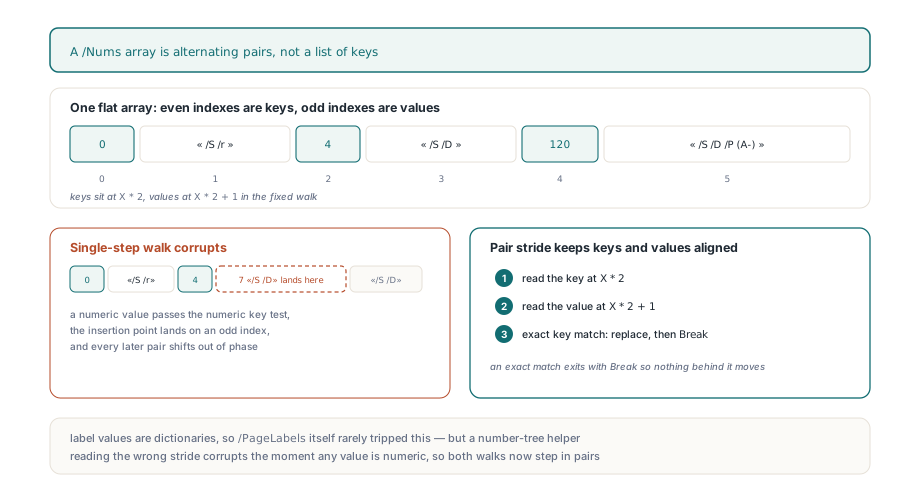
Page-Label-Werte sind Dictionarys, der Bug versteckt sich also auf /PageLabels selbst. Er zeigt sich an dem Tag, an dem derselbe Helfer für einen Number Tree wiederverwendet wird, dessen Werte schlichte Zahlen sind, und nichts in der Syntax des Arrays verrät, welche Sorte man da hält. PDF Library for Delphi liest Keys an Index X * 2 und Werte an X * 2 + 1, im Blatt-Walk wie im Insert, und ein exakter Key-Treffer ersetzt den Wert und stoppt den Scan. Wer eigenen Number-Tree-Code gegen rohe Objekte schreibt, übernimmt diese Schrittweite als allererstes
Labels mit GetPageLabel zurücklesen
TPDFlib.GetPageLabel(Page) gibt das Label für eine 1-basierte Seite zurück, und seine zwei Fallbacks verhalten sich mit Absicht verschieden. Ein Dokument ohne jeglichen /PageLabels-Eintrag gibt die dezimale Seitennummer zurück, ein Aufrufer kann die Funktion für die Anzeige also bedingungslos verwenden. Ein Dokument mit Tree, aber ohne Bereich, der die angefragte Seite abdeckt, gibt einen leeren String zurück. Der zweite Fall ist das, was eine Datei liefert, die den zwingenden Eintrag für Seitenindex 0 überspringt: Die ersten Seiten haben im Sinne der Spezifikation kein Label, und ein leerer String meldet das ehrlicher als eine ausgedachte Nummer. Beginnen Sie Ihren Label-Satz stets bei Seite 1
Buchstaben-Stile folgen der PDF-Spezifikation, nicht Tabellenkalkulations-Spalten. Nach Z kommt AA, dann BB, dann CC; der Buchstabe wiederholt sich, statt zu übertragen, Seite 53 eines A-Bereichs ist also AAA. Römische Ziffern werden für R in Großbuchstaben und für r in Kleinbuchstaben erzeugt, und der Prefix wird in beiden Fällen unverändert vorangestellt
var
  P: Integer;
  Data: WideString;
begin
  // Kurzer Audit dessen, was ein Viewer in seiner Seitenbox zeigen wird
  for P := 1 to Lib.PageCount do
    WriteLn(P, ' -> ', Lib.GetPageLabel(P));

  // Optionswert 4 exportiert nur die Label-Bereiche, ein PageLabelBegin-
  // Block pro Bereich
  Data := Lib.ExportDocumentData(4);
  // ... den Text bearbeiten oder in eine andere Datei tragen ...
  // Der erste Label-Record leert die bestehenden Bereiche, dann wird jeder
  // Record über AddPageLabels abgespielt; gibt die angewendeten Records zurück
  WriteLn(Lib.ImportDocumentData(Data, 4), ' label ranges applied');
end;
Für Massen-Edits schreibt ExportDocumentData mit Optionswert 4 jeden Bereich als PageLabelBegin-Block, gefolgt von PageLabelNewIndex (die 1-basierte Startseite), PageLabelStart, einer optionalen PageLabelPrefix- und einer PageLabelNumStyle-Zeile, mit Namen wie LowercaseRomanNumerals und DecimalArabicNumerals. ImportDocumentData behandelt den ersten Label-Record, dem es begegnet, als vollständige Ersetzung: Es ruft einmal ClearPageLabels auf, was den kompletten /PageLabels-Eintrag aus dem Katalog entfernt, und füttert dann jeden Record an AddPageLabels. Der neu gebaute Tree ist von Anfang an ein einziges Blatt, ein Text-Round-Trip durch ein /Kids-förmiges Original kommt also in derselben flachen Form zurück, die der Umlabel-Pfad erzeugt
Blattreihenfolge und Seitenverschiebungen nach dem Umlabeln
Das Flachmachen behält die Bereiche in der Reihenfolge, in der es sie vorfindet. §7.9.7 verlangt Keys in aufsteigender Ordnung, aber Dateien mit durcheinandergebrachten Blättern zirkulieren trotzdem, und GetPageLabel wendet den letzten Bereich dieser Ordnung an, dessen Key auf oder unter dem Seitenindex liegt. Für eine Datei, die ihre Bereiche als [0 roman, 120 A-, 4 decimal] deklariert, mit dem dezimalen Bereich ab 1, löst Seite 122 zum dezimalen Bereich auf und liest 118, wo Sie A-2 erwarteten. Zeigt das seitenweise Audit von oben solche Labels, flicken Sie nicht mit einem weiteren AddPageLabels-Aufruf herum. Rufen Sie ClearPageLabels und schreiben Sie den ganzen Satz in aufsteigender Ordnung neu; vier Aufrufe sind billiger als das Nachdenken darüber, welcher Bereich gewinnt
Labels hängen auch an Seitenindizes, nicht an Seitenobjekten. Alles, was Seitenzahl oder -ordnung ändert, lässt die Bereiche genau dort, wo sie waren, und sie zeigen auf die Seiten, die jetzt an diesen Indizes sitzen. Ein Tausch an Ort und Stelle wie das Ersetzen von Seiten unter Bewahrung der Objektnummern hält die Zahl, die Labels bleiben also ausgerichtet. Eine Verschmelzung wie das Sortieren verschränkter Duplex-Scans erzeugt eine neue Seitensequenz, und diese Ausgabe sollte nach dem Merge einen frisch geschriebenen Satz Bereiche bekommen, beginnend bei Seite 1
Die hier gezeigten Label-Aufrufe, das /Kids-Flachmachen und der Document-Data-Export und -Import sind Teil der PDF Library for Delphi für Delphi, C++Builder und Lazarus; ihr Referenzeintrag zu AddPageLabels listet Stilwerte und Rückgabecodes in einer Tabelle