PDFlibPas, die losLab PDF Library for Delphi, durchläuft PDF-Name-Trees und Number-Trees seit v3.539.45 mit einem expliziten Stack und einem Visited-Set, zyklische /Kids, geteilte Kinder und Tausende Ebenen tiefe Trees erschöpfen also nicht mehr den Call-Stack und duplizieren keine Einträge. Seit v3.539.51 versteckt ein fehlendes, missgebildetes oder umgedrehtes /Limits-Paar nie mehr einen Zweig, der den Schlüssel hält. Named Destinations, Page Labels, Attachments und Dokument-Level-JavaScript lesen alle durch diese beiden Codepfade, was sie zum Teil der Angriffsfläche jedes PDF macht, das Sie nicht selbst erzeugt haben
Der Auslöser ist selten exotisch. Ein Fuzzer, ein feindlicher Upload oder ein fehlerhaftes inkrementelles Speichern schreibt einen /Kids-Eintrag, der auf einen Ahnen zurückzeigt, und ein rekursiver Walker stirbt mit einem Stack Overflow an einer Zweikilobyte-Datei. Der stillere Ausfall ist ein Lookup, das einem kaputten /Limits-Array vertraut und für ein Destination, das offenkundig da ist, „nicht gefunden“ meldet
Wo tauchen Name Trees und Number Trees in einem PDF auf?
Name Trees und Number Trees tauchen überall dort auf, wo ein PDF eine große Menge von Schlüsseln auf Objekte abbildet, und PDFlibPas liest mindestens vier davon über öffentliche APIs. ISO 32000-1 §7.9.6 definiert den Name Tree (String-Schlüssel, Tabelle 36) und §7.9.7 den Number Tree (Integer-Schlüssel, Tabelle 37). Beide sind mehr oder weniger balancierte Trees, deren Wurzel- und Zwischenknoten /Kids tragen, deren Leaves die sortierten Schlüssel-Wert-Paare in /Names oder /Nums tragen und deren Nicht-Wurzelknoten ein zweielementiges /Limits-Array mit dem kleinsten und größten Schlüssel unter ihnen tragen
| Tree | Wo er lebt | Spezifikation | PDFlibPas-Lese-API |
|---|---|---|---|
| Named Destinations | /Dests im Name-Dictionary | §12.3.2.3 | GetNamedDestination, dann GetDestPage / GetDestType |
| Page Labels | /PageLabels im Katalog (Number Tree) | §12.4.2 | GetPageLabel |
| Attachments | /EmbeddedFiles im Name-Dictionary | §7.7.4, §7.11.4 | EmbeddedFileCount, GetEmbeddedFileStrProperty |
| Dokument-Level-JavaScript | /JavaScript im Name-Dictionary | §7.7.4 | GlobalJavaScriptCount, GlobalJavaScriptPackageName |
Zwei Details in dieser Tabelle sind leicht zu übersehen. Named Destinations haben auch eine ältere PDF-1.1-Form, ein schlichtes /Dests-Dictionary im Katalog, verschlüsselt nach Name-Objekten, und GetNamedDestination prüft dieses Dictionary zuerst, bevor es in den PDF-1.2-Name-Tree hinabsteigt. Und GetDocJavaScript ist gar kein Name-Tree-Leser: Es liefert die Skripte, die an Dokument-Trigger im Katalog-/AA-Dictionary hängen (WS, DS, WP, DP, DC), während die benannten Skriptpakete, die beim Öffnen eines Dokuments laufen, im /JavaScript-Name-Tree leben
Jedes Byte dieser Strukturen kommt aus der Datei. Die Spezifikation sagt, was ein Schreiber erzeugen soll; sie kann einen Leser nicht daran hindern, etwas anderes zu erhalten — dieselbe Lektion wie hinter dem Härtenden eines Pascal-PDF-Parsers gegen bösartige Dateien, hier angewandt auf die Tree-Form statt auf Puffergrößen
Warum lässt ein zyklisches /Kids-Array einen rekursiven Tree-Walker abstürzen?
Ein zyklisches /Kids-Array lässt einen rekursiven Walker abstürzen, weil nichts in der Rekursion bemerkt, dass es einen Knoten schon einmal gesehen hat, ein Kind, das auf seinen eigenen Ahnen verweist, macht also aus einer endlichen Datei einen unendlichen Abstieg. Vor v3.539.45 riefen sich NameTreeLookup, NumTreeLookup, EnumNumTree und das interne TPDFNameTree.ProcessNode alle einmal pro Kind selbst auf. Eine einzige Selbstreferenz genügte, um den Prozess zu beenden, und ein legitimer, aber sehr tiefer Tree konnte dasselbe ganz ohne Zyklus
Eine mildere Variante verfälscht Ergebnisse, statt abzustürzen. Wenn zwei /Kids-Einträge dasselbe Blatt referenzieren, besucht eine naive Enumeration es zweimal, und eine Attachment-Anzahl oder eine Liste von Skriptpaketen meldet Einträge, die es nicht gibt
Der Fix ersetzt die Rekursion durch einen expliziten Last-in-first-out-Stack auf dem Heap und ein Visited-Set, verschlüsselt nach Dictionary-Identität. Ein Knoten wird markiert, wenn er vom Stack genommen wird, nicht, wenn er darauf gelegt wird, eine zyklische Referenz darf also kurz auf dem Stack sitzen, wird aber im Moment ihres Wiederauftauchens verworfen. Jeder unterschiedliche Knoten expandiert seine Kinder genau einmal, was die Gesamtarbeit durch die Anzahl unterschiedlicher Dictionaries plus die Gesamtlänge ihrer /Kids-Arrays begrenzt. Tiefe hört auf zu zählen: Eine 4.096 Ebenen lange Kette ist einfach 4.096 Schleifeniterationen und 4.096 Einträge in einem Hash-Set
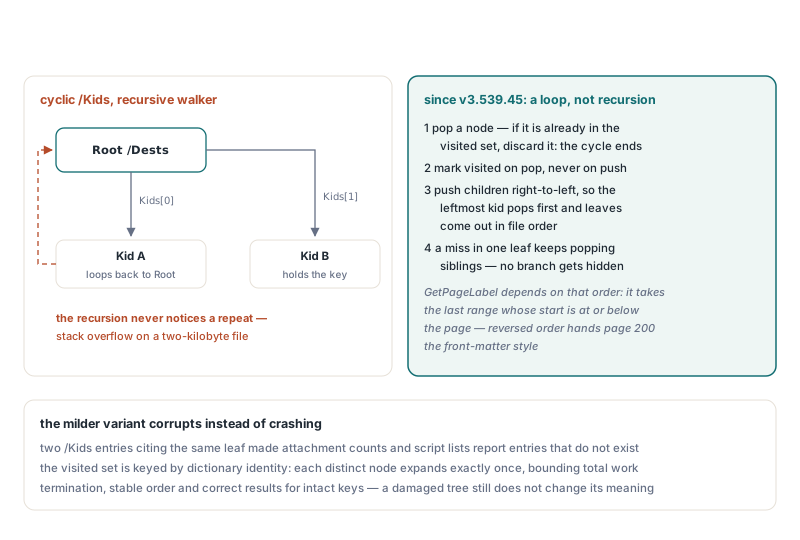
Die Reihenfolge zählt dennoch, und der Stack muss rückwärts gefüttert werden, um sie zu halten. Kinder werden vom letzten Index abwärts bis zum ersten gepusht, das linkeste Kind wird also zuerst gepoppt und die Leaves kommen in derselben links-nach-rechts-Reihenfolge heraus, in der sie der Produzent schrieb. GetPageLabel hängt daran: Es läuft durch jede enumerierte Range und wendet die letzte an, deren Startindex bei oder unter der Seite liegt, die Enumeration umzudrehen würde Seite 200 also stillschweigend den Vorspann-Stil verpassen. Das Skelett unten zeigt das Muster auf einem abstrakten Knotentyp, unabhängig von jedem PDF-Objektmodell
uses
  System.Generics.Collections;

type
  TTreeNode = class
  public
    Kids: TArray<TTreeNode>;   // leer bei einem Blatt
    Keys: TArray<string>;      // Blattschlüssel, sortiert von einem artigen Produzenten
    Values: TArray<Integer>;   // parallel zu Keys
    HasLimits: Boolean;
    LoKey, HiKey: string;
  end;

// /Limits ist ein Hinweis: nur ein wohlgeformtes, geordnetes Paar darf einen Zweig beschneiden
function LimitsExclude(Node: TTreeNode; const Key: string): Boolean;
begin
  Result := Node.HasLimits and (Node.LoKey <= Node.HiKey) and
    ((Key < Node.LoKey) or (Key > Node.HiKey));
end;

function FindValue(Root: TTreeNode; const Key: string;
  out Value: Integer): Boolean;
var
  Pending: TList<TTreeNode>;
  Visited: TDictionary<TTreeNode, Byte>;
  Node: TTreeNode;
  I: Integer;
begin
  Result := False;
  Value := 0;
  if Root = nil then
    Exit;
  Pending := TList<TTreeNode>.Create;
  Visited := TDictionary<TTreeNode, Byte>.Create;
  try
    Pending.Add(Root);
    while Pending.Count > 0 do
    begin
      Node := Pending[Pending.Count - 1];
      Pending.Delete(Pending.Count - 1);
      if Visited.ContainsKey(Node) then
        Continue;                      // Zyklus oder geteiltes Kind: schon gesehen
      Visited.Add(Node, 0);
      if Length(Node.Kids) > 0 then
      begin
        // Von rechts nach links pushen, damit das linkeste Kind zuerst gepoppt wird
        for I := High(Node.Kids) downto 0 do
          if (Node.Kids[I] <> nil) and not LimitsExclude(Node.Kids[I], Key) then
            Pending.Add(Node.Kids[I]);
      end
      else
        for I := 0 to High(Node.Keys) do
          if (Node.Keys[I] = Key) and (I <= High(Node.Values)) then
          begin
            Value := Node.Values[I];
            Exit(True);
          end;
      // Ein Fehlschlag in diesem Blatt ist kein Urteil: Geschwister weiter poppen
    end;
  finally
    Visited.Free;
    Pending.Free;
  end;
end;
Warum darf ein Lookup nicht am ersten passenden Zweig haltmachen?
Ein Lookup darf nicht am ersten Zweig haltmachen, dessen Range passt, denn /Limits-Ranges in einer echten Datei können sich überlappen oder lügen, und der Zweig, der den Schlüssel behauptet, ist nicht notwendigerweise der Zweig, der ihn hält. Die Lookups vor v3.539.45 setzten ein Found-Flag am ersten Kind, dessen /Limits den Schlüssel abdeckten, stiegen in es hinab und sahen nie ein anderes Geschwister an. Erwies sich dieses Kind als leer, veraltet oder als Schleife zurück zur Wurzel, war die Antwort nil, selbst wenn das allernächste Geschwister den Schlüssel hielt
Das umgeschriebene FindTreeValue, das heute sowohl NameTreeLookup als auch NumTreeLookup trägt, pusht jedes Kind, dessen Range den Schlüssel nicht ausschließt, und poppt weiter, bis es einen Treffer findet oder der Stack leer ist. Ein Fehlschlag in einem Blatt ist nur ein Fehlschlag in einem Blatt. In einem wohlgeformten Tree kostet das nichts extra; in einem beschädigten kostet es ein paar weitere Knotenbesuche und liefert die richtige Antwort
Die Blattsuche folgt derselben Philosophie. ISO 32000-1 verlangt, dass die Schlüssel in einem /Names-Array nach Bytewert sortiert sind, das Blatt wird also zuerst binär durchsucht. Scheitert das, fällt PDFlibPas auf einen linearen Scan der Paare zurück, denn ein Blatt in falscher Reihenfolge würde einen vorhandenen Schlüssel sonst unsichtbar machen. Sortierung ist ein schneller Pfad, kein Filter
Der Lookup weigert sich auch, bei einem strukturellen Widerspruch zu raten. Tabelle 36 lässt einen Knoten entweder /Kids oder /Names tragen, nie beides, und der Lookup-Pfad behandelt einen Knoten, der beides trägt, als missgebildet und überspringt ihn, statt sich für eine Interpretation zu entscheiden. Enumerationspfade wie EnumNumTree sind nachsichtiger und folgen /Kids, wenn beide vorhanden sind
Wofür darf ein Leser /Limits vertrauen?
Ein Leser darf /Limits nur vertrauen, um Arbeit zu überspringen, niemals, um zu entscheiden, dass ein Schlüssel fehlt, und auch das nur bei einem wohlgeformten Paar. Tabelle 36 sagt, Zwischen- und Blattknoten sollen /Limits als zweielementiges Array aus dem kleinsten und größten Schlüssel tragen, aber in der Praxis verschwindet der Eintrag nach Hand-Edits, hält Zahlen in einem Name Tree oder kommt mit vertauschten Grenzen. PDFlibPas v3.539.45 und v3.539.51 entscheiden jeden Fall auf dieselbe Weise: Liest sich die Range nicht als geordnetes Paar des richtigen Typs, bleibt das Kind durchsuchbar
- Fehlendes
/Limits: Der alte Range-Check lieferte False, und das Kind wurde kurzerhand übersprungen, ein Produzent, der den Eintrag vergaß, machte also seinen ganzen Subtree unerreichbar. Seit v3.539.45 wird das Kind durchsucht - Falscher Typ oder falsche Länge, etwa Zahlen in einem Name Tree oder ein ein-elementiges Array: seit v3.539.45 exakt wie ein fehlender Eintrag behandelt
- Umgedrehte Grenzen wie
[(Z) (A)]oder[9 0]: v3.539.45 nutzte sie weiterhin, und kein Schlüssel kannLo <= Key <= Hierfüllen, wennLo > Hi, der Zweig wurde also bei jedem Lookup ausgeschlossen. Seit v3.539.51 wird eine Range nur dann zum Beschneiden benutzt, wenn ihre untere Grenze ihre obere nicht übersteigt - Wohlgeformt, geordnet und korrekt: wird zum Überspringen des Zweigs benutzt, was der ganze Sinn des Eintrags ist
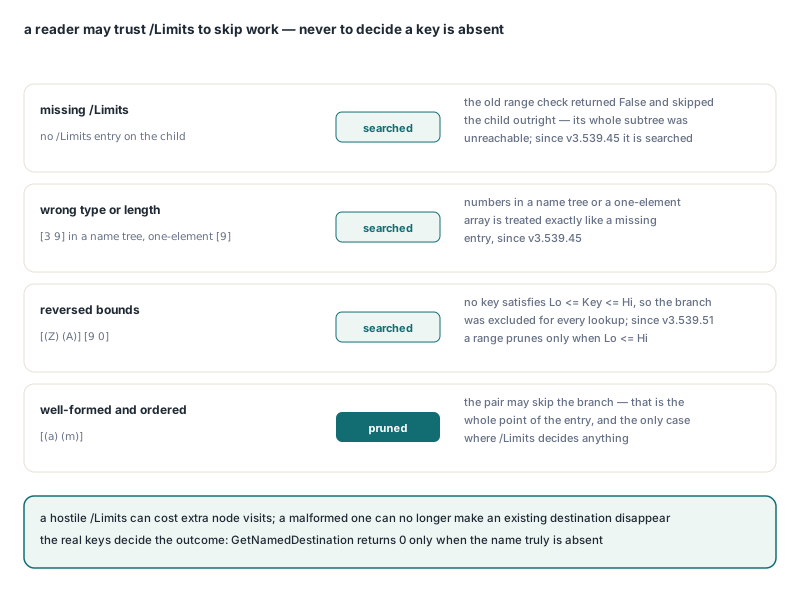
Die echten Schlüssel entscheiden in jedem Fall den Ausgang. Ein feindliches /Limits kann PDFlibPas mehr Knoten besuchen lassen als nötig, aber ein missgebildetes kann eine vorhandene Destination nicht mehr verschwinden lassen. Aus Aufrufersicht ändert sich nichts: GetNamedDestination liefert 0, wenn der Name wirklich fehlt, sonst eine Destination-ID, und die Destination-Funktionen übernehmen von dort
uses
  PDFlibrary;

procedure LookUpDestination(const FileName, DestName: string);
var
  Lib: TPDFlib;
  DestID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
    begin
      WriteLn('Load failed, error ', Lib.LastErrorCode);
      Exit;
    end;
    // Katalog-/Dests (PDF 1.1) zuerst, dann der /Dests-Name-Tree
    DestID := Lib.GetNamedDestination(DestName);
    if DestID = 0 then
      WriteLn('No destination named ', DestName)
    else if Lib.GetDestPage(DestID) = 0 then
      WriteLn(DestName, ' exists but does not resolve to a page')
    else
      WriteLn(DestName, ' -> page ', Lib.GetDestPage(DestID),
        ', view type ', Lib.GetDestType(DestID));  // 1 = XYZ, 2 = Fit ...
  finally
    Lib.Free;
  end;
end;
Angewandt auf eine handgebaute Datei, deren /Dests-Wurzel ein Kind hat, das unter einer [(a) (z)]-Range zur Wurzel zurückschleift, und ein zweites Kind, das den echten Eintrag unter umgedrehten [(z) (a)]-Limits hält, löst diese Prozedur das Destination auf Seite 2 mit View-Typ 2 (Fit) auf. Vor v3.539.45 lieferte dasselbe Lookup 0, denn das schleifende Kind beanspruchte den Schlüssel zuerst, und die Suche erreichte nie sein Geschwister; v3.539.45 allein lieferte weiterhin 0, denn die umgedrehte Range schloss das echte Blatt aus. Wenn Sie danach das Outline lesen, das auf diese Destinations zeigt, behandelt der Begleitartikel zu PDF-Bookmark- und Annotation-Actions in Delphi lesen die Action-Seite
Wie brach ein Blatt mit 32.769 Namen TPDFNameTree?
Ein Blatt mit 32.769 Name-Wert-Paaren brach TPDFNameTree, weil sein internes FindIndex zwei Zahlen in einen einzigen 32-Bit-Integer packte: die Position des Blatts in der internen Array-Liste in den hohen 16 Bits und den Eintrags-Offset innerhalb des /Names-Arrays dieses Blatts in den niedrigen 16 Bits. Jedes Paar belegt zwei Array-Slots, das 32.769ste Paar, Paarindex 32.768, beginnt also bei Offset 65.536, was $10000 ist. Dieser Wert trägt in die hohe Hälfte über, und der Dekoder las ihn als Offset 0 im nächsten Blatt zurück
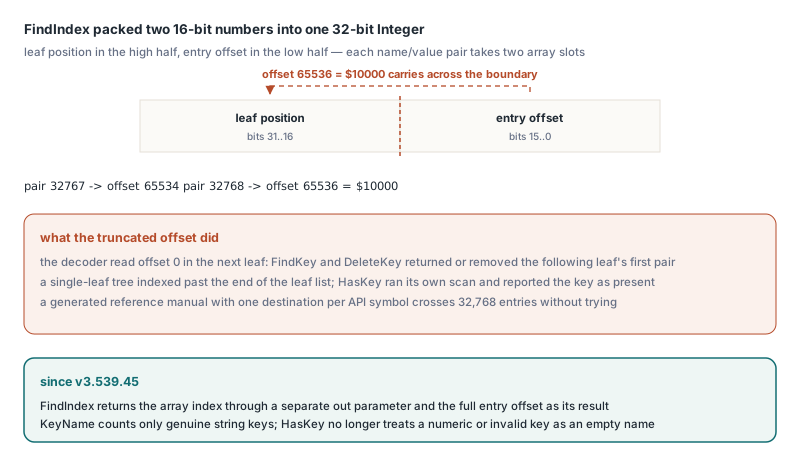
TPDFNameTree ist die Klasse hinter Attachments, globalen JavaScript-Paketen und Named-Destination-Schreibvorgängen, was die Folgen konkret macht. In einem Einblatt-Tree gibt es kein nächstes Blatt, FindKey und DeleteKey indizierten also hinter das Ende der Blattliste; in einem Mehrblatt-Tree lieferten oder löschten sie das erste Paar des folgenden Blatts statt des angefragten. Währenddessen fuhr HasKey seinen eigenen Scan und meldete den Schlüssel als vorhanden, die Klasse widersprach sich also selbst. Ein generiertes Referenzhandbuch mit einem Named Destination pro API-Symbol überschreitet 32.768 Einträge ohne sich anzustrengen, und manche Produzenten schreiben alle in ein einziges flaches Blatt
Seit v3.539.45 liefert FindIndex den Array-Index über einen separaten out-Parameter und den vollen Eintrags-Offset als Ergebnis, keiner der beiden Werte wird also abgeschnitten. Dasselbe Release zog zwei Nachbarn an. KeyName zählt und liefert jetzt nur echte String-Schlüssel und gibt für einen Index von 0 oder darunter einen leeren String zurück, wo es vorher jedes Objekt castete, das einem ungültigen Schlüssel folgte. HasKey behandelt einen numerischen oder anderswie ungültigen Schlüssel nicht mehr als leeren Namen. Für ein Blatt wie [(Valid) 42 123 456] ist HasKey('') jetzt False, und KeyName(2) liefert einen leeren String
procedure AuditTrees(const FileName: string);
var
  Lib: TPDFlib;
  I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(FileName, '') <> 1 then
      Exit;
    // /PageLabels-Number-Tree; Dateien ohne einen liefern schlichte Seitennummern
    for I := 1 to Lib.PageCount do
      WriteLn('Page ', I, ' label: ', Lib.GetPageLabel(I));
    // /EmbeddedFiles-Name-Tree; Indizes sind 1-basiert, Nicht-String-Schlüssel übersprungen
    for I := 1 to Lib.EmbeddedFileCount do
      WriteLn('Attachment ', I, ': ', Lib.GetEmbeddedFileStrProperty(I, 1),
        ' (', Lib.GetEmbeddedFileStrProperty(I, 2), ')');  // Name, MIME-Typ
    // /JavaScript-Name-Tree: Paketnamen auflisten, nichts ausführen
    for I := 1 to Lib.GlobalJavaScriptCount do
      WriteLn('Script package: ', Lib.GlobalJavaScriptPackageName(I));
  finally
    Lib.Free;
  end;
end;
Auf derselben handgebauten Datei, deren /PageLabels-Wurzel ein Blatt zweimal auflistet und sich selbst referenziert, druckt dieser Audit i und A-1 für die zwei Seiten, jede Range einmal, und das einzige Skriptpaket aus einem /JavaScript-Tree, der ebenfalls auf seine eigene Wurzel zeigt. Die Schreibseite der Page Labels hat eine eigene Vorgeschichte mit /Kids-Wurzeln, behandelt in PDF-Seitenlabels aus /Kids-Number-Trees reparieren; AddPageLabels plattet so eine Wurzel vor dem Einfügen flach und verlässt sich auf dieselbe EnumNumTree-Enumeration, die hier beschrieben wird
Was garantiert diese Härtung weiterhin nicht?
Die Härtung garantiert Terminierung, stabile Reihenfolge und korrekte Ergebnisse für Trees, deren echte Schlüssel intakt sind; sie macht einen beschädigten Tree nicht zu dem, was sein Autor beabsichtigte. Einige Grenzen sollten Sie kennen, bevor Sie darauf bauen
- Das Visited-Set arbeitet über Objektidentität. Zwei unterschiedliche Dictionaries mit identischem Inhalt sind zwei Knoten, ein Produzent, der ein Blatt kopiert statt es zu referenzieren, liefert also weiterhin doppelte Einträge
- Ein wohlgeformtes, geordnetes, aber falsches
/Limitsbeschneidet weiterhin. Ein Leser, der Ranges als Optimierung nutzt, kann nicht zugleich immun gegen eine plausibel lügende Range sein; die einzige Alternative ist,/Limitskomplett zu ignorieren und jedes Blatt zu scannen - Die Enumeration bewahrt die Dateireihenfolge, sortiert aber nicht.
GetPageLabelwendet die letzte enumerierte Range bei oder unter der Seite an, ein Produzent, der Rängen in falscher Reihenfolge schreibt, bekommt also Semantik in Dateireihenfolge - Speicher wächst mit der Anzahl unterschiedlicher Knoten und Einträge. Der Durchlauf fügt eine Liste und ein Hash-Set hinzu, nicht mehr, aber ein 100-MB-Name-Tree bleibt auch nach dem Parsen ein 100-MB-Name-Tree
- Doppelte Schlüssel innerhalb eines Blatts werden nicht gemeldet. Die binäre Suche liefert das erste passende Paar, auf das sie trifft; der lineare Fallback behält den letzten Treffer, den er scannt
Kurzreferenz: PDF-Trees aus nicht vertrauenswürdigen Dateien lesen
- Auf v3.539.45 oder später aktualisieren für zyklus- und stacksicheren Durchlauf von Name Trees und Number Trees, und auf v3.539.51 oder später, damit umgedrehte
/Limitskeine Schlüssel mehr verstecken GetNamedDestinationmit Rückgabe 0 als „abwesend“ behandeln undGetDestPagemit 0 als „vorhanden, aber unbrauchbar“GlobalJavaScriptCountundGlobalJavaScriptPackageNamefür den/JavaScript-Name-Tree nutzen;GetDocJavaScriptliest stattdessen Katalog-/AA-Trigger- Attachments und Skriptpakete von 1 bis zur von der Bibliothek gemeldeten Anzahl indizieren; ungültige Schlüssel werden nicht gezählt
- In Ihrem eigenen Tree-Code Knoten beim Pop als besucht markieren, Kinder umgekehrt pushen und
/Limitsnur dann beschneiden lassen, wenn es ein korrekt typisiertes, geordnetes Paar ist
Pre-Flight-Tools, Archivierer und Viewer lesen diese Trees, bevor irgendeine Seite gerendert wird, sie müssen also überleben, was auch immer in einer Upload-Warteschlange ankommt. Die oben beschriebenen Tree-Leser kommen mit PDFlibPas, der PDF Library for Delphi, die mit Delphi und Free Pascal baut