Eine Windows-Testmaschine auf deutsche Regionaleinstellungen umstellen, eine Routine laufen lassen, die einer Seite eine Skalier-und-Verschiebe-Matrix voranstellt, und den Content-Stream ausgeben lassen. Statt 0.5 0 0 0.25 0.00001 12.75 cm bekommt man 0,5 0 0 0,25 1E-5 12,75 cm. Ein Content-Parser liest das als die Zahl 0, dann ein Token ,5, das er nicht kennt, dann weitere Zahlen, die nicht mehr zu den sechs Operanden passen, die cm erwartet, und die Seite zeichnet mit einer Transformation, die nie jemand angefordert hat. Zahlen, die eine Maschine parst, brauchen einen festen Punkt, keinen Exponenten und keinerlei Abhängigkeit von FormatSettings, auf der Schreibseite wie auf der Leseseite
Warum bricht ein Komma-Dezimal-Locale PDF-Zahlen?
Ein Komma-Dezimal-Locale bricht PDF-Zahlen, weil Delphis Default-Float-Formatierung dem Desktop folgt, während die PDF-Zahlensyntax festgelegt ist. FloatToStr benutzt FormatSettings.DecimalSeparator, auf einer de-DE-, fr-FR- oder pt-BR-Maschine kommt also jeder Bruchteil mit Komma heraus. ISO 32000-1 §7.3.3 erlaubt in einer Zahl Ziffern, einen Punkt und ein führendes Vorzeichen. Nichts sonst. Das Komma spaltet daher eine Zahl in einen gültigen Integer plus Müll auf, und das Ergebnis ist eine Seite, die rendert — nur eben falsch
Hinter dem ersten lauert eine zweite Falle, und die beißt auch auf US-Maschinen. FloatToStr benutzt das Format ffGeneral, das ab einer Größenordnung unter 1E-4 auf Exponentialschreibweise umschaltet, ein winziger Offset wird also als 1E-5 geschrieben. Dasselbe §7.3.3 stellt fest, dass PDF die Exponentialform nicht unterstützt. Eines der beiden Probleme aus dem gerenderten Output rückwärts zu verfolgen ist elend, denn eine weggedriftete Matrix sieht exakt wie ein Layout-Bug im eigenen Code aus, und nichts auf der Seite zeigt auf die Regionaleinstellungen
PDFlibPas, die losLab PDF Developer Library für Delphi, schreibt die Operanden von AddPageMatrix durch PLDoubleToStrConst mit sechs Dezimalstellen, und die Aufrufstellen, die seitene Inhalte im eigenen Auftrag erzeugen, folgen derselben Regel. Der billigste Regressionstest, den wir kennen, dreht den Trenner im Prozess auf Komma, ruft die API auf und scannt das Ergebnis nach Kommas und Exponenten:
uses
  System.SysUtils, PDFlibrary;

// Eigene Prüfung, nicht Teil der Bibliothek. Sie ist absichtlich primitiv:
// Textstrings wie (Hello, world) Tj enthalten ebenfalls Kommas, also fährt man sie
// auf einer Testseite, die nur Formen zeichnet
function HasLocaleDamage(const Content: AnsiString): Boolean;
var
  I: Integer;
begin
  Result := False;
  for I := 1 to Length(Content) do
  begin
    if Content[I] = ',' then
      Exit(True);
    if (Content[I] in ['E', 'e']) and (I > 1) and (I < Length(Content)) and
       (Content[I - 1] in ['0'..'9']) and (Content[I + 1] in ['0'..'9', '-', '+']) then
      Exit(True);
  end;
end;

var
  Lib: TPDFlib;
  OldSeparator: Char;
  Content: AnsiString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.SetPageDimensions(300, 200);
    Lib.DrawBox(10, 10, 20, 20, 1);
    OldSeparator := FormatSettings.DecimalSeparator;
    try
      FormatSettings.DecimalSeparator := ',';   // sich wie ein de-DE-Desktop verhalten
      Lib.AddPageMatrix(0.5, 0.25, 1E-5, 12.75);
      Content := Lib.GetPageContentToString;
      // Erwartet: 0.5 0 0 0.25 0.00001 12.75 cm
      // FloatToStr hätte geliefert: 0,5 0 0 0,25 1E-5 12,75 cm
      Writeln(Content);
      if HasLocaleDamage(Content) then
        Writeln('Locale leaked into the content stream');
    finally
      FormatSettings.DecimalSeparator := OldSeparator;
    end;
  finally
    Lib.Free;
  end;
end;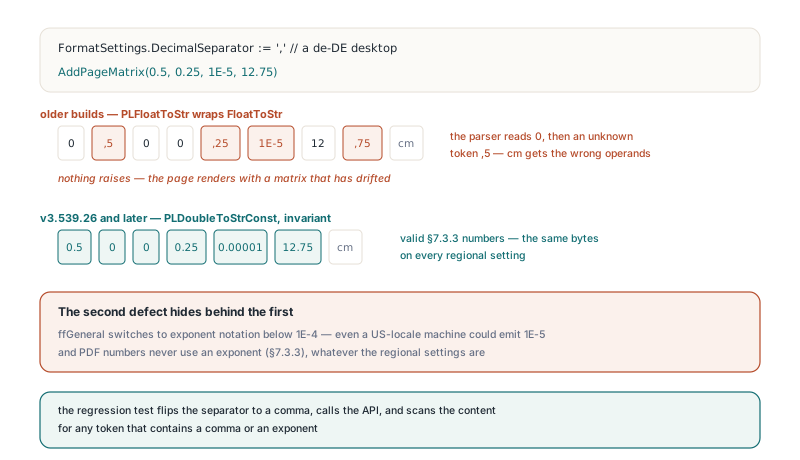
FormatSettings.DecimalSeparator im Prozess umzustellen ist ein Abkürzung. Sie übt keinen Code aus, der sein eigenes TFormatSettings vom Betriebssystem baut; macht Ihre Anwendung das, ist ein CI-Agent mit echten deutschen Regionaleinstellungen der ehrlichere Test
Zwei Sorten Zahlen, zwei Familien von Helfern
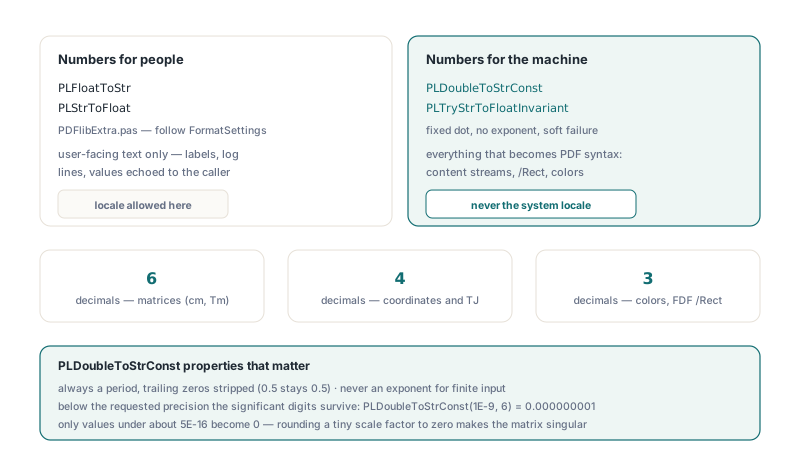
PDFlibPas spaltet seine Zahlenhelfer nach Publikum: Text für Menschen darf dem Locale folgen, und alles, was für eine Maschine geschrieben wird, tut es nie. PLFloatToStr und PLStrToFloat in PDFlibExtra.pas sind dünne Wrapper um FloatToStr und StrToFloat, und der Kommentar an ihrer Deklaration sagt, dass sie nur für menschenlesbaren Text sind. Maschinenausgabe (PDF, FDF, XFDF, JSON, XML, CSV) läuft stattdessen durch die invariante Familie: PLDoubleToStrConst zum Schreiben, PLTryStrToFloatInvariant zum Lesen und PLInvariantFormatSettings, wenn man für eigene TryStrToFloat-Aufrufe einen TFormatSettings-Record mit Punkt-Dezimal braucht
Die Präzision wird pro Job gewählt statt global. Matrizen bekommen sechs Dezimalstellen, Koordinaten und TJ-Adjustierungen vier, Farben und FDF-Rechtecke drei. Die maschinenseitige Seite deckt mehr Stellen ab, als die API-Oberfläche vermuten lässt:
AddPageMatrix,ScalePageundDeskewPage, die alle eincmvor den bestehenden Seitencontent setzen- Die
Tm-Resets,TJ-Advances undcm-Transformationen, die beim Erzeugen von Seitenelementen geschrieben werden - Glyphenplatzierungsmatrizen und Outline-Punkte, die entstehen, wenn Text in Pfade konvertiert wird
- Die schwarze Füllbox, die
RedactRegionvoranstellt, die/Rect-Werte im FDF-Export und die Farboperanden, die die Umfärbung schreibt
PLDoubleToStrConst ist ein handgestrickter Formatter, und wir halten das für die richtige Entscheidung gegenüber einem Wrapper um FloatToStrF mit festem TFormatSettings. ffFixed fällt weiterhin auf wissenschaftliche Notation zurück, sobald der Integer-Teil die Präzision übersteigt, und es würde 0.500000 stehen lassen, wo 0.5 kürzer und identisch ist. Die eigene Routine schreibt immer einen Punkt, stript nachlaufende Nullen und schreibt für endliche Eingaben nie einen Exponenten. Sie behält auch die signifikanten Stellen eines Nicht-Null-Werts, der kleiner ist als die angeforderte Präzision: PLDoubleToStrConst(1E-9, 6) liefert 0.000000001, erst Werte unter etwa 5E-16 werden zu 0. Einen winzigen Skalierungsfaktor auf null zu runden würde aus einer gültigen Matrix eine singuläre machen, was ein schlimmerer Fehlschlag ist als jeder verrutschte Dezimalpunkt
Wer Unit-Tests gegen den Formatter schreibt, wählt seine Beispielwerte mit binärer Gleitkommazahl im Hinterkopf. Die naheliegende Wahl für „vier signifikante Stellen“ ist 0.000012345, aber mit 1E8 multipliziert ist dieser Double 1234.4999…, das Ergebnis ist also 0.00001234, und die Behauptung scheitert aus einem Grund, der mit Locales nichts zu tun hat. Ein Wert, der deutlich neben der Mitte liegt, etwa 0.000012346, vermeidet die Diskussion komplett:
uses
  PDFlibExtra;

// Assert-Aufrufe sind Prüfungen, die man im eigenen Testprojekt ergänzt
procedure CheckNumberHelpers;
var
  V: Double;
begin
  // Maschinenausgabe: Punkt-Dezimal, kein Exponent, nachlaufende Nullen gestript
  Assert(PLDoubleToStrConst(1E-5, 6) = '0.00001');
  Assert(PLDoubleToStrConst(-0.5, 6) = '-0.5');
  Assert(PLDoubleToStrConst(0.000012346, 4) = '0.00001235');  // 4 signifikante Stellen behalten
  Assert(PLDoubleToStrConst(12345.25, 4) = '12345.25');

  // Maschineneingabe: False statt EConvertError
  Assert(PLTryStrToFloatInvariant('0.5', V) and (V = 0.5));
  Assert(PLTryStrToFloatInvariant('  12.75 ', V) and (V = 12.75)); // die Eingabe wird getrimmt
  Assert(not PLTryStrToFloatInvariant('0,5', V));   // Content-Zahlen benutzen nie ein Komma
end;
Warum ist die Parseseite gefährlicher als die Schreibseite?
Die Parseseite ist gefährlicher, weil ein am Locale hängender Parser keine leicht falsche Zahl produziert, sondern wirft. StrToFloat löst EConvertError aus, wann immer der Text nicht zum Systemtrenner passt. Ein Umfärbe-Durchlauf auf dieser Basis bräche in dem Moment ab, in dem er auf einen ganz gewöhnlichen 0.5 g-Operator auf einer Komma-Dezimal-Maschine stößt, das heißt, er scheitert an praktisch jeder realen Seite. Ein Clip-String wie "10.5,20.5,50.5,40.5" würde rundheraus zurückgewiesen, und SVG-Längen, SVG-Farben, Annotations-Vertexlisten und Output-Intent-Werte würden entweder verweigert oder lautlos durch Defaults ersetzt. Das ist Code, der auf der Entwicklermaschine jeden Test besteht und am ersten Kunden in München scheitert, dieselbe Problemfamilie wie die Fälle in dem Artikel über Delphi-Code, der nur zufällig funktioniert
Jeder StrToFloat-artige Aufruf in der Bibliothek ist danach sortiert, woher seine Eingabe kommt. Content-Stream-Operanden, SVG-Attribute, Painter-Farbstrings und kommagetrennte Clip- und Vertexlisten haben alle eine feste Punkt-Syntax, sie laufen also durch PLTryStrToFloatInvariant. Dieser Helfer trimmt den Text, parst ihn mit PLInvariantFormatSettings und liefert False (mit dem Wert auf 0 gesetzt) für leere, missratene, NaN- oder unendliche Eingaben. Komma-getrennte Listen brauchten keine Debatte: Ein Komma kann nicht gleichzeitig Listendelimiter und Dezimalzeichen sein, es gibt also keine Legacy-Form, kompatibel zu bleiben
Für die in der Anleitung zum Konvertieren einer PDF in einen Farbraum beschriebene Umfärbe-Pipeline ist das Ergebnis, dass RecolorPage und RecolorDocument den Seiteninhalt auf jedem Locale identisch parsen. Regelwerte, die ein Aufrufer in CheckDocumentPolicy eintippt, sind der eine Parse-Fall, der den nachsichtigen Weg nimmt, denn eine Person hat diesen String getippt und hat sehr wohl das lokale Dezimalzeichen benutzt
Eine über einen String weitergereichte Zahl braucht an beiden Enden dieselbe Konvention
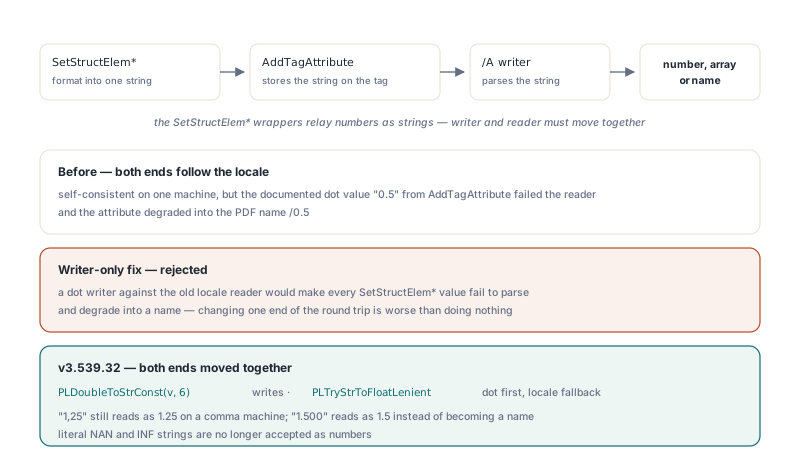
Wird eine Zahl von einem Teil des Codes in einen String geschrieben und von einem anderen zurückgeparst, müssen Writer und Reader derselben Konvention folgen, und nur eines von beiden zu ändern bricht den Roundtrip. Tagged-PDF-Strukturattribute funktionieren genau so. SetStructElemBBox formatiert vier Werte in einen String und speichert ihn über AddTagAttribute. Wird das /A-Attributwörterbuch geschrieben, wird dieser String erneut geparst, um zu entscheiden, ob er zu einer Zahl, einem Array oder einem Namen wird
Folgten beide Enden dem System-Locale, wäre der Trip auf einer deutschen Maschine in sich konsistent. Der Ärger beginnt mit einem Aufrufer, der der Dokumentation folgt und "0.5" an AddTagAttribute übergibt: Ein am Locale hängender Reader kann es nicht parsen und emittiert den PDF-Namen /0.5. PDF/VCR-Platzhalter treffen das Spiegelbild, denn ihr GTS_BBox wird mit Punkt erzeugt, und ein am Locale hängender Validierungsschritt vor dem Speichern würde es zurückweisen. Und nur den Writer auf Punkt umzustellen macht es schlimmer, denn jeder SetStructElem*-Wert würde dann auf Komma-Dezimal-Systemen zu einem Namen
Die Writer benutzen also PLDoubleToStrConst(v, 6), und der Reader PLTryStrToFloatLenient, der zuerst die Punktform versucht und dann aufs System-Locale zurückfällt. Ein Komma-Locale-Aufrufer, der "1,25" übergibt, bekommt die Zahl 1.25. Es gibt einen Preis, und wir haben ihn bewusst akzeptiert: Auf einem deutschen System wird "1.500" als 1.5 gelesen statt als eintausendfünfhundert, denn die Punktform gewinnt. Die API dokumentiert den Punkt als Trenner, eine deutsche Tausendergruppe in einem Attributstring ist also die Eingabe, auf die wir verzichtet haben. Die Literal-Strings NAN und INF werden nicht als Zahlen behandelt
uses
  System.SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
begin
  FormatSettings.DecimalSeparator := ',';   // Komma-Dezimal-Aufrufer
  Lib := TPDFlib.Create;
  try
    Lib.BeginTag('Figure', 'Sales chart', '');
    Lib.SetStructElemBBox(10.5, 20.25, 200.5, 100.75); // /BBox [ 10.5 20.25 200.5 100.75 ]
    Lib.AddTagAttribute('Layout', 'SpaceAfter', '0.5');   // /SpaceAfter 0.5 statt /0.5
    Lib.AddTagAttribute('Layout', 'StartIndent', '1,25'); // /StartIndent 1.25 über den Locale-Fallback
    Lib.DrawText(20, 20, 'figure');
    Lib.EndTag;
    Lib.SaveToFile('tagged.pdf');
  finally
    Lib.Free;
  end;
end;
Unsere Empfehlung für den eigenen Code: AddTagAttribute Punkt-Dezimal-Strings übergeben und den Komma-Fallback für Werte behalten, die man nicht kontrolliert, etwa Strings aus einer älteren Konfigurationsdatei. Wie der Strukturbaum um diese Attribute herum gebaut wird, behandelt die Anleitung zu getaggten PDF-Strukturen
Wo NaN und Unendlich gestoppt werden
AddPageMatrix, ScalePage und RedactRegion weisen NaN und unendliche Argumente vorne ab und geben 0 zurück, denn keine PDF-Zahl kann beides darstellen. Die Prüfung muss explizit sein. NaN gleitet an einem <= 0-Test vorbei, eine Bereichsprüfung über einen Skalierungsfaktor allein würde also einen NaN-Faktor bis zum Formatter durchreisen lassen, und Round auf NaN aufzurufen wirft unter Win32 ein EInvalidOp, weil die x87-Einheit ungültige Operationen nicht standardmäßig maskiert. PLDoubleToStrConst schreibt für NaN als letzte Verteidigungslinie eine 0, aber eine Null in einer Matrix ist eine singuläre Transformation, die API-Prüfung ist also die, die die Seite tatsächlich schützt. Im eigenen Code prüft man den Rückgabewert: Liefert ScalePage 0 für einen berechneten Faktor, gibt man den Faktor aus, bevor man irgendetwas anderes tut, denn ein 0/0 irgendwo vorgelagert erzeugt exakt dieses NaN
Zwei Grenzen sind bewusst so gesetzt. Metafile-State-Strings werden innerhalb eines einzelnen Prozesses mit dem Locale geschrieben und gelesen und erreichen nie eine Datei, sie bleiben also am Locale. Und wer kleine Werte durch den Seitenerzeugungspfad testet, liest den Content direkt nach dem Aufruf: Eine Operation, die den Seiteninhalt später in der Koordinatenpräzision des Dokuments erneut emittiert, verwandelt 1E-5 legitim in 0, und das ist Runden, kein Locale-Leck
Die Gewohnheit, die sich lohnt, ist kurz. Die PDF-erzeugenden Pfade der eigenen Anwendung einmal mit Komma-Trenner fahren, die Ausgabe nach Kommas und Exponenten absuchen und FloatToStr aus allem heraushalten, was ein Parser lesen wird. Zahlen, die aus einer bestehenden Datei gelesen werden, folgen einer verwandten Regel, behandelt im Artikel zum Bewahren geparster Dezimalpräzision, wo der exakte Quelltext ein Speichern überlebt. Trial-Builds, die API-Referenz und Lizenzdetails stehen auf der PDFlibPas Delphi PDF library Produktseite