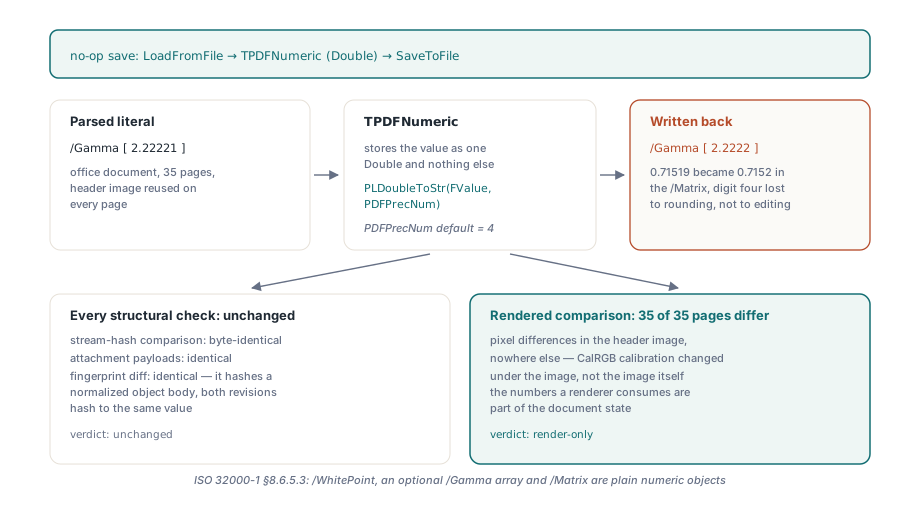
Ein kalibriertes PDF laden, nichts ändern, unter neuem Namen speichern und das Color-Space-Dictionary diffen: /Gamma [2.22221 2.22221 2.22221] ging hinein, /Gamma [2.2222 2.2222 2.2222] kam heraus. Der Writer hat eine Zahl umformatiert, die er nie anfassen musste, und die Seite rendert jetzt in leicht anderen Farben. Die Kur: jede geparste Dezimalzahl als zwei Dinge zugleich behandeln, als Wert für die Arithmetik und als Literal für die Ausgabe, und das Literal weiter ausgeben, bis jemand tatsächlich einen neuen Wert zuweist
Warum ein No-op-Save CalRGB-Farben verschieben kann
Die Pixel wandern, weil der Renderer leicht andere Kalibrierungsdaten bekommt, während die Bild-Bytes identisch bleiben. ISO 32000-1 §8.6.5.3 definiert einen CalRGB-Farbraum über ein Pflicht-/WhitePoint, ein optionales drei-elementiges /Gamma-Array und eine optionale neun-elementige /Matrix, und alle sind schlicht numerische Objekte im Color-Space-Dictionary. Schickt man sie durch einen Double und einen auf vier Dezimalstellen festgenagelten Formatter, wird aus 2.22221 ein 2.2222, und aus einem Matrix-Eintrag 0.71519 wird 0.7152. Ein Gamma-Wert ist ein Exponent, der über jede Komponente jedes Pixels gelegt wird, das durch diesen Raum läuft, daher zeigt die Änderung überall, wo der Raum benutzt wird
Deklariert eine Datei einen CalRGB-Raum für ein Kopfbild, das auf 35 Seiten wiederkehrt, rendern alle 35 Köpfe mit verschobenen Farben, und sonst ändert sich auf diesen Seiten nichts. Die Kontrollen, zu denen man zuerst greift, kommen sauber zurück. Ein Hash über dekodierte Stream-Bytes vergleicht Bilddaten, und die Bilddaten sind wirklich identisch; der Schaden sitzt in einem Dictionary. Der Revisions-Diff aus dem Artikel zur Modification Level bildet den Fingerabdruck eines normalisierten Objekt-Body, daher hashen die zwei Revisionen auch dort auf denselben Wert. Ein gerenderter Seitenvergleich ist es, der das erwischt. Für jede Pipeline, die PDFs anderer Software umschreibt, würden wir einen Seiten-für-Seiten-Rendervergleich vor jede strukturelle Prüfung setzen
Wie eine PDF-Realzahl überhaupt aussehen darf
ISO 32000-1 §7.3.3 definiert eine Realzahl als Dezimalstring: ein optionales Vorzeichen, Ziffern, ein Punkt, weitere Ziffern. Keine Radix-Notation, keine Exponentenform. Anhang C, die Implementierungsgrenzen auflistet, erwartet, dass grob fünf signifikante Dezimalstellen im Bruchteil eingehalten werden. Eine Default-Ausgabepräzision von vier sitzt damit schon eine Stelle unter dem, was die Specification den Readern aufträgt zu behalten, und die Datei hat nichts falsch gemacht, indem sie fünf benutzt
Nahe null macht ein naiver Formatter mehr als eine Stelle kaputt. Der übliche Weg, einen Double auf N Stellen zu drucken, ist mit 10^N multiplizieren, auf einen Integer runden und die Ziffern ausschreiben, und wenn dieser Integer null ist, ist die Ausgabe 0. Gibt man ihm den ersten Operanden von 0.00001 0 0 1 0 0 cm auf vier Stellen, ist das Ergebnis 0 0 0 1 0 0 cm, eine singuläre Matrix, unter der alles verschwindet, was gezeichnet wird. Ein /Matrix-Eintrag von -0.000012345 geht genauso unter
Wenn die PDF Library for Delphi (PDFlibPas) einen Double selbst formatieren muss, hält sie für einen Nicht-null-Wert unterhalb der Präzisionsschrittweite die angeforderte Zahl signifikanter Stellen, statt 0 zu schreiben. Auf vier Stellen wird 0.00001 als 0.00001 geschrieben und 0.0000123 als 0.0000123; erst Größenordnungen unter grob 5E-16 kommen als 0 heraus. Neu geschriebene Zahlen bleiben damit gesund. Eine geparste Zahl, die nie neu formatiert werden musste, ist etwas anderes, und die Bibliothek kümmert sich darum, indem sie sie gar nicht umformatiert
Wie PDFlibPas das geparste Literal behält
TPDFStructure.Decode behält den Quelltext jeder Standard-Real, die er tokenisiert, also eines Tokens mit Dezimalpunkt und ohne Exponentenmarker, direkt neben dem konvertierten Double. TPDFNumeric.Output schreibt diesen Text zurück, wann immer er da ist, und formatiert den Double erst dann nach der PDFPrecNum der Structure, wenn er fehlt. TPDFNumeric.SetTo verwirft den Text, denn eine bearbeitete Zahl ist eine neue Zahl und soll der aktuellen Ausgabepräzision folgen
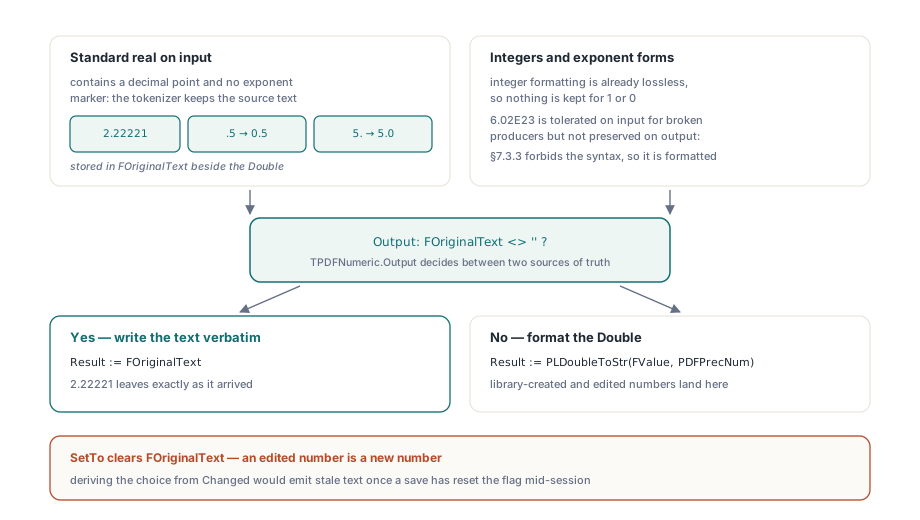
Das Zurücksetzen an SetTo zu koppeln, war eine bewusste Entscheidung. Der verlockende Abkürzungsweg ist, den Originaltext auszugeben, solange das Changed-Flag des Objekts nicht gesetzt ist, denn das Flag existiert ohnehin an jedem Objekt. Nur löscht die Save-Pipeline Changed, sobald ein Objekt geschrieben wurde, also würde ein Wert, der in derselben Sitzung bearbeitet, gespeichert und noch einmal bearbeitet wird, beim zweiten Save wieder sein veraltetes Literal ausgeben. Den Text innerhalb der Zuweisung selbst zu löschen heißt: Literal und Wert können nie auseinanderlaufen
Ein paar Grenzen sind absichtlich so. Integers werden nicht als Text gehalten, weil Integer-Formatierung ohnehin verlustfrei ist. Exponentenformen wie 6.02E23 werden bei der Eingabe akzeptiert, Rücksicht auf Produzenten, die sie trotzdem schreiben, aber bei der Ausgabe wie jede bibliothekseigene Zahl formatiert, denn sie zurückzukopieren würde eine Syntax verewigen, die §7.3.3 ausschließt. Der Tokenizer wendet außerdem seine übliche kleine Reparatur an, bevor er den Text speichert: Ein Literal mit führendem Punkt wie .5 wird als 0.5 gehalten, eines mit Punkt am Ende wie 5. als 5.0. Jeder Reader behandelt jedes Paar als dieselbe Zahl, und die reparierte Schreibung wird weit breiter akzeptiert
Das Snippet unten schickt die CalRGB-Werte direkt durch die Objektschicht, sodass sich jede Regel sehen lässt, ohne eine PDF-Datei zu öffnen. Die Assert-Zeilen sind Kontrollen, die wir für Ihre eigenen Tests vorschlagen; es sind keine Aufrufe in die Bibliothek
uses
  PDFlibStruct;

var
  Structure: TPDFStructure;
  Values: TPDFArray;
  Number: TPDFNumeric;
begin
  Structure := TPDFStructure.Create;
  try
    Structure.PDFPrecNum := 4;
    Values := TPDFArray(Structure.Decode('[2.22221 0.71519 -0.000012345 1 0.12567]'));

    // Eigene Kontrolle: unangetastete Eingabe überlebt wortwörtlich, auch der
    // Wert, den ein naiver Vier-Stellen-Formatter auf 0 kollabieren ließe
    Assert(Values.Output = '[ 2.22221 0.71519 -0.000012345 1 0.12567 ]');

    // Eine Bearbeitung verwirft den Originaltext und folgt PDFPrecNum
    Number := TPDFNumeric(Values.Item[0]);
    Number.SetTo(0.123456);
    Assert(Number.Output = '0.1235');
    Assert(Structure.NewNumeric(0.123456).Output = '0.1235');

    // Winzige neue Werte behalten signifikante Stellen, statt zu 0 zu werden
    Assert(Structure.NewNumeric(0.0000123).Output = '0.0000123');

    // Spätes Senken der Präzision erreicht unangetastete Eingabe nicht
    Structure.PDFPrecNum := 2;
    Assert(TPDFNumeric(Values.Item[1]).Output = '0.71519');
  finally
    Structure.Free;
  end;
end;
Eine Falle bei Assertions dieser Art: Delphis Round rundet nach der Banker's-Rounding-Regel, und 0.000012345 * 1e8 ergibt binär 1234.4999… statt 1234.5. Wir sind beim Prüfen des Near-zero-Formats genau über diesen Wert gestolpert. Wählen Sie Testeingaben, die keine binären Mittelpunkte sind, wann immer eine Assertion davon abhängt, wie die letzte Stelle rundet
Was steuert SetPrecision?
TPDFlib.SetPrecision setzt die Dezimalstellen der Zahlen, die die Bibliothek schreibt: Grafiken durch den Painter, Zahlen aus einem Double erzeugt, etwa über NewNumeric, und geparste Werte, die inzwischen per SetTo geändert wurden. Sie nimmt 2 bis 8 und liefert für alles außerhalb 0. Eine geparste Dezimalzahl, die niemand anfasste, behält ihren Eingabetext, egal wie die Einstellung steht, und die Einstellung nach LoadFromFile zu ändern greift nicht zurück in sie. Quelle, die an SetObjectFromString geht, läuft durch denselben Tokenizer und wird genauso gehalten
Unsere Empfehlung: SetPrecision in Ruhe lassen, außer die Geometrie, die Sie erzeugen, braucht feinere Schritte. Sie zu erhöhen, um Eingabedateien zu schützen, bringt nichts, denn unangetastete Eingabe behält bereits ihre eigenen Stellen, und es macht jede gezeichnete Zahl länger. Fünf Stellen sind eine sinnvolle Wahl für Zeichenarbeit unterhalb des Punkt-Rasters; acht bläht vor allem Content Streams auf
uses
  PDFlibrary;

var
  PDF: TPDFlib;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;

    // Regelt Zahlen ab hier; die geparsten /Gamma-,
    // /Matrix- und /WhitePoint-Arrays behalten ihren Originaltext
    PDF.SetPrecision(5);

    PDF.SelectPage(1);
    PDF.SetLineWidth(0.123456);       // gezeichnete Zahlen nutzen fünf Stellen
    PDF.DrawLine(72, 72, 300, 72);

    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Content Streams: Bearbeitungen behalten Operanden, Normalisierung ist Opt-in
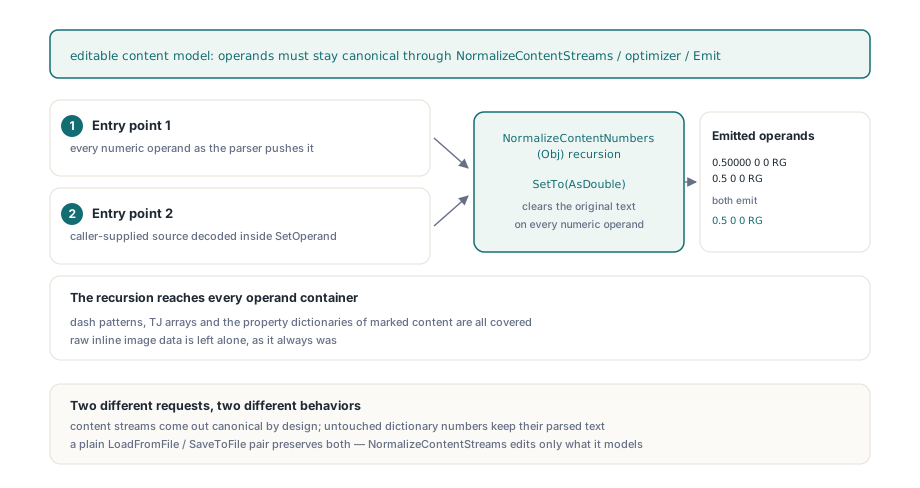
Das editierbare Content-Modell behält Operandentext per Default und kanonisiert Zahlen nur dann, wenn kanonische Ausgabe der Sinn des Aufrufs ist. TPDFContentProgram.CanonicalNumbers steht auf dem Default False, daher gibt eine Layer aus ParsePageContentLayer, dasselbe Modell, auf dem der Graphics-State-Tracker aufbaut, jeden unberührten numerischen Operanden exakt so wieder aus, wie er geschrieben war. Seiten-Bearbeitungen, die eine ganze Layer neu schreiben, inklusive ScalePage, TransformPageElement, DeletePageElement, RedactRegion, ConvertTextToPaths und Ihres eigenen, per WritePageContentLayer zurückgeschriebenen Programms, ändern nur die Operanden, die die Bearbeitung anfasst
Das andere Default sähe aufgeräumter aus: bei jedem Parse kanonisieren, sodass der Bearbeitungsweg und NormalizeContentStreams immer dieselbe Schreibung produzieren. Wir halten es für das falsche Default beim Editieren. Ein ScalePage-Aufruf auf einer Layer mit 0.123456 w würde 0.1235 w zurückschreiben, und jeder andere Operand der Layer würde gleich mit umgeschrieben, obwohl der Aufrufer nur Skalierung wollte. Kanonische Form gehört zu Operationen, deren Zweck vergleichbare Ausgabe ist
Diese Operationen bekommen sie weiterhin. NormalizeContentStreams und der Content-Optimierer beim Speichern parsen mit CanonicalNumbers auf True, denn ihre Aufgabe ist stabile Ausgabe aus beliebiger Eingabe; würden 0.50000 0 0 RG und 0.5 0 0 RG unterschiedlich emittiert, driftete jeder Downstream-Vergleich mit den Formatierungsgewohnheiten des Produzenten. Kanonisieren rekursiert durch Arrays und Dictionarys, also sind Strichmuster, TJ-Arrays und Property-Dictionarys von Marked Content abgedeckt, während rohe Inline-Image-Daten unangetastet bleiben. Operanden, die über SetOperand kommen, werden kanonisiert, was auch immer das Flag sagt. Ein Content-Programm trägt einen eigenen Zahlenspeicher mit fester Vier-Stellen-Präzision, unabhängig von SetPrecision, daher kommt ein bearbeiteter Operand mit vier Stellen heraus. Nur Parse liest das Flag, es muss also vor dem Parsen gesetzt sein; für ein Programm, das ParsePageContentLayer bereits geparst hat, das Flag setzen und Parse(Emit) aufrufen
uses
  PDFlibrary, PDFlibContentModel, PDFlibContentOps;

var
  PDF: TPDFlib;
  Prog: TPDFContentProgram;
  I: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;
    PDF.SelectPage(1);
    Prog := PDF.ParsePageContentLayer(1);
    if Prog = nil then
      Exit;
    try
      // Eine Linienbreite ändern; jeder andere Operand behält seinen Quelltext
      I := Prog.FindNextOp(0, coLineWidth);
      if I >= 0 then
        Prog.SetOperand(I, 0, '0.123456');   // emittiert als 0.1235
      PDF.WritePageContentLayer(1, Prog);

      // Kanonische Kopie nur für den Vergleich, nicht zurückgeschrieben:
      // Parse ist der einzige Leser des Flags, also nach dem Setzen neu parsen
      Prog.CanonicalNumbers := True;
      Prog.Parse(Prog.Emit);
      // Prog.Emit schreibt 0.50000 und 0.5 jetzt gleich
    finally
      Prog.Free;
    end;
    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Zusammengekommen ist die Regel für Aufrufer kurz. Ein schlichtes LoadFromFile gefolgt von SaveToFile lässt unberührte Content Streams und unberührte Dictionary-Zahlen so, wie sie waren. Eine über das Content-Modell bearbeitete Seite behält den Text jedes Operanden, den die Bearbeitung nicht änderte. NormalizeContentStreams, der Optimierer, der läuft, wenn Content beim Speichern komprimiert wird, und jedes mit CanonicalNumbers auf True geparste Programm produzieren kanonische Zahlen per Design, und der Rest des Dokuments bleibt weiterhin bewahrt
Was es kostet und wo die Garantie endet
Jedes TPDFNumeric trägt eine AnsiString-Referenz mehr, und jede geparste Dezimalzahl hält ihren Quelltext am Leben, solange das Objekt lebt. Bei einem Dokument mit Millionen von Realzahlen ist das messbarer Speicher, und er gehört in jeden Large-Document-Benchmark, den Sie fahren. Die Garantie gilt zudem nur innerhalb des eigenen Dokuments einer Zahl. Objekte zwischen Dokumenten zu kopieren oder Werte über die Objekt-API neu aufzubauen erzeugt neue Zahlen, und neue Zahlen folgen der Ausgabepräzision
Bewahrte Zahlen und byte-identische Ausgabe sind zwei getrennte Eigenschaften. Ein Load-and-Save eines unangetasteten Dokuments hält die Kalibrierungszahlen, die der Renderer verbraucht, aber Byte-Identität hängt auch an ObjektNummerierung, Stream-Kompression und der Trailer-Identifikator aus dem Artikel zur deterministischen PDF-ID. Der Fingerprint-Diff hasht weiterhin den normalisierten Body, das heißt: Rundungsdifferenzen in Dateien anderer Werkzeuge fallen außerhalb dessen, was er vergleicht; ein Rendervergleich bleibt die Prüfung dafür
Zahlenbehandlung und die exakte SetPrecision-Semantik sind in der Referenz der losLab PDF Developer Library behandelt, zusammen mit den oben benutzten Content-Modell-Aufrufen