Hier ist ein Fehler, den ein handgeschriebener JBIG2-Reader bei der ersten ungewöhnlichen Datei macht. Er parst den Datei-Header, parst den ersten Segment-Header, liest die Vier-Byte-Datenlänge und nimmt so viele Bytes als Segment-Body. Auf den meisten .jb2-Dateien ist das genau richtig. Bei einer Datei, deren Flags-Byte das Bit 0 gelöscht hat, sind diese „Body“-Bytes in Wirklichkeit der zweite, dritte und vierte Segment-Header, und der arithmetische Dekoder macht daraus ein Rausch-Bitmap oder läuft über das Buffer-Ende hinaus. Die Datei ist nicht kaputt. Sie nutzt die Random-Access-Organisation aus ITU-T T.88 Anhang D.2, bei der jeder Segment-Header zuerst kommt und alle Segmentdaten danach folgen, in derselben Reihenfolge
Random-Access-Dateien sind selten. Sie kommen aus Archiv- und Dokument-Imaging-Systemen, die wollen, dass ein Reader jede Seite und jede Dictionary-Abhängigkeit sieht, bevor er ein komprimiertes Byte anfasst. Mischt ein Konvertierungsauftrag Dateien aus so einer Quelle mit gewöhnlichen Scans, kann eine Random-Access-Datei mitten in einem Batch sitzen, der ansonsten komplett sequenziell ist. Der Dekoder, der sie liest, ist derselbe native Pascal-Dekoder, der auch JBIG2-Custom-Huffman-Tabellen und kanonische Präfix-Codes handhabt, die Kodierseite bleibt also gleich; nur die Reihenfolge, in der Segmente gefunden werden, ist anders
Drei Datei-Layouts hinter einem Flags-Byte
Die PDF Library for Delphi liest eigenständige JBIG2-Dateien über TPLJBIG2Decoder in der Unit PDFlibJBIG2, und der Dekoder ermittelt das Layout selbst aus dem Datei-Header. T.88 Anhang D erlaubt dieselben Segmente auf drei Arten: Sequential (D.1) setzt jeden Header direkt vor seine Daten, Random-Access (D.2) setzt alle Header voran und alle Daten dahinter, und Embedded (D.3) ist die headerlose Form, die in anderen Containern steckt. Eine eigenständige Datei beginnt mit dem Acht-Byte-Identifier 97 4A 42 32 0D 0A 1A 0A, dann einem Flags-Byte, dann einer Vier-Byte-Seitenzahl, sofern die Flags nicht sagen, dass die Anzahl unbekannt ist
Bit 0 dieses Flags-Bytes wählt die Organisation: 1 heißt sequenziell, 0 heißt Random-Access. Bit 1 gesetzt heißt, die Seitenzahl ist unbekannt und der Vier-Byte-Zähler fehlt, also beginnt der erste Segment-Header bei Byte 9 statt Byte 13. Die Bits 2 bis 7 sind reserviert; der Dekoder akzeptiert Dateien, die sie setzen, statt sie abzulehnen, denn ein einzelnes gesetztes Reserved-Bit sagt nichts darüber, ob die Segmente selbst lesbar sind
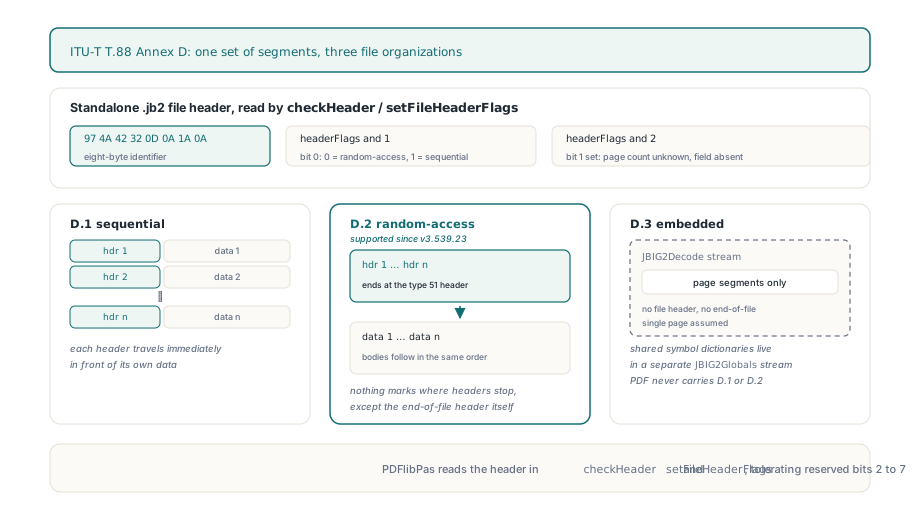
PDF selbst trägt das Random-Access-Layout nie. Ein JBIG2Decode-Bild-Stream, beschrieben in ISO 32000-1 §7.4.7, hält nur Seitensegmente in eingebetteter Form, mit geteilten Symbol-Dictionarys in einem separaten JBIG2Globals-Stream und ohne Datei-Header, End-of-Page- oder End-of-File-Segmente. Findet der Dekoder den Acht-Byte-Identifier nicht, behandelt er die Eingabe als genau diese Art von Stream: sequenziell, eine Seite. Anders herum: Exportiert die PDF Library for Delphi ein JBIG2Decode-Bild als native .jb2-Datei, schreibt sie das Flags-Byte $03 (sequenziell, Seitenzahl unbekannt) und hängt einen End-of-File-Segment-Header an. Random Access kommt also nur von außen, als eigenständige Datei, die direkt an TPLJBIG2Decoder übergeben wird, meist auf dem Weg, für PDF konvertiert oder rekodiert zu werden, mit den JBIG2-Encoder-Backends in PDFlibPas
Warum kann man eine Random-Access-Datei nicht in Dateireihenfolge lesen?
Weil nichts im Bytestrom markiert, wo der Header-Block endet und der Datenblock beginnt, außer dem End-of-File-Segment-Header (Typ 51) selbst. JBIG2-Segment-Header haben keine feste Größe. Die Referred-to-Segment-Zahl ist entweder eine Drei-Bit-Kurzform oder eine Langform mit anschließender Retention-Bitmap; jede Referred-to-Segment-Nummer nimmt ein, zwei oder vier Bytes, je nachdem, wie groß die eigene Nummer des aktuellen Segments ist; das Page-Association-Feld ist ein Byte oder vier. Ein Reader muss jedes Feld eines Headers parsen, nur um zu erfahren, wo der nächste beginnt
Ein sequenzieller Reader, der die Datei der Reihe nach durchläuft, bekommt den ersten Header richtig und alles danach falsch. Schlimmer: Er merkt es womöglich eine Weile nicht. Ein Generic-Region-Dekoder, dem Header-Bytes verfüttert werden, produziert Pixel, keinen Fehler, bis irgendeine spätere Längen- oder Referenzprüfung endlich zuschlägt. Unsere Auffassung: Ein Dekoder, der nicht zuerst Header indexiert, sollte Random-Access-Dateien kategorisch verweigern. Eine klare Ablehnung kostet eine Datei im Batch; ein plausibel aussehendes, aber falsches Bitmap kann in einem Archiv landen und dort bleiben
Jeden Header indexieren, bevor der erste Body kommt
Sagt das Flags-Byte Random-Access, macht die PDF Library for Delphi einen Durchlauf über den Header-Block, bevor irgendetwas dekodiert wird. Jeder Header wird vollständig geparst und dann weggeworfen; behalten wird nur sein Byte-Offset in der Datei. Die komprimierten Daten werden nie in einen umgeordneten zweiten Buffer kopiert, was bei großen Archiv-Scans zählt, wo der Datenblock der größte Teil der Datei sein kann. Der Durchlauf stoppt am ersten End-of-File-Header, und zu dem Zeitpunkt sitzt die Leseposition auf dem ersten Byte der Daten des ersten Segments
Eine Random-Access-Datei hat weniger Redundanz als eine sequenzielle, daher ist der Vorab-Scan streng. Er weist die Datei zurück, wenn:
- ein Header vom Buffer-Ende abgeschnitten wird, gemeldet als
JBIG2 truncated random-access header at byte Nmit dem Offset, an dem dieser Header begann - Segment-Nummern nicht streng steigen (verglichen als vorzeichenlose Werte), denn zwei Header, die dieselbe Nummer beanspruchen, machen die Referred-to-Liste einer späteren Region mehrdeutig
- eine Datenlänge ihr oberstes Bit gesetzt hat, was den
0xFFFFFFFF-Marker „unbekannte Länge“ einschließt; in diesem Layout gibt es keinen anderen Weg zu finden, wo der nächste Body beginnt, also lehnt der Dekoder ihn sofort ab, statt nach einem End-Marker zu scannen - der End-of-File-Header irgendwelche Daten deklariert oder gar nicht auftaucht (
JBIG2 random-access file is missing its end-of-file header) - die deklarierten Längen zusammen mehr ergeben als die verbleibenden Bytes, oder weniger
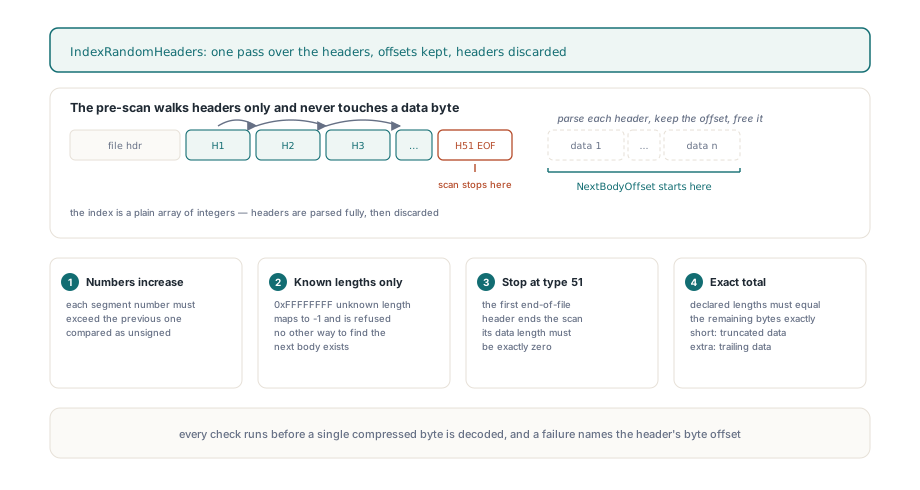
Die letzte Regel ist die, über die Leute stolpern. Ein einziges zusätzliches Byte nach dem letzten Body scheitert mit JBIG2 trailing random-access data. Das wirkt hart neben dem sequenziellen Weg, wo das Dekodieren einfach am End-of-File-Segment stoppt und alles danach ignoriert wird. Die Asymmetrie hat einen Grund. Im sequenziellen Layout sitzt jeder Header direkt neben seinen eigenen Daten, also kann Müll am Ende nichts verschoben haben. Im Random-Access-Layout sind die Header die einzige Karte des Datenblocks, und wenn die Längen nicht aufgehen, kann der Dekoder harmloses Padding nicht unterscheiden von einem Byte, das viel früher verloren oder hinzugefügt wurde und jeden Body danach verschoben hat
Warum verliert eine Byte-gezählte Schleife das letzte End-of-Page-Segment?
Eine Schleife, die „solange Bytes übrig“ läuft, endet bei einer Random-Access-Datei zu früh, denn die Daten gehen zur Neige, bevor der Header-Index es tut. End-of-Page- (Typ 49) und End-of-File-Segmente tragen null Daten-Bytes und kommen normalerweise zuletzt. Ist der letzte Region-Body konsumiert, sitzt die Leseposition exakt am Buffer-Ende; eine Byte-gezählte Schleife steigt dort aus, und das End-of-Page-Segment mit der Länge null wird nie ausgeliefert, was die Seite unvollständig lässt
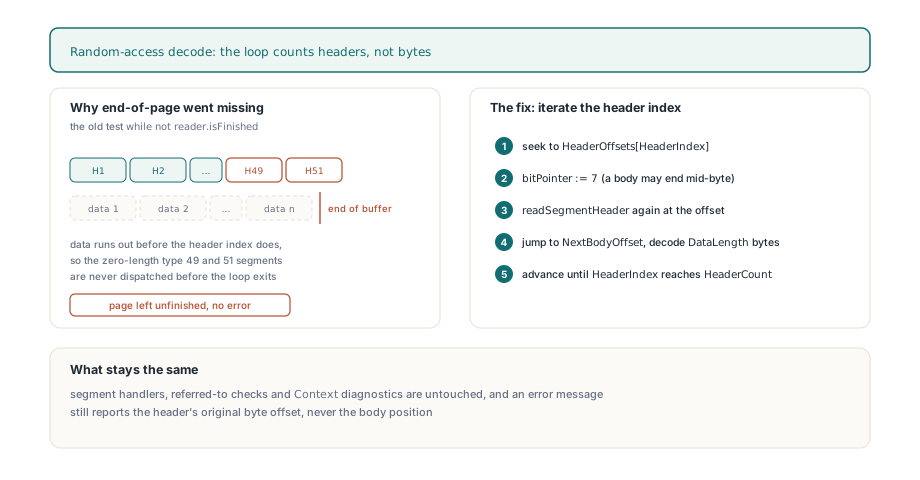
Daher zählt der Dekoder bei Random-Access-Dateien Header, keine Bytes. Jeder Schritt springt zurück zum nächsten indexierten Header, richtet sich an einer Bytegrenze aus (ein arithmetisch kodierter Body kann mitten im Byte enden), parst den Header erneut, springt dann vorwärts dorthin, wo der nächste Body beginnt, und rückt um die deklarierte Länge darüber hinaus. Ein Body, dessen Dekoder früher fertig wird, wird bis zu seinem deklarierten Ende übersprungen; einer, der darüber hinaus liest, wird abgelehnt. Von dort läuft das Segment durch dieselben Handler und Referenzprüfungen wie in einer sequenziellen Datei. Fehler beim Dekodieren eines Bodys tragen die Originalposition des Headers, in der Form JBIG2 segment N (type T) at byte B: ..., sodass der Offset in LastError auf etwas zeigt, das man in einem Hex-Editor finden kann
Eine Random-Access-.jb2-Datei in Delphi laden
Anwendungscode ändert sich mit der Organisation nicht. TPLJBIG2Decoder.LoadFromByteArray erkennt Datei-Header und Layout, liefert False bei jeder zurückgewiesenen Eingabe mit dem Grund in LastError und legt die dekodierte Seite über Width, Height und GetScanline offen, die ein Byte pro Pixel füllt, mit 1 für Schwarz
uses
  SysUtils, Classes, PDFlibJBIG2;

function ReadJb2(const FileName: string): TJBIG2ByteArray;
var
  FS: TFileStream;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    SetLength(Result, FS.Size);
    if Length(Result) > 0 then
      FS.ReadBuffer(Result[0], Length(Result));
  finally
    FS.Free;
  end;
end;

function CountBlackPixels(const FileName: string): Integer;
var
  Decoder: TPLJBIG2Decoder;
  Row: TJBIG2ByteArray;
  X, Y: Integer;
begin
  Result := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    // Sequenzielle und Random-Access-Einzeldateien nehmen denselben Aufruf
    if not Decoder.LoadFromByteArray(ReadJb2(FileName)) then
      raise Exception.Create('JBIG2 rejected: ' + Decoder.LastError);
    for Y := 0 to Decoder.Height - 1 do
      if Decoder.GetScanline(Y, Row) then
        for X := 0 to Decoder.Width - 1 do
          if Row[X] = 1 then
            Inc(Result);
  finally
    Decoder.Free;
  end;
end;
Wer wissen will, welches Layout eine Datei nutzt, etwa fürs Logging oder um ein Korpus vor einem Konvertierungslauf zu sortieren, liest das Flags-Byte selbst. Die Bibliothek legt die erkannte Organisation nicht offen, und neun Bytes sind alles, was man braucht. Der Helper unten ist etwas für Ihren eigenen Code; er wiederholt einfach die T.88-Header-Regeln:
type
  TJb2Layout = (jlNoFileHeader, jlSequential, jlRandomAccess);

// Eigener Helper, kein Teil von PDFlibJBIG2: sortiert einen Buffer anhand seines T.88-Datei-Headers ein
function DetectJb2Layout(const Data: TJBIG2ByteArray;
  out PageCountKnown: Boolean): TJb2Layout;
const
  Signature: array[0..7] of Byte = ($97, $4A, $42, $32, $0D, $0A, $1A, $0A);
var
  I: Integer;
begin
  Result := jlNoFileHeader;          // z. B. ein eingebetteter Stream, der aus einem PDF herausgelöst wurde
  PageCountKnown := False;
  if Length(Data) < 9 then
    Exit;
  for I := 0 to 7 do
    if Data[I] <> Signature[I] then
      Exit;
  PageCountKnown := (Data[8] and 2) = 0;   // Bit 1 gesetzt: keine Vier-Byte-Seitenzahl
  if (Data[8] and 1) = 0 then
    Result := jlRandomAccess
  else
    Result := jlSequential;
end;
Batch-Jobs: gepolsterte Buffer und abgelehnte Dateien
Die Trailing-Data-Regel ist die Stelle, an der Batch-Code meist danebengeht, und wenn eine Datei, die anderswo aufgeht, auf diese Weise abgelehnt wird, schauen Sie auf den Buffer, bevor Sie auf die Datei schauen. Ein .jb2 aus einer Datenbank-BLOB-Spalte, eine netzwerkseitig fix dimensionierte Leseoperation oder ein Containerformat mit Alignment-Padding kann mit ein paar Null-Bytes nach dem echten Ende ankommen. Eine sequenzielle Datei schulterkreuzt das weg. Eine Random-Access-Datei mit demselben Padding scheitert mit JBIG2 trailing random-access data, und ebenso ein Buffer, der um ein paar Bytes zu kurz geschnitten ist, der als Truncated scheitert. Reichen Sie exakt die Bytes der Datei durch, dimensioniert nach der echten Länge der Quelle, nie nach einer Chunk-Größe oder einer Kapazität
Eine abgelehnte Datei hinterlässt auch nichts. LoadFromByteArray setzt Width, Height und die Scanlines zurück, bevor es mit dem Dekodieren beginnt, also meldet ein fehlgeschlagener Aufruf die Dimensionen null statt der Seite der vorigen Datei, und dieselbe Dekoder-Instanz kann direkt zur nächsten Datei weiterziehen:
procedure DecodeBatch(const Files, Log, Quarantine: TStrings);
var
  Decoder: TPLJBIG2Decoder;
  I: Integer;
begin
  Decoder := TPLJBIG2Decoder.Create;
  try
    for I := 0 to Files.Count - 1 do
      if Decoder.LoadFromByteArray(ReadJb2(Files[I])) then
        Log.Add(Format('%s: %d x %d', [Files[I], Decoder.Width, Decoder.Height]))
      else
      begin
        // Width und Height sind hier 0; nichts aus der vorigen Datei überlebt
        Log.Add(Files[I] + ': ' + Decoder.LastError);
        if Pos('trailing random-access data', Decoder.LastError) > 0 then
          Quarantine.Add(Files[I]);   // prüfen, wie die Bytes abgelegt waren, bevor man der Datei die Schuld gibt
      end;
  finally
    Decoder.Free;
  end;
end;
Das in der eigenen Pipeline zu prüfen braucht keine seltenen Beispieldateien. Organisieren Sie eine sequenzielle .jb2 in Random-Access-Layout um, wobei jeder Header und jedes komprimierte Byte erhalten bleibt, verlegen Sie die End-of-Page- und End-of-File-Header ans Ende des Header-Blocks, und die dekodierten Pixel müssen exakt dem sequenziellen Original entsprechen, mit und ohne Seitenzahl-Feld. Füttern Sie ihn dann mit jedem abgeschnittenen Präfix, einer doppelt vergebenen Segment-Nummer, einem zusätzlichen Trailing-Byte und einer 0xFFFFFFFF-Länge; jedes muss False liefern, mit Width und Height auf null
Was der Dekoder liefert und was er erwartet
Random Access ist hier eine Eigenschaft des Datei-Layouts. TPLJBIG2Decoder liefert das Bitmap der ersten Seite, ganz gleich, welche Organisation die Datei nutzt, und Width und Height beschreiben diese Seite. Jedes Segment muss seine Datenlänge deklarieren; T.88 lässt eine Immediate Generic Region den 0xFFFFFFFF-Marker nutzen, und der Dekoder weist diesen Marker in beiden Layouts mit unknown or oversized segment length is not supported zurück. Custom-Huffman-Präfixlängen und Tabelleneintragszahlen sind genauso gedeckelt wie in sequenziellen Dateien
JBIG2 zu dekodieren ist eine Stufe eines längeren Bild-Wegs, der auch PDF-Bildextraktion, Rekompression und JBIG2-Kodierung abdeckt; die Produktseite der PDF Library for Delphi behandelt den Rest dieser Pipeline und die unterstützten Bildformate