Werfen Sie ein JBIG2-Tables-Segment (Typ 53) Byte für Byte auseinander, ist die erste Überraschung, was es weglässt: die Huffman-Codes selbst. Sie bekommen ein Flags-Byte, zwei Grenzen und eine Folge kleiner Zahlen, und diese Zahlen sind Code-Längen. Encoder und Decoder bauen die tatsächlichen Bitmuster beide aus den Längen mit dem Verfahren aus ITU-T T.88 Annex B.3 wieder auf. Bauen Sie sie in leicht anderer Reihenfolge auf, erhalten Sie trotzdem einen gültigen Prefix Code, jedes Muster dekodiert weiter, und jeder Wert landet am falschen Muster
Auf einer Seite, die mit Huffman-Symbol-IDs und selbst mitgeschickten Encoder-Tables kodiert ist, sieht diese Diskrepanz aus wie ein schlechter Scan: Glyphen um einige Pixel verschoben, Zeichen aus den falschen Symbolen gebaut, oder plausibel aussehende Zahlen, bis mehrere Segmente später eine Breite aus dem Bereich läuft. Das meiste JBIG2 in PDF-Dateien ist arithmetisch kodiert, und das meiste Huffman-kodierte JBIG2 hält sich an die Standard-Tables B.1 bis B.15. Dateien mit eigenen Tables sind selten, und sie trainieren Table-Parser, Huffman-kodiertes Refinement und unkomprimierte Collective Bitmaps meist alle auf einmal
Was ein Tables-Segment tatsächlich trägt
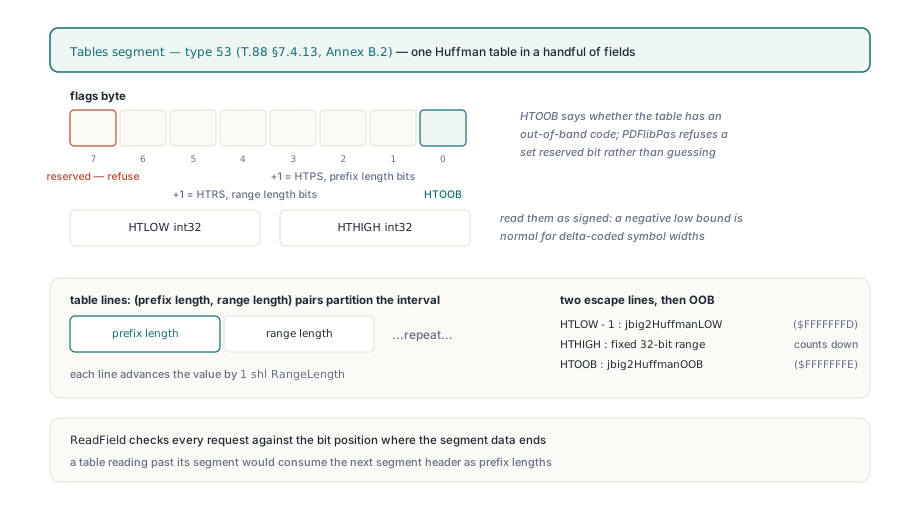
Ein Tables-Segment beschreibt genau eine Huffman-Tabelle. T.88 §7.4.13 und Annex B.2 legen es aus als ein Flags-Byte, ein vorzeichenbehaftetes 32-Bit-HTLOW, ein vorzeichenbehaftetes 32-Bit-HTHIGH und dann (Prefix-Länge, Range-Länge)-Paare, die das Intervall von HTLOW bis HTHIGH kacheln. Bit 0 des Flags ist HTOOB, was sagt, ob die Table einen Out-of-Band-Code hat. Bits 1 bis 3 plus eins ergeben HTPS, die Breite jedes Prefix-Längen-Felds. Bits 4 bis 6 plus eins ergeben HTRS, die Breite jedes Range-Length-Felds. Bit 7 ist reserviert
An den Grenzen stolpert ein handgeschriebener Parser meist zuerst. Liest man HTLOW als vorzeichenlos, behauptet eine Table, die bei -2 beginnt — für delta-kodierte Symbol-Breiten und -Höhen völlig üblich — plötzlich, knapp unter 4,3 Milliarden zu beginnen. PDF Library for Delphi liest beide Grenzen als vorzeichenbehaftete Werte, weist eine Table zurück, deren HTLOW nicht unter HTHIGH liegt oder deren Range-Länge 32 übersteigt, und prüft jedes Feldlesen gegen das Bit, an dem die deklarierten Segmentdaten enden. Diese letzte Prüfung wiegt schwerer, als sie klingt: Eine Table, die über ihr Segment hinausliest, konsumiert den nächsten Segment-Header als Prefix-Längen und parst sich in kompletten Unsinn. Ein gesetztes Bit 7 scheitert mit reserved custom Huffman table flag. Diese Zurückweisung ziehen wir einem Ratsspiel vor, denn eine geratene Table produziert falsche Pixel, die niemand bis zur Ursache zurückverfolgen kann
Auf die regulären Lines folgen die Escape-Lines aus Annex B.2. Die untere Range-Line startet bei HTLOW minus eins und zählt mit einem 32-Bit-Offset abwärts, die obere Range-Line startet bei HTHIGH mit einer 32-Bit-Range, und die Out-of-Band-Line existiert nur, wenn HTOOB gesetzt ist. Diese Lines tragen dieselben Marker wie die eingebauten Standard-Tables, also laufen eine Custom-Table und Table B.6 durch eine Dekodier-Schleife. Eine Custom-Table kann bis zu 65.536 Lines aufnehmen
Warum müssen Prefix Codes in Table-Line-Reihenfolge zugewiesen werden?
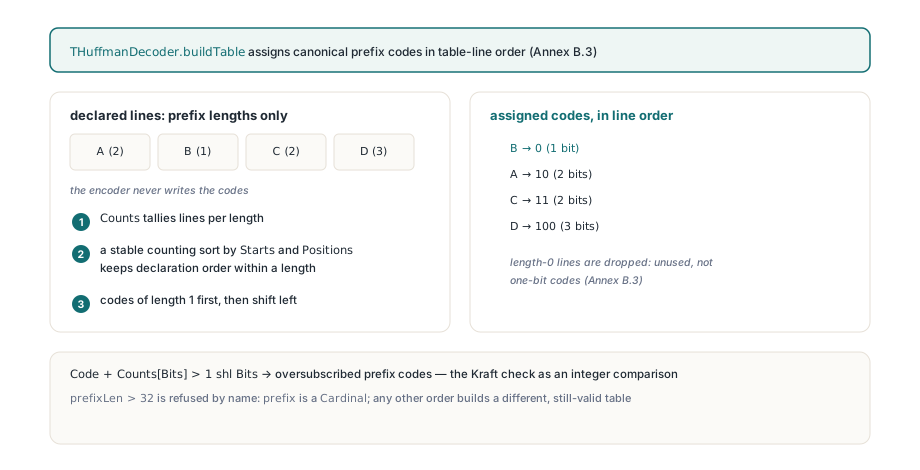
Weil die Deklarationsreihenfolge das Einzige ist, das ein Bitmuster an einen Wertebereich bindet. Annex B.3 zählt, wie viele Lines jede Prefix-Länge benutzen, vergibt zuerst Codes der Länge 1, schiebt nach links, um zu Länge 2 zu gelangen, und so weiter; innerhalb einer Länge gehen die Codes an die Lines in der Reihenfolge ihres Auftretens im Segment. Eine kleine Table macht das konkret. Sechs Lines, in Dateireihenfolge von A bis F benannt, mit diesen Prefix-Längen:
| Line | Prefix-Länge | Code (Dateireihenfolge gehalten) | Code, wenn B und D tauschen |
|---|---|---|---|
| A | 2 | 00 | 00 |
| B | 3 | 100 | 101 |
| C | 2 | 01 | 01 |
| D | 3 | 101 | 100 |
| E | 3 | 110 | 110 |
| F | 0 | ungenutzt | ungenutzt |
Beide Spalten sind gültige Prefix Codes. Nur die linke ist es, was der Encoder meinte: Mit getauschten B und D liefert das Muster 100 Ds Wertebereich, und der Decoder macht weiter mit einer Zahl aus dem falschen Intervall. Line F hat die Länge 0, was B.3 als ungenutzt definiert; geben Sie ihr einen Ein-Bit-Code, verschiebt sich jede spätere Zuweisung
Der bequeme Weg zur rechten Spalte ist ein Allzweck-Sortierlauf nach Prefix-Länge. Delphis TArray.Sort und TList<T>.Sort sind nicht stabil, gleiche Längen können also in beliebiger Reihenfolge zurückkommen. Für kanonische Codes im eigenen Werkzeug geht man die Lines stattdessen einmal pro Länge in Dateireihenfolge durch:
uses
  System.SysUtils;

type
  TCodeLine = record
    PrefixLen: Integer;   // wie aus dem Tables-Segment gelesen
    Code: Cardinal;       // unten zugewiesen
  end;

// Kanonische Zuweisung nach Annex B.3, geschrieben für Ihr eigenes Werkzeug.
// Gleiche Längen behalten ihre Dateireihenfolge; Länge 0 bekommt keinen Code.
procedure AssignCanonicalCodes(var Lines: array of TCodeLine);
var
  LenCount: array[0..32] of UInt64;
  FirstCode: array[0..32] of UInt64;
  NextCode: UInt64;
  CurLen, I: Integer;
begin
  FillChar(LenCount, SizeOf(LenCount), 0);
  for I := 0 to High(Lines) do
  begin
    if (Lines[I].PrefixLen < 0) or (Lines[I].PrefixLen > 32) then
      raise Exception.Create('prefix length out of range');
    Inc(LenCount[Lines[I].PrefixLen]);
  end;
  LenCount[0] := 0;
  FirstCode[0] := 0;
  for CurLen := 1 to 32 do
  begin
    FirstCode[CurLen] := (FirstCode[CurLen - 1] + LenCount[CurLen - 1]) shl 1;
    // Kraft-Prüfung: mehr Codes, als diese Länge fassen kann
    if FirstCode[CurLen] + LenCount[CurLen] > (UInt64(1) shl CurLen) then
      raise Exception.Create('oversubscribed prefix lengths');
    NextCode := FirstCode[CurLen];
    for I := 0 to High(Lines) do       // Dateireihenfolge ist der Tie-Break
      if Lines[I].PrefixLen = CurLen then
      begin
        Lines[I].Code := Cardinal(NextCode);
        Inc(NextCode);
      end;
  end;
end;
Füttern Sie ihn mit den sechs Lines oben und A bekommt 00, C bekommt 01, B bekommt 100, D bekommt 101 und E bekommt 110; F behält keinen Code. PDF Library for Delphi erledigt dieselbe Aufgabe mit einem Zähl-Durchlauf, der konstruktionsbedingt stabil ist und das 32-malige Neudurchlaufen der Table vermeidet, und zieht dieselben beiden Schranken an. Übersubskribierte Längen scheitern mit oversubscribed Huffman prefix codes; lässt man sie durch, kann ein Muster auf zwei Lines passen. Prefixes länger als 32 Bits scheitern ebenfalls namentlich, obwohl T.88 sie auf dem Papier erlaubt. Wir halten diese Deckelung für den richtigen Trade: Jeder Code passt in ein Maschinenwort, und eine Datei, die mehr braucht, ist weit eher beschädigt als schlau
Werte brauchen dieselbe Sorgfalt. Die untere Range-Line dekodiert als HTLOW minus eins minus eines 32-Bit-Offsets ohne Vorzeichen, und mit einem 32-Bit-Integer als Zwischenergebnis kann diese Subtraktion in eine gewöhnlich aussehende positive Breite umlaufen. Der Decoder rechnet in 64 Bits und wirft Huffman value exceeds signed integer range, wenn das wahre Ergebnis nicht hineinpasst
Selektor-Reihenfolge und zwei Fallen, die einander decken
Eine Text Region oder ein Symbol-Dictionary benennt seine Tables nicht. Es trägt Zwei-Bit-Selektoren, und jeder auf Custom gesetzte Selektor nimmt das nächste Tables-Segment aus der Referral-Liste, in Referral-Reihenfolge. T.88 §7.4.3.1.2 ordnet die Text-Region-Selektoren als FS, DS, DT, RDW, RDH, RDX, RDY und RSIZE; §7.4.2.1.1 ordnet die Symbol-Dictionary-Selektoren als DH, DW, BMSIZE und AGGINST. Die Werte 0 und 1 wählen Standard-Tables, 3 wählt eine Custom-Table, und 2 ist auf Feldern mit nur zwei Standard-Tables reserviert. PDF Library for Delphi weist reservierte Selektorwerte zurück und scheitert mit missing custom Huffman table reference, wenn die Selektoren mehr Custom-Tables wollen, als die Region referenziert
Wer seinen eigenen Decoder schreibt, macht hier leicht zwei Fehler, und jeder versteckt den anderen. Der erste beißt in Delphi, oder FPC im Delphi-Modus (der Objfpc-Modus weist den Code als doppelten Bezeichner zurück): ein Flags-Setter, dessen Parameter denselben Namen trägt wie das Feld. Der Parameter verschattet das Feld, Flags := Flags weist es sich selbst zu, und das Feld bleibt null. Jeder Selektor liest dann null, eine Text Region benutzt die Standard-Tables B.6, B.8 und B.11 für FS, DS und DT, was auch immer die Datei verlangte, und der Custom-Pfad läuft nie
Der zweite sitzt im Symbol-Dictionary. Ein Huffman-Dictionary kann seine Symbole als unkomprimierte Collective Bitmap ablegen (BMSIZE null), wobei jede Zeile in einem Teilbyte endet. Der Padding-Wert ist die Anzahl gültiger Bits in diesem Byte, und es verführt, ihn als die niedrigste gültige Bit-Position zu lesen:
// Letztes Byte einer Collective-Bitmap-Zeile, Bits MSB-zuerst gelesen.
// Padding := TotalWidth mod 8  -> Anzahl der GÜLTIGEN Bits in diesem Byte

// Falsch: behandelt Padding als den niedrigsten zu kopierenden Bit-Index
for BitPos := 7 downto Padding do
  CopyPixel((LastByte shr BitPos) and 1);

// Richtig: der niedrigste gültige Bit-Index ist 8 - Padding (0 bei Padding = 0)
for BitPos := 7 downto ((8 - Padding) and 7) do
  CopyPixel((LastByte shr BitPos) and 1);

// CopyPixel steht für das, was in Ihrem eigenen Decoder das Pixel schreibt
Prüfen Sie die Grenzbreiten. Eine 63-Pixel-Zeile hat ein Padding von 7: Die falsche Schleife kopiert ein Bit des letzten Bytes, die richtige sieben. Eine 9-Pixel-Zeile hat ein Padding von 1: Die falsche Schleife kopiert sieben, die richtige eins. Bei 64 Pixeln kopieren beide alle acht, Vielfache von 8 legen den Fehler also nie offen. Synthetische Collective Bitmaps mit 7 und 9 Pixeln Breite nageln beide Seiten der Byte-Grenze fest. Und der Schaden wandert weiter, denn das Refinement benutzt diese Symbole als Referenzen
Hat Ihr eigener Decoder beide Fallen, wird das Debuggen elend. Korrigiert man nur den Setter, läuft der Custom-Pfad endlich — direkt in kaputte Collective Bitmaps, die Seite sieht also weiterhin falsch aus. Korrigiert man nur das Padding, ändert sich sichtbar nichts, weil der Custom-Pfad weiter unerreichbar ist. Testen Sie beides mit synthetischen Eingaben, bevor Sie einer der beiden Änderungen vertrauen. Ein verwandtes Detail: Ein Huffman-Symbol-Dictionary, dessen Eingabe- und neue Symbole sich zu eins aufaddieren, bekommt aus der log2-Formel eine Symbol-Code-Länge von 0, doch die Huffman-Variante schreibt jede Symbol-ID mit mindestens einem Bit. PDF Library for Delphi hebt diese Länge im Huffman-Modus auf 1 an
Wo liest das Huffman-Refinement seine Bitmap-Größe?
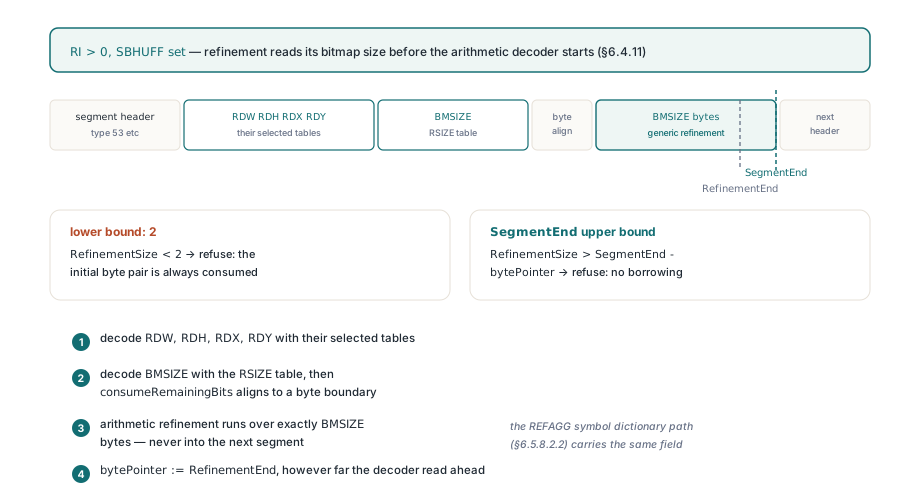
Aus einem BMSIZE-Feld, das nur im Huffman-Modus existiert und vor den arithmetischen Refinement-Daten dekodiert wird. Hat eine Text-Region-Instanz Refinement (RI ungleich null) und SBHUFF ist gesetzt, liest der Decoder nach T.88 §6.4.11 RDW, RDH, RDX und RDY mit ihren gewählten Tables, dann BMSIZE mit der RSIZE-Table, dann springt er zu einer Byte-Grenze, und erst danach läuft die generische Refinement-Dekodierung über genau BMSIZE Bytes. Text Regions im arithmetischen Modus haben kein solches Feld, also überspringt ein Decoder, der einen Codepfad zwischen beiden Modi teilt, es, startet den arithmetischen Decoder zu früh und verfeinert jedes Symbol gegen Rauschen. Der Symbol-Dictionary-Pfad mit REFAGG und einer einzelnen Refinement-Instanz (§6.5.8.2.2) hat dasselbe Feld
PDF Library for Delphi begrenzt BMSIZE auf beiden Seiten. Das Minimum ist 2, das initiale Byte-Paar, das der arithmetische Decoder immer konsumiert. Das Maximum ist, was vom aktuellen Segment übrig bleibt, bewusst nicht vom ganzen Stream: Ein BMSIZE, das nur passt, wenn es Bytes vom nächsten Segment borgt, ist missgestaltet, und eine Stream-Längenprüfung würde den arithmetischen Decoder in den folgenden Header hineinlesen lassen. Außerhalb des Bereichs liegende Größen scheitern mit invalid refinement bitmap size. Danach setzt der Huffman-Reader exakt BMSIZE Bytes hinter dem Feld wieder an, was auch immer der arithmetische Decoder vorausgelesen hat
Die deklarierte Segmentlänge ist die Grenze
Jeder Segment-Header gibt an, wie viele Datenbytes folgen, und der Decoder hält das Segment in beide Richtungen an diese Zahl: Über das Ende hinaus zu lesen ist ein Fehler, früh fertig zu werden ist normal, und der nächste Header wird immer von der Stelle gelesen, an der die Datei sagt, dass er beginnt. Kleinere Regeln folgen. Die unbekannte Datenlänge aus T.88 §7.2.7 wird vorne abgewiesen, statt nach einem Terminator zu scannen. Referenzierte Segmente müssen kleinere Nummern tragen als das aktuelle und müssen bereits existieren. END_OF_PAGE und END_OF_FILE müssen null Datenbytes deklarieren. Ein Profiles-Segment (Typ 52) muss exakt 4 plus 4 mal seine Bezeichneranzahl sein; es wird dann übersprungen, aber behalten, spätere Segmente können es also weiterhin referenzieren, und ein unbekannter Profil-Bezeichner stoppt die Dekodierung nicht
Der klassische Fall für frühes Fertigsein ist MMR. Ein MMR-Decoder ist fertig, sobald er das letzte Pixel der letzten Zeile produziert, was vor dem EOFB-Terminator passieren kann, den T.88 §6.2.5.7 ans Datenende setzt. Ein Reader, der annimmt, jetzt am nächsten Header zu sitzen, parst die verbliebenen EOFB-Bytes als Segmentnummer und scheitert einige Bytes später, weit weg von der wahren Ursache. Der Sprung zum deklarierten Ende vermeidet die Frage. Dieselbe Gewohnheit zieht sich durch das Parsen nicht vertrauenswürdiger PDF-Strukturen bei PDF Library for Delphi im Allgemeinen
Einen JBIG2-Bild-Stream aus Delphi dekodieren
Der Decoder wohnt in der Unit PDFlibJBIG2 als TPLJBIG2Decoder. LoadFromByteArray nimmt die eingebetteten JBIG2-Daten eines /JBIG2Decode-Bilds und optional die Daten seines /JBIG2Globals-Streams, in dem Custom-Tables und geteilte Symbol-Dictionarys üblicherweise wohnen. Er liefert False bei jeder Zurückweisung und hinterlässt den Grund in LastError; die Ausgabe eines früheren Aufrufs wird zu Beginn jedes Aufrufs geleert, ein gescheitertes Dekodieren hinterlässt also nie alte Pixel, die der Aufrufer für ein Ergebnis halten könnte
uses
  System.SysUtils, PDFlibJBIG2;

// ImageBytes: die Bild-Stream-Daten, von denen alle Filter vor
//   JBIG2Decode bereits entfernt sind
// GlobalBytes: die /JBIG2Globals-Stream-Daten oder ein leeres Array
function DecodeAndCountBlack(const ImageBytes, GlobalBytes: TJBIG2ByteArray;
  out BlackPixels: Int64): Boolean;
var
  Decoder: TPLJBIG2Decoder;
  Line: TJBIG2ByteArray;
  Row, Col: Integer;
begin
  BlackPixels := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    Result := Decoder.LoadFromByteArray(ImageBytes, GlobalBytes);
    if not Result then
    begin
      // Format: 'JBIG2 segment <n> (type <t>) at byte <offset>: <reason>'
      Writeln('JBIG2 refused: ', Decoder.LastError);
      Exit;
    end;
    for Row := 0 to Decoder.Height - 1 do
    begin
      Decoder.GetScanline(Row, Line);   // ein Byte pro Pixel, 0 oder 1
      for Col := 0 to Decoder.Width - 1 do
        Inc(BlackPixels, Line[Col]);    // 1 = schwarz in JBIG2
    end;
  finally
    Decoder.Free;
  end;
end;
Die Schwarzpixel-Zählung ist Ihre eigene Prüfung, ein billiger Fingerabdruck zum Vergleichen gegen einen zweiten Renderer. Fehler auf Segment-Ebene kommen mit Segmentnummer, Typ und Byte-Offset vorangestellt an, ein (type 53) vor oversubscribed Huffman prefix codes zeigt also direkt auf ein Tables-Segment. Halten Sie die beiden Fehlerkanäle auseinander: TPLJBIG2Decoder.LastError ist der Diagnosetext dieses Decoders, während TPDFlib.LastErrorCode der numerische Code der API auf Bibliotheksebene ist. Die Seitenwahl folgt dem Stream: Der Decoder liefert die Bitmap des ersten Page-Information-Segments, auf das er trifft, und schlägt Seiten-Assoziation 0 nicht nach, denn in PDF eingebettetes JBIG2 trägt eine Seite, und Encoder nummerieren sie routinemäßig 1
Renderer an diesen Dateien zu vergleichen verlangt etwas Demut, denn unabhängige JBIG2-Decoder sind sich bei Custom-Table-Dateien mit Huffman-Refinement nicht immer einig. Zwei sich widersprechende Decoder entscheiden nichts. Die Formatfelder schon: welche Tables die Selektoren wählten, was BMSIZE deklarierte, wo jedes Segment endet
Das Kodieren deckt der Artikel zu JBIG2-Encoder-Backends und ihrer Anbindung ab. Der Lesepfad muss nehmen, was der Encoder eines anderen ausgeworfen hat, und teilt seine Regeln mit dem eingebauten TIFF-Decoder und seinen BigTIFF- und Tiled-Layout-Prüfungen: namentlich zurückweisen, nie Bytes über eine deklarierte Grenze hinweg borgen, arithmetische Zwischenwerte breit halten. Wenn ein Ordner gescannter PDFs andere Toolkits ständig stolpern lässt, prüfen Sie, ob die Bilder Huffman-kodiertes JBIG2 mit Custom-Tables sind, und legen Sie sie dann gegen den nativen Delphi- und C++Builder-Lesepfad, beschrieben auf der PDF Library for Delphi-Produktseite