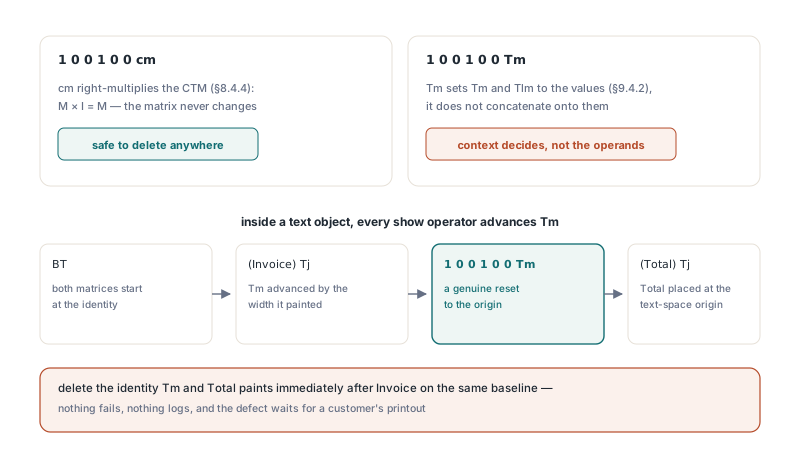
Nehmen wir einen Content-Stream, wie ein Reportgenerator ihn schreiben könnte, BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET, und streichen wir das 1 0 0 1 0 0 Tm, weil seine sechs Zahlen die Identity-Matrix buchstabieren. Rendert man das Ergebnis, beginnt "Total" nicht mehr am Ursprung des Textraums. Es beginnt dort, wo "Invoice" endete, auf derselben Grundlinie. Ein Identity-Tm ist nur dann redundant, während die Textmatrix und die Textzeilenmatrix bereits die Identity halten: direkt nach BT, oder direkt nach einem anderen Identity-Tm
Die Löschung ist verführerisch, weil dieselben sechs Zahlen vor einem cm wirklich totes Gewicht sind. Ein Content-Stream-Optimierer, der beide Operatoren gleich behandelt, schrumpft etliche Streams korrekt. Dann trifft er auf einen Generator, der ein Identity-Tm als Wagenrücklauf benutzt, und der Text wandert
Warum ist 1 0 0 1 0 0 Tm nicht immer ein No-op?
Die beiden Operatoren rechnen Verschiedenes. ISO 32000-1 §8.4.4 definiert cm als Verkettung seines Operanden mit der aktuellen Transformationsmatrix; multipliziert man eine beliebige Matrix mit der Identity, bekommt man dieselbe Matrix zurück, 1 0 0 1 0 0 cm lässt sich also überall löschen, wo es auftaucht. Tm ist eine Zuweisung. Nach §9.4.2 setzt es sowohl die Textmatrix als auch die Textzeilenmatrix auf seine Operanden und wirft weg, was sie hielten, ob es also etwas ändert, hängt ganz an den Operatoren davor
§9.4.1 sagt, BT startet beide Matrizen auf der Identity. Von dort bewegt fast alles innerhalb eines Textobjekts mindestens eine von ihnen. Td, TD, T* und ein Nicht-Identity-Tm verlegen die Textzeilenmatrix. Jeder textzeigende Operator (Tj, TJ, ' und ") schiebt die Textmatrix um die Breite der Glyphen weiter, die er gerade gemalt hat, und die letzten beiden starten vorher eine neue Zeile. Hat irgendeiner davon gelaufen, ist ein Identity-Tm ein echter Sprung zurück zum Ursprung. Der Invoice-Stream von oben baut auf diesem Sprung auf
Einen Stream von Hand zu verfolgen klärt das schnell. Treibt man das Invoice-Beispiel durch den Content-Stream-CTM- und Textmatrix-State-Tracker, zeigt der Record cm, das auf die CTM verkettet, während Tm beide Textmatrizen überschreibt — zwei verschiedene Update-Regeln hinter identischen Operanden
Wie PDF Library for Delphi entscheidet, welches Identity-Tm fällt
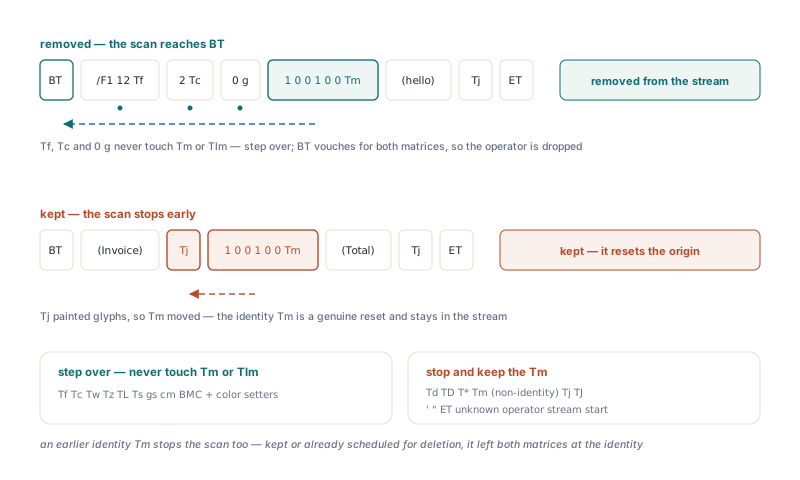
PDF Library for Delphi fällt jedes Identity-cm in ihrem Peephole-Durchlauf, und fällt ein Identity-Tm nur dann, wenn ein Rückwärtsscan von diesem Operator BT oder ein anderes Identity-Tm erreicht, bevor er auf etwas stößt, das die Textmatrizen bewegt haben könnte. Der Test für "Identity" ist numerisch: Der Operator braucht exakt sechs Zahlen-Operanden gleich 1, 0, 0, 1, 0, 0, 1.0 0 0 1.0 0 0 Tm qualifiziert sich also ebenfalls. Rückwärts laufend sortiert der Scan jeden Operator, dem er begegnet, in eine von zwei Gruppen:
- Stoppen und Tm behalten:
Td,TD,T*, ein Nicht-Identity-Tm,Tj,TJ,',",ET, jeder Operator, den der Parser nicht kennt, oder der Anfang des Streams - Weitersteppen und weiterscannen: Operatoren, die Textmatrix oder Textzeilenmatrix nie anfassen, etwa
Tf,Tc, Farb-Setter,gs, Marked-Content-Operatoren,Doundcm
Ein früheres Identity-Tm beendet den Scan zugunsten der Löschung, ob der Optimizer es behält oder es bereits zur Entfernung vorgemerkt hat. In beiden Fällen ließ es beide Matrizen auf der Identity, derselbe Zustand, den BT hinterlässt. Deshalb kollabieren drei Identity-Tm-Operatoren in Reihe direkt nach BT zu nichts
Die konservativen Stopps sind Absicht. Ein unbekannter Operator könnte eine Vendor-Erweiterung sein, die alles Mögliche tut, der Scan weigert sich also, über ihn hinweg zu schließen. Nach ET gibt es kein offenes Textobjekt, und ein dort sitzendes Identity-Tm hat kein BT, das für die Matrixwerte bürgt. Der Scan schaut sich außerdem immer nur einen Content-Stream an. Das zählt für Seiten, deren /Contents ein Array ist: PDF erlaubt, dass ein Textobjekt in einem Stream beginnt und im nächsten weiterläuft, eine Ebene also, die mitten in einem Textobjekt ohne eigenes BT beginnt, behält ihr Identity-Tm, selbst wenn die vorherige Ebene es redundant gemacht hätte
Wir halten das für die richtige Seite, auf der man sich irrt. Matrizen über Stream-Grenzen hinweg zu verfolgen oder unbekannte Operatoren zu simulieren würde vielleicht vierzehn Bytes unkomprimierten Texts pro exotischer Datei bergen. Es falsch zu machen verschiebt eine Glyphe auf einer gedruckten Rechnung. Kosten und Risiko sind nicht in derselben Liga
Ein Nebeneffekt ist wissenswert, weil er das Bild in der Ausgabe verändert. Derselbe Durchlauf entfernt auch Textobjekte mit nichts darin, BT 1 0 0 1 0 0 Tm ET verschwindet also komplett: Zuerst fällt das Identity-Tm, und das BT/ET-Paar, das es zurücklässt, ist leer
Den Optimizer auf einem Content-Stream-Schnipsel fahren
Der Optimierer arbeitet auf demselben geparsten TPDFContentProgram-Modell, das man nutzen würde, um Seitentext auf Instruktions-Ebene zu bearbeiten, wie im Artikel zum Charakter-zu-Content-Byte-Mapping. So lässt sich die Regel leicht an einem String ausprobieren, bevor man sie einem ganzen Dokument vertraut. Der Helfer unten parst einen decodierten Stream, fährt TPDFContentPeepholeOptimizer und gibt das Ergebnis mit einer Instruktion pro Zeile aus. CanonicalNumbers vor Parse zu setzen spiegelt den Save-Zeit-Durchlauf, der jede Zahl mit fixer Präzision umschreibt
uses
  PDFlibContentModel, PDFlibContentOptimize;

function OptimizeSnippet(const Source: AnsiString): AnsiString;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
begin
  Result := Source;
  Prog := TPDFContentProgram.Create;
  try
    Prog.CanonicalNumbers := True; // dieselbe Zahlenbehandlung wie der Save-Durchlauf
    if not Prog.Parse(Source) then
      Exit; // grober struktureller Schaden: die Bytes in Ruhe lassen
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run; // liefert die Anzahl der entfernten Instruktionen
    finally
      Optimizer.Free;
    end;
    Result := Prog.Emit; // eine Instruktion pro Zeile, mit #10 getrennt
  finally
    Prog.Free;
  end;
end;

// Entfernt: Tm direkt nach BT, die zweite von zwei Identity-Tm in Folge
//   OptimizeSnippet('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET')
// Behalten: Tm nach Td, nach Tj, nach einem Nicht-Identity-Tm oder außerhalb von BT
//   OptimizeSnippet('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET')
Treibt man den Invoice-Stream hindurch, überlebt das Identity-Tm, denn der Rückwärtsscan trifft lange vor BT auf ein Tj. Stellt man /F1 12 Tf, 2 Tc und 0 g zwischen BT und das Identity-Tm, fällt es trotzdem, keines davon fasst die Textmatrizen an. Der interessante Fall ist BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm. Er verliert exakt einen Operator. Das erste Identity-Tm macht die Bewegung rückgängig, die das Td gemacht hat, und nur das zweite ist redundant
Parse gibt nur bei grobem Schaden False zurück, etwa einem nicht terminierten String oder Dictionary. Unbekannte Operatoren parsen fein und bleiben im Programm, wo sie als harte Stopps für den Scan wirken
Wann läuft der Peephole-Optimizer tatsächlich?
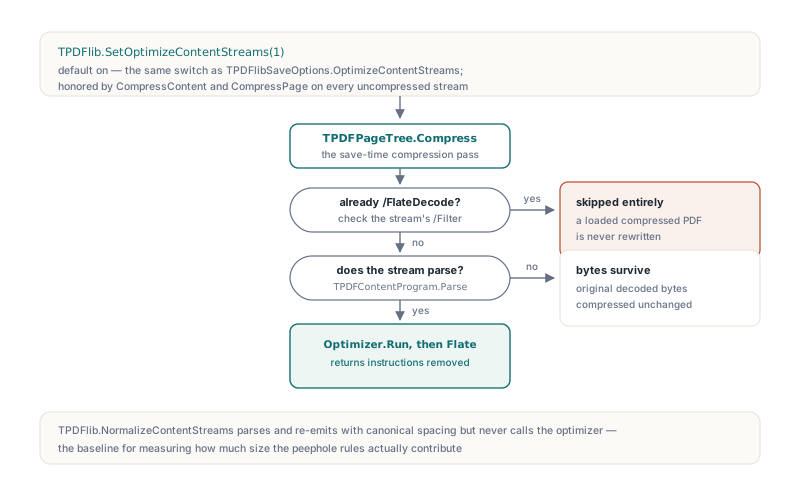
Der Optimizer läuft nur innerhalb des Kompressionsdurchlaufs, und nur auf Seiten-Content-Streams, die nicht bereits Flate-komprimiert sind. TPDFlib.SetOptimizeContentStreams(1) ist der Default, und derselbe Schalter erscheint als Feld OptimizeContentStreams von TPDFlibSaveOptions; CompressContent und CompressPage ehren ihn beide. Ein Stream, dessen /Filter bereits /FlateDecode ist, wird komplett übersprungen, eine typische komprimierte PDF zu laden und erneut zu speichern lässt ihre Operatoren also exakt, wie sie waren. Unkomprimiert gespeicherte Streams werden decodiert, optimiert und dann Flate-komprimiert. Scheitert ein Stream am Parsen, wird sein ursprünglicher decodierter Byte-Bestand unverändert komprimiert
var
  Lib: TPDFlib;
  Options: TPDFlibSaveOptions;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    // Unkomprimierte Streams laufen durch die Peephole-Regeln, dann durch Flate
    Lib.SetOptimizeContentStreams(1);
    Lib.CompressContent;
    Lib.SaveToFile('report-optimized.pdf');

    // Dieselbe Wahl über die gebündelten Save-Options; False meldet ab
    Options.CompressContent := True;
    Options.CompressFonts := True;
    Options.CompressImages := True;
    Options.Linearize := False;
    Options.KeepModDate := False;
    Options.OptimizeContentStreams := False;
    Options.GarbageCollect := False;
    Options.PackObjectStreams := True;
    Lib.SaveToFileOptions('report-plain.pdf', Options);
  finally
    Lib.Free;
  end;
end;
Den Default an lassen. Jede Transformation im Durchlauf ist ausgabeäquivalent, und die Identity-Matrix-Regel jagt ein Muster, das viele Generatoren emittieren, die jedes Textobjekt mit BT 1 0 0 1 0 0 Tm eröffnen. Abschalten lohnt sich vor allem, wenn man die eigene unkomprimierte Ausgabe gegen das Geschriebene diffen will, oder wenn man eine Basislinie braucht. Für diese Basislinie parst TPDFlib.NormalizeContentStreams Content und gibt ihn mit kanonischen Abständen und Zahlen wieder aus, ruft den Optimizer aber nie auf, der Größenabstand zwischen einem normalisierten und einem optimierten Save ist also das, was die Peephole-Regeln beisteuerten. Erwartung moderat, neben den größeren Gewinnen, die der Artikel zur PDF-Dateigrößen-Optimierung mit Font-Subsetting beschreibt
Ein Test, der eine Form deckt, definiert die Regel nicht
Ein Test, der BT 1 0 0 1 0 0 Tm (hello) Tj ET in einen Optimierer füttert und behauptet, kein Tm bleibe übrig, nagelt eine Form fest: Ein Identity-Tm direkt nach BT wird entfernt. Er sagt nichts über ein Identity-Tm nach Td oder nach angezeigtem Text. Diese eine Assertion als "Identity-Tm ist immer entfernbar" zu lesen ist ein leichter Fehler, und ein teurer, denn das Sample besteht in beide Richtungen. Tests für eine Regel wie diese brauchen die behaltenen Formen neben den entfernbaren aufgeschrieben
Der Helfer unten zählt die Tm-Operatoren, die überleben, und prüft dann eine Tabelle von Eingaben. ExpectTm gegen die Assertion Ihres Test-Frameworks tauschen; es ist nicht Teil der Bibliothek
uses
  SysUtils, PDFlibContentModel, PDFlibContentOps, PDFlibContentOptimize;

function TmCountAfterOptimize(const Source: AnsiString): Integer;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
  I: Integer;
begin
  Result := -1; // -1 signalisiert einen Parse-Fehler
  Prog := TPDFContentProgram.Create;
  try
    if not Prog.Parse(Source) then
      Exit;
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run;
    finally
      Optimizer.Free;
    end;
    Result := 0;
    for I := 0 to Prog.Count - 1 do
      if Prog[I].Op = coTextMatrix then
        Inc(Result);
  finally
    Prog.Free;
  end;
end;

// Ihr eigener Prüf-Helfer, hier vorgeschlagen; durch eine echte Assertion ersetzen
procedure ExpectTm(const Source: AnsiString; Expected: Integer);
var
  Actual: Integer;
begin
  Actual := TmCountAfterOptimize(Source);
  if Actual <> Expected then
    raise Exception.CreateFmt('%s: expected %d Tm, got %d',
      [string(Source), Expected, Actual]);
end;

procedure CheckIdentityTmRule;
begin
  // Entfernbare Formen
  ExpectTm('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET', 0);
  ExpectTm('BT 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  ExpectTm('BT /F1 12 Tf 2 Tc 0 g 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  // Formen, die das Identity-Tm behalten müssen
  ExpectTm('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET', 1);
  ExpectTm('BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 1);
  ExpectTm('BT 2 0 0 2 5 5 Tm (a) Tj 1 0 0 1 0 0 Tm (b) Tj ET', 2);
  ExpectTm('1 0 0 1 0 0 Tm (a) Tj', 1);    // kein umschließendes BT
  ExpectTm('BT ET 1 0 0 1 0 0 Tm', 1);     // nach ET
end;
Die letzten beiden Zeilen wirken albern, bis man sich erinnert, dass geschichtete /Contents-Arrays exakt solche Fragmente produzieren. Ein Stream, der mitten im Textobjekt beginnt, hat kein BT, und ein Identity-Tm nach ET gehört zu gar keinem Textobjekt. Beide bleiben. Das leere BT ET-Paar in der letzten Zeile entfernt die Empty-Text-Object-Regel, weshalb der Zähler Tm-Operatoren prüft statt ganze Strings zu vergleichen
Was die Regel aufgibt, ist das gelegentliche Identity-Tm mitten im Textobjekt, ein paar Bytes pro Seite, bevor Flate sie überhaupt sieht. Was sie kauft, ist eine Garantie, auf der das Design des Optimierers ruht: Keine Transformation im Durchlauf verändert die sichtbare Seite. Ein Größenoptimierer, der Text verschiebt, ist ein Rendering-Bug mit guter Kompressionsrate
Wer PDF-Content in Delphi oder C++Builder erzeugt oder nachbearbeitet, bekommt in der PDF Library for Delphi and C++Builder den Content-Stream-Parser, diesen Peephole-Durchlauf und die oben gezeigten Save-Optionen, dazu NormalizeContentStreams, um eine saubere, unoptimierte Basislinie zum Vergleichen zu erzeugen