Escapen Sie einen Kundenkommentar ordentlich, sodass <b>urgent</b> als <b>urgent</b> in Ihr HTML-Template geht, geben ihn einem Renderer, der das Markup zweimal parst, und das PDF kann mit dem Wort urgent in Fettdruck zurückkommen. Das Escaping war korrekt. Der Renderer hat es pro Durchlauf einmal dekodiert. Jeder HTML-zu-PDF-Pfad, der parst, das Ergebnis als HTML zurückschreibt und erneut parst, muss Entities über die gesamte Reise genau einmal dekodieren
Die Helpdesk-Version dieser Geschichte ist gewöhnlich. Tickets werden nach PDF exportiert, der Kundenkommentar sitzt in einem <p>, und jemand tippt spitze Klammern in das Kommentarfeld. Ein unbekannter Tag-Name verschwindet schlicht von der Seite. Ein escapeter Anker wird zu einer klickbaren Link-Annotation in einem Dokument, dem Ihr Personal vertraut. Die Datei ist gültig und öffnet überall; sie sagt nur etwas anderes als die Daten
Wo escapeter Text zurück zu Markup wird
Escapeter Text wird zu Markup an dem Punkt, an dem ein Zweipass-Renderer bereits dekodierten Text wieder als HTML zurückschreibt, ohne ihn erneut zu escapen. Was auch immer der erste Parse dekodiert hat, ist danach lebende Syntax für den zweiten Parse
Die beiden Durchläufe in DrawHTMLText und DrawHTMLTextBox der PDF Library for Delphi (PDFlibPas) existieren aus gutem Grund. Der erste Parse teilt die Eingabe in Tags und Wörter. Der Renderer löst dann die Stylesheet-Kaskade auf: Regeln aus <style>-Blöcken werden gegen jeden Tag gematcht, mit Inline-style-Attributen verschmolzen, und die ganze Elementliste wird als ein normalisierter HTML-String zurückgeschrieben, in dem jeder Tag seinen finalen Style trägt. Der Layout-Durchlauf parst diesen String. Selektor-Matching, Flexbox, Grid und der Rest der CSS-Unterstützung, beschrieben in Flexbox, CSS Grid und Fußnoten-Layout im PDFlibPas-HTML-Rendering, hängen alle an diesem Zwischenschritt
Die Gefahr sitzt darin, wie Wörter zurückkommen. Tags lassen sich aus ihrer Quellform zurückschreiben, aber Wörter liegen als dekodierter Text vor, denn das ist es, was der Zeilenumbruch misst. Hängt man das Wort aus <unsafe> unverändert an den normalisierten String an, kommt <unsafe> als Element beim zweiten Parse an. Ein Design, das einmal dekodiert, muss auch drei kleinere Lecks schließen:
- Fehlt
&in der dekodierten Menge, wirdR&Dwörtlich gedruckt, und es gibt gar keinen Weg, die Schreibweise<als Text auf die Seite zu bringen - Ersetzt die Zeichenstufe
erneut, nachdem das Parsen abgeschlossen ist, verschwindet eine wörtliche Entity-Schreibweise im allerletzten Moment - Escapet ein HTML-Produzent im Vornherein, etwa ein Markdown-Konverter oder ein Dataset-Exporter, nur die spitzen Klammern, wird eine Entity-Schreibweise in einem Code-Beispiel oder einem Zellenwert zu Markup dekodiert
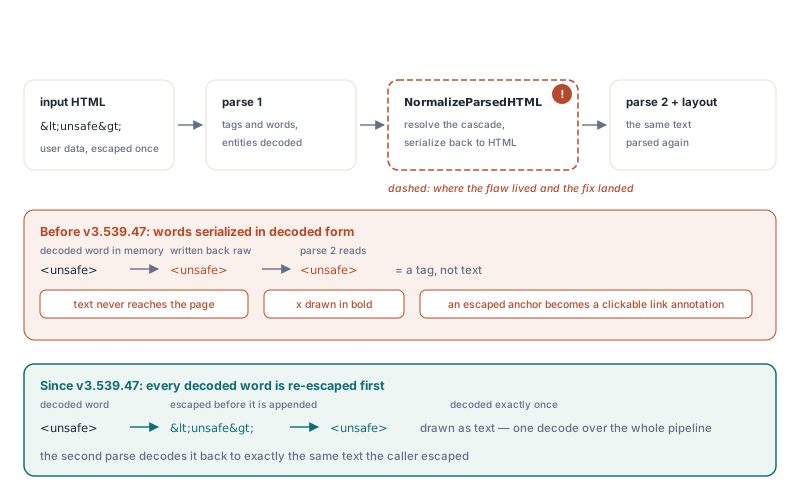
Die Tabelle unten listet, was für eine Handvoll Eingaben auf der Seite ankommt, und vergleicht einen naiven Zweipass-Renderer mit der PDFlibPas-Pipeline
| Eingabe, die den Renderer erreicht | Naiver Zweipass-Renderer | PDFlibPas |
|---|---|---|
<unsafe> | Als Tag geparst, der Text erreicht die Seite nie | <unsafe> als Text gezeichnet |
<b>x</b> | x fett gezeichnet | <b>x</b> als Text gezeichnet |
R&D | R&D wörtlich gedruckt | R&D |
&lt; | &lt; wörtlich gedruckt | < |
Markdown-Code-Span mit | Ein geschütztes Leerzeichen | als Text gezeichnet |
Dataset-Zellenwert < | < | < |
Wie dekodiert die PDF Library for Delphi jedes Entity genau einmal?
Die PDF Library for Delphi dekodiert jedes Entity genau einmal, indem sie drei Regeln zusammen befolgt: Der Parser dekodiert & zuletzt, die Zeichenstufe dekodiert nichts, und jede Stelle, die dekodierte Wörter zurück in HTML verwandelt, escapet sie zuerst. Lässt man eine der drei fallen, kippt eine der Tabellenzeilen oben in die naive Spalte
Beginnen Sie damit, was dekodiert wird. In Textinhalt erkennt der Parser <, >, & und . Numerische Referenzen wie A und benannte Entities wie " bleiben wörtlicher Text. Diese kurze Liste entscheidet, wie Sie Ihre eigene Eingabe escapen sollten, worauf es weiter unten noch einmal zurückkommt
Die Reihenfolge im Dekoder zählt sogar innerhalb eines einzelnen Durchlaufs. Dekodiert man & zuerst, wird aus der Eingabe &lt; ein <, und die allerächste Ersetzung macht daraus <: eine Doppel-Dekodierung ohne jeden zweiten Parse. Der 8-Bit-Wortpfad ersetzt daher <, > und zuerst und & zuletzt, das kaufmännische Und, das er produziert, wird also nie wieder angeschaut. Der UTF-16-Wortpfad nimmt einen anderen Weg zum selben Ergebnis — einen einzigen Links-nach-rechts-Scan in Zweibyte-Schritten, der jeden Treffer an Ort und Stelle umschreibt und daran vorbeizieht
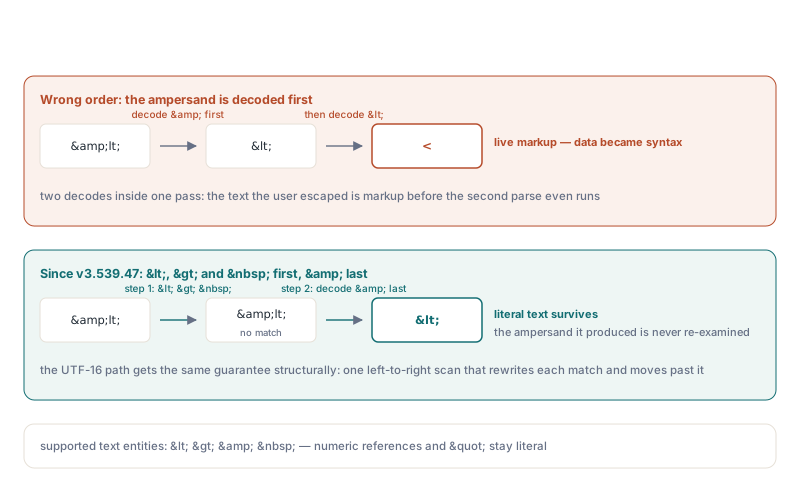
Die Zeichenstufe bekommt keine späte -Ersetzung. Ein Wort, das den Zeilenumbruch erreicht, ist finaler Text, und Dekodieren wohnt im Parser und nirgendwo sonst
Die Grenzregel trägt das meiste Gewicht. Schreibt der Renderer das normalisierte HTML, escapet er &, < und > in jedem dekodierten Wort, bevor er es anhängt, und der zweite Parse dekodiert es zu denselben Zeichen zurück. Netto-Effekt über beide Durchläufe: eine Dekodierung. Der Continuation-String, den DrawHTMLTextBox zurückliefert, folgt derselben Regel. Wörter, die nicht hineinpassten, werden escapet, bevor sie in den Rest wandern, und der Rest des Rests wird aus dem normalisierten HTML kopiert, das bereits escapet ist. Eine Box, die alles nimmt, liefert einen leeren String
Warum kann UTF-16BE-Escaping kein Replace auf Byte-Ebene verwenden?
UTF-16BE-Escaping kann keinen Replace auf Byte-Ebene verwenden, weil die zwei Bytes eines kaufmännischen Unds zwei nicht zusammengehörige Zeichen überbrücken können. Die ganze 16-Bit-Code-Einheit ist die einzige sichere Arbeitseinheit
Der Renderer hält Unicode-Wörter als Big-Endian-UTF-16, gepackt in Byte-Strings, hohes Byte zuerst, ein kaufmännisches Und ist also 00 26. Nehmen Sie U+0100 (Lateinischer Großbuchstabe A mit Makron, Bytes 01 00), gefolgt von U+2603 (der Schneemann, Bytes 26 03). Der Buffer liest sich 01 00 26 03, und die Bytes zwei und drei buchstabieren 00 26. Eine Bytesuche nach #0'&' findet ein kaufmännisches Und, das kein Zeichen enthält, fügt & mitten zwischen zwei Code Points ein und verschiebt jedes spätere Zeichen um ein Byte
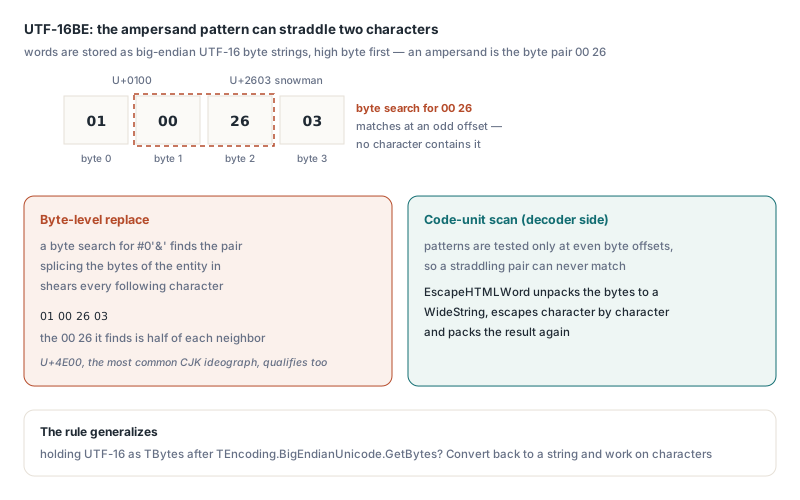
Das ist keine exotische Ecke. Jedes Zeichen, dessen niedriges Byte null ist, kann die erste Hälfte liefern, und U+4E00, eines der häufigsten CJK-Ideogramme, ist so ein Zeichen. Die spitzen Klammern liegen auf dieselbe Weise offen: 00 3C und 00 3E tauchen auf, sobald auf so ein Zeichen eines aus U+3C00 bis U+3EFF aus CJK Extension A folgt. PDFlibPas escapet Unicode-Wörter daher, indem es sie zu einem WideString entpackt, Zeichen für Zeichen escapet und das Ergebnis wieder packt. Der Dekoder ist aus dem passenden Grund sicher: Er testet Muster nur an geraden Offsets
Ihr eigener Code kann an dieselbe Wand laufen. Sobald UTF-16-Text in TBytes liegt, etwa nach TEncoding.BigEndianUnicode.GetBytes, ist eine Suche nach Byte-Mustern ein Bug, der auf das richtige Zeichenpaar wartet. Konvertieren Sie zurück zu einem String und arbeiten Sie auf Zeichen
Markdown-Code und Dataset-Zellen: das kaufmännische Und zuerst
Beide HTML-Produzenten in PDFlibPas, der Markdown-Konverter und der Dataset-Exporter, escapen das kaufmännische Und vor den spitzen Klammern, sodass die eine Dekodierung im Renderer den Originaltext Byte für Byte wiederherstellt
In MarkdownToHTML mappen Inline-Code-Spans und fenced oder eingerückte Code-Blöcke & zu &, < zu < und > zu >. Leerzeichen werden zu , ein Tab zu vieren davon, was die Einrückung intakt hält. Gewöhnliche Prosa escapet nur die spitzen Klammern: Rohes HTML, in Prosa getippt, kann keine Tags injizieren, während ein Autor, der absichtlich & schreibt, weiterhin ein kaufmännisches Und bekommt, so wie Markdown-Autoren es erwarten. DrawMarkdownText und DrawMarkdownTextBox fahren dieselbe Konvertierung, ein Code-Block erscheint also exakt wie getippt:
uses
System.SysUtils, PDFlibrary;
procedure RenderCodeSample;
var
Lib: TPDFlib;
Md, Html: WideString;
begin
Md := 'Comparison helper:' + sLineBreak + sLineBreak +
'```' + sLineBreak +
'if (A < B) and (Flags <> 0) then' + sLineBreak +
' WriteLn(''<tag> & R&D'');' + sLineBreak +
'```';
Lib := TPDFlib.Create;
try
// HTML ansehen: im Code wird '&' zu '&' und '<' zu '<'
Html := Lib.MarkdownToHTML(Md);
Lib.SetOrigin(1); // Ursprung oben links, Y wächst nach unten
Lib.SetMeasurementUnits(0); // Punkte
// Die Seite zeigt den Code exakt wie getippt, Entity-Schreibweisen eingeschlossen
Lib.DrawMarkdownText(50, 50, 495, Md);
Lib.SaveToFile('code-sample.pdf');
finally
Lib.Free;
end;
end;Der Dataset-Exporter ist der Ort des verführenden Shortcuts. Würde ein Renderer & nicht dekodieren, würde das Escapen des kaufmännischen Unds in jeder Zelle, die eines enthält, & drucken — nur die spitzen Klammern zu escapen sieht also wie die freundlichere Wahl aus. An der ersten Zelle, deren Wert zufällig < enthält, zerfällt das, sie kommt dann als < auf die Seite. Weil der Renderer & doch dekodiert, escapet der Exporter hinter PDFlibExportDataSet & zuerst, und ein Wert wie R&D < & landet wörtlich im PDF. Den Rest dieses Exporters deckt einen TDataSet nach PDF-Report in Delphi exportieren ab
Warum zuerst, und nicht einfach irgendwo in der Kette? Escapet man < zuerst, entsteht <. Escapet man & als Zweites, wird daraus &lt;, was eine korrekte Einfach-Dekodierung als < statt als < anzeigt. Eine sequenzielle Replace-Kette funktioniert nur, wenn das Escape-Zeichen selbst vor jedem Schritt behandelt wird, der es einführt
Wie escapen Sie nicht vertrauenswürdigen Text für DrawHTMLTextBox?
Escapen Sie nicht vertrauenswürdigen Textinhalt für PDFlibPas, indem Sie &, dann <, dann > ersetzen, genau einmal, und halten Sie nicht vertrauenswürdige Daten komplett aus Attributwerten heraus. Der Helfer unten ist Ihrer zum Ergänzen; er ist schlichter RTL-Code:
uses
System.SysUtils, PDFlibrary;
// Eigener Helfer (nicht Teil der Bibliothek): escapet nicht vertrauenswürdigen
// Text für PDFlibPas-HTML-Textinhalt. '&' muss zuerst ersetzt werden,
// sonst wird das kaufmännische Und in einem frisch erzeugten '<'
// ein zweites Mal escaped
function EscapeHTMLText(const S: string): string;
begin
Result := StringReplace(S, '&', '&', [rfReplaceAll]);
Result := StringReplace(Result, '<', '<', [rfReplaceAll]);
Result := StringReplace(Result, '>', '>', [rfReplaceAll]);
end;
procedure RenderTicket(const CustomerComment: string);
var
Lib: TPDFlib;
Html: WideString;
begin
Lib := TPDFlib.Create;
try
Lib.SetOrigin(1);
Lib.SetMeasurementUnits(0);
Html := '<p><b>Customer comment</b></p>' +
'<p>' + EscapeHTMLText(CustomerComment) + '</p>';
Lib.DrawHTMLText(50, 50, 495, Html);
Lib.SaveToFile('ticket.pdf');
finally
Lib.Free;
end;
end;Füttern Sie ihn mit dem Kommentar Try <a href="https://example.com">this</a> & <b>, und die Seite zeigt diese Zeichen eins zu eins. Unter einem Renderer, der zweimal dekodiert, wird aus derselben escapeten Eingabe eine lebende Link-Annotation. Das ist der Schritt vom kosmetischen Glitch zum Sicherheitsproblem: Ein Ticket-Kommentar sollte nie in der Lage sein, in ein PDF, das zu Ihrem eigenen Personal geht, eine klickbare URL zu pflanzen
Beachten Sie, was der Helfer unangetastet lässt. Allgemeine Escaper verwandeln auch " in " und ' in ', was für einen Browser richtig und hier falsch ist — die PDFlibPas-Text-Dekodierung kennt nur die vier oben gelisteten Entities, die beiden würden also wörtlich als " und ' gedruckt. Wiederverwenden Sie keinen Browser-Escaper dafür. Anführungszeichen sind in Textinhalt harmlos; sie zählen nur innerhalb von Attributwerten, und der Renderer dekodiert in Attributen überhaupt keine Entities. Für Attribute ist eine Regel lieber als ein schlaueres Escaping, denn dort wird ohnehin kein Escaping-Schema geprüft: Halten Sie Nutzwerte aus href, src und style heraus. Muss ein Link-Ziel wirklich aus Nutzereingaben kommen, validieren Sie es selbst gegen eine Allow-Liste von Schemata und Zeichen und weisen alles zurück, das Anführungszeichen oder spitze Klammern enthält
Zwei Gewohnheiten folgen direkt aus der Einmal-Dekodierung:
- Escapen Sie stets
&. Lassen Sie es aus, erscheint Nutzertext mit<als<— harmlos, aber nicht was der Nutzer tippte - Escapen Sie an genau einer Stelle. Text, der durch zwei Escaper läuft, rendert
<als die sichtbare Schreibweise<; suchen Sie also die eine Stelle, an der Ihre Daten in den HTML-String gelangen, und escapen Sie dort
Paginieren mit LeftOverText, ohne Escapes zu brechen
DrawHTMLTextBox liefert das HTML zurück, das nicht hineinpasste, meist LeftOverText genannt, und dieser Rest hält wörtliche Entity-Schreibweisen und escapete spitze Klammern intakt, wenn er in die nächste Box wandert. Reichen Sie ihn exakt so weiter, wie Sie ihn empfangen haben
const
  BoxLeft = 50;
  BoxTop = 50;
  BoxWidth = 495;    // bemessen für eine A4-Seite in Punkten
  BoxHeight = 740;
  MaxPages = 500;    // eigene Sicherheitsgrenze

procedure RenderLongHTML(Lib: TPDFlib; const Html: WideString);
var
  Rest: WideString;
  Pages: Integer;
begin
  Lib.SetOrigin(1);
  Lib.SetMeasurementUnits(0);
  Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Html);
  Pages := 1;
  while (Rest <> '') and (Pages < MaxPages) do
  begin
    Lib.NewPage;
    Inc(Pages);
    // Der Rest ist bereits escaped Engine-HTML: nie escapen oder unescapen
    Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Rest);
  end;
  if Rest <> '' then
    raise Exception.CreateFmt('Content still left after %d pages', [MaxPages]);
end;
Behandeln Sie den Rest als opak. Es ist normalisiertes HTML mit Styles, die bereits auf jeden Tag aufgelöst sind; es durch Ihren eigenen Escaper zu jagen verwandelt jedes < in &lt;, und es zu dekodieren überreicht der nächsten Box lebende Tags. Frischen Nutzertext hineinzusplicken hat dieselben zwei Fehlermodi. Das Seitenlimit kostet einen Vergleich: Kann ein Element die Box nie füllen, hat eine unbegrenzte Schleife keinen natürlichen Ausgang
Markdown hat seine eigene Fortsetzung. DrawMarkdownTextBox liefert einen Rest, der mit einem Marker-Kommentar beginnt, der den Markdown-Einstiegspunkten sagt, beim nächsten Aufruf die Konvertierung zu überspringen. Reichen Sie ihn an DrawMarkdownTextBox oder DrawMarkdownText zurück, genauso, wie Sie LeftOverText an DrawHTMLTextBox zurückgeben würden. Ein Markdown-Rest gehört zu den Markdown-Einstiegspunkten, halten Sie ihn also auf dieser Seite und leiten nur DrawHTMLTextBox-Reste durch die HTML-Aufrufe
Die Form hinter all dem — parsen, zurück in dieselbe Syntax schreiben, erneut parsen — taucht auch in Template-Engines, HTML-Sanitizern und Markdown-zu-HTML-zu-PDF-Ketten auf, und der Fehlschlag kommt aus zwei Richtungen. Zu wenig Re-Kodierung verwandelt Daten in Syntax. Zu viel Kodierung, oder ein Dekoder, der zweimal läuft, zeigt dem Leser Entity-Schreibweisen oder frisst sie. Nur eine Richtung zu flicken neigt dazu, die andere zu brechen, weshalb der PDFlibPas-Renderer &-Dekodierung, das Zuletzt-Dekodieren, keine späte Dekodierung und Re-Escaping an jeder Grenze als ein einziges Paket behandelt. Die Export-Richtung folgt derselben Regel in PDF zu Markdown- und DOCX-Semantik-Export aus Delphi, wo jedes wörtliche Zeichen exakt einmal für die Ziel-Syntax escapet wird
HTML- und Markdown-Zeichnung, der Dataset-Report-Exporter und der Rest der Layout-Engine kommen als nativer Pascal-Quelltext in der PDF Library for Delphi, für Delphi wie für Free Pascal. Editionen, Plattformabdeckung und der Trial-Download sind auf der PDF Library for Delphi-Produktseite gelistet