Ein Lageretikett speichert den Empfänger Müller GmbH, Köln als UTF-8 in einem Data-Matrix-Symbol, und jeder Handscanner in der Halle liest es als Müller GmbH, Köln zurück. Setzen Sie die PDFlibPas-Eigenschaft BarcodePayloadEncoding auf bpeUTF8WithECI, stellt dies einen ECI-000026-Marker vor die Daten, der Data-Matrix- und PDF417-Lesern sagt, die Bytes als UTF-8 zu dekodieren
Warum wird eine UTF-8-Payload als Müller dekodiert?
Das Symbol trägt keine Zeichensatz-Deklaration, also greift der Reader auf den Default-Single-Byte-Zeichensatz der Symbologie zurück, der bei Data Matrix ISO-8859-1 ist. Ein UTF-8-ü besteht aus den zwei Bytes C3 BC, die ISO-8859-1 als à und ¼ abbildet; ö wird auf dieselbe Weise zu ö. Die Bytes selbst sind intakt. Extended Channel Interpretation ist die Zeichensatz-Deklaration der Barcode-Welt. Die AIM-ECI-Registry vergibt Nummern an Zeichensätze, darunter 000026 für UTF-8, und ein Symbol, das mit einem ECI-Designator beginnt, sagt einem konformen Reader, alles danach in diesem Zeichensatz zu dekodieren. Für das Symbol ist der Designator gewöhnliche Daten. Er belegt in beiden hier besprochenen Symbologien zwei Codewörter, zählt gegen die Kapazität und genießt dieselbe Reed-Solomon-Fehlerkorrektur für 2D-Barcodes wie die Payload dahinter
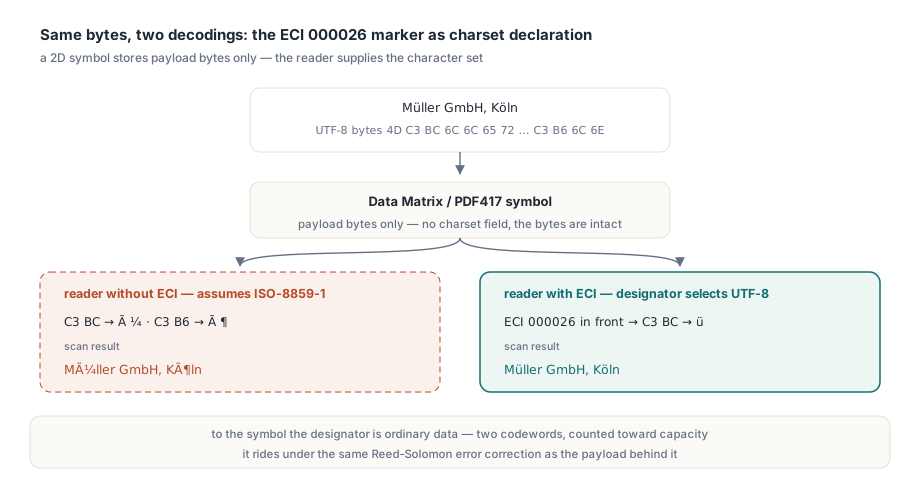
ECI-Codewort-Positionen in Data Matrix und PDF417
Jede Symbologie hat einen festen Slot für den Marker. Setzt man ihn anderswo hin, dekodiert das Symbol entweder gar nicht oder mit Datenmüll am Anfang:
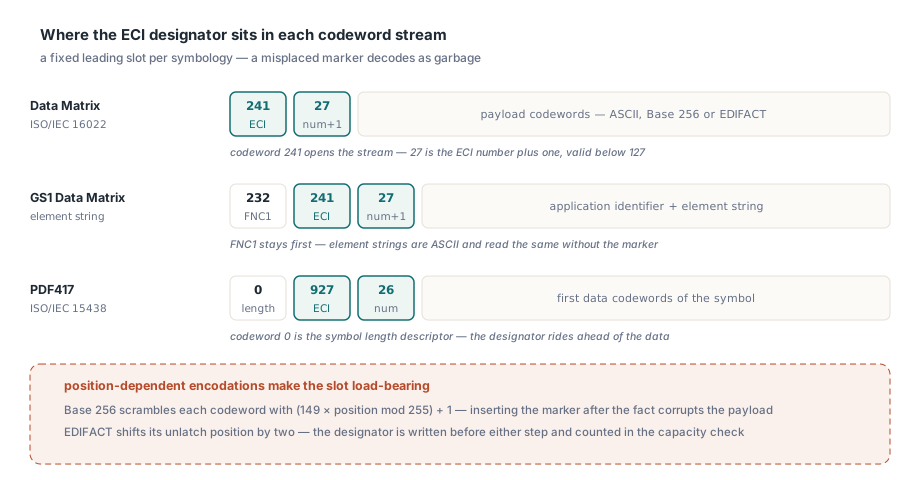
- Data Matrix (ISO/IEC 16022): Codewort 241, dann die ECI-Nummer plus eins in der Ein-Codewort-Form für Werte unter 127, also 27 für UTF-8. Der Designator eröffnet den Datenstrom
- GS1 Data Matrix: FNC1 (Codewort 232) muss in erster Position bleiben, deshalb setzt PDFlibPas den Marker direkt dahinter, wenn Sie einen anfordern; GS1-Elementstrings stammen aus einer ASCII-Teilmenge und lesen sich auch ohne ihn genauso
- PDF417 (ISO/IEC 15438): Codewort 0 ist der Symbol-Längendeskriptor, und der Marker folgt als Codewörter 927 und 26, vor dem ersten Daten-Codewort
Base 256 ist der harte Fall. Diese Encodierung, der kompakte Data-Matrix-Modus für beliebige Bytes, verwürfelt jedes Codewort mit einem pseudozufälligen Wert, der aus seiner absoluten Position im Symbol abgeleitet wird, (149 × position mod 255) + 1. Hängt man den Marker nach dem Verwürfeln an, wurde jedes Byte dahinter für eine Position zwei Stellen früher verwürfelt, als der Reader sie sieht, also unscrambelt die gesamte Payload zu falschen Werten. Die EDIFACT-Encodierung hat eine mildere Variante derselben Abhängigkeit — ihre Unlatch-Position verschiebt sich um zwei, wenn der Marker nach vorn kommt. PDFlibPas schreibt den Marker in den Codewort-Strom, bevor einer der beiden Schritte läuft, und die Kapazitätsprüfung, die die Symbolgröße wählt, zählt ihn bereits ein. Der Etikettencode für beide Symbologien:
uses
  SysUtils, PDFlibrary;

procedure PrintConsigneeLabel(const FileName: string);
var
  Pdf: TPDFlib;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.NewDocument;                                // erzeugt Seite 1 und wählt sie aus
    Pdf.SetPageSize('A4');
    Pdf.SetMeasurementUnits(1);                     // Millimeter
    Pdf.SetOrigin(1);                               // Top wird ab der oberen Kante gemessen

    Pdf.BarcodePayloadEncoding := bpeUTF8WithECI;   // UTF-8-Bytes + ECI 000026
    if Pdf.DrawDataMatrixSymbol(20, 20, 0.5, 'Müller GmbH, Köln',
      1,      // Encoding: 1 = ASCII-Encodierung
      0,      // SymbolSize: 0 = erste Größe der Tabelle, die passt
      100) <> 1 then                                // normale Orientierung, Default-Ruhezone von 1 Modul
      raise Exception.CreateFmt('Data Matrix failed (%d)', [Pdf.LastErrorCode]);

    if Pdf.DrawPDF417SymbolEx(20, 50, 'Zustellung: Müller GmbH, Köln',
      0, 0, 0,  // Orientierung, Spalten, Zeilen: automatisch
      -1,       // Fehlerlevel automatisch
      0.3, 3.0) <> 1 then
      raise Exception.Create('PDF417 failed');

    // Ein ECI-fähiger Scanner sollte für beide Symbole den deutschen Text zurückgeben
    Pdf.BarcodePayloadEncoding := bpeSystemANSI;    // zurück zum Default
    Pdf.SaveToFile(FileName);
  finally
    Pdf.Free;
  end;
end;
NewDocument erzeugt Seite 1 bereits und wählt sie aus, daher landen die Symbole ohne einen NewPage-Aufruf auf der ersten Seite. SetOrigin(1) verlegt den Ursprung in die linke obere Ecke, wodurch Top der Abstand der oberen Symbolkante vom Seitenanfang ist. Beim Default-Ursprung unten links legt ein Top von 10 mm diese Kante 10 mm über die Blattunterkante, und ein 11-mm-Symbol hängt heraus. DrawDataMatrixSymbol gibt bei Erfolg 1 zurück. Für Daten, die es nicht encodieren kann — eine Payload, die auch das größte Symbol sprengt, sobald der Marker mitgezählt ist, oder die angeforderte feste Größe — gibt es 0 zurück, setzt LastErrorCode auf 302 und zeichnet nichts, deshalb behandelt das Beispiel alles andere als 1 als Fehler
Soll jedes Etikett den ECI-Marker tragen?
Nein, und der Default bildet das ab. BarcodePayloadEncoding nimmt drei Werte an, und jeder passt zu einer anderen Reader-Gruppe:
bpeSystemANSI(der Default) wandelt den Text über die System-ANSI-Codepage und schreibt keinen Marker, was Etikettlayouts erwarten, die mit den PDFlibPas-Funktionen für QR, PDF417 und Data Matrix gebaut wurdenbpeUTF8schreibt UTF-8-Bytes ohne Marker, für geschlossene Systeme, in denen die eigene Software den Barcode liest und ohnehin UTF-8 annimmtbpeUTF8WithECIschreibt UTF-8-Bytes und versieht sie mit ECI 000026
Der Preis für das Etikettieren von allem ist die Reader-Unterstützung. ECI-Verarbeitung ist auf vielen Scannern eine Konfigurationsoption, und je nach Einstellung weist ein Gerät das Symbol zurück oder reicht den Designator als Text an den Host durch: Die AIM-Konvention ist ein Backslash plus sechs Ziffern, die Anwendung empfängt also \000026Müller GmbH, Köln. Schalten Sie den Marker pro Symbol ein, für Payloads mit Nicht-ASCII-Text, und führen Sie das zusammen mit der Scanner-Profiländerung ein. Eine Single-Byte-Payload bleibt eine legitime Wahl, solange jeder Name in die Codepage passt, die Ihre Reader annehmen. ü ist in Windows-1252 wie in ISO-8859-1 das Byte FC, also dekodiert eine deutsche Adresse, die unter bpeSystemANSI auf einem westeuropäischen Windows-System geschrieben wurde, auch auf einem Data-Matrix-Reader korrekt, der noch nie von ECI gehört hat. Japanischer Text hat einen solchen Fallback nicht
Symbolgröße: automatische Wahl, feste Templates und Rechtecke
Die zwei Codewörter des Markers wirken selten allein. In der ASCII-Encodierung speichert die Empfängerzeile unter bpeSystemANSI ü und ö als Einzelbytes über 127 mit je zwei Codewörtern, und die ganze Zeile kostet 19 Codewörter, was in ein 20×20-Symbol mit seinen 22 Daten-Codewörtern passt. Als UTF-8 werden aus den zwei Buchstaben vier High-Bytes, und die Zeile kostet 23. Der Marker bringt sie auf 25. Das braucht 22×22, und der Schritt geht allein auf die UTF-8-Bytes zurück, denn 23 sprengt 20×20 bereits. Ein Template, das SymbolSize auf 9 (20×20) fixiert, bekommt 0 und Fehler 302 von DrawDataMatrixSymbol, sobald sich die Encodierung ändert, und im Barcode-Slot wird nichts gezeichnet
Die automatische Größenwahl kann die Form ändern. Mit SymbolSize auf 0 läuft PDFlibPas die Größenliste aus ISO/IEC 16022 der Reihe nach durch und nimmt den ersten Eintrag, dessen Datenkapazität den Strom fasst. Die sechs rechteckigen Größen stehen in dieser Liste zwischen den Quadraten. Eine Payload, die ein 26×26-Symbol füllte (44 Daten-Codewörter), braucht mit dem Marker 46, und der nächste Eintrag, der 46 fasst, ist 16×48 mit 49, vor 32×32 mit 62. Bei 0,5 mm pro Modul wird aus einem 13-mm-Quadrat ein 8 × 24 mm Streifen. Ein volles 22×22 läuft genauso: 30 Codewörter plus zwei landen in 16×36. Kleine Payloads bleiben quadratisch — drei Codewörter, die 10×10 füllten, werden zu fünf und passen in 12×12, das in der Liste vor 8×18 steht. Reserviert das Etikett einen quadratischen Slot, fixieren Sie SymbolSize auf das Quadrat, das Sie sich leisten können (16 für 32×32), und lassen Sie Fehler 302 melden, wann ein Name dafür zu lang ist; die automatische Größenwahl passt zu Layouts, die beide Formen verkraften
PDF417 wächst nach einer anderen Regel. Mit ErrorLevel auf -1 plant der Encoder die Fehlerkorrektur anhand der empfohlenen Mindeststufen aus ISO/IEC 15438, die bei 41, 161 und 321 Codewörtern ansteigen, Längendeskriptor eingerechnet. Ein 39-Codewort-Strom wird mit dem Marker zu 41, die Mindeststufe springt von 2 auf 3, und der geplante Fehlerkorrekturblock wächst von 8 auf 16 Codewörter. Das sind zehn Codewörter extra. Mit automatischen Spalten und Zeilen legt der Encoder das Rechteck aus dieser größeren Summe an, also gewinnt eine Payload knapp unter einer Stufe mehr Fläche, als ihre zwei Marker-Codewörter vermuten lassen
Welche Encodierung hält eine UTF-8-Data-Matrix klein?
Vergleichen Sie die beiden Kosten direkt. Die ASCII-Encodierung packt ein Ziffernpaar in ein Codewort und reinen ASCII-Text mit einem pro Zeichen, aber jedes Byte über 127 kostet zwei: einen Upper Shift (235) und das Byte minus 127. Base 256 zahlt einmal Latch und Längenfeld — ein Längencodewort bis 249 Bytes, darüber zwei — und danach ein Codewort pro Byte, ohne Ziffernpackung. Bei Text ohne Ziffernläufe gewinnt Base 256, sobald eine Payload drei High-Bytes hält. Die Müller-Zeile tut das bereits, mit 21 gegen 23 Codewörtern. Lange Zahlenläufe schieben die Waage zurück Richtung ASCII, weil jedes Ziffernpaar dort ein Codewort spart. Die Hilfsfunktion unten zählt beide Kosten und zeichnet mit dem günstigeren Modus; pures ASCII bekommt gar keinen Marker, weil es unter jedem Zeichensatz identisch liest:
// Eine Data Matrix für Unicode-Text mit der günstigeren Encodierung zeichnen
function DrawUnicodeDataMatrix(Pdf: TPDFlib; Left, Top, ModuleSize: Double;
  const Text: WideString): Integer;
var
  Bytes: UTF8String;
  I, HighBytes, AsciiCost, Base256Cost, Mode: Integer;
  Saved: TPDFlibBarcodePayloadEncoding;
begin
  Bytes := UTF8Encode(Text);
  HighBytes := 0;
  AsciiCost := 0;
  I := 1;
  while I <= Length(Bytes) do
  begin
    if (I < Length(Bytes)) and (Bytes[I] >= '0') and (Bytes[I] <= '9') and
       (Bytes[I + 1] >= '0') and (Bytes[I + 1] <= '9') then
    begin
      Inc(AsciiCost);                    // Ziffernpaar: ein Codewort
      Inc(I, 2);
      Continue;
    end;
    if Ord(Bytes[I]) > 127 then
    begin
      Inc(HighBytes);
      Inc(AsciiCost, 2);                 // Upper Shift + (Byte - 127)
    end
    else
      Inc(AsciiCost);
    Inc(I);
  end;
  if Length(Bytes) <= 249 then
    Base256Cost := Length(Bytes) + 2     // Latch + ein Längencodewort
  else
    Base256Cost := Length(Bytes) + 3;    // Latch + zwei Längencodewörter

  Saved := Pdf.BarcodePayloadEncoding;
  try
    if HighBytes = 0 then
    begin
      Pdf.BarcodePayloadEncoding := bpeSystemANSI;  // pures ASCII: kein Marker
      Mode := 1;
    end
    else
    begin
      Pdf.BarcodePayloadEncoding := bpeUTF8WithECI;
      if Base256Cost < AsciiCost then
        Mode := 3                        // Base 256
      else
        Mode := 1;                       // ASCII
    end;
    Result := Pdf.DrawDataMatrixSymbol(Left, Top, ModuleSize, Text, Mode, 0, 100);
  finally
    Pdf.BarcodePayloadEncoding := Saved;
  end;
end;
Für 東京都千代田区 ist die UTF-8-Form 21 Bytes groß, alle über 127. Mit dem Marker braucht Base 256 25 Daten-Codewörter und die ASCII-Encodierung 44, was laut Kapazitätstabelle einem 22×22-Symbol gegenüber einem 26×26-Symbol bei gleicher Modulgröße entspricht. Dieses 26×26 ist voll. Ein Codewort mehr, und es springt auf 16×48. GS1-Payloads (Modus 7) bleiben außerhalb der Hilfsfunktion, weil ihre Elementstrings ASCII sind. QR-Codes übergeben ihren Datenmodus über das EncodeOptions-Argument von DrawQRCode, und Aztec-Symbole, die PDFlibPas zeichnet, tragen automatisch ein ECI-26-Flag, wann immer die Payload-Bytes gültiges UTF-8 mit mindestens einem Nicht-ASCII-Zeichen sind
Für die Müller-Zeile kostet der Marker zwei Codewörter, während der Sprung von 20×20 auf 22×22 — 10 mm auf 11 mm bei 0,5-mm-Modulen — von den UTF-8-Bytes verursacht wird. Bietet der Etikettenslot diesen Millimeter extra, setzen Sie BarcodePayloadEncoding auf der TPDFlib-Instanz der PDFlibPas Delphi PDF Library unmittelbar vor dem Zeichnen des Empfängersymbols auf bpeUTF8WithECI und stellen es für die Altsymbole auf derselben Seite wieder auf bpeSystemANSI