Ein Reed-Solomon-Encoder, der sein Generatorpolynom zuerst mit dem konstanten Term speichert und dann durch den führenden Term dividiert, berechnet überhaupt keine Fehlerkorrektur. Genau das lieferte HotPDF in vier 2D-Barcode-Encodern aus, QR, Data Matrix, PDF417 und Aztec, und jedes Symbol, das sie erzeugten, trug einen Prüfblock, den kein konformer Scanner verwenden konnte
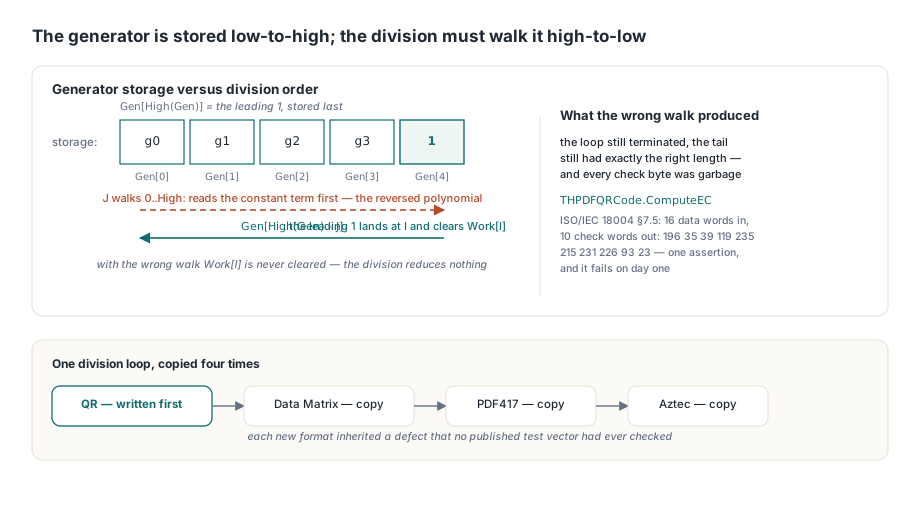
Das Interessante ist nicht der arithmetische Ausrutscher. Es ist die Ausbreitung. Ein Encoder wurde zuerst geschrieben, seine Divisionsschleife in die nächsten drei kopiert, und jedes neue Format erbte einen Defekt, der nie gegen einen einzigen veröffentlichten Testvektor validiert worden war. Symbole renderten trotzdem, Finder-Patterns saßen an der richtigen Stelle, die Größen stimmten. Nur die Bytes, die einen 2D-Barcode einen Schmutzfleck überleben lassen, waren Müll
Ein umgekehrtes Polynom, in vier Encoder kopiert
Die Wurzel ist eine Speicherreihenfolgen-Diskrepanz in der synthetischen Divisionsschleife. Alle vier HotPDF-Encoder bauen das Generatorpolynom mit Koeffizienten von niedrig nach hoch, also hält Gen[0] den konstanten Term und Gen[High(Gen)] den monischen führenden Koeffizienten. Die Divisionsschleife indexierte Gen[J] vorwärts, während sie die Nachricht durchlief, was arithmetisch identisch damit ist, durch das umgekehrte Polynom zu dividieren. Es gab eine zweite Konsequenz, die die erste verbarg: Weil der führende Koeffizient nie an Position I landete, wurde Work[I] nie gelöscht, die Division also nie tatsächlich reduziert. Die Schleife terminierte trotzdem und füllte den Schwanz trotzdem mit einem Array exakt der richtigen Länge
// THPDFQRCode.ComputeEC in der Unit HPDFQRCode.pas
Gen := GeneratorPoly(ECCount);            // Gen[0] ist der konstante Term
SetLength(Work, Length(Data) + ECCount);
for I := 0 to High(Data) do
  Work[I] := Data[I];
for I := Length(Data) to High(Work) do
  Work[I] := 0;
for I := 0 to High(Data) do
begin
  Factor := Work[I];
  if Factor = 0 then
    Continue;
  // Gen[High(Gen)] ist die führende 1, die Work[I] löscht; Gen vorwärts
  // zu durchlaufen dividiert stattdessen durch das umgekehrte Polynom
  for J := 0 to High(Gen) do
    Work[I + J] := Work[I + J] xor GFMul(Gen[High(Gen) - J], Factor);
end;
Der Fix ist der einzelne Indexausdruck Gen[High(Gen) - J]. Danach reproduziert THPDFQRCode.ComputeEC das durchgerechnete Beispiel aus ISO/IEC 18004 §7.5: Der Version-1-M-Byte-Mode-Block 32 91 11 120 209 114 220 77 67 64 236 17 236 17 236 17 ergibt die zehn Prüfwörter 196 35 39 119 235 215 231 226 93 23. Das ist eine Assertion, und sie wäre am ersten Tag fehlgeschlagen
Warum verlor auch das Aztec-Symbol seine Nutzlast?
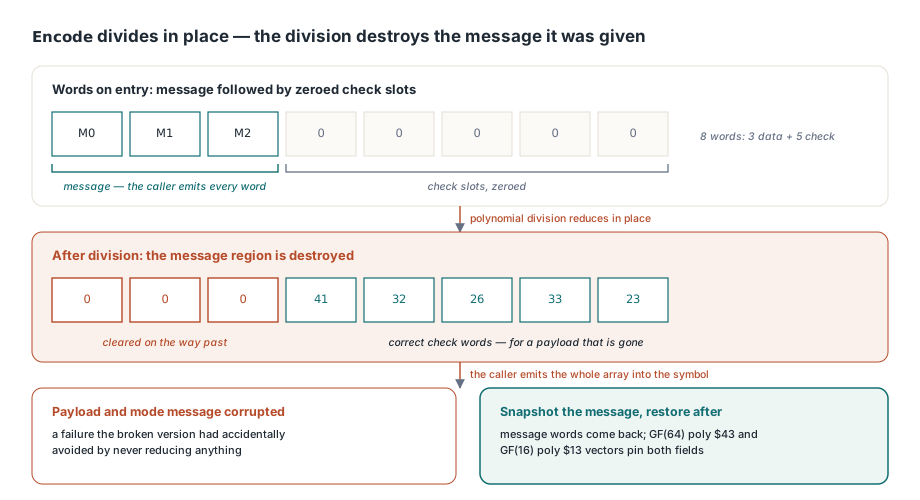
Aztec trug eine schwerere Version desselben Bugs, weil TAztecGF.Encode in-place dividiert. Die Routine bekommt Words mit der Nachricht gefolgt von genullten Prüfwort-Slots, und der Aufrufer schreibt dieses gesamte Array ins Symbol. Polynomdivision zerstört den Dividenden, während sie reduziert, also wurden, sobald die Schleife so gefixt war, dass sie wirklich reduzierte, die Nachrichtenwörter unterwegs überschrieben. Nutzlast und Mode Message kamen beide korrupt heraus, ein Versagen, das die kaputte Version zufällig vermieden hatte, weil sie nie etwas reduzierte
// TAztecGF.Encode in der Unit HPDFAztec.pas
SetLength(Message, DataCount);
for I := 0 to DataCount - 1 do
  Message[I] := Words[I];
for I := 0 to DataCount - 1 do
begin
  Factor := Words[I];
  if Factor = 0 then
    Continue;
  for J := 0 to ECCount do
    Words[I + J] := Words[I + J] xor Multiply(Gen[ECCount - J], Factor);
end;
// Die Division löscht die Nachrichtenregion, aber der Aufrufer schreibt das
// ganze Array ins Symbol, also müssen die Datenwörter zurückkommen
for I := 0 to DataCount - 1 do
  Words[I] := Message[I];
Aztec verwendet zwei verschiedene Felder, und die Regressions-Fixture übt beide. In GF(64), dem Feld eines Sechs-Bit-Symbols aus dem primitiven Polynom $43, erzeugen die Wörter 12 45 3 mit fünf Prüfwörtern 41 32 26 33 23, während die führenden drei unangetastet bleiben. In GF(16), dem Feld der Mode Message mit dem primitiven Polynom $13, erzeugen die Wörter 5 9 die Werte 11 15 6 8. Beide laufen über den Hook HPDFAztecTestEncode gegen ISO/IEC 24778
Warum braucht Data Matrix zwei Fixes statt einem?
THPDFDataMatrix.ComputeEC stapelte einen zweiten, unabhängigen Fehler auf den gemeinsamen: Es baute das Generatorpolynom mit Wurzeln ab α^0, während ISO/IEC 16022 Anhang E Wurzeln ab α^1 vorschreibt. Nur den Divisionsindex zu fixen ergibt für das Standardbeispiel die Prüfwörter 146 107 90 179 128, die genauso plausibel aussehen wie die korrekten und trotzdem unlesbar sind. Beide Defekte mussten weg, bevor die Zahlen passten
// THPDFDataMatrix.ComputeEC in der Unit HPDFDataMatrix.pas
Gen[0] := 1;
for I := 0 to ECCount - 1 do
begin
  // DMExp[I + 1]: die Wurzeln laufen alpha^1..alpha^ECCount, nicht ab alpha^0
  for J := ECCount downto 1 do
    Gen[J] := GFMul(Gen[J], DMExp[I + 1]) xor Gen[J - 1];
  Gen[0] := GFMul(Gen[0], DMExp[I + 1]);
end;
Der Referenzpunkt ist klein genug für einen Kommentar. Der String '123456' kodiert zu den ASCII-Codewörtern 142 164 186, ein 10x10-Symbol trägt fünf Prüfwörter, und der korrekte Block ist 114 25 5 88 102. HPDFDataMatrixTestComputeEC legt die Klassenfunktion hinter dem {$IFDEF HPDF_TESTING}-Gate offen, also assertet die Fixture diese fünf Werte, ohne einen Encoder zu instanziieren oder eine Seite zu rendern. Der Galois-Körper selbst, von InitDMTables über das primitive Polynom $12D in die DMExp- und DMLog-Tabellen gebaut, war die ganze Zeit korrekt, und genau deshalb verbarg sich der Bug so gut
PDF417 dividiert über einem Primkörper, wo Vorzeichen zählen
PDF417 brauchte vier Änderungen statt einer, weil GF(929) ein Primkörper und kein binärer Erweiterungskörper ist: Addition ist kein xor, Subtraktion keine Addition, und das Vorzeichen jedes Generatorfaktors ist echte Arithmetik statt Notation. Jeder Faktor muss (x - 3^i) sein, was im Code bedeutet, mit 929 - GF929Pow(3, I) zu multiplizieren; der Reduktionsschritt muss subtrahieren; die Wurzeln laufen laut ISO/IEC 15438 §5.5 von 3^1; und Factor muss vor dem Lauf der inneren Schleife in eine lokale Variable gelatcht werden, weil der J = 0-Durchlauf Work[I] schreibt und sonst den Multiplikator unter sich selbst verändern würde. HPDFPDF417TestComputeEC pinnt das korrigierte Ergebnis: Die Codewörter 5 453 178 121 239 mit vier Fehlerkorrekturwörtern ergeben 452 327 657 619
// THPDFPDF417.ComputeEC in der Unit HPDFPDF417.pas
for I := 1 to ECCount do
begin
  Root := (929 - GF929Pow(3, I)) mod 929;   // der Faktor ist (x - 3^i)
  for J := ECCount downto 1 do
    Gen[J] := (GF929Mul(Gen[J], Root) + Gen[J - 1]) mod 929;
  Gen[0] := GF929Mul(Gen[0], Root);
end;
// ...
Factor := Work[I];                          // Latch: J = 0 schreibt Work[I] neu
if Factor = 0 then
  Continue;
for J := 0 to ECCount do
  Work[I + J] := (Work[I + J] + 929 - GF929Mul(Gen[ECCount - J], Factor)) mod 929;
Der Data-Matrix-Finder wurde seitenverkehrt eingebaut
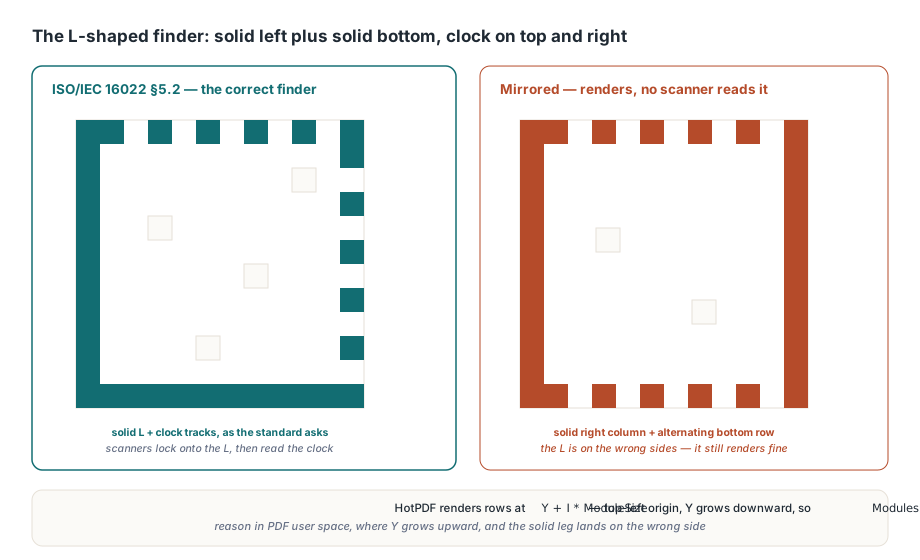
Korrekte Prüfwörter retten kein Symbol, dessen Finder-Pattern gespiegelt ist, und dasselbe Release musste auch das fixen. Der Platzierungscode zeichnete eine durchgehende linke Spalte, eine durchgehende rechte Spalte und alternierende Module entlang der oberen und unteren Reihe, während ISO/IEC 16022 §5.2 eine durchgehende linke Spalte plus eine durchgehende untere Reihe verlangt, den L-förmigen Finder, mit der alternierenden Clock Track entlang der oberen Reihe und der rechten Spalte. Was das leicht verkehrt herum macht, ist die Koordinatenkonvention: HotPDF rendert Modulreihen bei Y + I * ModuleSize, also mit Top-Left-Origin-Semantik, und damit ist Modules[Size - 1, *] die untere Reihe des gedruckten Symbols. Wer im PDF-Benutzerraum denkt, wo Y nach oben wächst, setzt den massiven Schenkel auf die falsche Seite und sieht auf dem Bildschirm nichts Verdächtiges
Warum bestanden vier kaputte Encoder jahrelang die Tests?
Weil die Tests Struktur asserteten und die Defekte in der Arithmetik lagen. Die bestehenden QR-, Data-Matrix- und Aztec-Fälle prüften Finder-Module, Timing-Patterns und Symboldimensionen, allesamt wirklich korrekt; kein Test hatte je ein Prüfwort mit einem veröffentlichten Vektor verglichen. Der zweite Grund verallgemeinert weiter. HotPDF liefert einen eingebauten QR-Decoder mit, und ihn zur Validierung des Encoders zu nutzen, fühlt sich wie ein offensichtlicher Round Trip an, außer dass dieser Decoder Daten-Codewörter liest und keine Reed-Solomon-Korrektur durchführt, also las er exakt das zurück, was der Encoder schrieb, und meldete Erfolg. Wenn ein Encoder und ein Decoder eine Annahme teilen, beweist ein Round-Trip-Test, dass sie übereinstimmen, nicht dass einer von beiden richtig ist. Ein fehlerkorrigierender Code muss gegen Vektoren validiert werden, die in der Norm gedruckt sind, nie gegen den eigenen Decoder. Die Fixture THPDFBarcodeECCTests hält jetzt einen Test pro Format, jeder benannt nach dem, was er pinnt, und jeder erreicht die Arithmetik über einen Hook, der nur unter {$IFDEF HPDF_TESTING} kompiliert wird:
QRCheckWordsMatchISO18004Exampleassertet die zehn Prüfwörter des Version-1-M-Byte-Mode-BeispielsDataMatrixCheckWordsMatchISO16022Exampleassertet 114 25 5 88 102 für die Codewörter 142 164 186PDF417CheckWordsMatchGF929Referenceassertet 452 327 657 619 über GF(929) mit Wurzeln 3^1 bis 3^4AztecCheckWordsKeepMessageAndMatchReferenceassertet die Prüfwörter und dass die Nachrichtenwörter die In-Place-Division überleben
Vier Fragen fangen den Großteil dieser Familie in jedem Encoder, den Sie betreuen. Stimmt Ihre Generator-Speicherreihenfolge mit Ihrer Divisionsindex-Reihenfolge überein, und können Sie auf die Zeile zeigen, die es beweist? Starten die Wurzeln dort, wo die Norm es sagt, α^1 bei Data Matrix und 3^1 bei PDF417? Stellt eine In-Place-Division danach die Nachrichtenregion wieder her? Vergleicht mindestens ein Test Prüfwörter, statt Modulzahlen, mit einer Zahl aus einer Spezifikation? Der Umfang zählt auch, wenn Sie entscheiden, was mit bestehenden Artefakten passiert. Symbole, die vor v2.748.0 erzeugt wurden, rendern und scannen unter idealen Bedingungen oft, denn ein sauberes Bild braucht keine Korrektur, um gelesen zu werden; verloren haben sie die Schadenstoleranz, die der ganze Grund ist, diese Formate zu wählen. Langlebige Etiketten und archivierte Dokumente mit betroffenen Symbolen lohnen das Neu-Erzeugen statt einer Stichprobenprüfung mit der Handykamera. Die Encoder leben im Barcode-Support in HotPDF, neben dem QR-Decodierungspfad mit seiner Orientierungsbehandlung und der Report-Ausgabeschicht, die Symbole auf einer Seite platziert; die vollständige Barcode-API-Referenz kommt mit dem HotPDF Delphi Component für Delphi und C++Builder