HotXLS bygger og opdaterer native XLSX-pivottabeller fra Delphi og C++Builder uden Excel-installation og uden COM-automation på maskinen. Du kalder AddPivotTable med et kildeområde, placerer felter på række-, kolonne-, side- og dataakserne, lægger beregnede elementer eller en procent-af-total-visning ovenpå, og komponenten skriver de pivotCacheDefinition- og pivotTableDefinition-dele, som Excel åbner som en levende pivot, der kan opdateres
Scenariet, der gør det besværet værd, er en rapporteringsserver. Du genererer hundredvis af arbejdsbøger hver nat, hver med en pivot, der opsummerer én konto, og næste måned flytter tallene sig, og hver fil skal afspejle de nye kilderækker. At styre Excel fra en Windows-tjeneste er skrøbeligt og ikke licenseret til serverbrug, og at håndskrive pivot-XML er et spec-arkæologiprojekt, der aldrig slutter. HotXLS sidder mellem de to blindgyder: en typet objektmodel over OOXML-pivotdelene, så den samme Pascal, der udfylder cellerne, også erklærer pivoten og genopbygger dens cache i samme proces
Hvordan opretter du en pivottabel i Delphi uden Excel?
Du opretter én med et enkelt kald og placerer derefter felter på akserne. AddPivotTable tager kildeområdet i A1-notation, destinationscellen, hvor tabellen forankres, og et navn; den parser området, scanner hver kolonne for at udlede dens datatype, bygger en pivotcache (eller genbruger en, der allerede er bundet til samme område) og returnerer en TXLSPivotTable, hvis felter alle starter uden for akserne. Derfra kobler bekvemmelighedsmetoderne AddRowField, AddColumnField, AddPageField og AddDataFieldByName layoutet sammen, og hvert datafelt tager én af elleve aggregeringer fra enum'en TXLSPivotAggregation (xlpaSum, xlpaCount, xlpaAverage, xlpaMax, xlpaMin, xlpaProduct, xlpaCountNums, xlpaStdDev, xlpaStdDevP, xlpaVar, xlpaVarP)
uses
  lxHandleX, lxPivot;

var
  Book : TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Pivot: TXLSPivotTable;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('sales.xlsx');
    Sheet := Book.Sheets[1];                 // rapportark (1-baseret i XLSX-motoren)

    // Kilde A1:E500 på arket 'Data'; foranker pivoten i række 3, kolonne 1.
    Pivot := Sheet.AddPivotTable('Data!$A$1:$E$500', 3, 1, 'SalesByRegion');
    if Pivot <> nil then
    begin
      Pivot.AddRowField('Region');
      Pivot.AddColumnField('Quarter');
      Pivot.AddPageField('Year');
      Pivot.AddDataFieldByName('Revenue', xlpaSum);
      Pivot.AddDataFieldByName('Units', xlpaAverage);
      Book.SaveAs('sales-pivot.xlsx');
    end;
  finally
    Book.Free;
  end;
end;
Hvorfor cachen og tabellen er to separate dele
En pivottabel er i virkeligheden to artefakter, der refererer til hinanden, og at forstå opdelingen er det, der holder resten af dette på plads. pivotCacheDefinition er dataøjebliksbilledet: en worksheetSource, der peger på kildeområdet, og ét cacheField pr. kolonne, som rummer kolonnens distinkte værdier (dens sharedItems) plus afledte grænser. pivotTableDefinition er visningen: hvilket cachefelt sidder på hvilken akse, datafelterne og deres aggregeringer, layoutknapperne. Visningen bindes til cachen via cacheId gennem arbejdsbogens pivotCaches-relation, præcis som ECMA-376 Part 1 §18.10 og [MS-XLSX] beskriver det
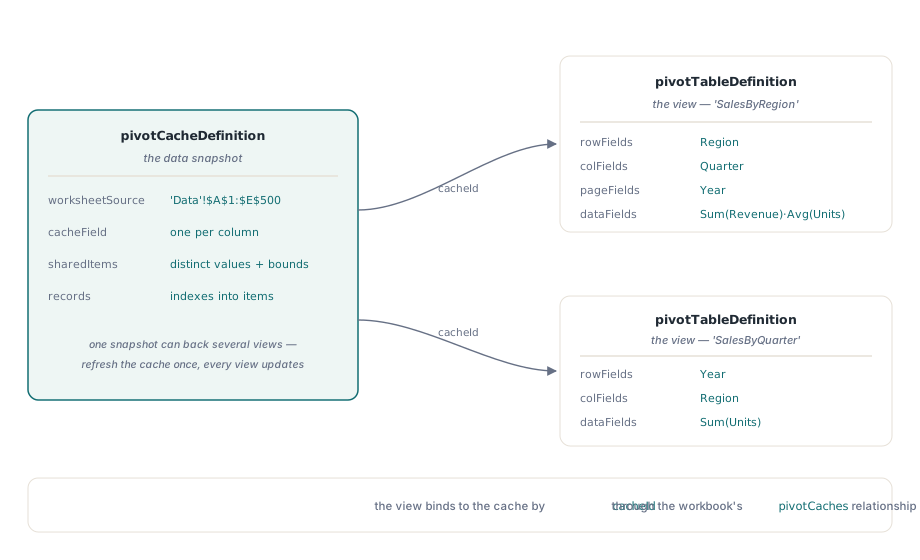
Den indirektion er ikke bureaukrati, den køber to ting. Én cache kan bakke flere tabeller, så én opdatering af cachen opdaterer alle visninger, der er tegnet fra den. Og cachen gemmer hver kolonnes værdier deduplikeret med en indekstabel pr. post frem for det rå gitter, hvilket er grunden til, at det at bygge en pivot betyder at scanne kilden, ikke at kopiere celler. HotXLS modellerer dette på samme måde for begge motorer, så koden ovenfor er næsten identisk med den klassiske sti, der er dokumenteret sammen med det binære SX-record-layout bag klassiske .xls-pivoter. Hvis din kilde ligger på et andet ark, eller du adresserer den gennem et navn, følger områdepræfikset og definerede navne og referencer på tværs af ark de sædvanlige A1-regler, med arknavne i anførselstegn tilladt for navne, der indeholder mellemrum
Beregnede elementer er ikke beregnede felter
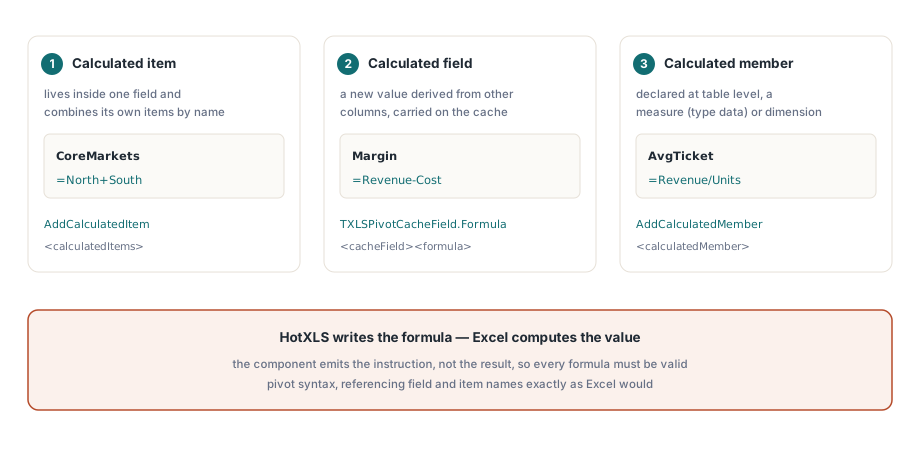
Disse tre begreber navngiver tre forskellige ting, og at blande dem sammen er den klassiske pivotfejl. Et beregnet element lever inde i ét felt og kombinerer feltets egne elementer efter navn, så inden for et Region-felt kan du definere en syntetisk CoreMarkets-række lig med North plus South; HotXLS eksponerer det som TXLSPivotField.AddCalculatedItem og skriver et <calculatedItem> under feltets <calculatedItems>. Et beregnet felt er noget andet: det er en ny værdi afledt af andre kolonner, som Margin fra Revenue og Cost, og det bæres som en formel på et cachefelt gennem TXLSPivotCacheField.Formula. Et beregnet medlem, tilføjet med TXLSPivotTable.AddCalculatedMember, er et brugerdefineret medlem på tabelniveau, der kan fungere som et mål (medlemstype data) eller et dimensionsmedlem, primært af interesse for OLAP-formede pivoter
var
  Region: TXLSPivotField;
  Member: TXLSPivotCalculatedMember;
begin
  // Et beregnet ELEMENT kombinerer elementer fra ét enkelt felt efter navn.
  Region := Pivot.AddRowField('Region');
  Region.AddCalculatedItem('CoreMarkets', '=North+South');

  // Et beregnet MEDLEM erklæres på tabelniveau. Medlemstypen
  // 'data' markerer det som et mål; en tom type er et dimensionsmedlem.
  Member := Pivot.AddCalculatedMember('AvgTicket', '=Revenue/Units');
  Member.MemberType := 'data';
end;
Én ærlig grænse gælder for alle tre. HotXLS udsender formelteksten i definitions-XML'en; den evaluerer den ikke. Excel beregner det beregnede element, felt eller medlem, når det åbner filen, på samme måde som det beregner hvert aggregat i gitteret. HotXLS skriver instruktionerne, ikke resultaterne, så de formler, du leverer, skal være gyldige pivotformler i Excels egen dialekt og referere til felt- og elementnavne, som Excel ville gøre det
Hvordan viser du værdier som procent af total?
Du sætter værdivisningstilstanden på datafeltet i stedet for selv at transformere tallene. TXLSPivotDataField.ShowDataAs tager enum'en TXLSPivotShowDataAs, som afspejler OOXML-værdierne i ST_ShowDataAs: xlpsdaNormal, xlpsdaDifference, xlpsdaPercent, xlpsdaPercentDiff, xlpsdaRunTotal, xlpsdaPercentOfRow, xlpsdaPercentOfCol, xlpsdaPercentOfTotal og xlpsdaIndex. Et almindeligt trick er at placere den samme kildekolonne på dataaksen to gange, én gang som en rå sum og én gang som en andel af totalsummen, så rapporten viser både tallet og dets vægt
var
  Rev, Share: TXLSPivotDataField;
begin
  Rev := Pivot.AddDataFieldByName('Revenue', xlpaSum);

  Share := Pivot.AddDataFieldByName('Revenue', xlpaSum);
  Share.DisplayName := 'Share of total';
  Share.ShowDataAs  := xlpsdaPercentOfTotal;

  // Elementrelative tilstande kræver en base at sammenligne med. En løbende total
  // ned ad 'Quarter' (cachefelt-indeks 3) ville lyde:
  //   Share.ShowDataAs := xlpsdaRunTotal;
  //   Share.BaseField  := 3;         // cachefelt-indeks, som transformationen kører over
  //   Share.BaseItem   := $7FFD;     // $7FFD = "(All)"
end;
xlpsdaPercentOfTotal behøver ingen base, fordi den er relativ til totalsummen, men de elementrelative tilstande gør. xlpsdaDifference, xlpsdaPercentDiff og xlpsdaRunTotal kræver BaseField (cachefelt-indekset, som sammenligningen kører over) og, for de elementforankrede former, et BaseItem-indeks, hvor $7FFD står for (All)-sentinelen. HotXLS skriver disse som attributterne <dataField showDataAs="percentOfTotal" baseField="N" baseItem="M"/> og overlader, som med beregnede formler, aritmetikken til Excel
Gruppering af datoer og tal samt sidefeltfiltre
Gruppering konfigureres på cachefeltet, ikke pivotfeltet, fordi den ændrer, hvordan kildedomænet inddeles i intervaller. Sæt HasGroup := True på det cachefelt, som Cache.FindFieldByName returnerer, og vælg derefter enten knapperne for numeriske intervaller (GroupStartNum, GroupEndNum, GroupInterval) eller datohierarki-flagene (GroupByDate med GroupMonths, GroupQuarters, GroupYears og et GroupStartDate- / GroupEndDate-spænd). HotXLS udsender det tilsvarende <fieldGroup><rangePr groupBy="months"/>-element, så et felt grupperet efter måned eller efter et numerisk bånd med bredde 1000 åbner, som Excel ville have grupperet det
Sidefelter er filter-dropdowns over tabellen. AddPageField placerer et felt på sideaksen, og PageItemIndex forudvælger ét enkelt cacheelement med xlPageItemAll ($7FFD, altså (All)) som standard. For at lade en læser afkrydse flere elementer på én gang sættes MultipleItemSelectionAllowed := True, som HotXLS skriver som <pivotField multipleItemSelectionAllowed="1"/>. Til kriterier ud over et manuelt valg bærer hvert felt en typet Filters-samling, der spænder over OOXML-familierne i ST_FilterType — antal-, procent-, sum-, tekst-, værdi- og datofiltre — hvor hver post parrer en filtertype med dens sammenligningsværdier
Hvordan opdaterer du en pivotcache, når kilden ændrer sig?
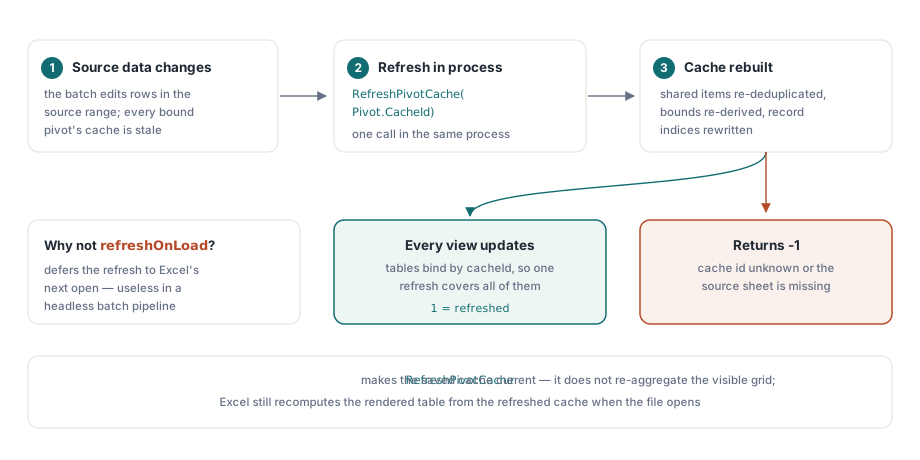
RefreshPivotCache på TXLSXWorkbook scanner kildeområdet igen og genopbygger cachen på stedet, hvilket er det, en batchpipeline har brug for, efter den har redigeret de underliggende rækker. Send cache-id'et, og metoden genlæser hver celle i kildeområdet (overskrift på første række, data fra den anden), genopbygger hvert felts domæne af delte elementer ved at deduplikere værdierne igen og genudlede grænserne pr. type, og genskriver elementindeksene pr. post. Den returnerer 1 ved succes og -1, når cache-id'et er ukendt, eller kildearket mangler
var
  Rc: Integer;
begin
  // ...kildedataene har ændret sig, siden pivoten blev bygget...
  Sheet := Book.Sheets[1];
  Sheet.Cells[2, 5].Value := 128000;             // et rettet Revenue-tal

  // Genopbyg cachens delte elementer og postindekser fra kilden.
  Rc := Book.RefreshPivotCache(Pivot.CacheId);   // 1 = opdateret, -1 = cache/kilde mangler
  if Rc = 1 then
    Book.SaveAs('sales-pivot-refreshed.xlsx');
end;
Den semantiske grænse her er værd at sige ligeud. Før denne metode fandtes, forlod HotXLS sig på flaget refreshOnLoad="1" og overlod alt opdateringsarbejde til Excel ved næste åbning, hvilket er fint, når et menneske vil åbne filen, men ubrugeligt i en headless pipeline, der skal aflevere korrekte data. RefreshPivotCache gør den gemte cache aktuel i processen, og fordi tabeller bindes til en cache via id, ser hver pivot tegnet fra den cache opdateringen. Hvad den ikke gør, er at layoute eller aggregere det synlige gitter — Excel genberegner stadig den gengivne tabel fra den opdaterede cache, når filen åbnes
Hvad HotXLS skriver, og hvad Excel beregner
Hold arbejdsdelingen for øje, og intet overrasker dig. HotXLS er en definitionsskriver: den producerer pivotCacheDefinition, cacheposterne og pivotTableDefinition, komplet med akser, aggregeringer, beregnede elementer og medlemmer, værdivisninger, gruppering og filtre. Excel er regnemaskinen: ved åbning materialiserer det gruppeintervallerne, evaluerer de beregnede formler, anvender showDataAs-transformationerne og aggregerer kroppen. De værdier, en bruger ser, er Excels, produceret ud fra de instruktioner, HotXLS skrev, hvilket er grunden til, at hver formel og hvert baseindeks skal være korrekt på skrivetidspunktet frem for at blive kontrolleret på gengivelsestidspunktet
To begrænsninger er værd at kende, før du designer omkring denne funktion. AddPivotTable parser et rektangulært A1-område med et valgfrit arkpræfiks; kilder i form af navngivne områder og eksterne arbejdsbøger ligger uden for, hvad byggeren opløser, selvom caches læst fra en Excel-forfattet fil bevarer deres navngivne områdekilde ved rundtur. Og Excel-oprettede pivoter, som HotXLS læser fra disken, afspilles byte for byte ved gemning, så de typede redigeringer beskrevet her gælder rent for pivoter, du bygger i kode, mens eksisterende pivoter forbliver tabsfri. For inputsiden af en rapport — de validerede celler og filtrerede tabeller, som pivoten opsummerer — se datavalidering, AutoFilter og strukturerede tabeller
Pivotmodellen vist her er en del af standardudgaven af HotXLS Delphi Excel Component til Delphi og C++Builder, som læser og skriver både de typede XLSX-pivotdele og de klassiske BIFF8-records fra samme objektmodel