Næsten enhver del af det ældre Excel-binære format er en enkelt record med en ren to-byte type og en to-byte længde. En celle er en LABELSST eller en NUMBER. Et flettet område er en MERGEDCELLS. De fleste regneark kan læses ved at gennemgå records én ad gangen og dispatch'e på typeordet. PivotTables bryder denne rytme. En pivot-tabel er ikke én record, men et lille program af snesevis af samarbejdende records fordelt på to steder i den samme OLE-stream, og relationerne er positionelle, bitpakkede og ubarmhjertige. Det er den struktur, som mange BIFF8-læsere enten springer over eller bevarer som uigennemsigtige bytes, fordi en ny skrivning kræver alle de krydsreferencer, Excel selv vedligeholder
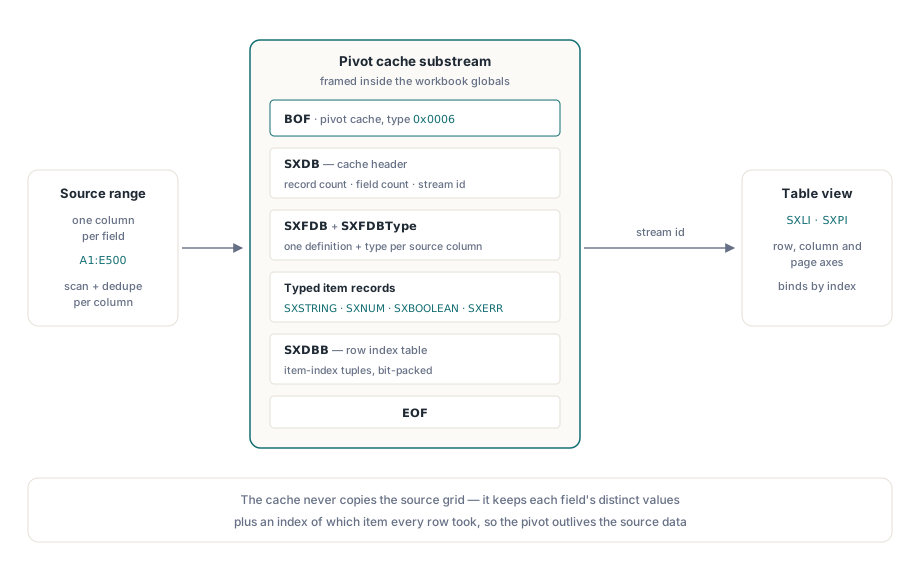
Grunden til, at en pivot-tabel er svær, er, at det reelt er to artefakter svejset sammen. Der er pivot-cachen, et selvstændigt øjebliksbillede af kildedataene med sin egen understrøm, og der er tabelvisningen, det layout, der fortæller, hvilke felter der sidder på hvilken akse. Cachen og visningen refererer til hinanden med indeks. Tag fejl af ét indeks, og filen åbnes med en opdateringsfejl eller et lydløst tomt gitter
Pivot-cachen er sin helt egen understrøm
Cachen lever i workbook globals-strømmen som en komplet BIFF-understrøm, indrammet af en BOF-record, hvis dokumenttype er 0x0006 (den værdi, der markerer en pivotcache, i modsætning til 0x0005 for projektmappen eller 0x0010 for et regneark) og lukket af den matchende EOF. Inden i denne ramme er strukturen fast. En SXDB-record er cache-hovedet. Den bærer record-antallet, antallet af cache-felter og den stream-identifikator, som tabelvisningen vil citere for at binde sig til denne cache. Hver kildekolonne bidrager derefter med en SXFDB felt-definitionsrecord efterfulgt af en SXFDBType, der klassificerer den, og derefter de unikke værdier, kolonnen antog, udsendt som én typet elementrecord pr. distinkt værdi
Element-records er der, hvor cachen tjener sig hjem. En tekstværdi bliver til en SXSTRING, en numerisk værdi en SXNUM, en logisk værdi en SXBOOLEAN, og en formelfejl en SXERR. Cachen gemmer ikke kildegitteret, den gemmer de distinkte værdier pr. felt plus en indekstabel, der for record n angiver, hvilket distinkt element hvert felt antog. Det er derfor, at det ikke er en sag om at kopiere celler at bygge en pivot-tabel programmatisk. Du skal scanne kildeområdet, udlede hvert felts type fra de værdier, det indeholder, deduplikere dem til en typet elementliste og registrere hver række som en tuple af elementindekser. Det er præcis, hvad HotXLS gør: en rent numerisk kolonne udsendes med SXNUM-elementer, en blandet tekstkolonne bliver til SXSTRING-elementer, og datoer føres som serielle værdier gennem den samme numeriske sti
SXDBB og den bit-pakning, der gør det interessant
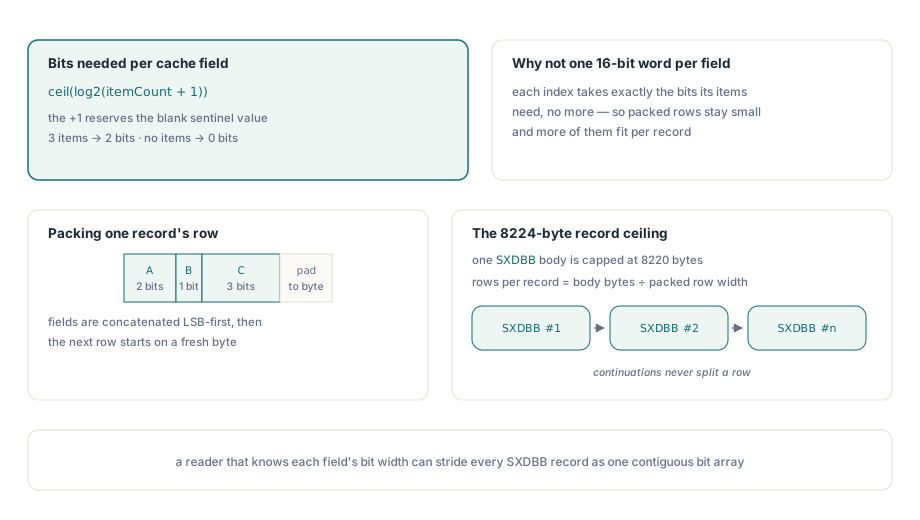
Indekstabellen pr. record er den absolut mest teknisk mærkelige del af hele strukturen, og den findes i SXDBB-recorden. Den naive kodning ville gemme hvert felts elementindeks som et 16-bit ord. Det gør Excel ikke. Det pakker hvert felts indeks ind i nøjagtigt det antal bits, der kræves for at adressere det felts elementer, og ikke flere. Bredden er ceil(log2(itemCount + 1)) bits. + 1 betyder noget: den ekstra værdi er en sentinelværdi, der betyder "tom, ingen værdi for dette felt i denne record", så et felt med tre distinkte elementer skal kunne repræsentere fire tilstande og tager derfor to bits, ikke det ene bit, som tre elementer alene ville antyde. Et felt uden nogen elementer overhovedet bidrager med nul bits og springes helt over under pakningen
Bits for én record sammenkædes på tværs af alle felter, hvorefter den næste record begynder på en frisk bytegrænse. Records er byte-justerede, ikke bit-pakkede ende til ende, hvilket gør tilfældig adgang til tabellen håndterbar til prisen af nogle få padding-bits pr. række. Pakningen inden for en byte er mindst-signifikant-bit først. Når man accepterer disse to regler, er encoderen en ligetil bit-pumpe, og decoderen er dens spejlbillede
// Bredden af ét felts indeks i SXDBB-strømmen.
// citmTotal distinkte elementer kræver ceil(log2(citmTotal + 1)) bits,
// hvor +1 reserverer en "tom" sentinelværdi.
function BitsForFieldItems(itemCount: Integer): Integer;
var
  capacity: Integer;
begin
  Result := 0;
  if itemCount <= 0 then
    Exit;            // et tomt felt bidrager med nul bits
  Result := 1;
  capacity := 2;
  while capacity < itemCount + 1 do
  begin
    Inc(Result);
    capacity := capacity * 2;
  end;
end;
Grunden til, at denne detalje ikke kan ignoreres, er loftet på 8224 bytes for en enkelt BIFF-record. Enhver record i formatet, pivot-records inklusive, skal have sin payload inden for højst 8224 bytes, og en travl pivot-cache med tusindvis af kilderækker vil sprænge den grænse længe før den har udsendt hver eneste række. Derfor bliver indekstabellen delt. HotXLS begrænser et enkelt SXDBB-indhold til 8220 bytes, hvilket er rekordgrænsen på 8224 minus det fire-byte rekordhoved af type og længde, deler dette med byte-bredden for én pakket record for at finde ud af, hvor mange hele rækker der passer, og afgiver derefter så mange fortsatte SXDBB-records, som rækkeantallet kræver. Hver fortsættelse genstarter rent på en rekordgrænse, så ingen række nogensinde bliver skåret over to records. En læser, der kender bit-bredden pr. record, kan skridte gennem hver SXDBB i rækkefølge, som om de var ét sammenhængende bit-array
Visningslayoutet: SXLI for kroppen, SXPI for siden
Med cachen bygget er tabelvisningen den anden halvdel. Dens kerne er akse-linjeelementerne, rækkerne i pivot-kroppen, der opregner hver kombination af række-felt- og kolonne-felt-værdier, som tabellen tegner. Disse føres i SXLI-records (recordtype 0x00B5, beskrevet i [MS-XLS] §2.4.275). Én SXLI rummer mange linjer, igen indtil 8224-byte-grænsen tvinger en ny record frem, og den bruger et lille komprimeringstrick: hver linje gemmer kun, hvordan den adskiller sig fra linjen ovenfor, udtrykt som et fælles-præfiks-antal, så en dybt indlejret akse ikke gentager de ydre feltværdier på hver række. Totallinjen og den første linje i enhver record nulstiller altid dette præfiks-antal til nul, så en læser aldrig behøver at kigge tilbage over en rekordgrænse for at genopbygge en linje
Sideaksen, de filterrullemenuer, der sidder over en pivot-tabel, er en separat record. SXPI (recordtype 0x00B6, [MS-XLS] §2.4.276) bærer én ti-byte indgang pr. sidefelt: pivotfeltindekset isxvd, det valgte cache-element iCache, et positionsord ipos og et ældre objekt-id objId. Værdien iCache er den, man skal holde øje med. Et sidefelt, der viser "(All)", som intet filtrerer, gemmer sentinel-værdien 0x7FFD i stedet for et reelt elementindeks. En programmatisk bygget pivot åbnes med hvert sidefelt indstillet til "(All)", indtil kalderen forhåndsvælger et element, hvorefter dette elements cache-indeks erstatter sentinel-værdien, og Excel åbner med filteret allerede anvendt. Sideløbende med disse sidder de understøttende records, der beskriver de enkelte felter og deres formatering, SXVD og SXVDEx for feltvisningsdefinitioner, SXIVD for feltindekslisterne, der ordner hver akse, og SXFormat for nummerformatering, som hver især indekserer tilbage til den samme cache, som kroppens linjer refererer til
To skrivere i én: rå blobs og den typede model
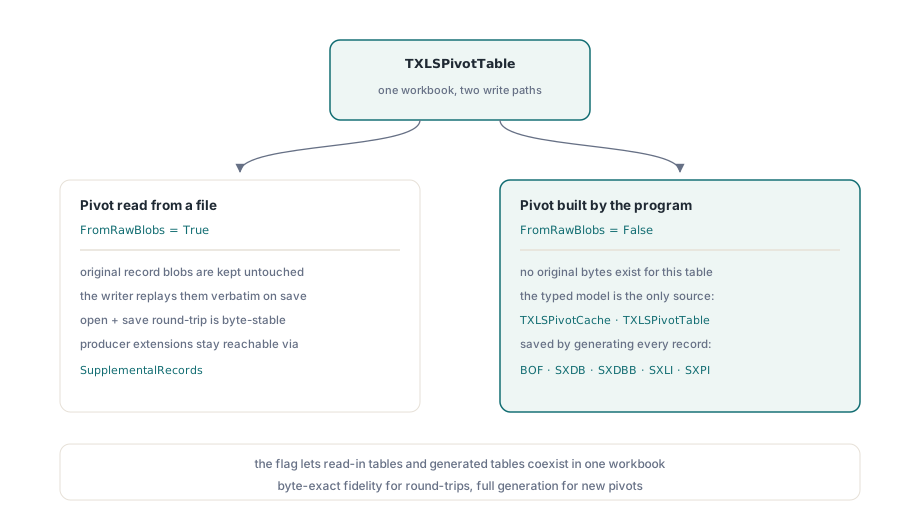
Der er en strukturel grund til, at HotXLS beholder to fuldstændig separate stier til at skrive en pivot-tabel, og det kommer direkte fra kravene til troskab (fidelity). Når en projektmappe læses fra disken, er dens pivot-records blevet skrevet af Excel eller af en anden producent, og de kan bruge rekordvarianter, mærkelige sorteringer eller udvidelsesrecords, som ingen tredjepartsskriver fuldt ud modellerer. Det eneste sikre at gøre med disse bytes er at give dem uændret tilbage. Så en pivot-tabel, der kom ind fra en fil, flages FromRawBlobs = True, og ved gem genafspiller skriveren de bevarede rekord-blobs ordret. Intet genoprettes, intet genfortolkes, og en rundtursrejse gennem åbning og gemning er byte-stabil
En pivot-tabel, som programmet har bygget, er det modsatte tilfælde. Der er ingen originale bytes at bevare, kun den typede objektmodel: en TXLSPivotCache med dens felter og elementlister, og en TXLSPivotTable med dens aksetildelinger. Denne tabel flages FromRawBlobs = False, og skriveren serialiserer den på den hårde måde ved at afgive en ny BOF = 0x0006 cacheunderstrøm, pakke SXDBB-indekstabellen ud fra de elementindekser, som den typede model indeholder, og udlægge SXLI- og SXPI-records ud fra aksekonfigurationen. Flaget er det, der lader begge typer eksistere side om side i én projektmappe. Uden det ville en enkelt skriver enten skulle kassere troskaben for indlæste tabeller eller nægte at generere nye. Eventuelle producentspecifikke udvidelsesrecords, som en indlæst tabel bar på, gemmes som supplerende records, der kan nås via tabellens SupplementalRecords-liste, så en tabel, der inspiceres via den typede model, ikke mister de dele, som modellen ikke beskriver
Sådan bygges en pivot-tabel i kode
Hele maskineriet ovenfor sidder bag ét enkelt kald. AddPivotTable tager kildeområdet i A1-notation, destinationscellen, hvor tabellens øverste venstre hjørne forankres, og et navn. Den parser området, scanner det for at udlede felttyper og bygge cachen (genbruger en eksisterende cache, hvis en anden tabel allerede er bundet til samme område), og returnerer en typet TXLSPivotTable med ét felt pr. kildekolonne, hvor hvert felt indledningsvis er off-axis. Derefter placerer du felter på akserne og vælger en aggregering. Signaturen er præcis dette, og cachen, SXDBB-pakningen og visningsrecords produceres alle for dig ved gem
uses
  lxHandle, lxPivot;

var
  Book : TXLSWorkbook;
  Sheet: IXLSWorkSheet;
  Pivot: TXLSPivotTable;
begin
  Book := TXLSWorkbook.Create;
  try
    Book.Open('Sales.xls');
    Sheet := Book.Sheets[1];

    // Kilde A1:E500 på 'Data'; forankr pivoten ved række 3, kolonne 1.
    Pivot := Sheet.AddPivotTable('Data!$A$1:$E$500', 3, 1, 'SalesByRegion');
    if Pivot <> nil then
    begin
      Pivot.AddRowField('Region');
      Pivot.AddColumnField('Quarter');
      Pivot.AddDataFieldByName('Revenue', xlpaSum);
    end;

    Book.SaveAs('Sales-Pivot.xls');
  finally
    Book.Free;
  end;
end;
Den første række i kildeområdet læses som overskriften, der navngiver cachefelterne, så AddRowField('Region') matcher en kolonne på dens overskriftstekst frem for på position. Fordi den returnerede tabel er en typet model med FromRawBlobs = False, tager skriveren stien fra bunden: den bygger en selvstændig cache, der ikke afhænger af, at kildeområdet stadig er til stede på opdateringstidspunktet, hvilket er netop den egenskab, du ønsker, når pivoten skal sendes til en modtager, der kan flytte eller slette de underliggende data
Læsning og afstemning af pivot- og cacherecords i en fil, du ikke selv har produceret, inklusive stien til bevarelse af rå blobs, er dækket i gennemgangen af projektmappe-audit og konverteringsværktøjskasse. Når kildeområdet strækker sig over titusinder af rækker, og SXDBB-strømmen spænder over mange fortsatte records, holder teknikkerne i noterne om ydeevne for store projektmapper cache-opbygningen fra at dominere din kørselstid. Begge går hånd i hånd med den pivot-skriver, der leveres i HotXLS Delphi spreadsheet component til Delphi og C++Builder, sammen med API'erne til celler, formler, diagrammer og formatering, der er dækket andre steder på denne blog