En parser hænger på en fejlbehæftet PDF, når en eller anden gren læser en byte, vælger ikke at håndtere den og returnerer uden at flytte markøren. Kaldeløkken ser ingen fremgang og ingen grund til at stoppe, så den spinner i det uendelige. HotPDF leverede præcis den fejl i tre uafhængige parsere, alle nåelige fra input på under halvtreds bytes
Det er en denial-of-service-klasse der fortjener sit eget navn, for den ligner ikke den alle allerede beskytter sig mod. Der er ingen dekomprimering, ingen voksende allokering, intet hukommelsestryk der kan udløse en watchdog. Processen sidder bare på hundrede procent CPU på en enkelt kerne med en håndfuld bytes i en buffer. Hvis du tilføjede et dekodningsbudget efter at have læst om nested filter-amplifikation og PDF-bomber, vil budgettet ikke slå til her: intet bliver dekodet, og intet bliver allokeret. Anden fejl, anden rettelse
Hvorfor koster en 40-byte fil mere end en dekomprimeringsbombe?
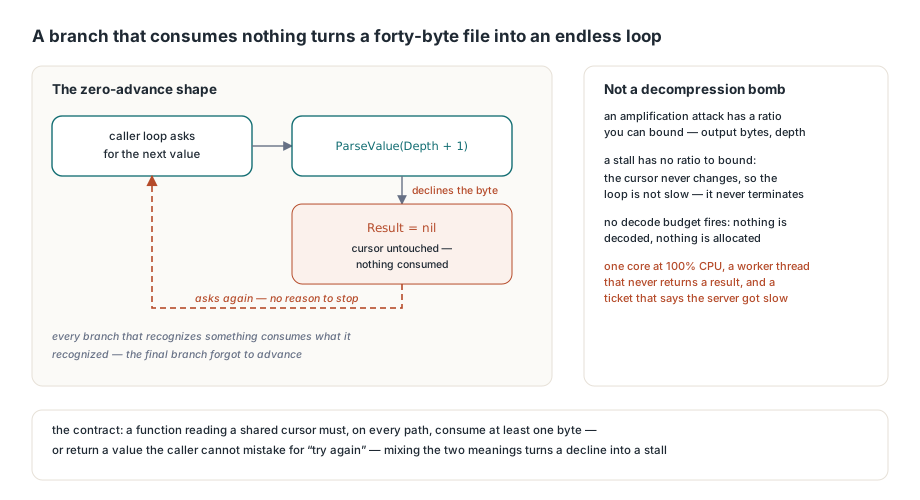
Fordi omkostningen slet ikke hænger sammen med inputstørrelsen. Et amplifikationsangreb har et forhold du kan afgrænse: lofter du output-bytes og rekursionsdybden, bliver værste tilfælde endeligt. En zero-advance-løkke har intet forhold at afgrænse. Løkkebetingelsen er en funktion af en markør der aldrig ændrer sig, så den er ikke langsom, den terminerer bare ikke — og ingen størrelsesbaseret grænse længere oppe fanger den. Det gør den også operativt unikt træls. Et crash giver dig en stack, en out-of-memory giver dig en loglinje, og en hængende parser giver dig en worker-thread der aldrig returnerer et resultat, en request der aldrig timeouter fordi intet længere nede ved den er startet, og en ticket der siger at serveren blev langsom i tirsdags. Den strukturelle årsag har altid samme form. En tokenizer eller værdiparser har en kæde af grene der forgrener på den aktuelle byte. Hver gren der genkender noget, forbruger det den genkendte. Så er der en sidste gren, eller en vagt før kæden, der returnerer for de bytes ingen gjorde krav på — og forfatteren tænker på den som en fejlsti frem for som et scanningstrin. Fejlstier returnerer. Scanningstrin rykker frem. Når én funktion skal være begge dele, er det fremrykningen der bliver glemt
Objektparseren: to delimiters ingen fik forbrugt
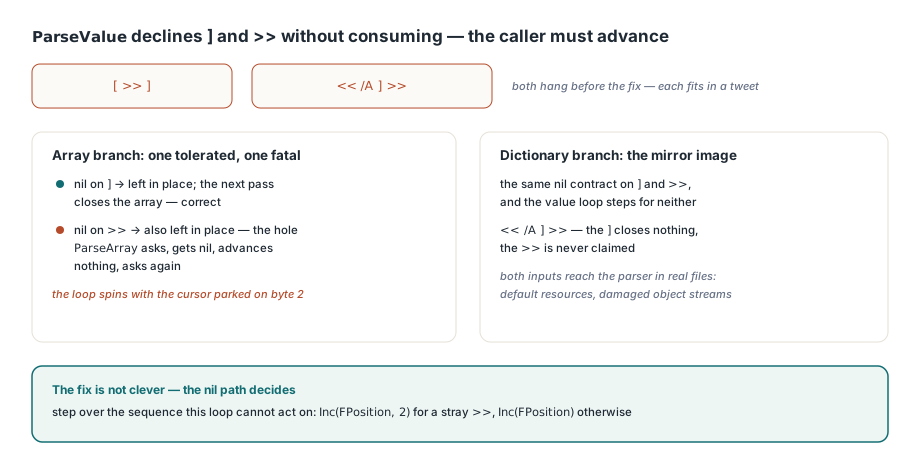
I HPDFParser begynder metoden THPDFSpanObjectParser.ParseValue med at afslå to bytesekvenser uden videre. Ifølge ISO 32000-1 afsnit 7.3 kan en værdi ikke starte med ] eller >>, for de lukker en beholder i stedet for at åbne en værdi, så ParseValue returnerer nil for begge uden at forbruge dem. Det er den korrekte kontrakt, og den lægger hele byrden med at rykke frem på kalderen. Array-grenen overholdt halvdelen: ved et nil-resultat tjekkede den efter ], lod den blive til næste pass for at lukke arrayet, og sprang over alt andet — bortset fra at tjekket tilfældigvis var skrevet sådan, at et forvildet >> også blev efterladt. Så [ >> ] hænger, fordi ParseArray beder om en værdi, får nil, rykker intet og spørger igen. Dictionary-grenen havde det spejlvendte hul, og << /A ] >> hænger på samme måde. Begge inputs er gyldige nok til at nå parseren og korte nok til at passe i en tweet
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // Før rettelsen returnerede ingen af kaldene nedenfor
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
Rettelsen er ikke smart, og det er pointen: nil-stien skal eksplicit beslutte, hvilken af de to uforbrugte sekvenser den aktuelle løkke kan handle på, og springe over den anden
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue returnerer nil for både ']' og '>>' uden at forbruge
  // dem. ']' lukker arrayet på næste pass, men et forvildet '>>'
  // inde i et array skal springes over, ellers rykker parsen aldrig frem
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;
En ting mere fortjener opmærksomhed her. THPDFSpanObjectParser.RecordError øger kun ErrorCount i THPDFParserViewStatistics; den lofter intet. Parseren sætter HPDFParserMaximumDepth til 64 for at afgrænse indlejring, men har intet tilsvarende loft på fejlantallet — og en tæller ingen nogensinde læser er en overset sikkerhedsafbryder. Selv med fremrykningen genoprettet vil et input der producerer én fejl per byte, tygge sig gennem et stort objekt i et tempo der fortjener en tidlig exit frem for en fuld gennemgang. Tjek Valid på statistik-recordet efter hver parse, og behandl et stort ErrorCount som grund til at holde op med at stole på objektet — ikke blot som en diagnose
Samme form i CMap-tokenizeren og XFDF-læseren
HPDFCMapReader.NextToken bar den identiske fejl i sin fallback-gren. Funktionen returnerer en TCMapTok og håndterer <, ( og / med dedikerede grene; alt andet falder igennem til "læs indtil whitespace eller delimiter". Når startbyten selv er en delimiter fra sættet i ISO 32000-1 afsnit 7.2.2, kører den løkke nul gange, tokenet kommer tomt tilbage, og kalderen beder om den samme token igen. Af de seks tegn der kan havne der, blev kun [ opsnappet tidligere af bfrange-håndteringen, så et forvildet ), >, ], { eller } hvor som helst i en ToUnicode-CMap var nok til at få tekstudtrækningen til at gå i stå
// nøgleord eller tal: læs indtil whitespace eller delimiter
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// En delimiter ingen af grenene ovenfor gør krav på (et forvildet ')', '>',
// '[', ']', '{' eller '}') ville efterlade P hvor det var og returnere et
// tomt nøgleord, så kalderen ville bede om den samme token i det uendelige
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
XFDF-siden havde en variant med en anden oprindelse og samme effekt. HPDFXFDFXml.ParseElement sætter Result := P i toppen, mens P stadig peger på det åbnende <, og først derefter øges den lokale markør — så hver tidlig exit der følger, returnerer indgangspositionen, medmindre den overskriver Result først. En doctype-deklaration per XML 1.0 afsnit 2.8, eller noget andet uden et parserbart tag-navn som <1a>, tog en exit der aldrig opdaterede Result, og child-element-løkken modtog den position den selv havde sendt ind. Attribut-løkken havde tre mere af den slags, fordi ReadName, whitespace-skippet og =-håndteringen alle afslår en byte der hverken er et navnetegn, whitespace eller en af =, >, / — og ingen af dem forbrugte den. CDATA-reparationen ved siden af flyttede et ansvar i stedet for at tilføje en vagt: en CDATA-sektion per XML 1.0 afsnit 2.7 starter med <, så child-løkken plejede at overdrage den til ParseElement, som så læste et tag-navn ud af sektionens indhold. At genkende den i child-løkken med IsCDATAStart og kopiere bytes ind i tekstbufferen indtil IsCDATAEnd er den korrekte arbejdsdeling — og det gamle skip sprang også kun én byte over, for markeringen er otte bytes regnet fra !
Deklarerede antal der overlever dataene
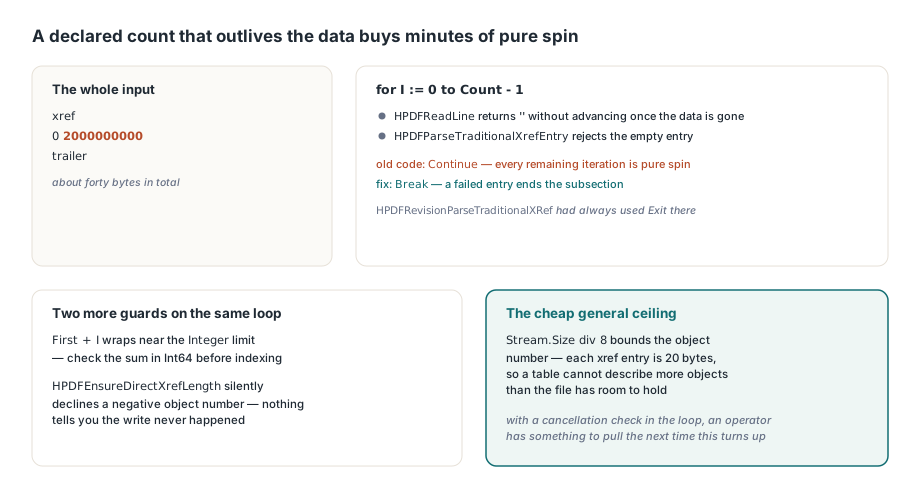
En senere release viste samme mønster fra den modsatte retning, og det er varianten der med størst sandsynlighed findes i din egen kode. En cross-reference-underafsnits-header per ISO 32000-1 afsnit 7.5.4 er et first count-par, og begge HotPDFs traditionelle xref-parsere løkkede for I := 0 to Count - 1 over den, med Continue i stedet for Break når en entry ikke kunne parses. Det ligner tolerance over for én dårlig linje. Det er det ikke: HPDFReadLine returnerer en tom streng uden at rykke frem når dataene er opbrugt, og HPDFParseTraditionalXrefEntry afviser en tom entry med det samme — så hver tilbageværende iteration af det deklarerede antal er ren spin. Regnestykket er ubarmhjertigt: headeren xref\n0 2000000000\ntrailer plus en minimal indpakning er omkring fyrre bytes, og den køber dig ti sekunder på en travl kerne uden noget cancel-tjek nogen steder i løkken. Afsløringen lå i samme unit, for HPDFRevisionParseTraditionalXRef havde altid brugt Exit i den position. Når to funktioner parser samme grammatik og er uenige om, hvorvidt en fejlet entry afslutter underafsnittet, er den ene en fork der holdt op med at få rettelserne — samme signatur der dukker op i hybrid cross-reference-håndtering, hvor en traditionel tabel og en stream beskriver de samme objekter
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // Et deklareret antal større end tabellen ville ellers spinne
  // her uden data tilbage at læse
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // First kommer fra underafsnits-headeren, så summen wrapper for en
  // deklareret start nær Integer-grænsen, og vækst-hjælperen
  // afviser stille og roligt et negativt index
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... registrér entry'en ...
end;
De to grænser efter Break hører til samme reparation. HPDFEnsureDirectXrefLength nægter at vokse arrayet for et negativt objektnummer og siger ikke noget om det, og First + I wrapper for en deklareret start nær Integer-grænsen, så et negativt index når ned til skrivningerne længere nede. Objektnummer-loftet Stream.Size div 8 er det billige generelle svar, for ingen traditionel cross-reference-tabel kan beskrive flere objekter end filen har plads til — og enhver header der påstår andet, beskriver en fil der ikke findes. Hvis du reparerer en beskadiget tabel i hånden, gælder samme ræsonnement fra den modsatte side, hvilket er territoriet dækket i noterne om diagnosticering og reparation af håndredigerede PDF-filer
Hvordan beviser du at en hænge-rettelse faktisk virker?
Ved at køre den gamle kode, ikke ved at læse den igen. En stilstand er en af de få fejlklasser hvor en rettelse kan verificeres med et binært signal og uden instrumentation, for processen returnerer enten eller også gør den ikke — og at ræsonnere om kontrolflow er præcis den færdighed der skabte fejlen i første omgang. Mekanikken er værd at kopiere. Pak præ-fix-revisionen af de ændrede units ud i en scratch-mappe, kompilér derefter en lille probe med unit-søgestien så mappen ligger foran det rigtige bibliotek: dcc32 -U<scratchdir>;<Lib> probe.dpr. Compileren tager de gamle kilder for det den finder først og de nuværende kilder for alt andet, så en enkelt probe-binary øver den gamle parser mod resten af biblioteket. Kør den under en timeout — fyrre sekunder er rigeligt — og behandl exit-kode 124 som assertionen. Træk derefter units ud af scratch-mappen én ad gangen og byg om. Alle tre stilstande kunne reproduceres på den måde, hver især henførbar til en bestemt unit, og alle tre forsvandt igen da den rettede kilde var tilbage i stien — til prisen af én kompilering per unit
To fælder er værd at kende før du prøver. Unit-søgestien er tavst eftergivende: giver du -U en Unix-stil-sti fra en shell, som $PWD, ignorerer compileren den mappe uden et ord — hvilket betyder at din probe blev kompileret mod de nuværende kilder og bestod af den forkerte grund. Konvertér stien til native Windows-form først. Det andet er at scratch-mappen ikke indeholder include-filerne, så du også har brug for -I<Lib> for HotPDF.inc — ellers fejler bygningen på en måde der ligner et kilde-problem snarere end et sti-problem. Og vær ærlig om hvad metoden ikke giver dig: den bekræfter at et bestemt input stoppede med at hænge på en bestemt build, og siger intet om de inputs du ikke tænkte på. Zero-advance-fejl findes ved fuzzing eller ved at læse hver gren i hver tokenizer — ikke ved regressionstests skrevet bagefter
Hvad du skal auditere i dine egne parsere
Den genbrugelige regel er en kontrakt, ikke et checkliste-punkt. Enhver funktion der læser fra en delt markør skal på enhver sti, inklusive fejlstierne, enten forbruge mindst én byte eller returnere en værdi kalderen ikke kan misforstå som "prøv igen". At blande de to betydninger i ét nil eller én tom token er det der gør et afslag til en stilstand. Så auditér efter formen snarere end efter symptomet. Find hver løkke hvis terminering afhænger af en markør en anden funktion ejer, og spørg hvad der sker når den funktion nægter den aktuelle byte. Find hver fallback-gren skrevet som "læs indtil X" og spørg hvad den gør når markøren allerede sidder på X. Find hver løkke afgrænset af et antal der kom fra filen frem for fra dataene, og lad et fejlet element afslutte løkken i stedet for at springe en iteration over. Hvor den samme grammatik parses to steder, diff dem — for den ene vil have fået en rettelse den anden ikke fik. Og læg et cancel-tjek ind i enhver løkke der kan køre i et kalderspecificeret antal iterationer, så en operatør har noget at trække i næste gang en af de her dukker op i produktionen
Parserne beskrevet her leveres i den nuværende HotPDF Delphi Component til Delphi og C++Builder, med statistik-records og dybdegrænser eksponeret, så din egen hærdning kan bygge videre på dem