HotPDF kan gemme et indlæst dokument i en diagnostisk form, designet til at blive læst og redigeret af et menneske, og derefter reparere filen, efter du har redigeret den. SaveLoadedDocumentDiagnostic skriver dokumentet med deterministisk dictionary-rækkefølge, hvert objekt som et normalt indirekte objekt, ingen object streams, ingen cross-reference stream og ingen linearisering. RepairDiagnosticDocument genopbygger derefter de byte-offsets, stream-længder, cross-reference-tabel og trailer, som din redigering gjorde ugyldige
Dette par eksisterer til ét arbejdsforløb: at forstå eller rette, hvad der reelt ligger inde i en PDF. Enhver udvikler, der har fejlsøgt et gengivelsesproblem, har ønsket at åbne filen, ændre ét tal i én dictionary og se på resultatet. I en normal PDF er det umuligt, fordi indholdet er komprimeret ind i object streams, og hver byte, du indsætter, forskyder offsets, som en cross-reference-tabel registrerer nøjagtigt
Hvad gør en diagnostisk gemning anderledes?
Seks indstillinger ændres samlet. Dictionary-nøgler skrives i deterministisk rækkefølge, så to gemninger af det samme dokument giver sammenlignelige filer. Diagnostisk output-tilstand annoterer strukturen. Fuld genskrivning tvinges igennem, så intet overføres som en urørt inkrementel revision. Linearisering er slået fra, da en lineariseret fil er organiseret til en webfremviser frem for til en læser. Cross-reference streams er slået fra, så tabellen er ren tekst. Og object streams er slået fra, så intet objekt er skjult inde i en komprimeret beholder
Resultatet er en fil, hvis header bærer en diagnostisk markør ved siden af den sædvanlige %PDF--signatur, og hvis krop du kan bladre igennem i en hvilken som helst editor. Objekter optræder ét efter ét, dictionaries er læselige, og content streams ligger, hvor du kan finde dem. Reparationsværktøjet tjekker for den markør og afviser filer, der mangler den, fordi en normal PDF's kompakte struktur ikke er noget, en byte-range-reparatør bør forsøge at fortolke

uses
  HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoice.pdf') <= 0 then
      Exit;
    // Læsbar, ét objekt pr. blok, intet skjult i object streams
    Pdf.SaveLoadedDocumentDiagnostic('invoice-diagnostic.pdf');
  finally
    Pdf.Free;
  end;
end;
Hvorfor ødelægger redigering filen, og hvad skal genopbygges?
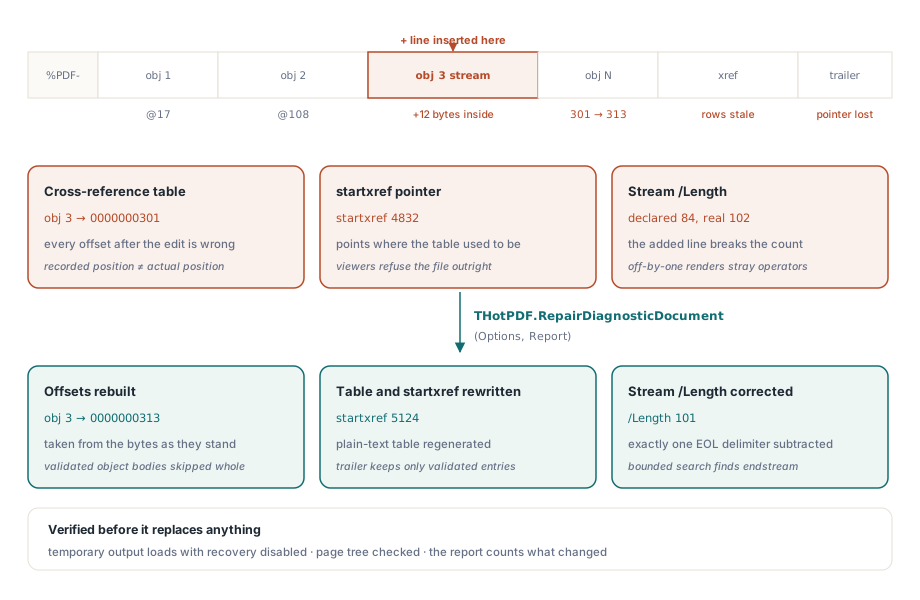
Tre ting i en PDF koder byte-positioner eller byte-antal. Cross-reference-tabellen kortlægger hvert objektnummer til en byte-offset. startxref-værdien i slutningen af filen peger på tabellen. Og hver stream-dictionary bærer et /Length, der angiver, hvor mange bytes stream-kroppen fylder
Ændr ét tegn hvor som helst før slutningen af filen, og offsets efter det er forkerte. Tilføj en linje til en content stream, og dens /Length er også forkert. De fleste fremvisere vil afvise filen, og dem, der genopretter den, gør det ved at scanne, hvilket skjuler fejlen frem for at rette den. Reparation genopbygger alle tre ud fra, hvad byttene nu rent faktisk siger
var
  Options: THPDFDiagnosticRepairOptions;
  Report: THPDFDiagnosticRepairReport;
begin
  Options := THPDFDiagnosticRepairOptions.Default;
  Options.VerifyOutput := True;         // indlæs resultatet, før det erstattes

  if THotPDF.RepairDiagnosticDocument('invoice-diagnostic.pdf',
       'invoice-fixed.pdf', Options, Report) then
    Writeln(Format('%d objects, %d streams, %d lengths corrected, ' +
      '%d xref rows rebuilt, %d pages verified',
      [Report.ObjectCount, Report.StreamCount,
       Report.RepairedStreamLengthCount, Report.RebuiltXRefEntryCount,
       Report.VerifiedPageCount]))
  else
    Writeln(Format('repair failed (%d): %s',
      [Ord(Report.Status), string(Report.Diagnostic)]));
end;
Kopiér bytes, reserialisér ikke
Designbeslutningen, der gør dette værktøj troværdigt, er, at det aldrig indlæser dokumentet og skriver det ud igen. Det kopierer byte-intervallerne for de objekter, det har valideret, ændrer kun de /Length-værdier, der er forkerte, og genopbygger tabellen, traileren og startxref omkring dem
At indlæse og reserialisere ville være langt lettere at implementere og ville stille ændre ting. Ukendt objektsyntaks ville blive normaliseret, string-escapes ville blive omskrevet i writerens foretrukne form, og allerede kodede stream-payloads kunne blive genkodet. For et fejlsøgningsværktøj er det uacceptabelt: du redigerede ét tal, og diffen bør vise ét tal, ikke tusind tilfældige formateringsændringer. Hvis du vil vide præcis, hvad der ændrede sig mellem to filer, er det et sammenligningsproblem, dækket i sammenligning af to PDF-filer efter struktur og pixels

De to parsing-regler, der forhindrer falske objekter
En byte-range-scanner står over for en oplagt fælde: tekst, der ligner en objektheader, kan optræde inde i en stream-payload eller inde i en streng. En naiv scanning ville udsende en cross-reference-række, der peger midt ind i en content stream, og den resulterende fil ville være ødelagt på en ny og mere forvirrende måde
HotPDF undgår dette ved at springe hele byte-intervallet for hvert valideret objekt over, ved brug af dets registrerede slut-offset, så intet inde i en objektkrop nogensinde betragtes som en kandidat. Mellem objekter er kun PDF-mellemrum og kommentarer tilladt; alt andet betyder, at regionen ikke er forstået, og dens bytes må ikke trækkes ind i output
Stream-længder kræver lige så stor omhu. Den reelle payload-længde ekskluderer det linjeskift-afgrænsertegn, som en writer indsætter før endstream. Når den angivne længde lander præcis på markøren, accepteres den angivelse. Når den ikke gør, udfører reparatøren en begrænset søgning efter parret endstream og endobj og trækker præcis ét afgrænsertegn fra, et CR, et LF eller et CRLF. At tage fejl her med én byte giver en fil, der åbner og gengiver en side med én vildfaren operator til sidst i sin content stream
Hvad traileren må beholde
Den genopbyggede trailer er ikke en kopi af den gamle. /Size, /Prev og /XRefStm beskriver alle det tidligere fillayout og genberegnes eller droppes. Kun poster, hvis mål er blevet valideret, overlever: /Info, /ID og /Encrypt. Og /Root skal opløse til præcis ét Catalog-objekt — ikke nul og ikke flere, hvilket er, hvad en fil samlet ved at copy-paste objektblokke har en tendens til at give
Output-sikkerhed håndteres, som den bør for et værktøj, der kører mod filer, folk er afhængige af. Resultatet skrives til en midlertidig fil i målmappen og verificeres derefter ved at blive indlæst gennem den normale sti med cross-reference-genopretning slået fra, så en fil, der kun åbner takket være genopretning, tæller som en fejl. Først når sidetræet verificerer, erstatter den midlertidige fil atomart målet. En mislykket reparation overskriver aldrig et eksisterende output
Budgetter og ærlige fejlkoder
Tre grænser afgrænser arbejdet: inputbytes, antal kandidatobjekter og maksimalt objektnummer, som som standard er 8 GiB, to millioner og to millioner. Loftet for objektnummer betyder mere, end det ser ud til, fordi en spredt tabel med få objekter nummereret i milliarder ellers ville oppuste den genopbyggede cross-reference-tabel enormt. Klassiske cross-reference-tabeller afviser også offsets, der ville kræve mere end ti decimalcifre, hvilket er en formatgrænse frem for et implementeringsvalg
Fejl rapporterer en specifik status frem for en boolean: ugyldige argumenter, kilde for stor, ikke en diagnostisk fil, objektgrænse overskredet, ugyldigt objekt, duplikeret objekt, manglende catalog, ugyldig trailer, output-fejl eller validering mislykkedes. Hver kortlægges til en anden rettelse. Et duplikeret objekt betyder, at du indsatte en objektblok to gange. En manglende catalog betyder som regel, at objektet, der holder /Type /Catalog, var beskadiget. Validering mislykkedes betyder, at strukturen nu er konsistent, men at sidetræet ikke indlæses, hvilket typisk er et /Kids-array, der er redigeret ude af trit med sit /Count
To praktiske bemærkninger runder det af. Behold den diagnostiske fil, ikke kun den reparerede, så den næste redigering starter fra et læsbart grundlag. Og send ikke diagnostisk output til slutbrugere: det er større end en normal gemning, fordi intet er komprimeret ind i object streams, og produktionsvejen til en kompakt fil er den almindelige gemmesti, beskrevet i object streams og inkrementelle opdateringer. Når målet er at finde, hvad der er galt, frem for at ændre det, svarer den automatiserede vej i preflight-rapportautomatisering hurtigere end at læse bytes
Diagnostisk gemning, reparation, preflight og sammenligning arbejder alle på den samme indlæste dokumentmodel i Delphi og C++Builder; den komplette funktionsliste findes på HotPDF Delphi PDF component-siden