PDFium Component kontroluje rovnocennost PDF/A Info a XMP metadat přes TPdf.InspectPdfAMetadata a opravuje ji přes TPdf.NormalizePdfAMetadata. ISO 19005-1 (ve znění opravy Cor.1) vyžaduje, aby každá z osmi mapovaných Info položek, od Title po ModDate, nesla tutéž hodnotu jako její XMP vlastnost, ne jen aby existovala; kontrola čte správný RDF tvar, páruje namespace podle URI a porovnává data jako okamžiky
Bug report, který tuhle konverzaci obvykle rozpoutá, vypadá neškodně. Document management systém vpíše nové /ModDate do Info slovníku při každé inkrementální úložbě, XMP packet nechá být a o půl roku později archive audit označí tisíce souborů za nekonformní. Obě data tam jsou. Jen přestala souhlasit při první editaci a presence kontrola si toho nikdy nevšimla. Stejným způsobem padají editace Title provedené přes Info-only API a Author řetězec jako Finance; Controlling, který nějaký nástroj rozsekal na dvě položky dc:creator
Proč PDF/A odmítá metadata, která existují na obou místech?
PDF/A to odmítá, protože ISO 19005-1 §6.7.3 je pravidlo o hodnotách, ne o přítomnosti: Tabulka 1 mapuje osm Info klíčů na XMP vlastnosti a jakmile je Info klíč přítomný, mapovaná XMP vlastnost musí nést rovnocennou hodnotu. Byte-level scanner popsaný v článku o PDF/A preflight validaci s PDFium Component jen potvrdí, že xmp:CreateDate a xmp:ModifyDate existují (pvaiMissingXmpDates). Od v3.72.0 navíc TPdf.ValidatePdfA pustí plné porovnání hodnot a přidá pvaiInfoXmpValueMismatch do sady nálezů, když XMP packet existuje, ale rozporuje s Info (packet, který nejde parsovat, počítá jako rozporující). Chybějící packet zůstává hlášený jako pvaiMissingXmpMetadata, takže oba nálezy nikdy nepočítají dvakrát tutéž vadu
Jaký RDF tvar potřebuje každá mapovaná XMP vlastnost?
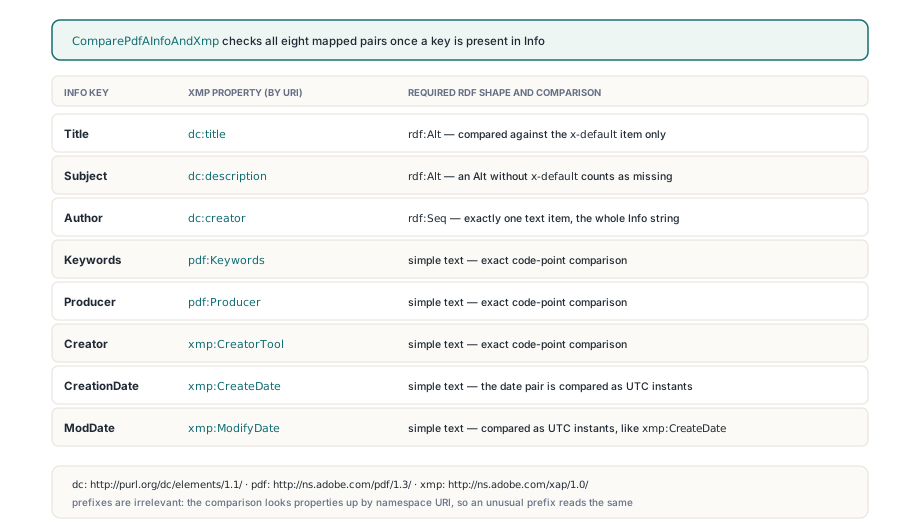
Každé z osmi mapování má fixní XMP typ a správná hodnota ve špatném kontejneru i tak padá. ComparePdfAInfoAndXmp v FPdfPdfa.pas vyhledává vlastnosti podle namespace URI, takže packet svazující http://purl.org/dc/elements/1.1/ s neobvyklou předponou se čte úplně stejně jako jeden používající dc. Vyžadované tvary jsou:
- Title →
dc:titlea Subject →dc:description: jazyková alternativardf:Alt, porovnávaná jen s její položkoux-default(jazyková značka se páruje bez ohledu na velikost písmen); Alt bezx-defaultse počítá jako chybějící - Author →
dc:creator:rdf:Seqs přesně jednou textovou položkou nesoucí celý Info řetězec, takže seznam autorů oddělených středníky zůstává jedinou položkou - Keywords →
pdf:Keywordsa Producer →pdf:Producer(namespacehttp://ns.adobe.com/pdf/1.3/): jednoduché textové vlastnosti - Creator →
xmp:CreatorTool, CreationDate →xmp:CreateDate, ModDate →xmp:ModifyDate(namespacehttp://ns.adobe.com/xap/1.0/): jednoduché textové vlastnosti
<dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report 2026</rdf:li></rdf:Alt></dc:title>
<dc:creator><rdf:Seq><rdf:li>Finance; Controlling</rdf:li></rdf:Seq></dc:creator>
<pdf:Producer>PDFium Component</pdf:Producer>
Textové hodnoty se porovnávají jako exaktní sekvence Unicode code pointů, bez ořezu, převodu velikosti písmen nebo normalizace. Mezera na konci, nebo precomposed é na jedné straně proti decomposed e plus kombinujícímu akcentu na druhé, je skutečný nesoulad. Strana Info vždy pochází z vlastního dekódování PDFDocEncoding a UTF-16 textu PDFiem přes FPDF_GetMetaText, což knihovně brání znovu implementovat dekódování řetězců a udělat si v něm drobnou chybu; strana XMP je jen tak čistá, jaké byty ji vytvořily — proto tu hrají roli i codepage pasti, které pod Free Pascalem ničí XMP metadata
Kdy jsou PDF datum a XMP datum rovna?
PDF datum a XMP datum jsou rovna, když popisují tentýž okamžik na sekundu přesně, se stejnou znalostí časového pásma na obou stranách. Oba parsery přijímají legální zredukovanou přesnost, takže D:2026 i 2026 znamenají 1. ledna 2026, 00:00:00. Když obě hodnoty nesou pásmo, převede se před porovnáním na UTC: D:20260827093659+08'00' se rovná 2026-08-27T01:36:59Z. Když pásmo nenesou ani jedna, lokální složky se porovnají tak, jak jsou zapsané. Když má pásmo jen jedna strana, výsledkem je pamsValueMismatch, protože vymyslet offset by byl tip od boku. Nenulová zlomková sekunda jako .250 v XMP taky nutí nesoulad, protože PDF datum ji nemá jak vyjádřit a tiché zaokrouhlení by schovalo skutečný rozpor; .000 se přijímá. Neparsovatelné hodnoty se hlásí odděleně jako pamsInvalidInfoDate nebo pamsInvalidXmpDate
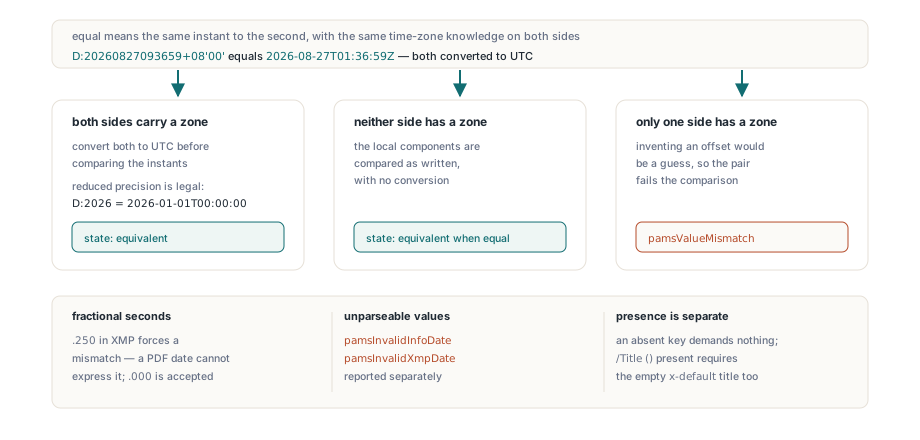
Přítomnost má vlastní pravidlo. TPdfAMetadataValues.Present je sada plněná průchodem slovníku /Info aktivního traileru a drží „klíč chybí“ odděleně od „klíč je přítomný s prázdným řetězcem“. Chybějící klíč dá pamsNotRequired a po XMP nic nechce; /Title () je přítomný, takže XMP packet musí nést i prázdný titul x-default
Jak prohlédnete Info a XMP metadata před uložením?
TPdf.InspectPdfAMetadata vrací TPdfAMetadataReport s jedním TPdfAMetadataComparison na pole, každý nese Info hodnotu, XMP hodnotu a TPdfAMetadataState, takže selhání jde vysvětlit bez reverzního inženýrství jediného validačního flagu. MismatchFields sumarizuje padající sadu, HasXmpPacket poví, jestli se packet našel, a XmpParseError nese zprávu parseru, když packet existuje, ale nedá se přečíst
uses
  System.SysUtils, PDFium, FPdfPdfa;

const
  FieldNames: array[TPdfAMetadataField] of string = (
    'Title', 'Author', 'Subject', 'Keywords',
    'Creator', 'Producer', 'CreationDate', 'ModDate');
  StateNames: array[TPdfAMetadataState] of string = (
    'not required', 'equivalent', 'XMP missing', 'XMP type mismatch',
    'value mismatch', 'invalid Info date', 'invalid XMP date');

procedure ReportMetadata(Pdf: TPdf);
var
  Report: TPdfAMetadataReport;
  Item: TPdfAMetadataComparison;
begin
  Report := Pdf.InspectPdfAMetadata;
  if Report.XmpParseError <> '' then
    Writeln('XMP packet unreadable: ', Report.XmpParseError)
  else if not Report.HasXmpPacket then
    Writeln('No XMP packet at all');
  for Item in Report.Comparisons do
    if not Item.IsEquivalent then
      Writeln(Format('%-12s %-18s Info="%s" XMP="%s"',
        [FieldNames[Item.Field], StateNames[Item.State],
         Item.InfoValue, Item.XmpValue]));
end;
Co NormalizePdfAMetadata mění a co odmítá?
TPdf.NormalizePdfAMetadata bere Info slovník jako zdroj pravdy a přepíše jen XMP vlastnosti, jejichž pole skončilo v MismatchFields; všechno ostatní v packetu přežije. Title a Subject se zapisují do položky x-default, zatímco ostatní jazykové alternativy zůstanou nedotčené, Author se stane jedno-položkovým rdf:Seq, neznámé namespace a nesouvisející vlastnosti se zachovají a XMP vlastnosti chybějících Info klíčů se nenechají zasáhnout. Info datum s pásmem se zapíše jako kanonické UTC XMP datum s příponou Z; datum bez pásma si drží lokální složky. File overload ukládá přes dočasný soubor a atomickou výměnu a samotná XMP aktualizace se přilepí jako inkrementální update
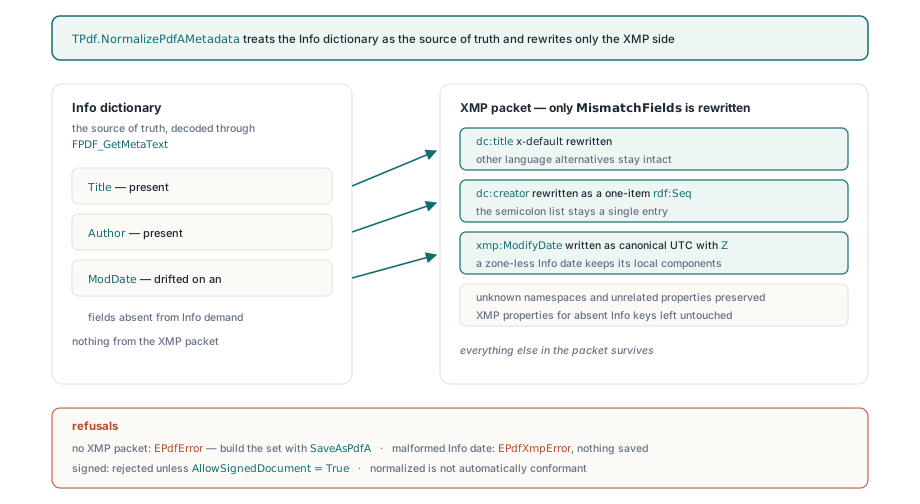
Odmítnutí jsou záměrná. Bez XMP packetu metoda vyhodí EPdfError, protože stavba kompletní PDF/A identifikace a metadata sady je práce SaveAsPdfA, rozebrané v článku o tvorbě PDF/A archivních souborů s PDFium Component. Zborcené Info datum vyhodí EPdfXmpError místo zapsání věrohodně vypadající špatné hodnoty a nic se neuloží. Podepsané dokumenty se odmítají, pokud volající nepředá AllowSignedDocument = True. Rovnocennost je jen jedno z pravidel ISO 19005-1, takže normalizovaný soubor není automaticky konformní
uses
  System.SysUtils, PDFium, FPdfPdfa, FPdfXmp;

procedure NormalizeArchive(const Source, Target: string);
var
  Pdf: TPdf;
  Report: TPdfAMetadataReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := Source;
    Pdf.Active := True;
    Report := Pdf.InspectPdfAMetadata;
    if Report.IsEquivalent then
      Exit;                      // už konzistentní, soubor nijak nezasahujeme
    if not Report.HasXmpPacket then
      raise Exception.Create('No XMP packet: convert with SaveAsPdfA instead');
    try
      if not Pdf.NormalizePdfAMetadata(Target) then
        raise Exception.Create('Normalized save failed');
    except
      on E: EPdfXmpError do      // zborcené Info datum nebo nečitelný packet
        raise Exception.CreateFmt('Cannot normalize %s: %s', [Source, E.Message]);
    end;
  finally
    Pdf.Free;
  end;
end;
Spuštění porovnání na vlastním XMP packetu
ComparePdfAInfoAndXmp a SynchronizePdfAInfoToXmp jsou obyčejné funkce v FPdfPdfa, které pracují na TPdfXmpPacket bez načteného dokumentu, což sedí unit testům a pipeline sestavujícím XMP ze šablony. Jedna past je Present: záznam inicializovaný přes Default(TPdfAMetadataValues) má prázdnou sadu, každé pole pak hlásí pamsNotRequired a porovnání projde prázdně, ať jste vyplnili jakékoliv hodnoty
uses
  System.SysUtils, System.IOUtils, FPdfPdfa, FPdfXmp;

procedure AlignTemplate(const TemplateFile: string);
var
  Info: TPdfAMetadataValues;
  Packet: TPdfXmpPacket;
  Changed: TPdfAMetadataFields;
begin
  Info := Default(TPdfAMetadataValues);
  Info.Title := 'Quarterly Report 2026';
  Info.Author := 'Finance; Controlling';
  Info.ModDate := 'D:20260827093659+08''00''';
  // Present rozhoduje, která pole jsou povinná; samotné hodnoty se ignorují
  Info.Present := [pamfTitle, pamfAuthor, pamfModDate];

  Packet := TPdfXmpPacket.Parse(TFile.ReadAllText(TemplateFile, TEncoding.UTF8));
  try
    Changed := SynchronizePdfAInfoToXmp(Info, Packet);
    // xmp:ModifyDate je teď 2026-08-27T01:36:59Z, dc:creator jedno-položkový rdf:Seq
    if Changed <> [] then
      TFile.WriteAllBytes(TemplateFile, Packet.ToUtf8);
  finally
    Packet.Free;
  end;
end;
Pokud vaše pipeline archivuje dokumenty, které dál editují jiné systémy, spojte noční sweep InspectPdfAMetadata s NormalizePdfAMetadata pro soubory, které se rozjedou, a nechávejte ValidatePdfA jako bránu předtím, než cokoli odjede do dlouhodobého úložiště. Typovaný report, opravná cesta a zbytek PDF/A toolingu dodává PDFium Component pro Delphi a C++Builder