PDFium Delphi Component skládá XMP packet pro výstup PDF/A spojováním UTF-8 fragmentů do AnsiString a na Free Pascalu 3.2.2 tento packet potichu přestal být platným UTF-8 ve chvíli, kdy titul dokumentu obsahoval ne-ASCII znak. ISO 19005-1 6.7.2 vyžaduje, aby metadata stream byl validní UTF-8, takže soubor neprošel validací. Verze 3.103.1 opravuje samotný encoder v StringToUtf8. Zajímavý není patch, ale to, že jediný nezměněný řádek zdroje vytvářel správné bajty pod Delphi, správné bajty v aplikaci Lazarus LCL a poškozené bajty v běžném console programu Free Pascalu zkompilovaném ze stejné unity. Než to začne dávat smysl, musí do sebe zapadnout tři samostatná chování stringů Free Pascalu a každé je samo o sobě obhajitelné
Proč stejný metadata kód emituje jiné bajty v Delphi a FPC
Protože string není v obou kompilátorech stejný typ. FPC 3.2.2 v režimu {$MODE Delphi} kompiluje string jako AnsiString označený DefaultSystemCodePage, zatímco Delphi ho kompiluje jako UnicodeString. Každé metadata pole v TPdfASaveOptions je deklarované jako string, takže Title, Author, Subject, Keywords, Creator a Producer nesou na jednom kompilátoru UTF-16 code units a na druhém jednobajtové znaky plus označení codepage. Stejný record, stejné pole, jiný payload. Hodnoty přicházejí z dokumentu jako UTF-16. TPdf.GetTitle a sourozenci vracejí WString, což je na FPC WideString a na Delphi string, a SaveAsPdfAToStream doplní každé prázdné option pole z Info dictionary před vložením markerů. Toto přiřazení je na Free Pascalu narrowing conversion a RTL ho provede přes codepage cílového stringu. V LCL programu už LazUTF8 nastavil DefaultSystemCodePage na CP_UTF8, takže narrowing vytvoří UTF-8 a všechno downstream náhodou funguje. V čistém console programu stejné narrowing dopadne na ANSI codepage a StringToUtf8 potom tyto octety zkopíruje beze změny, protože předpokládá, že už jsou UTF-8. Tento tvar sdílí šest save bridges: SaveAsPdfAToStream, SaveAsPdfUaToStream, SaveAsPdfEToStream, SaveAsPdfXToStream, SaveAsPdfRToStream a SaveAsPdfVTToStream, každý s vlastním option recordem
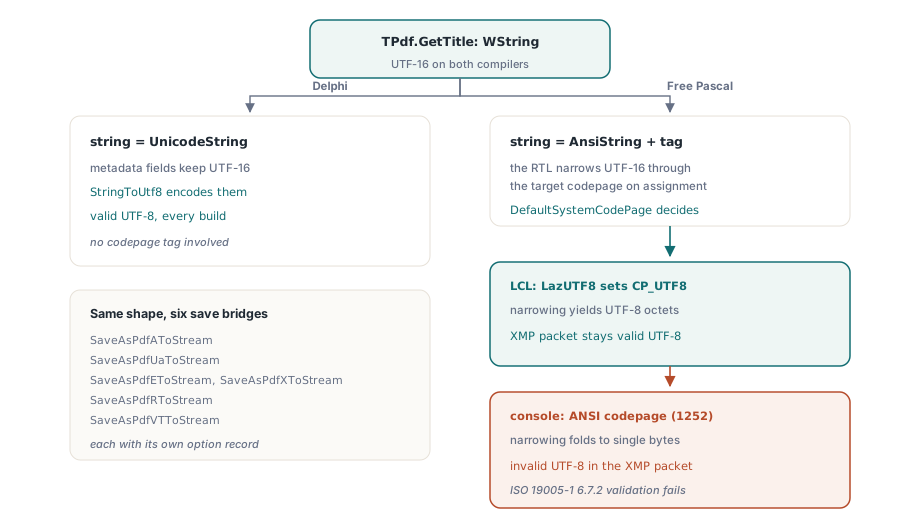
// PDFium.pas: accessors dokumentu jsou vždy UTF-16
//   WString = WideString na FPC, = string (UnicodeString) na Delphi
function TPdf.GetTitle: WString;

// FPdfPdfa.pas: record save options nese metadata jako `string`
TPdfASaveOptions = record
  Conformance: TPdfAConformance;
  IccProfileData: TBytes;
  Title: string;      // UnicodeString na Delphi
                      // AnsiString + DefaultSystemCodePage na FPC
  Author: string;
  Subject: string;
  Keywords: string;
  Creator: string;
  Producer: string;
  CreationDate: string;
  ModDate: string;
  DocumentId: TBytes;
  InstanceId: TBytes;
  class function Default: TPdfASaveOptions; static;
end;

// SaveAsPdfAToStream doplňuje prázdná pole z Info dictionary.
// Narrowing je nyní zapsaný explicitně místo ponechání implicitním:
if Eff.Title = '' then
  Eff.Title := WStringToStr(GetTitle);
Směrování všech šesti bridge přes jediný helper WStringToStr nemění chování RTL, ale staví konverzi tam, kde ji čtenář vidí, a odstranilo 92 warningů o implicitních konverzích, které maskovaly právě tento druh problému. Je to zrcadlový obraz korupce na straně Delphi popsané v poznámkách o pastích cross-compilerů Delphi a FPC v buildech PDFium, kde concatenation v Delphi zničí vysoký bajt, který Free Pascal zachová
Tři chování Free Pascalu, která porazí očividnou opravu
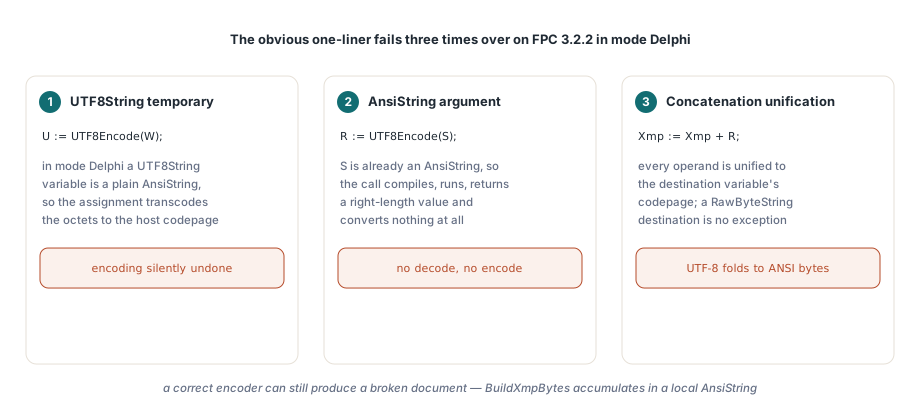
Očividná oprava je zavolat UTF8Encode a skončit. Na FPC 3.2.2 v režimu Delphi to selže třikrát a každé selhání je tiché
var
  W: UnicodeString;
  S: string;
  U: UTF8String;
  R: RawByteString;
  Xmp: AnsiString;
begin
  // Past 1: v režimu Delphi je proměnná UTF8String obyčejný AnsiString,
  // takže assignment převede octety rovnou zpět do host codepage
  U := UTF8Encode(W);

  // Past 2: S už je AnsiString, takže UTF8Encode neudělá vůbec nic
  R := UTF8Encode(S);                 // žádný decode, žádný encode, žádná chyba
  R := UTF8Encode(UnicodeString(S));  // tento skutečně encoduje

  // Past 3: concatenation sjednotí každý operand na codepage cíle
  // a RawByteString jako cíl není výjimkou
  Xmp := Xmp + R;
end;
První past znamená, že encoded výsledek musí zůstat v AnsiString nebo RawByteString, v němž vznikl. Pošlete ho cestou ven přes dočasný UTF8String a vykonanou práci jste obrátili. Druhá past se skrývá nejdéle, protože UTF8Encode(S) se zkompiluje, běží, vrátí hodnotu správné délky a když je argument už AnsiString, neprovede žádnou konverzi; teprve rozšíření na UnicodeString předem způsobí, že volání něco dekóduje. Třetí past vysvětluje, proč i správný encoder může vyrobit rozbitý dokument: BuildXmpBytes hromadí packet do lokálního Xmp: AnsiString a Free Pascal při concatenation převede každý operand na codepage cílové proměnné, takže vícebajtové sekvence cestou dovnitř znovu složí do jednobajtových ANSI hodnot
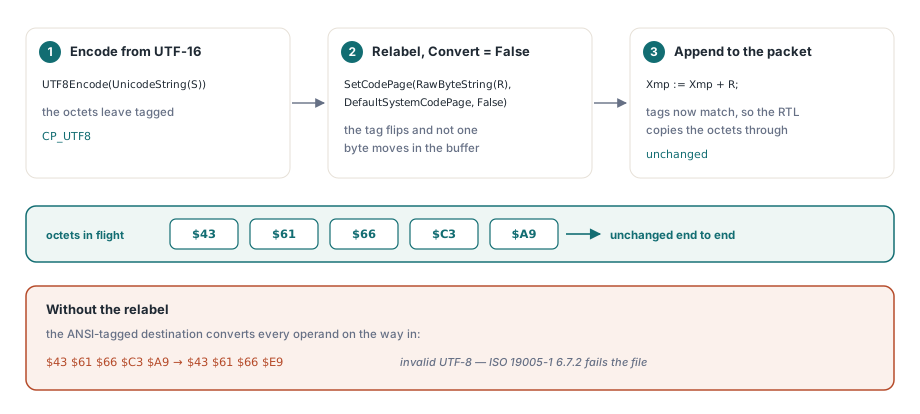
Co skutečně zaručuje SetCodePage s False
SetCodePage(RawByteString(Result), DefaultSystemCodePage, False) string přeznačí, aniž se dotkne jediného bajtu. Třetí parametr je Convert; předání False znamená „předpokládej, že payload už je v cílové codepage a pouze změň štítek“. Je to záměrná lež o obsahu: octety jsou ve skutečnosti UTF-8, ale označení host codepage zabrání tomu, aby je concatenation z třetí pasti převáděla. Do XMP bufferu se připojí jako raw bytes a vyjdou na druhé straně beze změny
function StringToUtf8(const S: string): AnsiString;
begin
{$IFDEF UNICODE}
  // Delphi: UTF8Encode už vrací octety označené CP_UTF8 a
  // concatenation do AnsiString je zachová
  Result := AnsiString(UTF8Encode(S));
{$ELSE}
  // FPC: nejdříve rozšiř, jinak je UTF8Encode nad AnsiString no-op
  Result := UTF8Encode(UnicodeString(S));
  // Přeznač bez transcodingu, aby octety přežily concatenation do
  // ANSI-tagovaných bufferů, které skládají XMP packety a PDF string objekty
  if Length(Result) > 0 then
    SetCodePage(RawByteString(Result), DefaultSystemCodePage, False);
{$ENDIF}
end;
Buďte přesní v hranici. Retag je pouze FPC a není obecným požehnáním pro míchání označených a neoznačených stringů. Funguje zde, protože downstream existuje přesně jeden consumer pattern: připojit k AnsiString a zapsat buffer jako bajty. Cokoli, co by retagovanou hodnotu zkusilo interpretovat jako text v host codepage, by četlo mojibake, a správně. Opačný směr se řeší zrcadlově a na obou kompilátorech stejně: příchozí buffer označte CP_UTF8 přes SetCodePage(..., False) a potom zavolejte UTF8ToString
Proč stejnou past nesly regresní testy
Protože test, který sestaví očekávané bajty ze source literálu, testuje kompilátor, nikoli knihovnu. Konstanta jako #$C3#$A9 zapsaná v Pascal source souboru nese compile-time codepage tohoto souboru a při předání do parametru AnsiString ji RTL znovu zakóduje, což je přesně konverze, kterou testujete. Očekávání se musí sestavit za běhu bajt po bajtu a porovnat bajt po bajtu, protože = nad dvěma AnsiString hodnotami s různými tagy před porovnáním codepage sjednotí a vrátí veselý false negative
function BytesPattern(const Values: array of Byte): AnsiString;
var
  I: Integer;
begin
  SetLength(Result, Length(Values));
  for I := 0 to High(Values) do
    Result[I + 1] := AnsiChar(Values[I]);
end;

procedure TPdfATests.StringToUtf8_AnsiCodePageString_EncodesUtf8;
var
  Saved: Word;
  Wide: WideString;
  Narrowed: string;
  Encoded, ExpectedUtf8: AnsiString;
begin
  Saved := DefaultSystemCodePage;
  try
    SetMultiByteConversionCodePage(1252);
    Wide := WideChar($0043) + WideChar($0061) + WideChar($0066) + WideChar($00E9);
    Narrowed := Wide;                    // narrowing, které testujeme
    Encoded := StringToUtf8(Narrowed);
  finally
    SetMultiByteConversionCodePage(Saved);
  end;
  // 'Caf' + U+00E9 jako UTF-8, sestavené za běhu, aby se literal nepřekódoval
  ExpectedUtf8 := BytesPattern([$43, $61, $66, $C3, $A9]);
  AssertTrue('StringToUtf8 must emit UTF-8 for a string carrying a non-UTF-8 codepage',
    SameOctets(Encoded, ExpectedUtf8));
end;
Harness samotný je LCL program, takže DefaultSystemCodePage je CP_UTF8 a chyba je neviditelná, dokud ji test nepřepne. SetMultiByteConversionCodePage(1252) uvnitř try..finally na dobu jediného testu napodobí prostředí běžného console programu. End-to-end kontrola jde dál a assertuje oba směry: XMP packet vytvořený vložením markeru musí obsahovat $43 $61 $66 $C3 $A9 a nesmí obsahovat $43 $61 $66 $E9, takže budoucí regrese vracející se k raw single-byte outputu selže hlasitě místo vytvoření souboru, který v hex dumpu jen vypadá plausibilně. Pokud pracujete s nelatinskými metadaty, stejná disciplína rozšiřování řídí případy v článku o emoji a CJK textu, které rozbíjejí WideChar handling v Delphi
Kde ještě narrowing dopadá
XMP je viditelná oběť, ale stejnému problému byla vystavena každá další bridge mezi TBytes a string v téže codebase. Ve v3.103.1 se opravily další dvě: Utf8BytesToString a StringToUtf8Bytes v FPdfProduction, které round-trippují packet datasetů XFA přes string, aby MergePdfXfaDatasets mohl nahradit bound values, a BytesToUtf8 v FPdfTrustedList, který po odstranění BOM dekóduje XML evropského trusted listu. Obě nyní připraví buffer v RawByteString, označí ho CP_UTF8 bez konverze a dekódují přes UTF8ToString. Jeden modul byl už imunní a důvod stojí za převzetí. XFDF writer deklaruje vlastní textový typ XFDFString, který se pod FPC řeší na WideString a pod Delphi na UnicodeString, takže jeho encoder nikdy nevidí codepage-tagovaný AnsiString. To je strukturální oprava: držte text v UTF-16 typu až do přesného okamžiku serializace a jedinou úzkou funkci nechte vlastnit převod na bajty. Každý bug z této rodiny vznikl tím, že uprostřed pipeline, která byla na jednom konci UTF-16 a na druhém octety, sedělo pole typu string
Co kontrolovat ve vlastním PDF kódu pro dva kompilátory
Pokud dodáváte Object Pascal běžící na obou kompilátorech a zapisující metadata do PDF vyhovujícího standardu, čtyři kontroly najdou většinu tohoto druhu problému dřív než validator
- Grepujte
UTF8Encodes argumentemstring. Na FPC je toto volání no-op a jde o řádek s nejvyšší výtěžností pro audit - Každou proměnnou
UTF8Stringv režimu Delphi považujte za podezřelou. Je to tam obyčejnýAnsiStringa přiřazení zakódovaných bajtů do ní je znovu transcoduje - Spusťte alespoň jednu regresi pod
SetMultiByteConversionCodePages jednobajtovou codepage. LCL test harness běží naCP_UTF8a běžný console program nikdy nereprodukuje - Očekávané byte vectors sestavujte za běhu a porovnávejte octet po octetu. Source literály i
=procházejí codepage reconciliation a chybu, kterou hledáte, skryjí
Nic z toho není exotická trivia Free Pascalu. Je to běžná cena jazyka, který vedle UTF-16 ponechal byte-oriented string typ, a oba kompilátory rozumně, ale odlišně zvolily, co má string znamenat. Praktický důsledek pro PDF práci je úzký a ostrý: metadata, která vypadají dobře v IDE, mohou dorazit do XMP packetu jako neplatné UTF-8 a ISO 19005-1 6.7.2 nezajímá, který kompilátor je tam vložil. Pokud stavíte archivační pipeline, encoding layer si zaslouží stejnou pozornost jako zbytek workflow archivní shody PDF/A. PDFium Delphi Component dodává tyto konverze jako součást knihovny, takže SaveAsPdfA a jeho pět standardních sourozenců emituje konformní UTF-8 metadata v Delphi, Lazarusu i čistých buildech Free Pascalu bez konfigurace codepage na straně volajícího. Úplnou dokumentaci API a aktuální release najdete na produktové stránce PDFium Delphi Component